
《大模型导论》笔记——预训练
·
预训练 通过整合大量从低成本渠道获取的训练数据,并将这些数据传递给模型,由模型对这些数据的共性知识进行学习,从而形成一种通用的理解能力。模型获得能量后,可以用于特定任务中。我个人的理解是从特定的数据归纳总结出共性,然后用于工业生产。比如车辆监控,从一大堆车辆行驶图片里面,规定特点形状的为车车,图片左边的座位为副驾驶,副驾驶如果有人有一个斜斜角度的带子默认绑定安全带,这样就可以把这些特性用于检查副驾驶有没有系安全带咯,虽然安全带可能有跟衣服颜色相似,不容易辨认,大部分的应该可以辨识出来吧,一部分的图片数据可以作为验证集,直到调整到模型识别率比较高,就可以应用于马路上咯。
预训练语言模型可以分为 自回归语音模型 和 自编码语言模型。自回归针对从左往右生成任务。
预训练任务
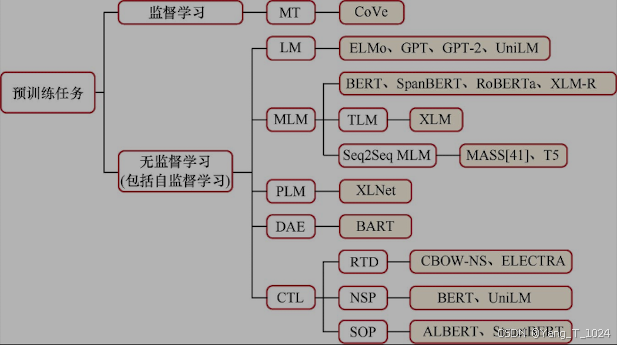
语言模型通过预训练学习通用语言知识后,通过迁移学习和微调两种方法获得知识应用于下游任务。
迁移学习,讲知识从一个领域迁移到另一个领域。它是深度学习中一种重要策略。核心是模型举一反三(哇咔咔,超过人类了,有的时候我们举一反三还没有模型厉害😓)。
微调是自然语言处理领域的常用技术。 通过将预训练语言模型与特定任务领域相适配,利用 已经过大型语料训练的预训练语言模型 在针对特定任务的 小型语料 上继续训练。
BERT为例子,用于下游任务:
标准形式的微调: 通过目标任务对模型训练
两阶段微调: 第一阶段使用中间任务或语料对语言模型进行微调或者增量式训练,第二阶段针对目标任务对语言模型进行微调,更新模型参数。
多任务微调:多任务框架下对语言模型微调。
额外自适应模块进行微调:低成本高效微调主流方法。固定参数,只对自适应模块训练,减少参数。
预训练模型的应用
命令实体任务,问题回答任务,情感分析任务。
更多推荐


 15
 0
- 0


 已为社区贡献9条内容

所有评论(0)