
《大模型导论》笔记——训练优化
·
大模型的训练优化技术主要应用于预训练和微调阶段。
数据并行
超大模型需要极高的算力和存储需求,通过数据并行解决单一设备性能有限的问题, 提升大模型的计算速度。
1) 对数据切分
方式一:训练迭代开始前,讲数据集以并行进程数进行切分,每个进程读取切分后的数据。
方式二: 仅某个进程负责数据的读取任务。一个读,分发给不同进程。
2)模型参数同步
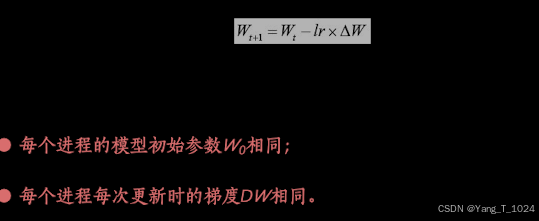
确保模型参数同步并正确更新(其实不大懂)。
3) 保证各个进程中模型初始参数相同方法
方法一: 参数初始化时,使用相同的随机种子和相同的顺序来初始化各个进程的模型参数。
方法二: 由某一个进程初始化全部参数,通过广播告知其他进程。
模型并行
参数规模增长到单 GPU 设备的显存无法容纳,数据并行不再适用。
模型并行就是拆分模型,把模型部署到不同 gpu 设备。
实现模型并行的关键在于将模型的不同子网放置在不同的 GPU 设备,并编写前向传播函数,确保设备的输入输出能够正确协调。
无论是大模型还是工程,基本就是大了以后拆拆拆,复杂问题基本都是拆解成单一子问题,进行逐个求解并合并。好处就是扩充方便,坏处就是流转需要时间,还有就是机器因为运行速度不同,闲置时间可能会互相影响。
流水线并行
基于模型并行上结合数据并行。把模型和数据都拆分开,然后看哪个空闲就给它塞数据。
混合精度训练
显存优化,适合单机单卡 或 多卡并行的场景。
大模型训练平台
deepseed, megatron-lm,colossal-ai,bmtrain
更多推荐


 2
 0
- 0


 已为社区贡献9条内容

所有评论(0)