
RetiZero:融合 MAE 与 CLIP 的眼底疾病诊断大模型
眼底疾病(如视网膜病变、青光眼)的早期诊断是降低失明风险的关键,但传统 AI 模型存在疾病覆盖少、泛化能力弱、图文特征对齐不足等问题。本文深入解析 Nature Communications 2025 年发表的 RetiZero 模型 —— 一款融合多源知识的视觉 - 语言大模型,其通过多源异构数据构建、MAE+CLIP 双架构融合、不确定性特征校准三大核心创新,实现了 400 + 眼底疾病的精准识别,零样本诊断性能超越多数眼科医生。本文将拆解 RetiZero 的创新设计、详细实现流程,并分析其在临床场景的应用价值,为医疗 AI 研究者提供技术参考。
一、研究背景与现有痛点
全球眼底疾病负担沉重,但眼科医疗资源分布不均,AI 辅助诊断成为解决方案。然而现有模型存在明显局限:
数据单一:多数模型仅基于特定疾病数据集(如糖尿病视网膜病变)训练,覆盖疾病类别不足 100 种,罕见病诊断几乎空白;
架构缺陷:MAE-based 模型(如 RETFound)缺乏文本语义对齐,无法支持零样本诊断;CLIP-based 模型(如 FLAIR)难以捕捉眼底图像的局部病理细节,图像检索性能差;
泛化能力弱:跨设备、跨人群、跨疾病类别的诊断误差大,需大量标注数据重训练;
数据噪声:多源数据存在图像质量差异、文本描述不统一等问题,影响模型稳定性。
RetiZero 针对上述痛点,通过三大创新突破现有瓶颈,下面逐一解析其核心设计。
二、RetiZero 的三大核心创新方法
2.1 创新一:多源异构数据构建,覆盖 400 + 眼底疾病
RetiZero 的核心优势源于其知识丰富的数据集,这是现有模型无法比拟的。团队整合了三类数据源,构建了 341,896 张眼底图像 - 文本对,覆盖 414 种眼科标签(含罕见病):
公共数据集:29 个公开数据集的 303,124 张图像,统一转换为 “a fundus image of [疾病名称]” 的标准化文本描述;
眼科文献:180 篇文献中提取 23,328 张图像,由 12 位眼科医生标注疾病关键词和文本描述;
在线资源:筛选 15,544 张高质量眼底图像 - 文本对,剔除模糊、曝光异常等低质量数据。
数据处理关键操作:
标签统一:将不同数据源的疾病名称标准化(如 “Bietti 结晶样 dystrophy” 统一命名);
文本清洗:仅保留与图像直接相关的病理描述,剔除标题、背景等无关信息;
质量控制:2 位资深眼科医生审核,排除非标准图像(如局部截图、黑白图)和错误标注。
2.2 创新二:MAE+CLIP 双架构融合,兼顾细节与语义
RetiZero 创新性地结合了 MAE 的局部细节提取能力和 CLIP 的图文语义对齐能力,同时通过 LoRA 低秩适配降低训练成本,模型架构如下:
2.2.1 图像编码器:MAE 骨干 + LoRA 适配
骨干网络:采用 RETFound(基于 MAE 预训练的眼底图像模型)作为基础骨干,冻结其权重以保留对视网膜病变轮廓、细微病理结构的识别能力;
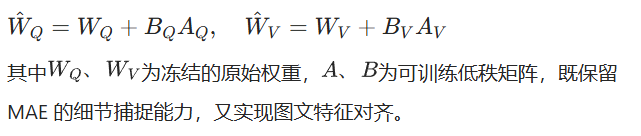
低秩适配(LoRA):在 RETFound 的 Query 和 Value 投影层插入低秩矩阵(r=8),仅训练少量参数(远少于全量微调),即可引入文本语义关联,公式如下:
2.2.2 文本编码器:BioClinicalBERT 适配医疗场景
眼底疾病描述含大量专业术语(如 “chorioretinal coloboma” 脉络膜视网膜缺损),传统 CLIP 的文本编码器难以理解;
采用 BioClinicalBERT(基于 MIMIC-III 医疗文本预训练)作为文本编码器,初始化后通过对比学习适配眼底疾病描述,提升语义提取准确性。
2.2.3 不确定性特征校准:Dirichlet 重参数化
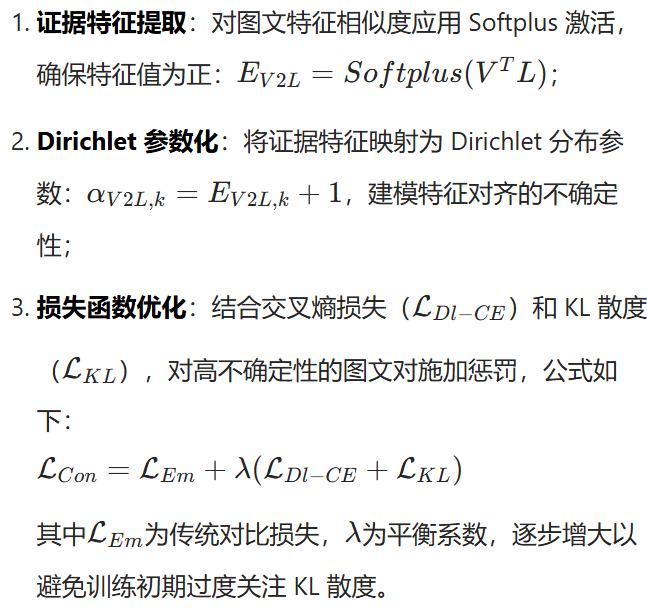
针对多源数据的噪声问题,RetiZero 引入基于 Dirichlet 分布的不确定性校准,三步实现特征优化:
证据特征提取:对图文特征相似度应用 Softplus 激活,确保特征值为正:
2.3 创新三:零样本 + 图像检索双范式,适配罕见病诊断
针对罕见病样本稀缺的问题,RetiZero 支持两种无需额外训练的诊断范式:
零样本诊断:仅通过文本提示(如 “诊断:Bietti 结晶样 dystrophy”)即可识别未见过的疾病,无需标注样本;
图像检索诊断:输入待诊断图像,从候选池中检索 Top-K 相似图像,通过相似病例辅助诊断,尤其适合病理特征独特的罕见病。
2.3 创新三:零样本 + 图像检索双范式,适配罕见病诊断
针对罕见病样本稀缺的问题,RetiZero 支持两种无需额外训练的诊断范式:
零样本诊断:仅通过文本提示(如 “诊断:Bietti 结晶样 dystrophy”)即可识别未见过的疾病,无需标注样本;
图像检索诊断:输入待诊断图像,从候选池中检索 Top-K 相似图像,通过相似病例辅助诊断,尤其适合病理特征独特的罕见病。
三、RetiZero 的详细实现步骤
数据预处理流程
# 伪代码:数据预处理核心步骤
def preprocess_data():
    # 1. 数据读取:公共数据集+文献+在线资源
    public_data = load_public_datasets(29)  # 29个公开数据集
    literature_data = extract_from_literature(180)  # 180篇文献
    online_data = crawl_online_resources()  # 在线资源

    # 2. 文本标准化
    public_data["text"] = public_data["label"].apply(lambda x: f"a fundus image of {x}")
    literature_data["text"] = standardize_medical_terms(literature_data["keywords"])

    # 3. 数据清洗
    all_data = pd.concat([public_data, literature_data, online_data])
    all_data = filter_low_quality_images(all_data)  # 剔除模糊/异常图像
    all_data = unify_labels(all_data)  # 标签统一

    # 4. 划分数据集
    train_data, val_data, test_data = split_data(all_data, ratio=[0.6, 0.2, 0.2])
    return train_data, val_data, test_data
预训练阶段(图文对比 + 不确定性校准)
# 伪代码:预训练核心流程
def pretrain_retizero():
    # 初始化编码器
    image_encoder = RETFound(pretrained=True)  # MAE骨干
    image_encoder.add_lora(rank=8)  # 插入LoRA层
    text_encoder = BioClinicalBERT.from_pretrained("biobert-base-cased")

    # 优化器与损失函数
    optimizer = Adam([
        {"params": image_encoder.lora_params()},
        {"params": text_encoder.parameters()},
        {"params": projection_head.parameters()}
    ], lr=1e-4)

    # 训练循环
    for epoch in range(100):
        for batch in train_loader:
            images, texts = batch["image"], batch["text"]

            # 特征提取
            img_feat = image_encoder(images)
            txt_feat = text_encoder(texts)

            # 投影到统一空间
            img_embed = projection_head(img_feat)
            txt_embed = projection_head(txt_feat)

            # 对比损失计算
            contrastive_loss = calculate_contrastive_loss(img_embed, txt_embed)

            # 不确定性校准损失
            uncertainty_loss = calculate_dirichlet_loss(img_embed, txt_embed)

            # 总损失
            total_loss = contrastive_loss + 0.1 * uncertainty_loss  # λ=0.1

            optimizer.zero_grad()
            total_loss.backward()
            optimizer.step()
下游任务微调
零样本诊断:无需微调,直接输入文本提示(如 52 种疾病名称),计算图像与文本的相似度排序;
图像检索:仅微调投影头,优化图像特征的相似度计算;
少样本微调:每个疾病仅用 5 张样本,微调 LoRA 层和投影头,AUC 达 0.85+。
关键评估指标
分类任务:Top-1/3/5 准确率、AUC;
检索任务:Precision@1/3/5;
临床验证:医生诊断准确率提升幅度、置信度变化。
更多推荐


 29
 0
- 0


 已为社区贡献1条内容

所有评论(0)