
底层视觉及图像增强-项目实践理论补充(十六-0-(18):深度学习与卷积神经网络【卷积层、池化层、全连接层】:从原理到LED显示工业实践的穿透式思考):从奥运大屏,到手机小屏,快来挖一挖里面都有什么
底层视觉及图像增强-项目实践理论补充(十六-0-(18):深度学习与卷积神经网络:从原理到LED显示工业实践的穿透式思考):从奥运大屏,到手机小屏,快来挖一挖里面都有什么
代码仓库入口:
- 源码地址。
系列文章规划:
- 第一章节:底层视觉及图像增强-项目实践(十六-1:Real-ESRGAN在LED显示画质增强上的实战:从数据构建到模型微调):从奥运大屏,到手机小屏,快来挖一挖里面都有什么
第二章节:底层视觉及图像增强-项目实践<十六-2,谈些虚虚的,项目咋做?论文看哪些点?有哪些好工具能用?>(从LED显示问题到非LED领域影像画质优化):从LED大屏,到手机小屏,快来挖一挖里面都有什么
深度学习与卷积神经网络:从原理到LED显示工业实践的穿透式思考
作为一名软件工程师,我的工作核心是驾驭“光”——通过算法驱动LED显示屏,呈现精准、绚烂且稳定的画面。在这个过程中,我深刻体会到,许多复杂的画质问题,其底层逻辑与当今人工智能的基石——卷积神经网络(CNN)有着惊人的相通之处。本文不仅是对CNN知识的梳理,更是一次将理论映射到工业实践的探索。
一、神经网络:从“直觉判断”到“工业控制”
原理探秘:
神经网络本质是一个万能函数逼近器。它通过多层神经元的互联,将输入数据(如图像像素)层层变换,最终输出我们期望的结果(如分类标签)。每个神经元都像一个小型决策器,进行 y = f(wx + b) 的运算,其中 w(权重)决定输入的重要性,b(偏置)是触发阈值,f 是激活函数,为系统引入非线性,使其能够拟合复杂关系。
通俗解释:
这好比我们调试LED屏的色温。输入是RGB原始值,我们的“大脑神经网络”会根据经验(权重和偏置)判断:“嗯,当前画面偏蓝,需要降低蓝色驱动电流,同时微增红色。”这个决策过程就是一次前向传播。如果调完后用色度计测量发现色温还是不准(计算损失),我们就反过来修正刚才的决策思路(反向传播与梯度下降),下次遇到类似情况就能调得更准。
工业实践链接:
在画质调节中,手动调节色温、Gamma值便是一个“人工神经网络”在运作。我们工程师的大脑就是激活函数,根据光枪反馈(损失值)不断调整屏幕参数(权重),目标是让输出画质无限接近标准值。而自动化这一过程,正是AI要解决的问题。
AI如何玩转:
AI将这一过程自动化、规模化。我们将大量的“屏体原始数据”和“期望画质效果”丢给神经网络,让它自己学习出最优的 w 和 b,从而构建一个自动化的画质调优模型,替代传统依赖老师傅经验的调试流程。
比较好的可视化网站:让你能够深入理解神经网络
- https://www.asimovinstitute.org/neural-network-zoo/
- 包含每种网络的讲解:
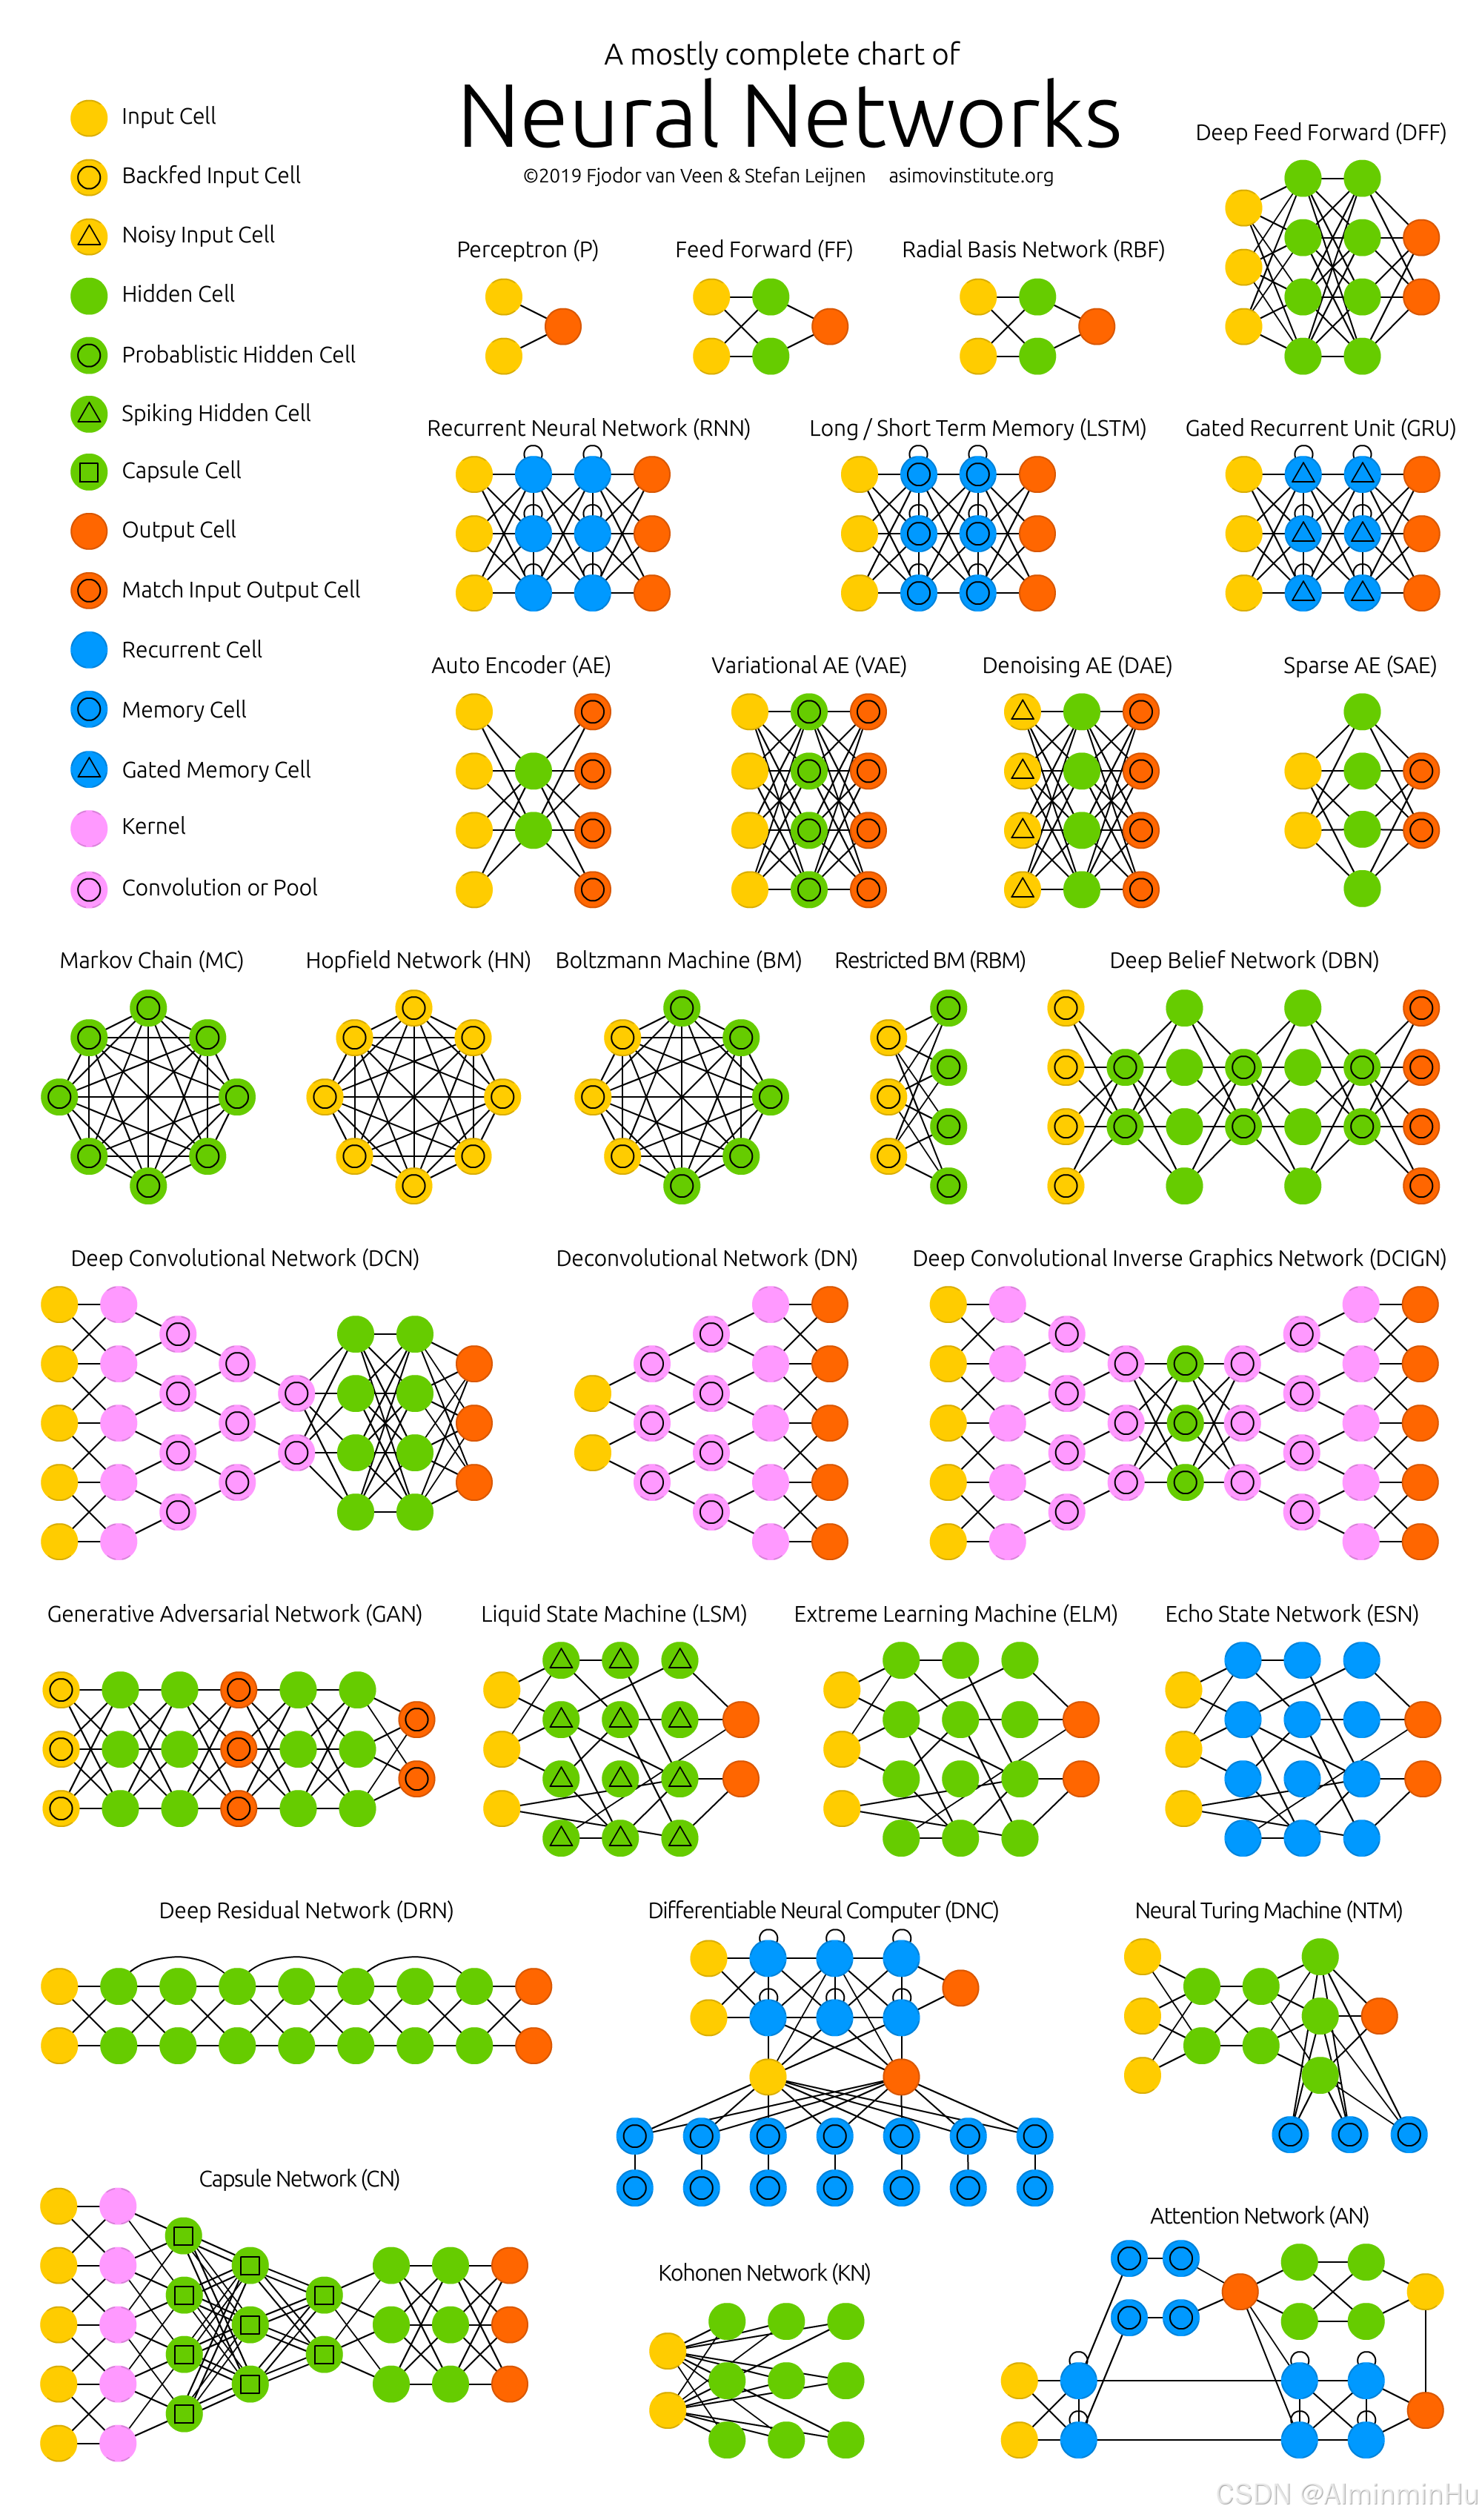
- https://jalammar.github.io/feedforward-neural-networks-visual-interactive/
- https://jalammar.github.io/visual-interactive-guide-basics-neural-networks/
二、卷积神经网络(CNN:Convolutional Neural Networks):解构图像的“火眼金睛”
CNN是神经网络在图像处理领域的王牌架构,其设计思想深刻契合了图像的底层特性。
工作流程概述:
卷积层—》池化层(或者叫降采样层、下采样层)—》卷积层—》池化层(或者叫降采样层、下采样层)—》把池化的结果拉平成一个长向量传入到全连接层中—》输出层(全连接+Softmax激活)
- 本质类似于一个函数,有自己的输入(二维的像素阵列图片)和输出(图片的分类集信息)
- 举例:1、把LED相关的问题图片转换成为像素矩阵;2、对像素矩阵进行第一层卷积运算,生成六个feature map;3、对每个feature map进行下采样(池化),在保留feature map特征的同时缩小数据量。生成六个小图,这六个小图和上一层各自的feature map长得很像,但尺寸缩小了;4、对六个小图进行第二层卷积运算,生成更多的feature map;5、对第二次卷积生成的featuremap进行下采样;6、第一层全连接层;7、第二层全连接层、8、高斯连接层,输出分类结果
- 输入可以是归一化之后的结果,每一个种类的概率(0到1之间),也可以是一个二分类结果,是不是狗蛋
1. 卷积层:特征的“模式识别器【卷积层用来提取图像的底层特征】”
原理探秘:
卷积核是一个小的权重矩阵(如3x3),它像探照灯一样在输入图像上滑动,进行局部区域的乘加运算。其核心思想是局部连接和权值共享。局部连接意味着每个神经元只关注一小块区域,符合“图像中相邻像素关联性最强”的常识;权值共享意味着同一个模式(如边缘)在整个图像中由同一个卷积核来检测,极大减少了参数量。
- 卷积核:类似于细胞核等,是一个kernel,比如可以是3*3的,用卷积核在原图像上滑动,然后卷积核上的元素与原图上对应位置对应元素进行相乘并求和
- 感受野:卷积核光顾到的地方就叫做感受野,类似于人眼目光看到的地方或者说感受到的地方
- padding:为了防止边缘的特征被卷积核忽略掉,因为中间的被卷积核卷了好几次,而边缘的只有极少数几次,就相当于被忽略掉了,所以进行padding,外圈补一圈0,让卷积核多光顾几次边缘的特征
- 对于一张具有3通道的RGB颜色的图像其大小为663;卷积核大小也有333,即具有3个颜色通道的卷积核;生成一个44大小的特征图,如果也想生成66的图,可以进行边缘padding。假设用256个卷积核,那最终就生成44256,那么生成的图像或者说参数就远远超过了原图的参数,所以此时我们需要把生成的参数的维度降下来,进行数据压缩,这样也可以防止过拟合----》池化
- 针对感受野,也可以理解成为局部连接(相对于全连接那种密集的连接)
- padding:为了防止边缘的特征被卷积核忽略掉,因为中间的被卷积核卷了好几次,而边缘的只有极少数几次,就相当于被忽略掉了,所以进行padding,外圈补一圈0,让卷积核多光顾几次边缘的特征
通俗解释:
想象你拿着一把检测“垂直边缘”的模板尺子,在一张图片上从头到尾滑动。当尺子划过建筑物的边缘时,会输出一个高值;划过平滑的天空时,输出低值。这把“尺子”就是卷积核,它专门负责抓取特定模式。CNN的第一层卷积核可能学会检测“边缘”,第二层基于“边缘”组合检测“角点”,第三层再组合出“纹理”,以此类推,形成从底层到高层的特征层次结构。
- 多通道卷积示例:https://thomelane.github.io/convolutions/2DConvRGB.html
- https://github.com/vdumoulin/conv_arithmetic
- 选择不同的卷积核有不同的效果,比如单位矩阵,全是1的33矩阵,可以将每个像素及其相邻值进行平均会使图像模糊;33的0 1 0、1 -4 1、0 1 0的卷积核可以取一个像素与其相邻像素之间的差异可检测到边缘;也可以对图像的底层特征进行抽取(比如卷积核对应一个眼睛,那么用这个卷积核划过人脸,只有卷积核划过眼睛时,生成数值为1,其他地方都为0,这不就把眼睛(特征)提取出来了吗)
工业实践链接:
在画质系统中,我们可以检测“首行偏暗”、“余晖”等IC异常。传统做法需要我们手工设计算法来识别这些异常特征。而卷积核的思想与此异曲同工——一个训练好的CNN,其某一层的卷积核可能自动学会了识别“因首行偏暗而产生的特定亮度梯度模式”,另一组卷积核则可能专门识别“因余晖而产生的拖影模式”。这比手动设计规则更全面、更鲁棒。
AI如何玩转:
我们可以收集大量标注了各类画质异常的屏摄图像,训练一个CNN分类模型。模型会自动学习到区分正常与异常的特征,实现IC异常的自动化、高精度检测,将工程师从繁重的主观检测中解放出来。
2. 池化层:信息的“精炼压缩厂”【池化(也叫降采样、下采样)层用来防止过拟合,并且将数据维度减小】
原理探秘:
池化(如最大池化、平均池化)对特征图进行下采样,在保留最显著信息的同时,大幅降低数据维度和计算量。它赋予了CNN平移不变性——即无论目标在图像中的哪个位置,都能被成功识别。
- 对于一张具有3通道的RGB颜色的图像其大小为663;卷积核大小也有333,即具有3个颜色通道的卷积核;生成一个44大小的特征图,如果也想生成66的图,可以进行边缘padding。假设用256个卷积核,那最终就生成44256,那么生成的图像或者说参数就远远超过了原图的参数,所以此时我们需要把生成的参数的维度降下来,进行数据压缩,这样也可以防止过拟合----》池化
- 可以想象,用一个被划分为很多小格子的大框,框在图像中,在小格子中选择一个值代表这个大框中所有的像素
- 选择平均值,就叫平均池化((降采样、下采样))
- 生成对抗网络中,上采样,小图像变成大图像,反卷积(转置卷积)
- 选择最大值,就叫最大池化((降采样、下采样))
- 用的比较多,图像上比较尖锐的亮点等都可以用最大池化进行捕捉
- 选择平均值,就叫平均池化((降采样、下采样))
- 池化的作用:
- 1.减少参数量(过程中保留了原始图像的信息)
- 2.防止过拟合
- 3、平移(缩放、变形)不变性(眼睛卷积核滑过眼睛,眼睛的位置是不变的)
- 选择不同的卷积核有不同的效果,比如单位矩阵,全是1的33矩阵,可以将每个像素及其相邻值进行平均会使图像模糊;33的0 1 0、1 -4 1、0 1 0的卷积核可以取一个像素与其相邻像素之间的差异可检测到边缘;也可以对图像的底层特征进行抽取(比如卷积核对应一个眼睛,那么用这个卷积核划过人脸,只有卷积核划过眼睛时,生成数值为1,其他地方都为0,这不就把眼睛(特征)提取出来了嘛)
- 【卷积神经网络CNN,保持平移、缩放、变形不变性的原因,有这个不变性是因为CNN有局部感受野(滑动的过程中每次只关注一小部分图像的特征,每个神经元仅与输入神经元的一块区域连接,这块局部区域称为感受野(receptive field)。局部连接的思想,也是受启于生物学里面的视觉系统结构,视觉皮层的神经元就是局部接收信息的)、权值共享(卷积核在滑动的过程中卷积核本身的权重是不变的,卷积核是共享的,全举变量一样)、下采样(池化)(减少参数,降维,把大图变成小图、防止过拟合) 的特点】
- https://towardsdatascience.com/light-on-math-machine-learning-intuitive-guide-to-convolution-neural-networks-e3f054dd5daa/
通俗解释:
假设卷积层输出了一张标记了所有“眼睛”位置的激活图。池化层的作用是告诉你:“这张图里确实有眼睛”,但它不关心眼睛是在左上角还是右下角。它通过将一个小区域(如2x2)的多个值,用一个最大值或平均值来代替,实现了“抓大放小”,聚焦核心特征。
工业实践链接:
在全灰阶校正过程中,我们面对的是数百万颗灯珠的逐点补偿数据,数据量巨大。直接处理全分辨率数据对存储和计算都是挑战。我们可以借鉴池化的思想,对校正区域进行分块,对块内的补偿系数进行“池化”(如取中值或均值),生成一个更稀疏但更具代表性的校正映射,在保证校正效果的同时,极大提升处理效率和降低对硬件内存的占用。
AI如何玩转:
在基于AI的超分模型中,编码器部分会大量使用步长卷积或池化层来压缩图像尺寸,提取高级语义特征;解码器部分则使用反卷积(转置卷积)进行上采样,重建高分辨率细节。这套“编码-解码”结构,正是我们研究如何将低分辨率源数据高效转换为高精度屏体驱动信号的灵感来源。
3. 全连接层:决策的“指挥部”
原理探秘:
在经过多轮卷积和池化后,得到的高层特征图被“拉平”成一个长向量,输入全连接层。全连接层的作用是综合全局信息,将前面提取的分布式特征进行整合,最终映射到样本的标记空间。
- 全连接层用于汇总池化层和卷积层得到的特征和信息。全连接指的是每一层都是和上一层的所有神经元相连的,最后变成一个密集的连接,所以叫做全连接
通俗解释:
卷积层和池化层好比前线侦察兵,汇报“发现边缘!”“发现纹理!”。全连接层就是总指挥部,它汇集所有情报,进行综合分析:“根据汇报的多种特征组合,有90%的把握确定这是一张人脸。”
工业实践链接:
在LED相关应用中,我们通过迭代优化多个参数,使低灰阶的DeltaE色差最小化。这可以看作一个微型“决策系统”:输入是当前光枪测量的(L, x, y)值,全连接层(在这里是我们的决策逻辑)综合这些输入,计算出PWM和PAM的最佳调整量,输出给驱动芯片。一个训练好的AI模型可以替代这个迭代过程,直接端到端地给出最优参数。
三、经典网络与工程启示:LeNet-5的简约之美
原理回顾:
LeNet-5是一个经典的CNN序列结构:输入 -> 卷积 -> 池化 -> 卷积 -> 池化 -> 全连接 -> 输出。这种“交替堆叠”的模式,奠定了后续大多数CNN的基础。
工业实践的映射:
这个流程与我们处理LED屏体画质问题的流水线惊人地相似:
- 输入:接收卡送来的原始图像数据。
- 卷积1:进行底层特征提取,如亮度分布、色块初判。
- 池化1:忽略细微抖动,聚焦明显的显示异常区域。
- 卷积2:进行高级特征提取,如判断色块类型、均匀性等级。
- 池化2:进一步抽象,确定问题的大致范围和严重程度。
- 全连接:综合所有特征,做出最终诊断:“此屏体在10%亮度下存在低灰红色色偏,建议启动**算法进行校准。”
- 输出:执行校准指令或生成测评报告。
举例:
输入是32321通道的图像—》进行55卷积核步长为1的卷积,用六个—?得到28286的特征图—》进行22的平均池化,步长为2—》得到14146—》再用 55的卷积核,步长为1进行卷积,用16个—》得到101016的特征图—》进行22的平均池化,步长为2—》得到5516的特征图,拉平为5516的长向量,喂给有120个神经元的全连接层,再给有84个神经元的全连接层—》输出softmax(归一化后每一个分类的概率,位于0和1之间)
四、激活函数:引入“是非观”的ReLU
原理探秘:
ReLU函数 f(x) = max(0, x) 是深度学习成功的催化剂之一。它解决了Sigmoid等函数带来的梯度消失问题,计算简单,能加速收敛。
通俗与工程解释:
ReLU就是一个简单的阈值判断。在LED驱动中,我们经常设置一个最低驱动电流(如PAM值),低于这个值灯珠不亮(输出0),高于则线性输出。ReLU的行为与此类似,它让网络变得稀疏,只有部分神经元被激活,提高了模型的判别能力。
总结:从理解到创造
深度学习并非遥不可及的“黑魔法”,其核心思想源于我们对物理世界和问题本质的洞察。作为一名显示行业的工程师,理解CNN,不仅是为了应用现成的模型,更是为了汲取其设计哲学:
- 局部连接 启示我们,解决复杂问题可以先从局部入手。
- 权值共享 告诉我们,找到可复用的模式是高效解决问题的关键。
- 池化 教导我们,在信息爆炸的时代,要学会抓住主要矛盾。
-
如果想了解一些成像系统、图像、人眼、颜色等等的小知识,快去看看视频吧 :
- 抖音:数字图像哪些好玩的事,咱就不照课本念,轻轻松松谝闲传
- 快手:数字图像哪些好玩的事,咱就不照课本念,轻轻松松谝闲传
- B站:数字图像哪些好玩的事,咱就不照课本念,轻轻松松谝闲传
- 认准一个头像,保你不迷路:

- 认准一个头像,保你不迷路:
-
您要是也想站在文章开头的巨人的肩膀啦,可以动动您发财的小指头,然后把您的想要展现的名称和公开信息发我,这些信息会跟随每篇文章,屹立在文章的顶部哦

更多推荐
 24
 0
- 0


 已为社区贡献5条内容

所有评论(0)