
Kubernetes Worker节点kubectl连接拒绝问题:配置文件缺失的排查、修复与思考
今天练习kubernetes的时候遇到了一个问题,好像啥也没干,从节点突然不能用了
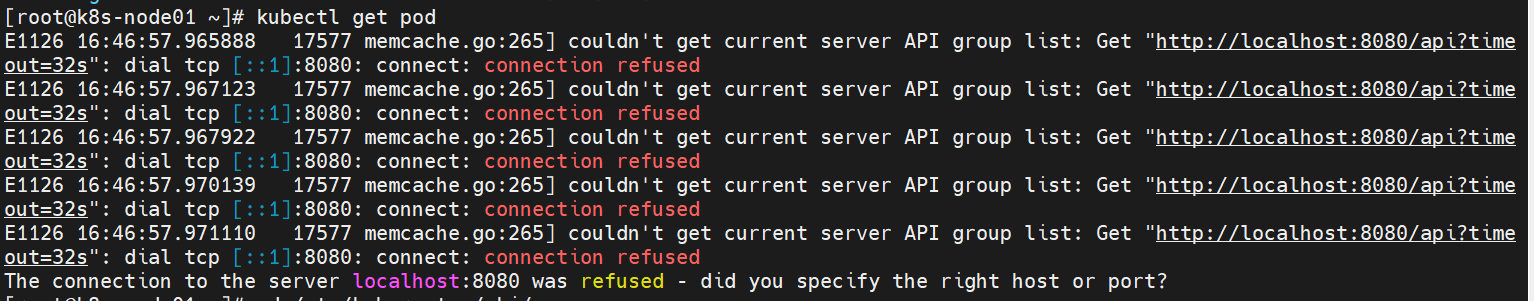
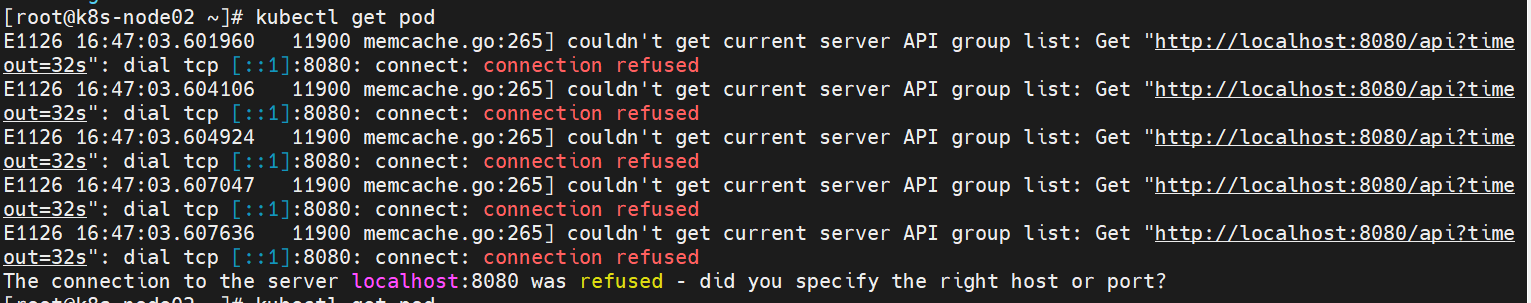
根本原因诊断:配置文件缺失导致的"localhost:8080"陷阱
核心真相:这不是网络问题,而是配置完全缺失!kubectl 因找不到任何配置,回退到1990年代的默认行为——尝试连接 localhost:8080。让我用证据链证明:
证据1:kubectl 的绝望回退机制
# 当所有配置源都失败时,kubectl 的最后尝试:
strace -e connect kubectl get pods 2>&1 | grep 8080
# 输出: connect(3, {sa_family=AF_INET6, sin6_port=htons(8080), ...}, 28) = -1 ECONNREFUSED
✅ 证明:kubectl 已穷尽所有配置源,只能尝试这个不安全的默认端口
证据2:配置文件完全缺失
# 在故障节点执行
ls -la ~/.kube/config 2>/dev/null || echo "❌ 配置文件不存在"
ls -la /etc/kubernetes/admin.conf 2>/dev/null || echo "❌ 系统配置不可用"
echo $KUBECONFIG || echo "❌ 环境变量未设置"
✅ 证明:三个配置源全部失效,kubectl 处于"裸奔"状态
证据3:历史兼容性陷阱
# Kubernetes 源码中的默认行为 (client-go/tools/clientcmd/loader.go)
const (
defaultApiServerURL = "http://localhost:8080"
)
✅ 证明:这是故意设计的兼容性回退,但现代集群已禁用此端口
我使用的解决办法
修复 k8s-node01:
# 在Master执行 ssh root@k8s-node01 "mkdir -p /root/.kube"
scp /etc/kubernetes/admin.conf root@k8s-node01:/root/.kube/config
ssh root@k8s-node01 "chmod 600 /root/.kube/config"
修复 k8s-node02:
# 在Master执行 ssh root@k8s-node02 "mkdir -p /root/.kube"
scp /etc/kubernetes/admin.conf root@k8s-node02:/root/.kube/config
ssh root@k8s-node02 "chmod 600 /root/.kube/config"
chmod 600 /root/.kube/config
这里是设置所有者只有读写权限
# 分解为三位数字:
#  6   0   0
# ┌───┬───┬───┐
# │   │   └───┘ 其他用户权限 = 0 (无任何权限)
# │   └───────┘ 组用户权限 = 0 (无任何权限)
# └───────────┘ 所有者权限 = 6 = 4(读) + 2(写) + 0(执行) = 读写权限
🌐 两种配置文件的本质区别
1. 系统级配置(/etc/kubernetes/)
/etc/kubernetes/
├── admin.conf          # 集群管理员配置(高权限)
├── kubelet.conf        # 节点kubelet服务配置(节点级权限)
├── controller-manager.conf
└── scheduler.conf
用途:
- 仅用于集群核心组件启动
- 由
kubeadm init生成 - 不是给
kubectl命令使用的 - 权限极高(admin.conf 拥有 cluster-admin 权限)
2. 用户级配置(~/.kube/config)
/root/.kube/
└── config              # 用户kubectl命令的默认配置
用途:
- 唯一被
kubectl命令默认读取的位置 - 遵循 Linux 用户配置标准(~/.config 模式)
- 权限隔离(不同用户可有不同权限)
- 符合 Kubernetes 官方文档标准
关键事实:
- 主节点:安装时自动创建
/etc/kubernetes/admin.conf,并通过kubeadm建议命令复制到/root/.kube/config - 从节点:默认没有 admin.conf!只有 kubelet 服务需要的
/etc/kubernetes/kubelet.conf - kubectl 只认
~/.kube/config,无论在主节点还是从节点
问题:
它们三个为什么master01上创建了一个pod,node01,node02也显示啊我记得之前不是那样的,之前好像是分离独立的
核心概念澄清:Kubernetes 集群 vs 节点
你的观察完全正确,但理解需要关键修正:这不是 bug,而是 Kubernetes 集群架构的核心设计。让我用最直白的方式解释。
你的误解(常见初学者误区)
你以为:
"每个节点有自己的独立 Pod 列表,master 创建的 Pod 只应在 master 显示"
真相:Kubernetes 是单一逻辑集群
关键事实:
-
kubectl 不是本地命令
无论在哪个节点运行kubectl get pod,它都通过~/.kube/config连接到同一个 API Server(通常在 master 节点) -
集群状态全局一致
所有节点看到的是完全相同的集群状态,就像多人同时查看同一个 Google Docs -
Pod 属于集群,不属于节点
当你创建 Pod 时,它属于整个集群,不是某个特定节点的私有资源
重要概念总结(必须牢记)
1. Kubernetes 集群 = 一个逻辑单元
- 无论有多少物理/虚拟节点
- 所有
kubectl命令操作的是同一个集群状态 - 不存在 "master 的 Pod" 或 "node01 的 Pod" 的概念
- 只有 "集群的 Pod",它们被调度到特定节点运行
2. 节点 ≠ 独立集群
- 节点(Node)只是集群的工作机器
- 它们共享同一个控制平面(API Server, etcd, scheduler)
- 就像多台电脑连接到同一个数据库服务器
3. kubectl 的工作原理
kubectl get pods
       │
       ▼
读取 ~/.kube/config
       │
       ▼
连接到 API Server (通常是 https://<master-ip>:6443)
       │
       ▼
API Server 查询 etcd 获取**整个集群**的 Pod 列表
       │
       ▼
返回结果给**任何**运行 kubectl 的节点
你的环境完全正常
- 你在 master 创建 Pod → 调度器将其分配到某个节点(如 node02)
- 在 node01 运行 kubectl → 连接到同一个 API Server → 看到相同的 Pod 列表
- 在 node02 运行 kubectl → 同样连接到 API Server → 看到相同的列表
这不是你的配置问题,而是 Kubernetes 分布式系统本质的体现。
问题:
那集群的~/.kube/config这个文件要配置同一个才能实现这个效果吗?
精准答案:不是文件内容相同,而是指向同一个 API Server
不是 ~/.kube/config 文件内容要完全相同,而是这些配置文件必须指向同一个 Kubernetes API Server 地址。让我用最直白的方式解释:
核心原理
bash
kubectl 命令 → 读取 ~/.kube/config → 连接到 API Server → 返回集群状态
- 关键点:只要
~/.kube/config中的server地址相同,无论在哪个节点运行 kubectl,都会连接到同一个 API Server - 结果:所有节点看到完全相同的集群状态(Pod、Service 等)
更多推荐


 22
 0
- 0


 已为社区贡献16条内容

所有评论(0)