
【机器学习】案例1.1——解析解求线性回归
·
# -------------------------- 代码功能说明 --------------------------
# 本代码通过"解析解(正规方程)"实现简单线性回归模型的训练与预测
# 解析解是线性回归的闭式解,直接通过矩阵运算求解最优参数θ(包含截距项w0和系数w1)
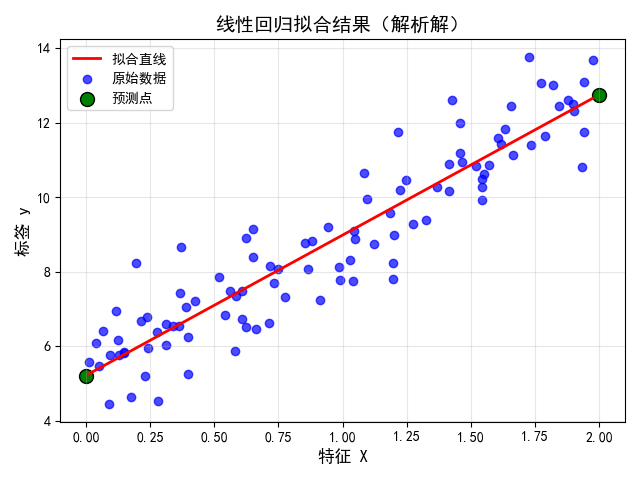
# 新增:可视化原始数据、拟合直线、预测点,直观验证模型效果


# -------------------------- 导入依赖库 --------------------------
# 导入numpy库,命名为np,用于数值计算(矩阵、数组操作)
import numpy as np
# 导入matplotlib的pyplot模块,命名为plt,用于绘图(可视化数据与模型)
import matplotlib.pyplot as plt
# 解决matplotlib中文显示问题(Windows系统)
plt.rcParams['font.sans-serif'] = ['SimHei']  # 用黑体显示中文
plt.rcParams['axes.unicode_minus'] = False    # 正常显示负号

# -------------------------- 固定随机种子(保证结果可复现) --------------------------
# 设置numpy随机数生成器的种子为42,确保每次运行代码生成的随机数完全一致
np.random.seed(42)


# -------------------------- 生成模拟数据集(线性回归的训练数据) --------------------------
# 生成特征X:100个样本,每个样本是1个特征
# np.random.rand(100, 1):生成100行1列的数组,元素是[0,1)区间的均匀分布随机数
# 乘以2后,X的取值范围变为[0, 2),形状为(100, 1)
X = 2 * np.random.rand(100, 1)
# 打印X的样本数量(验证是否是100个)
print(len(X))
# 打印X的具体数值,查看特征数据分布
print(X)


# 生成标签y:模拟"带噪声(误差)的真实线性关系"
# 真实模型是 y = 5 + 4*X + 噪声(5是截距w0,4是特征X的系数w1)
# np.random.randn(100, 1):生成100行1列的数组,元素是服从标准正态分布(均值0、方差1)的噪声
y = 5 + 4 * X + np.random.randn(100, 1)


# -------------------------- 构造含偏置项的特征矩阵(适配解析解公式) --------------------------
# 线性回归的解析解公式需要特征矩阵包含"偏置项对应的特征x0=1"
# np.ones((100, 1)):生成100行1列的全1数组(对应每个样本的x0=1)
# np.c_[]:按列拼接数组,将全1数组(偏置项列)与原特征X拼接,得到形状为(100, 2)的特征矩阵X_b
# X_b的每一行是 [x0, x1],其中x0=1,x1是原特征X的取值
X_b = np.c_[np.ones((100, 1)), X]


# -------------------------- 用解析解(正规方程)求解线性回归参数θ --------------------------
# 解析解公式:θ = (X_b^T · X_b)^(-1) · X_b^T · y
# 其中:
# X_b^T:X_b的转置矩阵
# ·:矩阵乘法(np.dot实现)
# (-1):矩阵的逆(np.linalg.inv实现)
# θ是形状为(2, 1)的数组,对应 [w0(截距), w1(特征系数)]
θ = np.linalg.inv(X_b.T.dot(X_b)).dot(X_b.T).dot(y)
# 打印求解得到的参数θ,理想情况下接近真实值[5, 4](因噪声存在会略有偏差)
print("线性回归参数θ(w0, w1):", θ)


# -------------------------- 用训练好的模型做预测 --------------------------
# 定义新的待预测特征X_new:2个样本,特征值分别为0和2
X_new = np.array([[0],  # 第一个待预测样本的特征
                  [2]]) # 第二个待预测样本的特征

# 构造新样本的特征矩阵(同样需要加偏置项x0=1)
# np.ones((2, 1)):2个样本对应的偏置项列
# 拼接后X_new_b形状为(2, 2),每一行是 [1, 特征值]
X_new_b = np.c_[np.ones((2, 1)), X_new]
# 打印新样本的特征矩阵,验证格式
print("新样本特征矩阵(含偏置项):", X_new_b)

# 预测:用特征矩阵点乘参数θ,得到预测值y_predict
# 线性回归的预测公式是 y = X_b · θ
y_predict = X_new_b.dot(θ)
# 打印预测结果,可对比真实模型(5+4*0=5、5+4*2=13),因噪声会略有差异
print("新样本预测值:", y_predict)


# -------------------------- 新增:可视化拟合结果(核心绘图逻辑) --------------------------
# 1. 绘制原始数据散点图
# plt.scatter():绘制散点图
# X[:, 0]:将X(100,1)数组转为一维数组(便于绘图),作为x轴坐标
# y[:, 0]:将y(100,1)数组转为一维数组,作为y轴坐标
# color='blue':散点颜色设为蓝色
# alpha=0.7:透明度0.7(避免点重叠时看不清)
# label='原始数据':设置图例名称,后续通过plt.legend()显示
plt.scatter(X[:, 0], y[:, 0], color='blue', alpha=0.7, label='原始数据')

# 2. 绘制线性回归拟合直线(覆盖整个特征范围,保证直线平滑)
# 生成特征范围:从X的最小值到最大值,生成100个均匀分布的点(确保直线连续)
X_range = np.linspace(X.min(), X.max(), 100).reshape(-1, 1)  # 形状(100,1)
# 构造拟合直线的特征矩阵(加偏置项x0=1)
X_range_b = np.c_[np.ones((100, 1)), X_range]
# 计算拟合直线的y值(用训练好的参数θ预测)
y_range_predict = X_range_b.dot(θ)
# plt.plot():绘制折线图(此处因点连续,表现为直线)
# color='red':直线颜色红色
# linewidth=2:线宽2(更醒目)
# label='拟合直线':图例名称
plt.plot(X_range[:, 0], y_range_predict[:, 0], color='red', linewidth=2, label='拟合直线')

# 3. 标记预测点(突出显示待预测样本的结果)
# plt.scatter():绘制预测点
# X_new[:, 0]:待预测样本的特征值(x轴坐标)
# y_predict[:, 0]:待预测样本的预测值(y轴坐标)
# color='green':颜色绿色
# s=100:点的大小(比原始数据点大,更显眼)
# edgecolors='black':点的边框黑色(增强对比)
# label='预测点':图例名称
plt.scatter(X_new[:, 0], y_predict[:, 0], color='green', s=100, edgecolors='black', label='预测点')

# 4. 优化图表可读性
# 设置图表标题(中文支持,需确保matplotlib配置了中文字体)
plt.title('线性回归拟合结果(解析解)', fontsize=14)
# 设置x轴标签
plt.xlabel('特征 X', fontsize=12)
# 设置y轴标签
plt.ylabel('标签 y', fontsize=12)
# 显示图例(根据各元素的label自动生成)
plt.legend(fontsize=10)
# 显示网格线(便于读取坐标)
plt.grid(True, alpha=0.3)
# 调整布局(避免标签被截断)
plt.tight_layout()
# 显示图表(执行后弹出窗口展示)
plt.show()
更多推荐


 3
 0
- 0


 已为社区贡献168条内容

所有评论(0)