
机器学习之支持向量机(SVM)
支持向量机(Support Vector Machines,SVM)是一种二元分类模型。核心思想是,训练阶段在特征空间寻找一个超平面,它能将训练样本中的正例和负例分离在它的两侧,预测时以该超平面作为决策边界判断输入实例的类别。
寻找超平面的原则是,在可分离的情况下使超平面与数据集间隔最大化。支持向量机是一类模型的统称,其中包括线性可分支持向量机、线性支持向量机、非线性支持向量机。
一.线性可分支持向量机
1.分离超平面
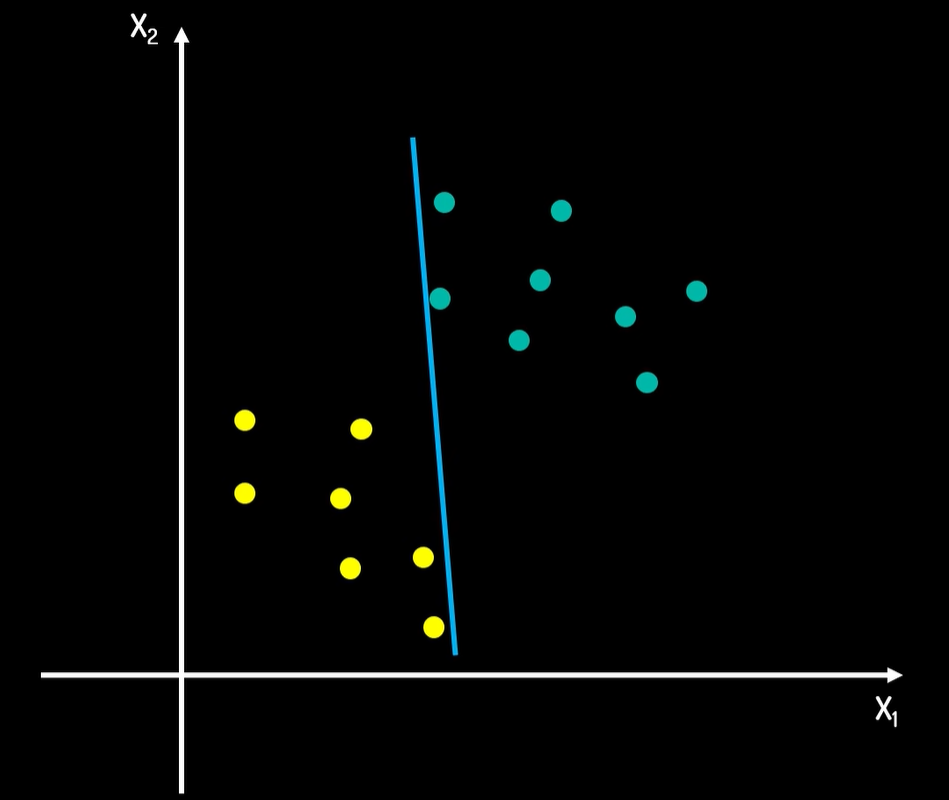
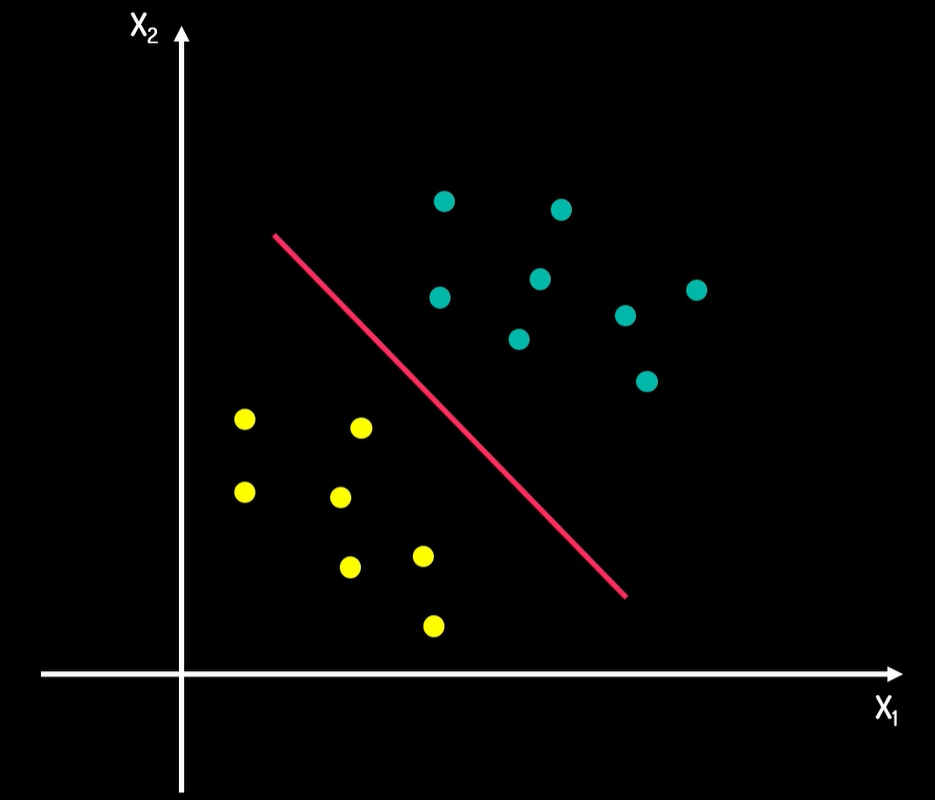
假设有数据集D,其中的样本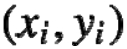 有两种类别,分别称为正例和负例。如果特征空间内存在某个超平面能将正例和负例完全正确地分离到它的两侧,则称数据集D为线性可分数据集;不存在则为线性不可分数据集。

( 此图为一个线性可分数据集)
空间中的一个超平面可以用如下方程表示:
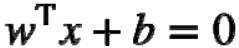
其中,w为平面的法向量,b为截距。
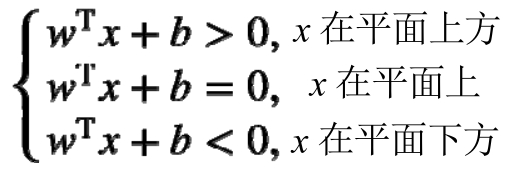
2.间隔最大化
对于一个线性可分数据集,实际上有无穷个超平面可以完全正确地将正例和负例分离,不同分法效果不同,我们要从中挑选最佳的作为决策边界。一个样本点距离超平面越远则被正确分类的概率越高。
样本点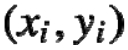 到超平面的几何间隔为:
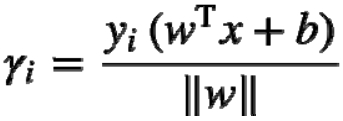
函数间隔为:
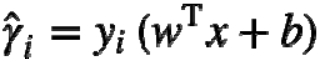
(几何间隔为真实距离,与超平面参数缩放无关;函数间隔为w、b缩放后的距离,是相对远近)
故几何间隔/函数间隔即为 (向量w的范数),即
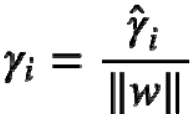
此处d维向量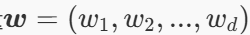 有:
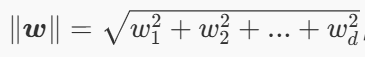
经过一系列整理后,可得出约束表达式:
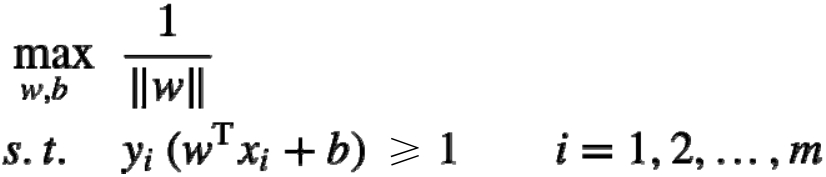
则可转化为求:
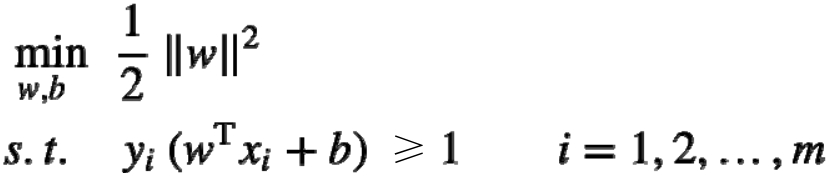
上述过程阐述了如何取得最大化间隔,即此时分类效果可达到最佳,对最后方程进行求解即得到最大间隔分离超平面。接下来进行求解。
3.拉格朗日对偶法
求解凸二次规划问题,可先利用拉格朗日对偶性将原始问题转换为对偶问题,再通过求解对偶问题得到原始问题的解。简单来说就是通过引入一个中间变量,把带约束的难题变成两个更容易的小问题解决。
简单来说拉格朗日对偶法的步骤可分为:
- 构造拉格朗日函数:
把约束绑到目标函数上,得到,λ≥0为拉格朗日乘子,用于惩罚不满足约束的情况;f(x)为要实现最小化的目标函数;g(x)≤0为约束条件
- 求“极小极大”(原问题)
先固定λ,找到让L(x,λ)最小的x;再调整λ,让这个最小值尽可能大(确保约束被满足)- 求“极大极小”(对偶问题)
先固定x,找到让L(x,λ)最大的λ;在调整x,让这个最大值尽可能小
代入相关公式,对偶问题变为:

等价于:
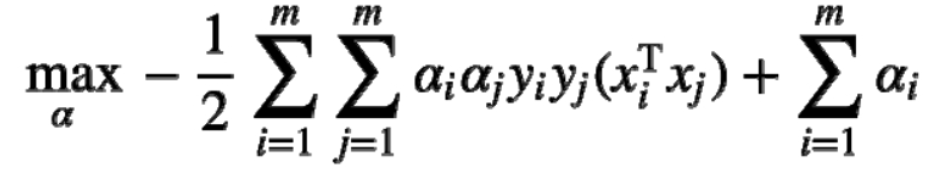
带入求得原始问题的解即为:
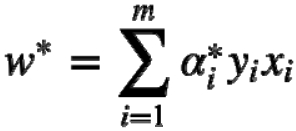
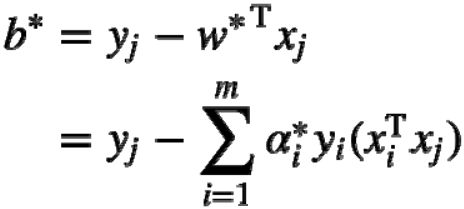
4.分类决策函数
如果找到了数据集D的最大间隔分离超平面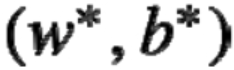 ,便可以用其构建分类器:根据输入实例x位于超平面的哪一侧,判定为正例还是负例。
分类决策函数为:
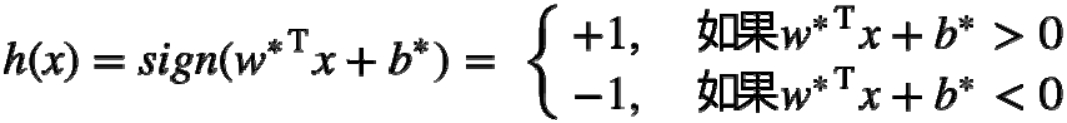
5.线性可分支持向量机算法
总结线性可分支持向量机算法。
1)构造并求解约束最优化问题,求得 ;
2)计算原始问题最优解的 ,
 ;
3)构造分类决策函数
二.线性支持向量机
1.软间隔最大化
对于一些线性不可分数据集,无法找到一个超平面使其所有样本点满足:
,为了解决这个问题,对每个样本点引进松弛变量
≥0,放宽约束条件:
为了使放宽适度,需要对每一个
的“惩罚”。其中C为惩罚系数,大小根据具体问题而定,C越大,对于错误分类的惩罚越重。
线性支持向量机挑选分离超平面的准则为“软间隔最大化”,约束最优化问题变为:
可推导出:
,
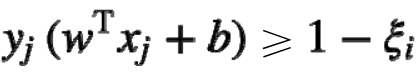
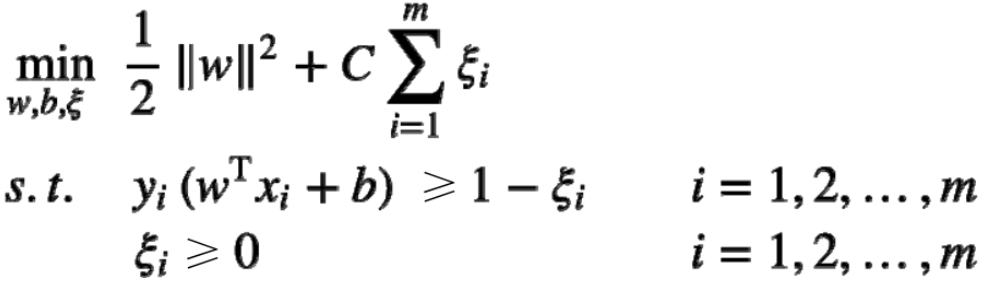
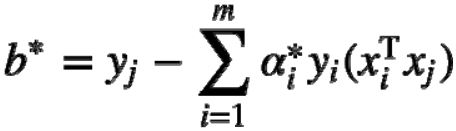
可看出分离超平面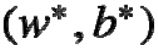 计算公式与线性可分支持向量机的完全相同。此类的支持向量不仅仅位于间隔边界上(函数间隔为1),也可能位于间隔边界与分离超平面之间,甚至位于分离超平面误分的一侧。当
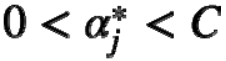 时,相应
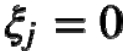 ,支持向量位于间隔边界上,则可计算出
 。

2.线性支持向量机算法
总结线性支持向量机算法。
1)选取适当惩罚系数C,构造并求解约束最优化问题,求得 ;
2)计算原始问题最优解 ,

3)构造分类决策函数
三.非线性支持向量机
1.空间变换
前两种均为线性分类问题,但有时还会面对非线性分类问题,即无法用直线将数据分开。那么我们使用超曲面进行分类而非超平面。
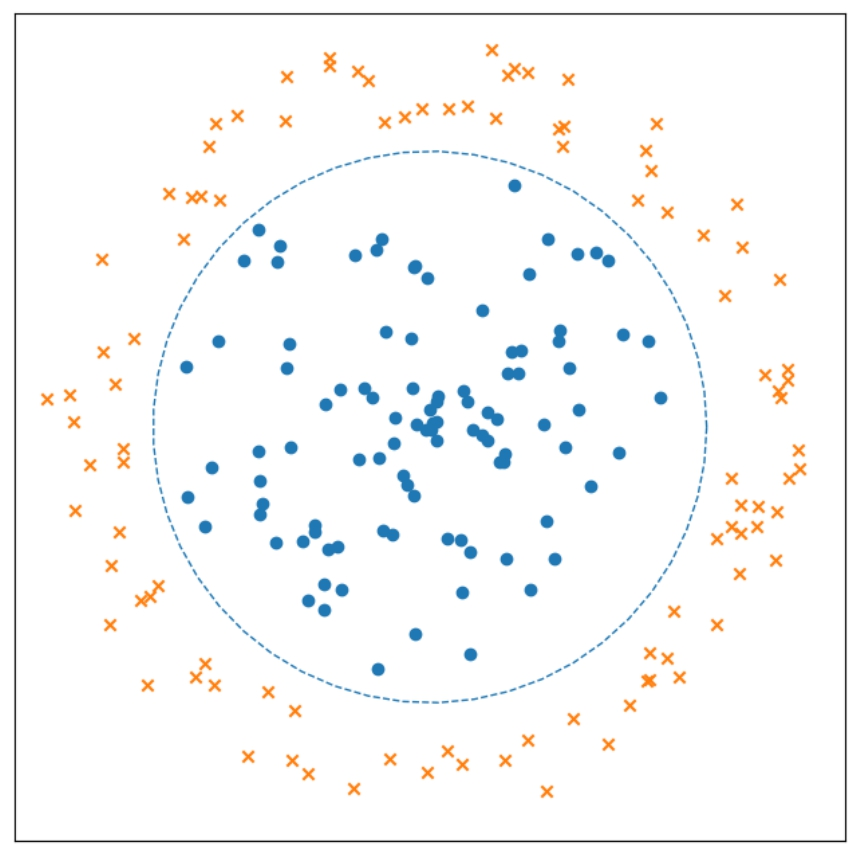
求解分离超曲面往往比超平面复杂得多,因此在面对非线性分类问题时,我峨嵋你希望能将其转化为线性问题,从而降低求解难度。方法就是使用某种非线性变换 ,将原来的数据集映射到更高维的空间中。
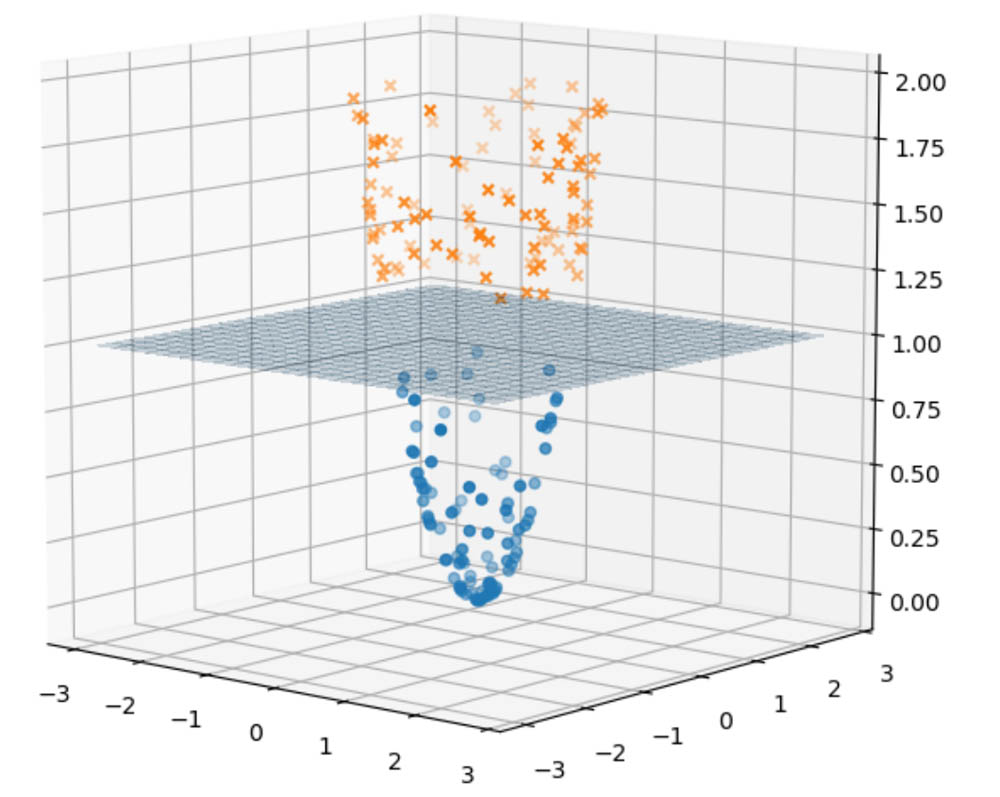
如图,该数据集的非线性变换函数为:
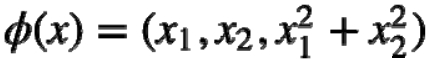
(为原数据增加了一个大小为 的新维度,变为线性分类问题)
2.核技巧
使用非线性变换会面临新问题:如果映射后的空间维度很高(甚至是无限维),将导致运行过程中存储空间和计算资源开销过大,导致有时无法实现。这时就要利用核技巧解决这个问题。核技巧的核心思想是,利用核函数直接计算映射到空间H后实例间的内积,以此代替先做映射再计算内积。简单来说就是直接算出变形后数据的关联度(内积)。
以下是几种常用的核函数:
1)多项式核(poly,Polynomial Kernel)
2)高斯核(rbf,Radial Basis Function)
3)拉普拉斯核(Laplacian Kernel,sklearn.svm未提供 须自定义)
4)Sigmoid核
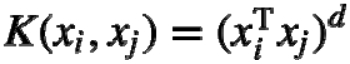
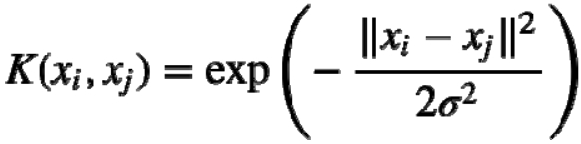
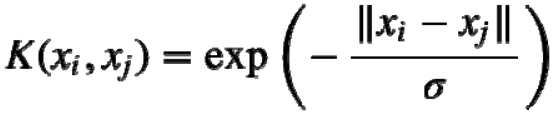
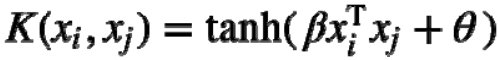
3.非线性支持向量机算法
总结线性支持向量机算法。
1)选取适当惩罚系数C以及核函数K,构造并求解约束最优化问题,求得;
2)计算原始问题最优解,
3)构造分类决策函数
四.SMO算法(序列最小优化算法)
1.两个变量最优化问题的求解
SMO 通过每次仅优化 2 个拉格朗日乘子(而非全部)来简化计算,利用约束条件将双变量优化转化为单变量问题,最终得到这两个乘子的最优值。
2.变量选择
需选择 “违反 KKT 条件最严重” 的乘子作为第一个变量(工作集),再选择与第一个变量相关性高的乘子作为第二个变量,以加快收敛
3.更新b
优化乘子后,需重新计算 SVM 决策函数中的偏置项 b,确保分类边界的正确性。
4.更新E缓存
E 缓存存储的是每个样本的预测误差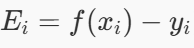 ,更新乘子后需同步更新对应的 E 值,为后续变量选择提供依据
更多推荐


 10
 0
- 0


 已为社区贡献2条内容

所有评论(0)