
大模型常见重权格式与推理框架配对指南
面对开源大模型社区中琳琅满目的权重文件(如qwen-7b-q4_0.gguf、llama3-8b-gptq-4bit),以及各式各样的推理框架(如Ollama、vLLM、llama.cpp),你是否曾感到困惑:它们之间有何区别?我又该如何为我的项目选择最佳的组合?
本文将为你彻底厘清这些概念,提供一份从格式解析到工具选择的完整指南。
一、 核心概念:为什么需要不同的权重格式?
大模型拥有数百亿甚至数千亿参数,如果以全精度(如FP32)存储,一个70亿参数的模型就需要约28GB空间。这对存储、传输,尤其是推理时的GPU显存构成了巨大挑战。
量化技术 应运而生。其核心思想是降低权重的数值精度,用极小的精度损失换取显存占用和推理速度的大幅优化。而不同的量化算法和存储方案,就产生了不同的权重格式。
|
精度 |
每个参数大小 |
70亿模型大小 |
特点 |
|---|---|---|---|
|
FP32 |
4字节 |
28 GB |
全精度,主要用于训练 |
|
BF16/FP16 |
2字节 |
14 GB |
半精度,常用的原始推理精度 |
|
INT8 |
1字节 |
7 GB |
量化起点,精度损失很小 |
|
INT4 |
0.5字节 |
3.5 GB |
性价比之王,个人玩家首选 |
现在,让我们看看主流的权重格式。
二、 主流权重格式详解
1. GGUF:个人玩家的福音
-
设计目标:取代旧的GGML格式,成为
llama.cpp的官方格式。专注于在消费级硬件(甚至是CPU和Mac)上高效运行。 -
核心技术:支持内存卸载。允许将模型的一部分层保留在CPU的系统内存中,只在需要时调入GPU计算,从而实现在小显存GPU上运行超大模型。
-
文件示例:
qwen2-7b-q4_k_m.gguf -
优势:硬件门槛极低,灵活性超高,社区资源丰富。
-
劣势:在拥有大显存的高端GPU上,纯GPU推理速度通常不及GPTQ。
2. GPTQ:NVIDIA GPU的性能猛兽
-
设计目标:一种训练后量化算法,为NVIDIA GPU实现极致的推理速度。
-
核心技术:使用校准数据集,对模型权重进行一次性优化,找到最优的低比特整数表示。通常需要整个模型都能加载到GPU显存中。
-
文件示例:
Llama-2-7B-Chat-GPTQ -
优势:在支持的GPU上,推理速度极快。
-
劣势:不够灵活,通常不支持CPU卸载,模型文件与特定GPU架构绑定。
3. AWQ:精度与速度的平衡者
-
设计目标:一种先进的训练后量化算法,旨在实现比GPTQ更优的精度-速度权衡。
-
核心技术:激活感知权重量化。保护对模型输出影响更大的重要权重,只对次要权重进行激进量化。
-
文件示例:
llama3-8b-instruct-awq -
优势:同等比特下精度通常更高。
-
劣势:推理速度可能略慢于GPTQ,社区预量化模型相对较少。
4. 原始格式(.safetensors / .bin):官方标准件
-
设计目标:存储原始的、未量化的高精度模型(通常是FP16/BF16)。
-
核心技术:
.safetensors是一种安全、加载快速的存储格式,替代了旧的.bin。 -
文件示例:
model-00001-of-00002.safetensors -
优势:精度最高,灵活性最强,可用于继续训练或微调。
-
劣势:体积巨大,对推理硬件要求最高。
一张表快速总结:
|
格式 |
核心特点 |
量化类型 |
硬件友好性 |
易用性 |
|---|---|---|---|---|
|
GGUF |
CPU/Mac优先,内存卸载 |
整数量化 |
⭐⭐⭐⭐⭐ |
⭐⭐⭐⭐⭐ |
|
GPTQ |
NVIDIA GPU速度最优 |
整数量化 |
⭐⭐⭐⭐ (NVIDIA) |
⭐⭐⭐ |
|
AWQ |
精度与速度的平衡 |
整数量化 |
⭐⭐⭐⭐ (NVIDIA) |
⭐⭐⭐ |
|
原始格式 |
官方标准,用于微调 |
无(FP16/BF16) |
⭐⭐ (要求高) |
⭐⭐ |
三、 推理工具/框架:如何运行这些格式?
不同的权重格式需要合适的“引擎”来驱动。以下是主流的推理框架及其定位。
1. Ollama:零配置的终极选择
-
支持格式:GGUF
-
核心优势:极致简单。通过一条命令(
ollama run llama3.1:8b)完成模型的下载、加载和运行,自动管理所有依赖。 -
适用场景:个人学习、快速原型验证、不熟悉技术的用户。
-
工作流:
# 安装后,一行命令即可
ollama run qwen2:7b
2. llama.cpp:GGUF格式的创造者
-
支持格式:GGUF
-
核心优势:GGUF格式的底层引擎,效率和灵活性极高,尤其擅长CPU和混合推理。Ollama和LM Studio都以其为核心。
-
适用场景:开发者、研究者、需要精细控制推理参数的高级用户。
-
工作流:
./main -m /path/to/model.gguf -p "Hello" -n 100 -ngl 99
3. vLLM:生产环境的吞吐量王者
-
支持格式:原始模型、GPTQ、AWQ
-
不支持格式:GGUF
-
核心优势:革命性的PagedAttention技术,为高并发场景提供极致吞吐量。提供生产级的API服务。
-
适用场景:需要部署高并发API服务的云端和生产环境。
-
工作流:
# 启动API服务器
vllm serve Qwen/Qwen2-7B-Chat

# 然后通过OpenAI兼容的API调用
curl http://localhost:8000/v1/chat/completions ...
4. Hugging Face Transformers:万能标准库
-
支持格式:原始模型(支持运行时动态量化)
-
核心优势:事实上的行业标准,灵活性最高,可用于推理、训练和微调。
-
适用场景:研究、实验、模型微调,以及任何需要最大控制力的Python项目。
-
工作流:
from transformers import AutoModelForCausalLM
model = AutoModelForCausalLM.from_pretrained("Qwen/Qwen2-7B-Chat")
5. LM Studio:图形界面王者
-
支持格式:GGUF
-
核心优势:提供美观易用的图形化界面,内置模型市场,无需命令行操作。
-
适用场景:Windows/Mac用户,偏好图形界面操作,不希望接触命令行的初学者。
四、 如何选择?一份终极决策指南
选择的关键在于明确你的主要场景。下面的流程图可以帮你快速做出决定:
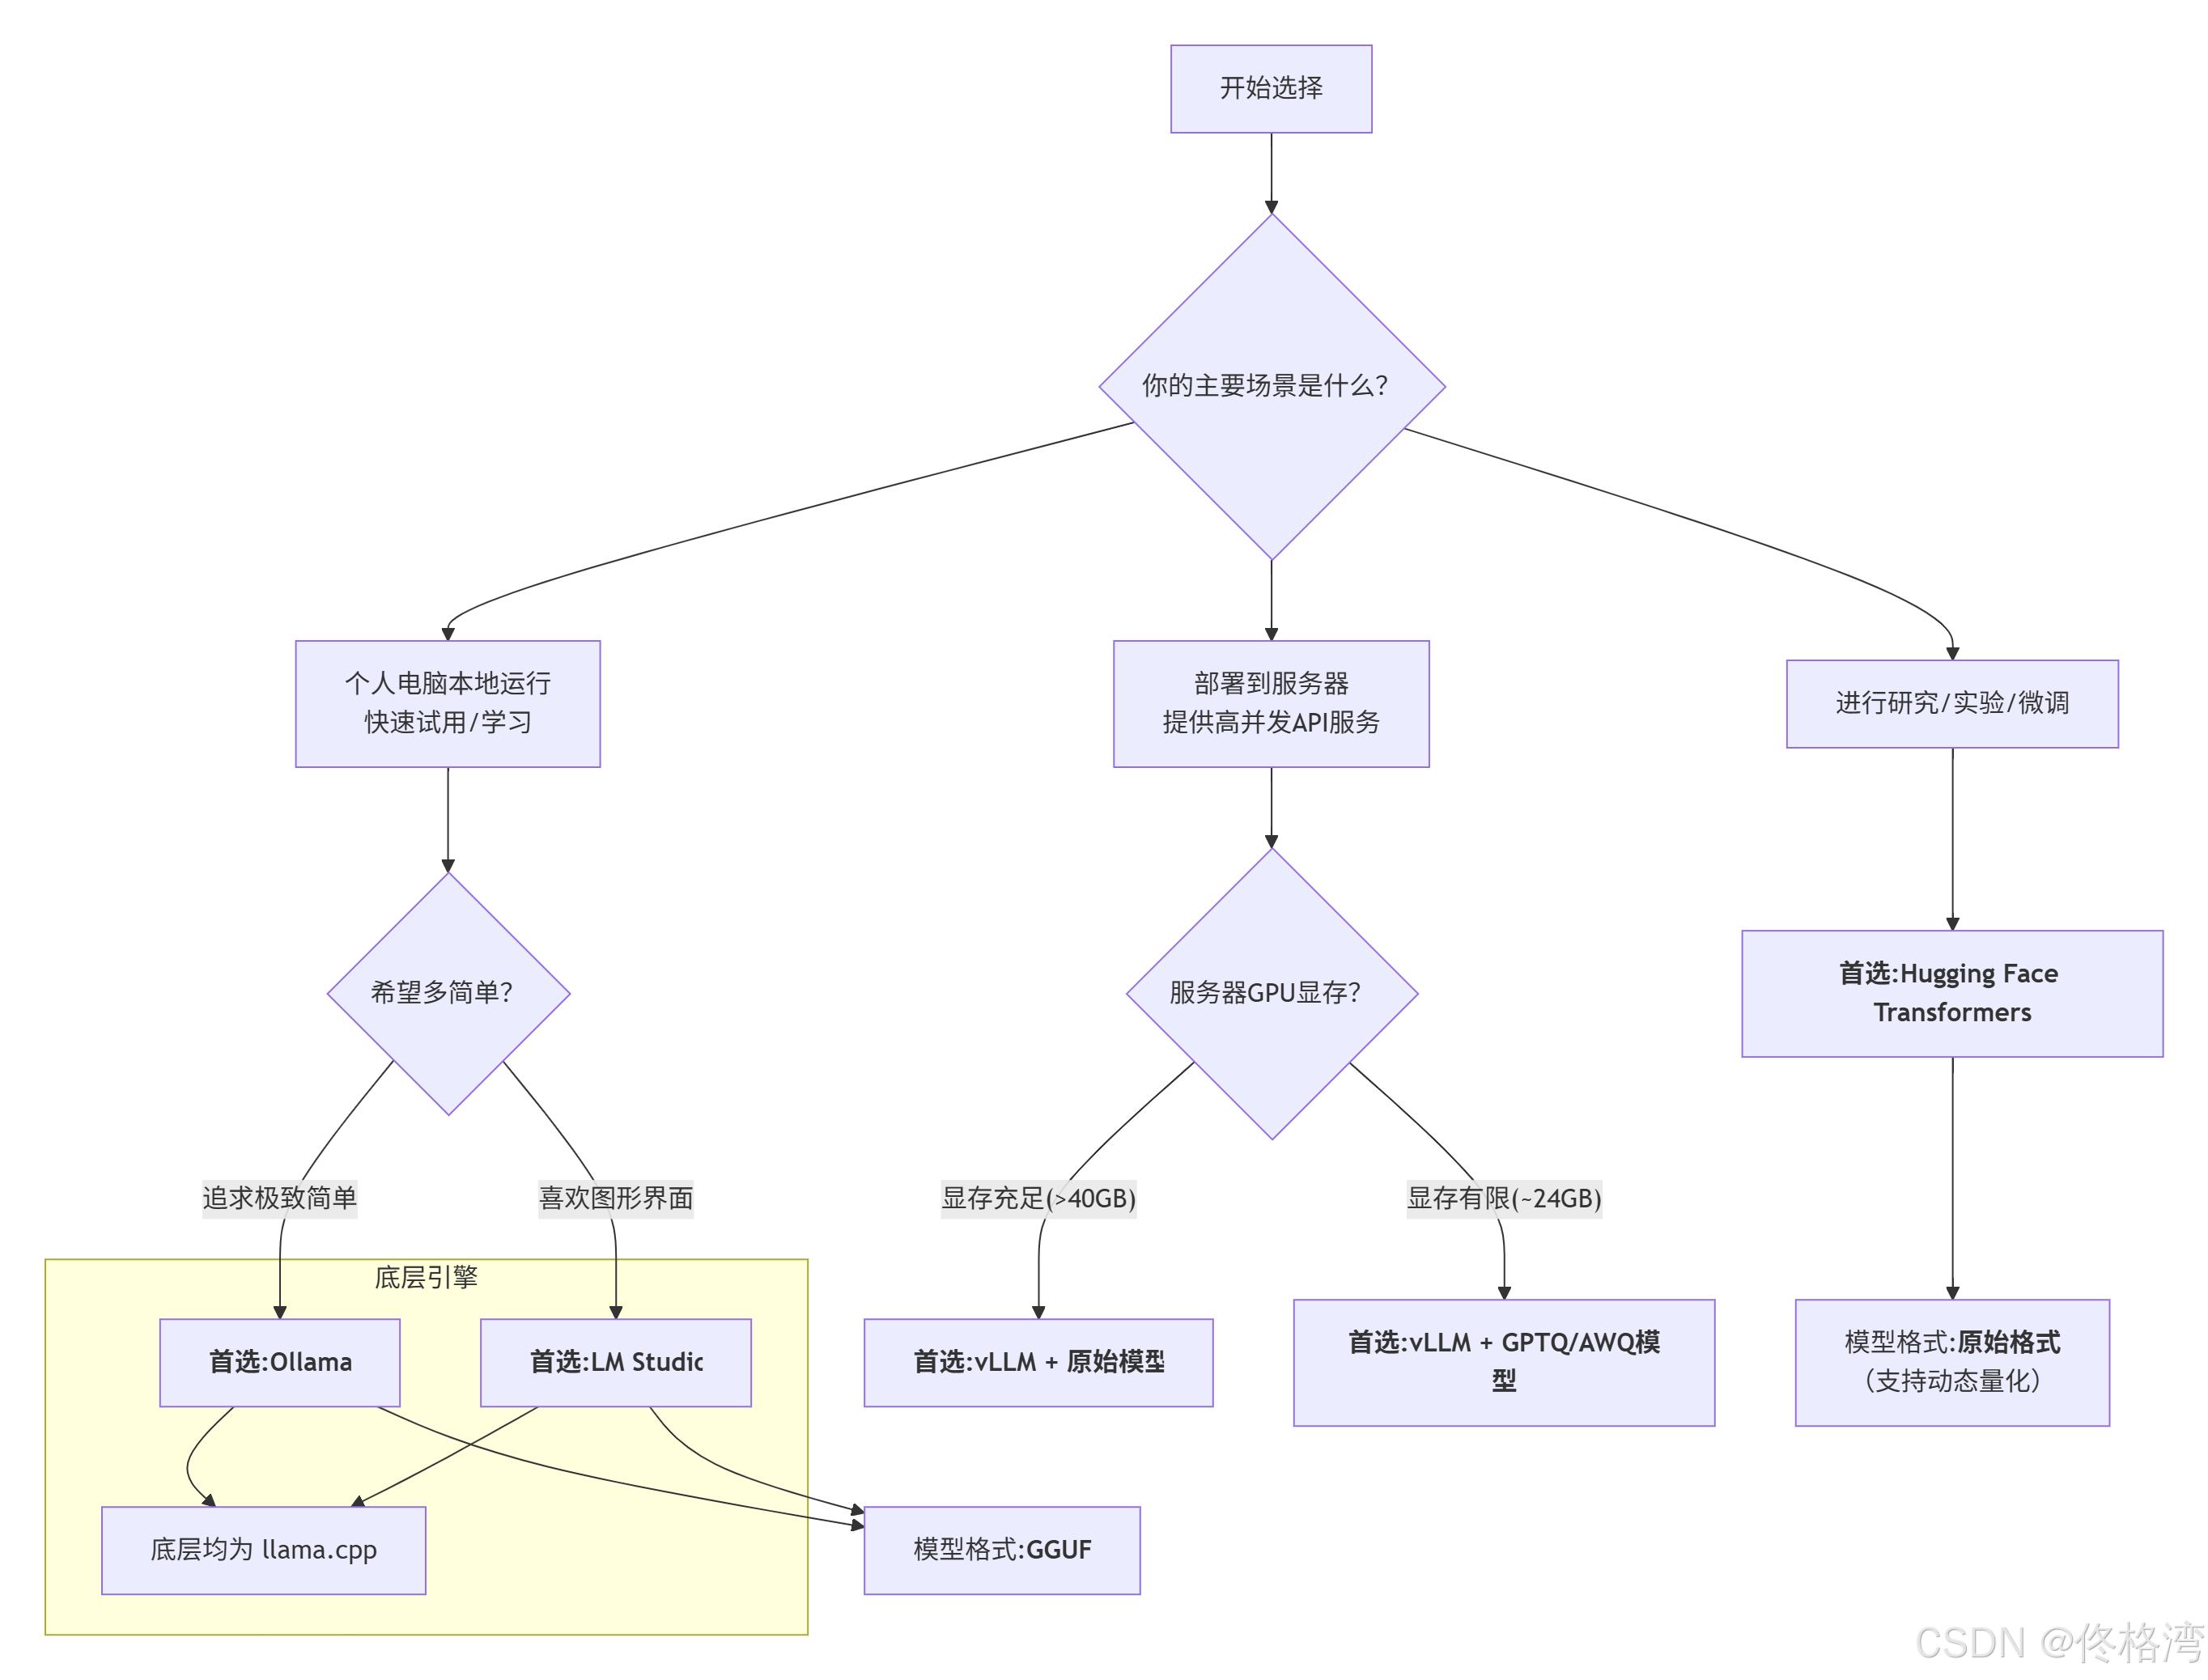
总结一下黄金法则:
-
个人玩家,快速开始:Ollama + GGUF格式模型。这是最省心、最普适的组合。
-
部署服务,追求性能:vLLM + GPTQ/AWQ格式模型。这是生产环境的高性能组合。
-
研究开发,需要灵活:Hugging Face Transformers + 原始模型。这是最基础、最灵活的组合。
希望这份指南能帮助你在大模型的海洋中清晰导航,为你接下来的项目选择最合适的“装备”。
更多推荐


 16
 0
- 0


 已为社区贡献4条内容

所有评论(0)