
RAG大模型处理本地Excel且支持多轮对话
·
甲方想要输入语句就可以获得相应的Excel(真是够懒的),最合适的方案就是RAG(Retrieval-Augmented Generation)检索增强生成 成为最常用的方案。
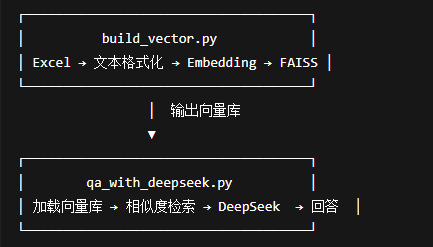
原理就是为大模型补充知识,适应本地“知识”
-
Excel 本地文档向量化
-
使用 FAISS 构建向量库
-
text2vec 做中文 Embedding
-
DeepSeek-V3 完成最终问答
-
本地Excel文件作为“补充知识”
一、构建向量库:build_vector.py
-
从 Excel 读取行数据
-
格式化为统一的 RAG 文本片段
-
使用 text2vec-base-chinese 向量化
-
将所有 Document 存入 FAISS 向量库
将每行 Excel 转为稳定结构的文档
def row_to_text(row):
    parts = [
        f"序号:{row.get('序号','')}",
        f"名称:{row.get('名称','')}",
        f"编号:{row.get('编号','')}",
        f"调查结果:{row.get('调查结果','')}",
        ...
        f"简介:{row.get('简介','')}"
    ]
    return "\n".join(parts)
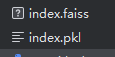
构建 FAISS 数据库
embeddings = SentenceTransformerEmbeddings(
    model_name="shibing624/text2vec-base-chinese"
)
db = FAISS.from_documents(docs, embeddings)
db.save_local(INDEX_DIR)
生成
材料统一“[文档 i] id + 名称” snippet 截断到 1200 字避免过长 每条事实要求标注来源 若资料不足必须明确指出
def make_prompt(query, retrieved_docs):
    # Prompt 开头说明模型角色和规则
    header = (
        "你是中文专业信息检索助理。下面给出检索到的材料,请 *仅基于这些材料* 回答问题。\n"
        "如果材料不足,请回答:资料不足以判断。\n\n"
    )

    materials = []
    for i, doc in enumerate(retrieved_docs, start=1):
        meta = doc.metadata or {}
        seq = meta.get("seq", "")   # 文档 id
        name = meta.get("name", "") # 文档名称

        # snippet 截断到 1200 字
        snippet = doc.page_content[:1200].strip()
        # 每条文档统一格式 [文档 i] id + 名称
        materials.append(f"[文档 {i}] id:{seq} 名称:{name}\n{snippet}\n")

    # Prompt 结尾要求回答格式
    footer = (
        "\n回答要求:\n"
        "1) 不超过 300 字\n"
        "2) 每个事实后用【来源: 文档编号(id), 名称】标注出处\n"
        "3) 若材料不足,则说明需要哪些额外信息\n\n"
    )

    return header + "\n".join(materials) + footer + f"用户问题:{query}\n回答:"
二、问答系统:qa_with_deepseek.py
-
加载向量库
-
执行相似度搜索(Top-K)
-
构造 Prompt(引用来源、格式化材料)
-
发送到 DeepSeek-V3 API
-
输出最终答案
加载向量库与 Embedding
embeddings = HuggingFaceEmbeddings(model_name="shibing624/text2vec-base-chinese")
db = FAISS.load_local(INDEX_DIR, embeddings, allow_dangerous_deserialization=True)
构造 Prompt:高质量 RAG 的灵魂
header = (
    "你是中文专业信息检索助理..."
)
...
footer = (
    "1) 不超过 300 字\n"
    "2) 每个事实后用【来源: 文档编号(id), 名称】标注出处\n"
    "3) 若材料不足,则说明需要哪些额外信息\n\n"
)
DeepSeek API 调用
payload = {
    "model": MODEL_NAME,
    "messages": [
        {"role": "system", "content": "你是专业中文信息检索助手。"},
        {"role": "user", "content": prompt}
    ],
}
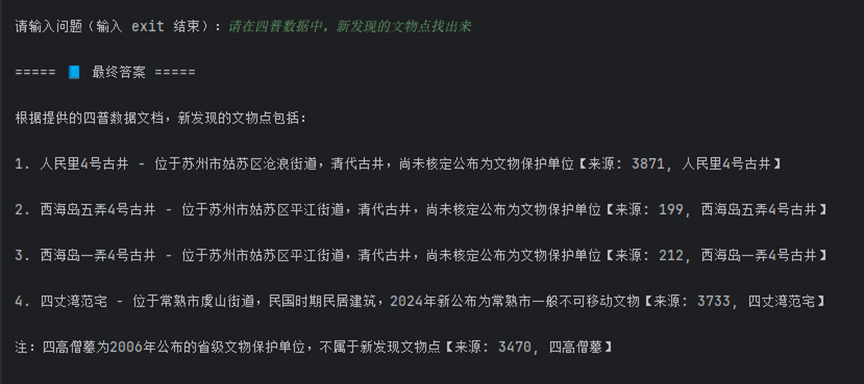
检索 + 回答
docs = db.similarity_search(query, k=5)
prompt = make_prompt(query, docs)
resp_json = call_deepseek(prompt)
整个 pipeline 通过 CLI 交互式运行
if __name__ == "__main__":
    print("🚀 加载成功!向量库目录:", INDEX_DIR)

    while True:
        q = input("\n请输入问题(输入 exit 结束):").strip()  # CLI 交互

        if q.lower() in ("exit", "quit"):
            break

        try:
            retrieve_and_answer(q, k=5)  # 整个 pipeline:检索 + DeepSeek 回答
        except Exception as e:
            print("❌ 错误:", e)
            print("请检查:API_KEY、API_URL、网络、或 DeepSeek 返回格式。")
三、完整代码
# build_vector.py
import pandas as pd
import os

from langchain_community.embeddings import SentenceTransformerEmbeddings
from langchain_community.vectorstores import FAISS
from langchain_core.documents import Document

EXCEL = "四普数据.xlsx"
INDEX_DIR = ""


def row_to_text(row):
    """把每一行转换成 RAG 用的统一文本格式"""
    parts = [
        f"序号:{row.get('序号','')}",
        f"名称:{row.get('名称','')}",
        f"编号:{row.get('编号','')}",
        f"调查结果:{row.get('调查结果','')}",

......................................................

        f"简介:{row.get('简介','')}"
    ]
    return "\n".join(parts)


def main():
    if not os.path.exists(EXCEL):
        raise FileNotFoundError(f"❌ 找不到 Excel 文件:{EXCEL}")

    print("📖 正在读取 Excel ...")
    df = pd.read_excel(EXCEL, dtype=str).fillna("")

    docs = []
    for idx, row in df.iterrows():
        text = row_to_text(row)

        metadata = {
            "seq": row.get("序号", "") or str(idx + 1),
            "name": row.get("名称", ""),
            "编号": row.get("编号", "")
        }

        docs.append(Document(page_content=text, metadata=metadata))

    print("🔍 正在加载中文向量模型 text2vec-base-chinese ...")
    embeddings = SentenceTransformerEmbeddings(
        model_name="shibing624/text2vec-base-chinese"
    )

    print("📦 正在构建 FAISS 向量库 ...")
    db = FAISS.from_documents(docs, embeddings)

    print("💾 正在保存向量库到本地 ...")
    db.save_local(INDEX_DIR)

    print("\n🎉 向量库构建完成!")
    print("📁 向量库目录:", INDEX_DIR)


if __name__ == "__main__":
    main()
# qa_with_deepseek.py
import os
import json
import requests
from langchain_community.embeddings import HuggingFaceEmbeddings
from langchain_community.vectorstores import FAISS


# ==== 配置 ====
API_KEY = "9b6b8bd0-    -4e53-ae63-91f89dbbddb8"
API_URL = "https://ark.cn-beijing.volces.com/api/v3/chat/completions"
MODEL_NAME = "deepseek-v3-250324"

INDEX_DIR = ""


# ==== 加载 Embedding 与向量库 ====
print("🔍 正在加载 Embedding:shibing624/text2vec-base-chinese ...")
embeddings = HuggingFaceEmbeddings(model_name="shibing624/text2vec-base-chinese")

print("📦 正在加载向量库 ...")
db = FAISS.load_local(
    INDEX_DIR,
    embeddings,
    allow_dangerous_deserialization=True  # ⚠ Windows + pickle 必须
)


# ==== 构造 Prompt ====
def make_prompt(query, retrieved_docs):
    header = (
        "你是中文专业信息检索助理。下面给出检索到的材料,请 *仅基于这些材料* 回答问题。\n"
        "如果材料不足,请回答:资料不足以判断。\n\n"
    )

    materials = []
    for i, doc in enumerate(retrieved_docs, start=1):
        meta = doc.metadata or {}
        seq = meta.get("seq", "")
        name = meta.get("name", "")

        snippet = doc.page_content[:1200].strip()
        materials.append(f"[文档 {i}] id:{seq} 名称:{name}\n{snippet}\n")

    footer = (
        "\n回答要求:\n"
        "1) 不超过 300 字\n"
        "2) 每个事实后用【来源: 文档编号(id), 名称】标注出处\n"
        "3) 若材料不足,则说明需要哪些额外信息\n\n"
    )

    return header + "\n".join(materials) + footer + f"用户问题:{query}\n回答:"


# ==== 调用 DeepSeek API ====
def call_deepseek(prompt, temperature=0.0, max_tokens=800):

    headers = {
        "Content-Type": "application/json",
        "Authorization": f"Bearer {API_KEY}",
    }

    payload = {
        "model": MODEL_NAME,
        "messages": [
            {"role": "system", "content": "你是专业中文信息检索助手。"},
            {"role": "user", "content": prompt}
        ],
        "temperature": temperature,
        "max_tokens": max_tokens
    }

    resp = requests.post(API_URL, headers=headers, data=json.dumps(payload))
    resp.raise_for_status()
    return resp.json()


# ==== 检索 + 问答 ====
def retrieve_and_answer(query, k=5):

    docs = db.similarity_search(query, k=k)

    prompt = make_prompt(query, docs)
    resp_json = call_deepseek(prompt)

    # 解析生成内容
    try:
        answer = resp_json["choices"][0]["message"]["content"]
    except:
        answer = str(resp_json)

    print("\n===== 📘 最终答案 =====\n")
    print(answer.strip())

    print("\n===== 🔎 检索到的文档(Top 5) =====\n")
    for i, d in enumerate(docs, start=1):
        meta = d.metadata or {}
        print(f"[文档 {i}] id:{meta.get('seq')} 名称:{meta.get('name')}")
        print(d.page_content[:500])
        print("\n")


# ==== 交互式 CLI ====
if __name__ == "__main__":
    print("🚀 加载成功!向量库目录:", INDEX_DIR)

    while True:
        q = input("\n请输入问题(输入 exit 结束):").strip()

        if q.lower() in ("exit", "quit"):
            break

        try:
            retrieve_and_answer(q, k=5)
        except Exception as e:
            print("❌ 错误:", e)
            print("请检查:API_KEY、API_URL、网络、或 DeepSeek 返回格式。")
更多推荐


 4
 0
- 0


 已为社区贡献3条内容

所有评论(0)