
深度学习实验——实现MNIST手写数字识别
- 🍨 本文为🔗365天深度学习训练营 中的学习记录博客
- 🍖 原作者:K同学啊
文章目录
1.简介
使用Pytorch构建一个CNN模型对MNIST手写数字数据集进行识别
2.环境
● 语言环境:Python 3.12.7
● 编译器:Jupyter Notebook
● 深度学习环境:torch—2.8.0 + cu126 / torchvision—0.23.1+cu126
3.数据集介绍
MNIST手写数字数据集由Yann LeCun等人整理,来源于美国国家标准与技术研究院(NIST),是计算机视觉和机器学习领域最著名的公开数据集之一。该数据集包含250位不同职业人士手写的数字图像,官方获取地址为:http://yann.lecun.com/exdb/mnist/。网站提供四个压缩文件,分别对应训练图像、训练标签、测试图像和测试标签。
数据集共包含70,000张28×28像素的灰度图像,其中60,000张作为训练集,10,000张作为测试集。若将每张图像展平为一个向量,则得到长度为784(28×28)的向量表示。因此,整个训练集可视为一个形状为[60000, 784]的张量,其中第一维为图像索引,第二维对应像素特征。通常,像素值会被归一化到0到1的范围内。
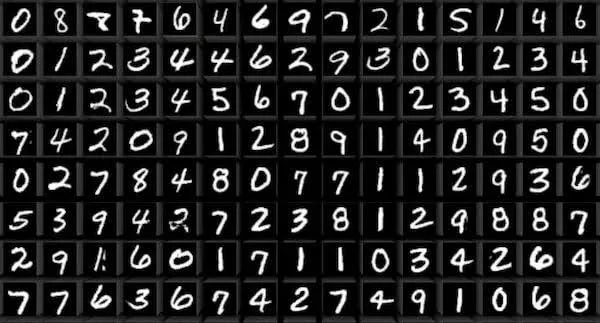
在PyTorch中,可使用torchvision.datasets.MNIST()加载该数据集,常用方式如下:
import torchvision

# 下载并加载MNIST数据集(需指定数据保存路径)
train_dataset = torchvision.datasets.MNIST(root='./data', train=True, download=True, transform=None)
加载后,可通过数据预处理流程(如归一化、转换为张量)进一步处理图像数据,以便用于模型训练与评估。
4.代码实现
4.1 前期准备
4.1.1 导入库 & 设置GPU
import torch.nn as nn
import torch
import torchvision
import matplotlib.pyplot as plt
import numpy as np
import torch.nn.functional as F
from torchinfo import summary
import warnings
from datetime import datetime

current_time = datetime.now() # 获取当前时间

warnings.filterwarnings("ignore")               #忽略警告信息
plt.rcParams['font.sans-serif']    = ['SimHei'] # 用来正常显示中文标签
plt.rcParams['axes.unicode_minus'] = False      # 用来正常显示负号
plt.rcParams['figure.dpi']         = 100        #分辨率

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
device
输出:
4.1.2 数据下载与划分
train_ds = torchvision.datasets.MNIST('data', train=True, transform=torchvision.transforms.ToTensor(), download=True)
test_ds  = torchvision.datasets.MNIST('data', train=False, transform=torchvision.transforms.ToTensor(), download=True)
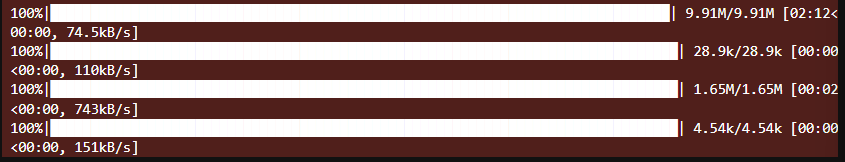
torch.utils.data.DataLoader()是Pytorch自带的一个数据加载器,结合了数据集和取样器,并且可以提供多个线程处理数据集。
函数原型:
torchvision.datasets.MNIST(root, train=True, transform=None, target_transform=None, download=False)
参数说明:
● root (string) :数据地址
● train (string) :True-训练集,False-测试集
● download (bool,optional) : 如果为True,从互联网上下载数据集,并把数据集放在root目录下。
● transform (callable, optional ):这里的参数选择一个你想要的数据转化函数,直接完成数据转化
● target_transform (callable,optional) :接受目标并对其进行转换的函数/转换。
batch_size = 32
train_dl = torch.utils.data.DataLoader(train_ds, batch_size=batch_size, shuffle=True)
test_dl = torch.utils.data.DataLoader(test_ds, batch_size=batch_size)

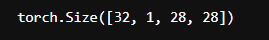
imgs, labels = next(iter(train_dl))
imgs.shape
4.1.3 数据可视化
squeeze()函数的功能是从矩阵shape中,去掉维度为1的。例如一个矩阵是的shape是(5, 1),使用过这个函数后,结果为(5, )。
plt.figure(figsize=(20, 5))
for i, imgs in enumerate(imgs[:20]):
    npimg = np.squeeze(imgs.numpy())
    plt.subplot(2, 10, i+1)
    plt.imshow(npimg, cmap=plt.cm.binary)
    plt.axis('off')
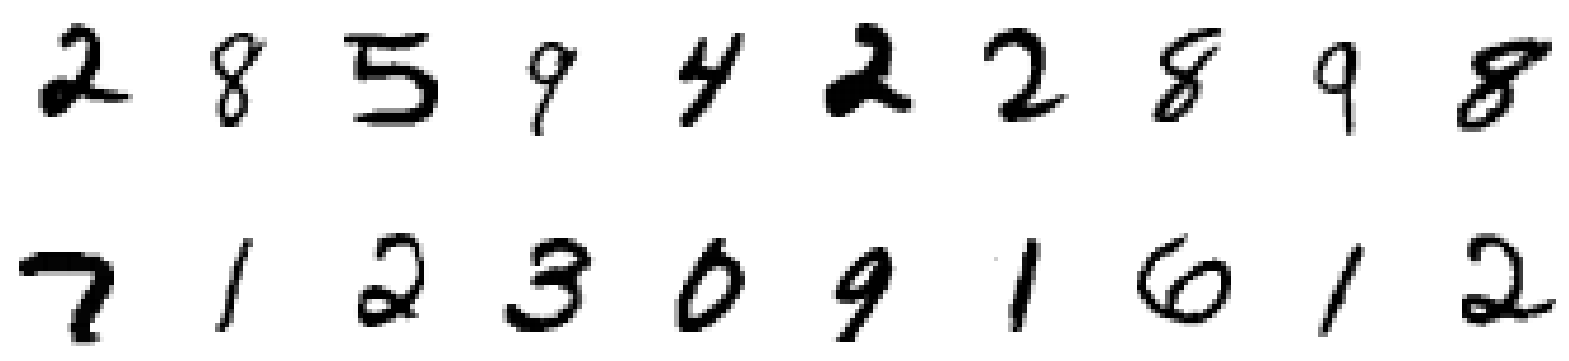
4.2 构建CNN模型
卷积神经网络(CNN)通常由特征提取网络和分类网络两部分组成。特征提取网络通过一系列卷积和池化操作,从输入图像中逐层抽象出高级特征;分类网络则将这些特征映射到最终的类别输出。
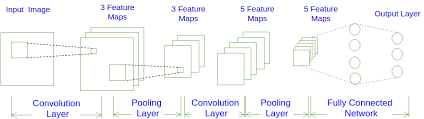
在 PyTorch 框架中,构建CNN常用的核心模块及其作用如下:
-
nn.Conv2d(卷积层):核心特征提取器。通过卷积核在图像上滑动,计算局部特征的加权和,从而捕捉空间层次结构(如边缘、纹理)。主要参数包括:输入通道数、输出通道数(即卷积核数量)、以及卷积核尺寸(如 3×3)。
-
nn.MaxPool2d(最大池化层):用于特征降维和空间不变性增强。在指定窗口(如 2×2)内取最大值,实现对特征图的下采样,能在保留显著特征的同时减少参数量和计算量。主要参数是池化窗口大小。
-
nn.ReLU(激活函数):引入非线性变换。它将所有负值置零,正值保持不变,使得网络能够学习和表示复杂的非线性关系,这是深度学习模型强大拟合能力的关键。
-
nn.Linear(全连接层):通常用于分类网络的末端。它将前面提取到的、经过展平后的多维特征,通过矩阵运算映射到样本的类别空间。最后一层全连接层的输出维度通常等于类别数,因此也常被视为网络的输出层。其关键参数是输入特征数与输出特征数(输入特征数需根据前面特征图的尺寸计算得出)。
-
nn.Sequential(顺序容器):一种网络结构的封装方式。它允许以声明式的顺序组合多个网络层,自动构建层与层之间的前向传播路径,从而简化模型定义代码,避免在前向传播方法中显式地编写每一层的调用逻辑。
补充说明:第一个全连接层的输入特征数,取决于特征提取网络最终输出的特征图尺寸(通道数 × 高度 × 宽度)。可通过逐层推算或直接运行网络进行调试来确定该值。
num_classes = 10
class Model(nn.Module):
    def __init__(self):
        super().__init__()
        self.conv1 = nn.Conv2d(1, 32, kernel_size=3)
        self.pool1 = nn.MaxPool2d(2)
        self.conv2 = nn.Conv2d(32, 64, kernel_size=3)
        self.pool2 = nn.MaxPool2d(2)

        self.fc1 = nn.Linear(1600, 64)
        self.fc2 = nn.Linear(64, num_classes)

    def forward(self, x):
        x = self.pool1(F.relu(self.conv1(x)))
        x = self.pool2(F.relu(self.conv2(x)))

        x = torch.flatten(x, start_dim=1)

        x = F.relu(self.fc1(x))
        x = self.fc2(x)

        return x

model = Model().to(device)
summary(model)
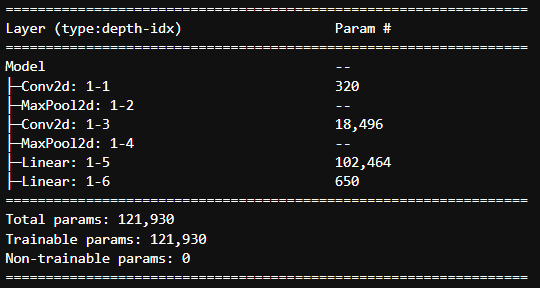
4.3 训练模型
4.3.1 设置超参数
loss_fn = nn.CrossEntropyLoss()
learn_rate = 1e-2
opt = torch.optim.SGD(model.parameters(), lr=learn_rate)
4.3.2 编写训练函数 & 测试函数
在 PyTorch 的训练循环中,optimizer.zero_grad()、loss.backward() 和 optimizer.step() 是三个按固定顺序执行的核心操作,它们共同完成模型参数的一轮更新。这三个步骤的作用与必要性如下:
1. optimizer.zero_grad():梯度清零
- 作用:将优化器跟踪的所有模型参数的梯度(
.grad属性)重置为零。 - 原因:在PyTorch中,张量的梯度是累加的。每当调用
.backward()计算梯度时,新的梯度会累加到已有梯度上,而不会自动替换。这设计在某些高级场景(如RNN多时间步)中有用,但在标准的前馈网络训练中,必须在每次参数更新前手动清空上一轮计算的“旧”梯度,否则梯度会不断累积,导致参数更新方向错误。
2. loss.backward():反向传播计算梯度
- 作用:执行自动微分(反向传播)。它以计算图(Computation Graph)中的损失值(
loss)为起点,根据链式法则,自动计算出损失函数关于每一个可训练参数的梯度。计算结果(梯度值)会被存储在对应参数的.grad属性中。
3. optimizer.step():执行优化器更新参数
- 作用:调用优化器(如SGD、Adam等)中定义的具体算法规则,根据上一步计算得到的梯度(存储在参数的
.grad中)以及设定的超参数(如学习率),执行一次参数更新。更新完成后,模型的参数就向损失函数减小的方向迈进了一步。
核心关系与执行顺序
这三步构成了一个完整的参数更新周期:
清零历史梯度 → 计算当前梯度 → 根据梯度更新参数
如果缺失了第一步的 .zero_grad(),梯度会不断累积,导致更新方向错误,模型无法收敛。因此,正确的执行顺序对于训练成功至关重要。
def train(dataloader, model, loss_fn, optimizer):
    size = len(dataloader.dataset)
    num_batches = len(dataloader)

    train_loss, train_acc = 0, 0

    for X, y in dataloader:
        X, y = X.to(device), y.to(device)

        pred = model(X)
        loss = loss_fn(pred, y)

        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

        train_acc += (pred.argmax(1) == y).type(torch.float).sum().item()
        train_loss += loss.item()

    train_acc /= size
    train_loss /= num_batches

    return train_acc, train_loss
测试函数和训练函数大致相同,但是由于不进行梯度下降对网络权重进行更新,所以不需要传入优化器
def test(dataloader, model, loss_fn):
    size = len(dataloader.dataset)
    num_batches = len(dataloader)

    test_loss, test_acc = 0, 0

    with torch.no_grad():
        for imgs, target in dataloader:
            imgs, target = imgs.to(device), target.to(device)

            target_pred = model(imgs)
            loss = loss_fn(target_pred, target)

            test_loss += loss.item()
            test_acc += (target_pred.argmax(1) == target).type(torch.float).sum().item()

    test_acc /= size
    test_loss /= num_batches

    return test_acc, test_loss
4.3.3 正式训练
在 PyTorch 中,model.train() 和 model.eval() 是用于在模型的训练与评估/推理两种不同阶段之间进行切换的关键方法。正确切换模式能确保特定网络层(如 Dropout、BatchNorm)行为正确,是获得可靠结果的重要前提。
1. model.train():切换到训练模式
调用此方法后,模型将启用所有专门为训练阶段设计的特性。
- Dropout 层:生效。它会按照设定的概率随机“关闭”(丢弃)网络中的一部分神经元,这是一种防止模型过拟合的正则化手段。
- BatchNorm 层:基于当前批次(Batch)的数据进行标准化。它会计算当前小批量数据的均值和方差,并用于标准化。同时,它会更新其内部维护的全局“运行均值”和“运行方差”(这些值将在评估模式下使用)。
2. model.eval():切换到评估模式
调用此方法后,模型将关闭训练阶段的随机性,进入稳定的预测状态。
- Dropout 层:失效。所有神经元都会参与计算,不再进行随机丢弃,以保证预测结果的确定性和可重复性。
- BatchNorm 层:固定统计量。它将停止更新运行均值和方差,并直接使用在训练阶段最终累积下来的全局统计量进行标准化,确保输入输出的稳定性。
epochs = 5
train_loss = []
train_acc = []
test_loss = []
test_acc = []

for epoch in range(epochs):
    model.train()
    epoch_train_acc, epoch_train_loss = train(train_dl, model, loss_fn, opt)
    model.eval()
    epoch_test_acc, epoch_test_loss = test(test_dl, model, loss_fn)

    train_acc.append(epoch_train_acc)
    train_loss.append(epoch_train_loss)
    test_acc.append(epoch_test_acc)
    test_loss.append(epoch_test_loss)

    template = ('Epoch: {:2d}, Training Accuracy: {:.1f}%, Training Loss: {:.3f}, Validate Accuracy: {:.1f}%, Validate Loss: {:.3f}')
    print(template.format(epoch+1, epoch_train_acc*100, epoch_train_loss, epoch_train_acc*100, epoch_test_loss))

print("Done.")
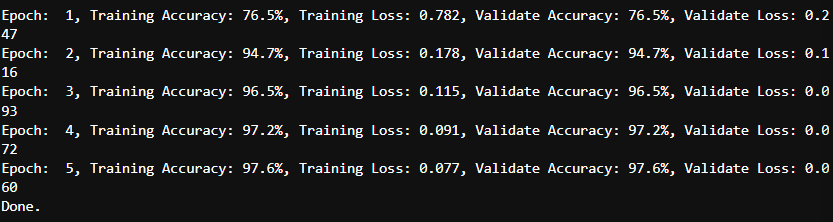
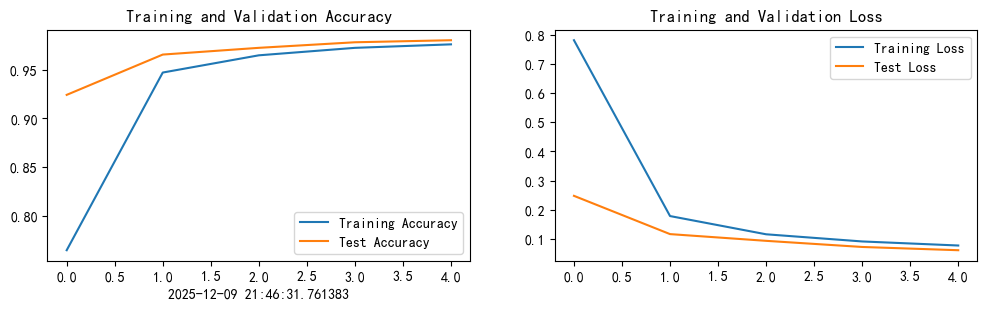
5. 结果可视化
epochs_range = range(epochs)

plt.figure(figsize=(12, 3))
plt.subplot(1, 2, 1)

plt.plot(epochs_range, train_acc, label='Training Accuracy')
plt.plot(epochs_range, test_acc, label='Test Accuracy')
plt.legend(loc='lower right')
plt.title('Training and Validation Accuracy')
plt.xlabel(current_time)

plt.subplot(1, 2, 2)
plt.plot(epochs_range, train_loss, label='Training Loss')
plt.plot(epochs_range, test_loss, label='Test Loss')
plt.legend(loc='upper right')
plt.title('Training and Validation Loss')
plt.show()
更多推荐
 24
 0
- 0


 已为社区贡献29条内容

所有评论(0)