
保姆级实战!Hadoop 3.4 高可用集群部署全攻略(附完整配置注释 + 生产级避坑指南)
·
Hadoop高可用集群部署
一、Zookeeper 集群部署
1. 环境准备与解压安装
首先在各节点创建统一的安装目录/opt/module/,将 Zookeeper 安装包上传至服务器后执行解压操作:
tar -zxvf apache-zookeeper-3.9.3-bin.tar.gz -C ../module/
mv apache-zookeeper-3.9.3-bin/ zookeeper-3.9.3
2. 核心配置文件修改
进入配置目录并创建自定义配置文件:
cd zookeeper-3.9.3/conf
cp zoo_sample.cfg zoo.cfg
在zoo.cfg中添加以下关键配置(注意数据目录需提前创建):
# 基本配置
tickTime=2000                  # 基本时间单位(毫秒)
initLimit=10                   # Leader选举初始化超时时间
syncLimit=5                    # 与Leader同步的超时时间
clientPort=2181                # 客户端连接端口

# 数据与日志存储目录
dataDir=/opt/module/zookeeper-3.9.3/data       # 数据存储目录
dataLogDir=/opt/logs/zookeeper                # 日志存储目录

# 集群节点配置(格式:server.ID=主机名:选举端口:通信端口)
server.1=node1:2888:3888                      # node1节点配置
server.2=node2:2888:3888                      # node2节点配置
server.3=node3:2888:3888                      # node3节点配置

# 自动清理配置(可选)
autopurge.purgeInterval=24                   # 自动清理频率(小时)
autopurge.snapRetainCount=3                  # 保留快照数量
3. 节点标识配置
在每个节点的数据目录中创建唯一标识文件:
mkdir -p /opt/module/zookeeper-3.9.3/data      # 创建数据目录
cd /opt/module/zookeeper-3.9.3/data
echo "1" > myid                                # node1节点写入1
# node2节点执行:echo "2" > myid
# node3节点执行:echo "3" > myid
4. 集群文件分发
通过 rsync 工具快速同步安装目录到其他节点:
rsync -rv zookeeper-3.9.3 node2:/opt/module/    # 分发到node2
rsync -rv zookeeper-3.9.3 node3:/opt/module/    # 分发到node3
5. 环境变量配置
在/etc/profile中添加 Zookeeper 环境变量并生效:
# ZK_HOME配置
export ZK_HOME=/opt/module/zookeeper-3.9.3
export PATH=$PATH:$ZK_HOME/bin
source /etc/profile                              # 使配置立即生效
6. 集群启动与状态验证
在所有节点执行启动命令,并通过状态检查确认集群运行情况:
zkServer.sh start                               # 启动Zookeeper服务
zkServer.sh status                              # 查看节点状态(应显示Leader/Follower)
二、Hadoop 高可用集群部署
1. 基础环境准备
解压 Hadoop 压缩包
tar -zxvf hadoop-3.4.1.tar.gz -C ../module/2.修改配置文件
hdfs-site.xml
<configuration>
  <!-- 定义HDFS高可用集群的命名服务ID -->
  <!-- 客户端通过此名称访问HDFS,而不需要直接指定NameNode主机名 -->
  <property>
    <name>dfs.nameservices</name>
    <value>mycluster</value>
  </property>

  <!-- 指定命名服务下的NameNode标识符列表 -->
  <!-- 多个NameNode通过逗号分隔,用于实现主备切换 -->
  <property>
    <name>dfs.ha.namenodes.mycluster</name>
    <value>nn1,nn2</value>
  </property>

  <!-- 配置每个NameNode的RPC通信地址 -->
  <!-- 客户端通过此地址与NameNode进行元数据操作 -->
  <property>
    <name>dfs.namenode.rpc-address.mycluster.nn1</name>
    <value>node1:8020</value>
  </property>
  <property>
    <name>dfs.namenode.rpc-address.mycluster.nn2</name>
    <value>node2:8020</value>
  </property>

  <!-- 配置每个NameNode的HTTP Web UI地址 -->
  <!-- 用户通过此地址访问NameNode管理界面 -->
  <property>
    <name>dfs.namenode.http-address.mycluster.nn1</name>
    <value>node1:9870</value>
  </property>
  <property>
    <name>dfs.namenode.http-address.mycluster.nn2</name>
    <value>node2:9870</value>
  </property>

  <!-- 配置共享编辑日志存储位置 -->
  <!-- 使用Quorum Journal Manager(QJM)实现主备NameNode间的日志同步 -->
  <!-- 格式:qjournal://节点1:端口;节点2:端口;节点3:端口/命名服务ID -->
  <property>
    <name>dfs.namenode.shared.edits.dir</name>
    <value>qjournal://node1:8485;node2:8485;node3:8485/mycluster</value>
  </property>

  <!-- 配置客户端故障转移代理提供类 -->
  <!-- 当Active NameNode故障时,自动切换到Standby NameNode -->
  <property>
    <name>dfs.client.failover.proxy.provider.mycluster</name>
    <value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider</value>
  </property>

  <!-- 配置NameNode主备切换时的隔离机制 -->
  <!-- sshfence通过SSH远程执行命令,强制关闭故障的NameNode -->
  <property>
    <name>dfs.ha.fencing.methods</name>
    <value>sshfence</value>
  </property>

  <!-- 配置SSH隔离机制使用的私钥文件 -->
  <!-- 需确保所有NameNode节点间SSH无密码登录已配置 -->
  <property>
    <name>dfs.ha.fencing.ssh.private-key-files</name>
    <value>/root/.ssh/id_rsa</value>
  </property>

  <!-- 配置JournalNode存储编辑日志的数据目录 -->
  <!-- 每个JournalNode节点都需要在此目录存储共享编辑日志 -->
  <property>
    <name>dfs.journalnode.edits.dir</name>
    <value>/opt/data/journalnode</value>
  </property>

  <!-- 启用NameNode自动故障转移功能 -->
  <!-- 依赖ZooKeeper实现NameNode状态监控和自动切换 -->
  <property>
    <name>dfs.ha.automatic-failover.enabled</name>
    <value>true</value>
  </property>
</configuration>
core-site.xml
<configuration>
  <!-- 配置Hadoop默认文件系统的URI -->
  <!-- 定义客户端访问HDFS的统一入口,与hdfs-site.xml中的dfs.nameservices保持一致 -->
  <!-- 格式:协议://命名服务ID,客户端通过此URI透明访问高可用集群 -->
  <property>
    <name>fs.defaultFS</name>
    <value>hdfs://mycluster</value>
  </property>

  <!-- 配置Hadoop全局临时目录 -->
  <!-- 存储Hadoop运行时生成的临时文件(如NameNode元数据、DataNode数据块等) -->
  <!-- 需确保该目录存在且有足够磁盘空间,建议使用独立存储路径 -->
  <property>
    <name>hadoop.tmp.dir</name>
    <value>/opt/data/hadoop</value>
  </property>

  <!-- 配置Zookeeper集群地址列表 -->
  <!-- 用于Hadoop高可用组件(如NameNode、ResourceManager)的协调和状态存储 -->
  <!-- 格式:主机名:端口(Zookeeper客户端端口,默认2181),多个节点用逗号分隔 -->
  <!-- Hadoop通过此配置连接ZooKeeper集群,实现故障检测和自动切换 -->
  <property>
    <name>ha.zookeeper.quorum</name>
    <value>node1:2181,node2:2181,node3:2181</value>
  </property>
</configuration>
yarn-site.xml
<configuration>
  <!-- 启用ResourceManager高可用模式 -->
  <!-- 必须设置为true以支持主备ResourceManager节点的自动故障转移 -->
  <property>
    <name>yarn.resourcemanager.ha.enabled</name>
    <value>true</value>
  </property>

  <!-- 定义YARN集群的唯一标识 -->
  <!-- 用于区分不同YARN集群,同一集群内的所有ResourceManager需使用相同ID -->
  <property>
    <name>yarn.resourcemanager.cluster-id</name>
    <value>cluster1</value>
  </property>

  <!-- 指定高可用模式下的ResourceManager实例ID列表 -->
  <!-- 多个实例ID用逗号分隔,需与yarn.resourcemanager.hostname.<id>配置一一对应 -->
  <property>
    <name>yarn.resourcemanager.ha.rm-ids</name>
    <value>rm1,rm2</value>
  </property>

  <!-- 配置每个ResourceManager实例的主机名 -->
  <!-- 与rm-ids中的ID一一对应,指定每个RM实例运行的物理节点 -->
  <property>
    <name>yarn.resourcemanager.hostname.rm1</name>
    <value>node1</value>
  </property>
  <property>
    <name>yarn.resourcemanager.hostname.rm2</name>
    <value>node2</value>
  </property>

  <!-- 配置每个ResourceManager的Web UI访问地址 -->
  <!-- 用户通过此地址访问YARN管理界面(如查看应用状态、资源使用情况) -->
  <property>
    <name>yarn.resourcemanager.webapp.address.rm1</name>
    <value>node1:8088</value>
  </property>
  <property>
    <name>yarn.resourcemanager.webapp.address.rm2</name>
    <value>node2:8088</value>
  </property>

  <!-- 配置Zookeeper集群地址(用于ResourceManager高可用协调) -->
  <!-- ResourceManager通过Zookeeper实现:主备选举、状态存储、故障转移通知 -->
  <!-- 格式:主机名:端口(Zookeeper客户端端口),需包含所有Zookeeper节点 -->
  <property>
    <name>yarn.resourcemanager.zk-address</name>
    <value>node1:2181,node2:2181,node3:2181</value>
  </property>

  <!-- 配置NodeManager的辅助服务 -->
  <!-- mapreduce_shuffle是MapReduce框架所需的 shuffle 服务,必须与MapReduce版本兼容 -->
  <property>
    <name>yarn.nodemanager.aux-services</name>
    <value>mapreduce_shuffle</value>
  </property>

  <!-- 启用YARN日志聚合功能 -->
  <!-- 日志聚合会将分散在NodeManager的容器日志集中存储,便于查询和分析 -->
  <!-- 生产环境建议启用,需配合yarn.log-aggregation.retain-seconds等参数配置保留策略 -->
  <property>
    <name>yarn.log-aggregation-enable</name>
    <value>true</value>
  </property>
</configuration>
mapred-site.xml
<configuration>
  <!-- 指定MapReduce框架运行在YARN资源管理系统上 -->
  <!-- 必选配置:将MapReduce作业提交到YARN集群执行,而非独立模式(standalone) -->
  <!-- YARN负责资源分配和任务调度,MapReduce仅作为计算框架 -->
  <property>
    <name>mapreduce.framework.name</name>
    <value>yarn</value>
  </property>

  <!-- 启用MapReduce历史服务器(JobHistory Server) -->
  <!-- 用于存储和展示已完成作业的详细信息(如计数器、日志、任务执行时间等) -->
  <!-- 客户端通过RPC地址获取作业元数据,Web UI地址访问可视化界面 -->
  <property>
    <name>mapreduce.jobhistory.address</name>
    <value>node1:10020</value> <!-- 历史服务器RPC通信端口(默认10020) -->
  </property>
  <property>
    <name>mapreduce.jobhistory.webapp.address</name>
    <value>node1:19888</value> <!-- 历史服务器Web界面端口(默认19888) -->
  </property>

  <!-- Shuffle服务配置(MapReduce数据传输核心组件) -->
  <!-- Shuffle服务负责Map任务输出到Reduce任务输入的数据传输与排序 -->
  <!-- 端口需在所有NodeManager节点开放,确保Reduce任务能拉取Map输出数据 -->
  <property>
    <name>mapreduce.shuffle.service.port</name>
    <value>13562</value> <!-- Shuffle服务监听端口(默认13562,需与YARN集群网络规划一致) -->
  </property>

  <!-- Map/Reduce任务内存资源分配策略 -->
  <!-- 以下配置控制任务的资源上限,需与YARN队列资源配置(如capacity-scheduler)协同工作 -->

  <!-- Map任务内存分配 -->
  <property>
    <name>mapreduce.map.memory.mb</name>
    <value>2048</value> <!-- Map任务申请的物理内存上限(MB) -->
  </property>
  <property>
    <name>mapreduce.map.java.opts</name>
    <value>-Xmx1638m</value> <!-- Map任务JVM堆内存上限(通常为内存分配的80%,避免OOM) -->
  </property>

  <!-- Reduce任务内存分配 -->
  <property>
    <name>mapreduce.reduce.memory.mb</name>
    <value>4096</value> <!-- Reduce任务申请的物理内存上限(MB),通常高于Map任务 -->
  </property>
  <property>
    <name>mapreduce.reduce.java.opts</name>
    <value>-Xmx3276m</value> <!-- Reduce任务JVM堆内存上限(建议不超过内存分配的85%) -->
  </property>
</configuration>
workers
node1
node2
node3
hadoop-env.sh
# ------------------------------ HDFS 服务用户配置 ------------------------------ #
# 指定NameNode服务的运行用户(核心元数据管理节点)
# 当前配置:使用root用户(仅建议开发测试环境,生产环境严禁直接使用root)
# 生产建议:创建专用用户(如hadoop),通过sudo分配最小必要权限,降低安全风险
export HDFS_NAMENODE_USER=root

# 指定DataNode服务的运行用户(数据块存储节点)
# 职责:负责存储HDFS数据块,与NameNode通信汇报状态
export HDFS_DATANODE_USER=root

# 指定SecondaryNameNode(或CheckpointNode)运行用户(元数据辅助节点)
# 职责:定期合并fsimage和edits日志,减轻NameNode负担(HDFS 3.x后推荐使用CheckpointNode)
export HDFS_SECONDARYNAMENODE_USER=root

# ------------------------------ YARN 服务用户配置 ------------------------------ #
# 指定ResourceManager服务的运行用户(YARN资源调度核心节点)
# 职责:协调集群资源分配,管理ApplicationMaster和NodeManager
export YARN_RESOURCEMANAGER_USER=root

# 指定NodeManager服务的运行用户(YARN工作节点)
# 职责:管理容器生命周期,监控资源使用,与ResourceManager通信
export YARN_NODEMANAGER_USER=root

# ------------------------------ 高可用组件用户配置 ------------------------------ #
# 指定JournalNode服务的运行用户(HDFS共享编辑日志存储节点)
# 职责:在Quorum Journal Manager中存储NameNode编辑日志,实现主备同步
export HDFS_JOURNALNODE_USER=root

# 指定ZKFC(ZooKeeper Failover Controller)运行用户(故障转移控制器)
# 职责:监控NameNode状态,与Zookeeper交互实现自动故障转移和隔离
export HDFS_ZKFC_USER=root

# ------------------------------ Java 环境配置 ------------------------------ #
# 指定Java安装路径(需与Hadoop兼容版本,Hadoop 3.4.x支持Java 8/11/17)
# 注意:若出现"Unsupported class file version"错误,需检查Java版本兼容性
export JAVA_HOME=/opt/module/jdk-17.0.15
yarn-env.sh(Java11+需要)
# 添加 JVM 参数到 HADOOP_OPTS
export HADOOP_OPTS="$HADOOP_OPTS --add-opens java.base/java.lang=ALL-UNNAMED"
3.将hadoop分发到其他节点
rsync -rv hadoop-3.4.1 node2:/opt/module/
rsync -rv hadoop-3.4.1 node3:/opt/module/
4. 服务启动流程
启动 JournalNode 服务(所有节点):
hdfs --daemon start journalnode验证 JournalNode 状态:
curl http://node1:8480/jmx # 检查各节点JMX信息格式化第一个 NameNode(主节点 node1):
hdfs namenode -format启动第一个 NameNode(主节点 node1):
hdfs --daemon start namenode同步元数据到备用节点(node2 执行):
hdfs namenode -bootstrapStandby启动备用 NameNode(node2):
hdfs --daemon start namenode初始化 ZooKeeper 故障转移控制器(任意节点):
hdfs zkfc -formatZK启动所有 DataNode:
hdfs --daemon start datanode启动 YARN 服务(在 node1 上执行):
start-yarn.sh启动历史服务器:
mr-jobhistory-daemon.sh start historyserver踩坑:
Failed to retrieve data from /webhdfs/v1/?op=LISTSTATUS: Server Error
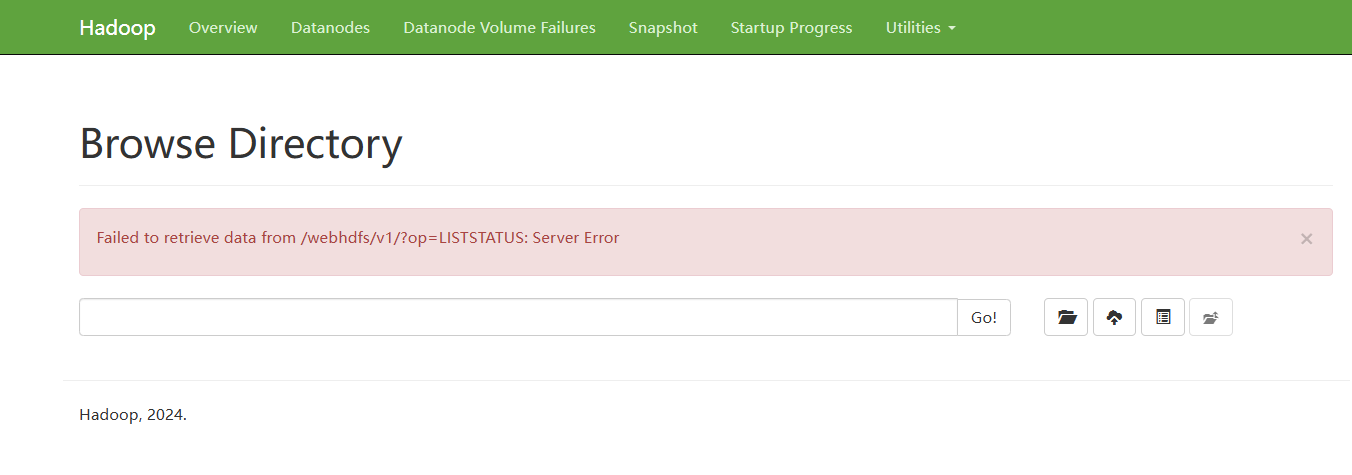
原因:Hadoop支持的Java最新版本是Java11,而我的是17,在hadoop_env.sh改成11的JAVA_HOME就可以了
Supported Java Versions  支持的 Java 版本
Apache Hadoop 3.3 and upper supports Java 8 and Java 11 (runtime only)
Apache Hadoop 3.3 及更高版本支持 Java 8 和 Java 11(仅限运行时)
Please compile Hadoop with Java 8. Compiling Hadoop with Java 11 is not supported:  HADOOP-16795 - Java 11 compile support Open
请使用 Java 8 编译 Hadoop。不支持使用 Java 11 编译 Hadoop:HADOOP-16795 - Java 11 编译支持打开
Apache Hadoop from 3.0.x to 3.2.x now supports only Java 8
Apache Hadoop 从 3.0.x 到 3.2.x 现在仅支持 Java 8
Apache Hadoop from 2.7.x to 2.10.x support both Java 7 and 8
从 2.7.x 到 2.10.x 的 Apache Hadoop 同时支持 Java 7 和 8更多推荐
 0
 0
- 0


 已为社区贡献33条内容

所有评论(0)