
AI大模型面试全攻略:从理论到实战的避坑指南
快速体验
在开始今天关于 AI大模型面试全攻略:从理论到实战的避坑指南 的探讨之前,我想先分享一个最近让我觉得很有意思的全栈技术挑战。
我们常说 AI 是未来,但作为开发者,如何将大模型(LLM)真正落地为一个低延迟、可交互的实时系统,而不仅仅是调个 API?
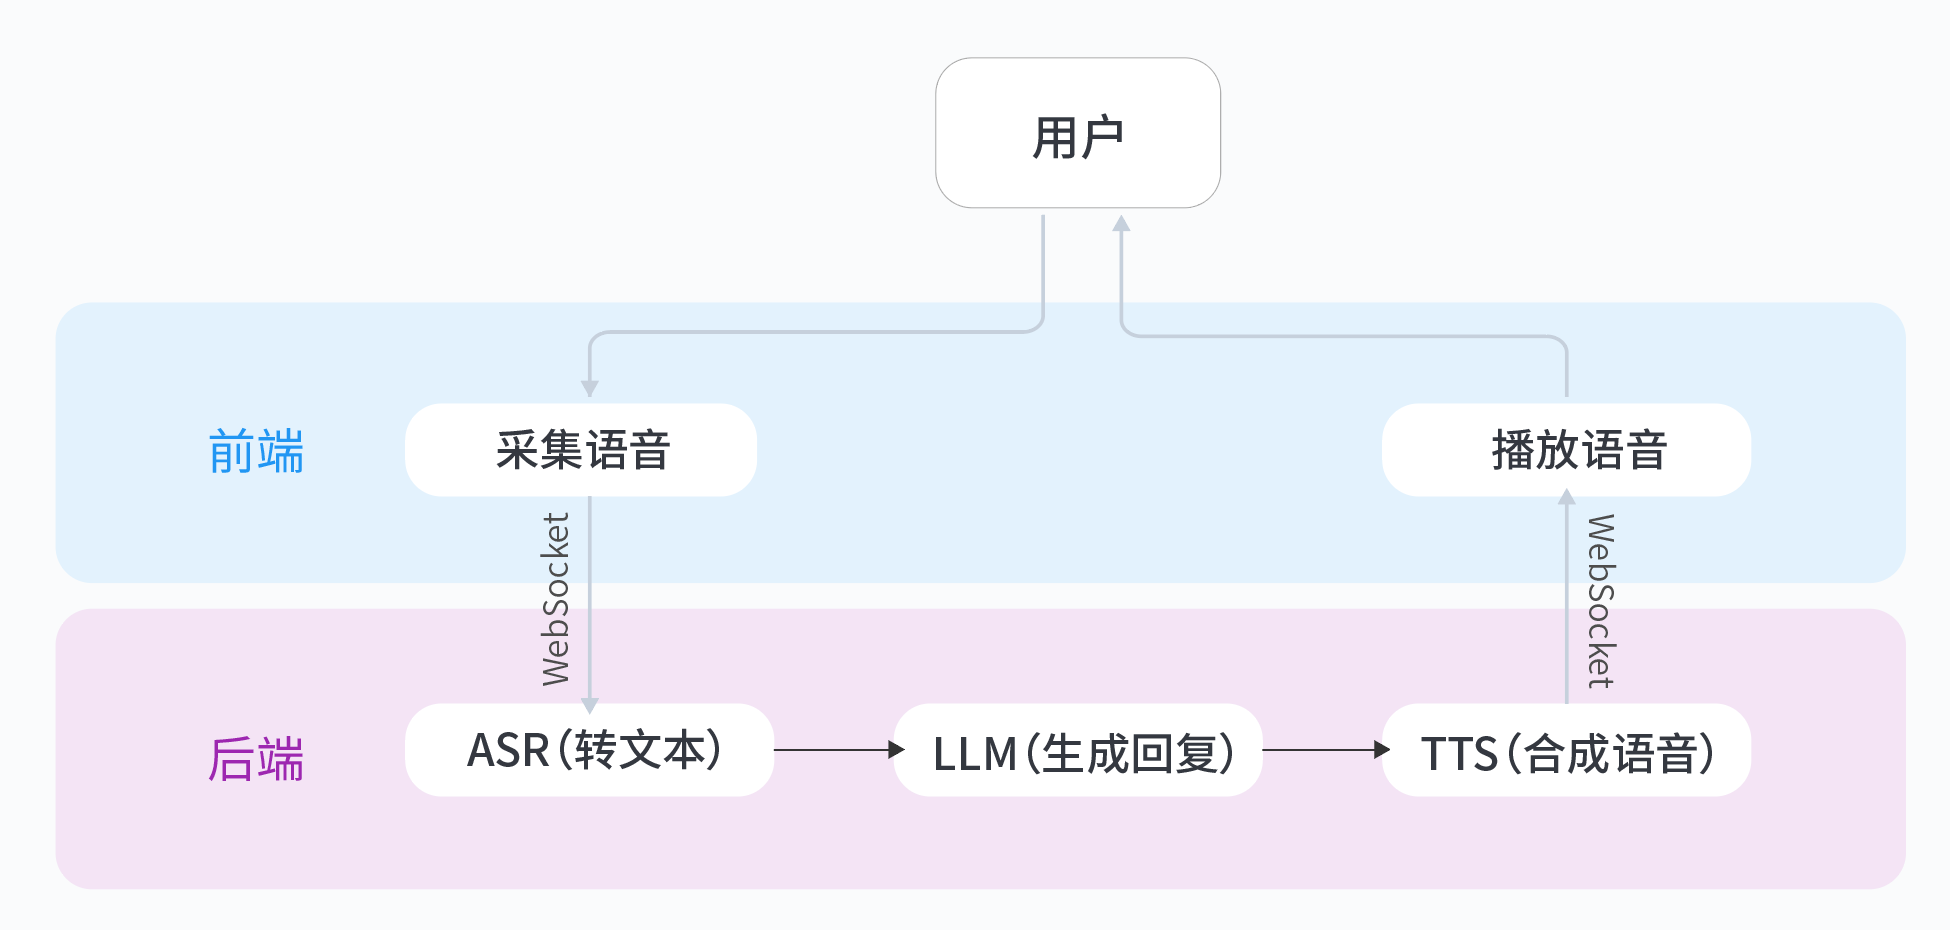
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
AI大模型面试全攻略:从理论到实战的避坑指南
最近帮几个学弟学妹复盘AI大模型方向的面试,发现很多同学在技术细节和实战经验上容易踩坑。今天就把这些高频问题和应对策略整理成攻略,希望能帮到准备面试的你。
新手常见知识盲区与应对策略
-
概念混淆:把Transformer、BERT、GPT混为一谈。实际上Transformer是基础架构,BERT是双向编码器,GPT是自回归模型。建议画架构对比图记忆。
-
原理表述不清:被问到注意力机制时,很多同学只能说出"计算权重",却讲不清QKV矩阵的数学含义。建议用"信息检索"的类比来理解:Query是问题,Key是索引,Value是内容。
-
缺乏实操细节:能说出微调步骤,但说不清学习率设置、数据增强等具体技巧。建议在个人项目中实践完整的finetune流程。
主流模型架构选型指南
-
Transformer:适合需要长距离依赖的任务,核心优势是并行计算能力。面试常考位置编码、多头注意力的实现。
-
BERT:在理解类任务上表现优异,如文本分类、实体识别。要掌握Next Sentence Prediction和MLM预训练目标。
-
GPT系列:适合生成任务,重点理解自回归特性。注意区分GPT-3的few-shot learning能力。
关键技术深度解析
- 注意力机制三要素:
- Query:当前需要表征的内容
- Key:用于匹配的相关性依据
-
Value:实际提取的信息内容
-
微调实战技巧:
- 分层学习率:底层参数小幅度调整
- 早停策略:验证集loss连续3次不下降则终止
- 数据增强:对文本进行同义词替换、回译等操作
手写Transformer核心代码
import torch
import torch.nn as nn

class MultiHeadAttention(nn.Module):
    def __init__(self, d_model, num_heads):
        super().__init__()
        self.d_k = d_model // num_heads
        self.num_heads = num_heads
        self.W_q = nn.Linear(d_model, d_model)
        self.W_k = nn.Linear(d_model, d_model)
        self.W_v = nn.Linear(d_model, d_model)
        self.out = nn.Linear(d_model, d_model)

    def forward(self, x):
        # 拆分多头
        Q = self.W_q(x).view(-1, self.num_heads, self.d_k)
        K = self.W_k(x).view(-1, self.num_heads, self.d_k)
        V = self.W_v(x).view(-1, self.num_heads, self.d_k)

        # 计算注意力分数
        scores = torch.matmul(Q, K.transpose(1,2)) / torch.sqrt(torch.tensor(self.d_k))
        attn = nn.Softmax(dim=-1)(scores)

        # 加权求和
        context = torch.matmul(attn, V)
        return self.out(context.view(-1, self.num_heads * self.d_k))
性能优化关键指标
- 延迟优化:
- 使用KV缓存减少重复计算
- 量化到FP16甚至INT8精度
-
注意力计算采用稀疏或近似方法
-
内存占用:
- 梯度检查点技术
- 模型并行策略
- 激活值压缩
面试避坑指南
- 高频错误:
- 混淆decoder-only和encoder-decoder架构
- 说不清LayerNorm和BatchNorm的区别
-
对位置编码的实现细节含糊其辞
-
加分回答:
- 结合论文讲解最新改进如FlashAttention
- 讨论模型压缩的实践经验
- 分析不同优化器(AdamW vs SGD)的适用场景
想快速验证这些知识点?推荐体验从0打造个人豆包实时通话AI实验,通过构建完整的ASR→LLM→TTS流水线,可以直观理解大模型在实际应用中的表现。我亲测这个实验对理解推理流程特别有帮助,代码结构清晰易上手,适合面试前巩固实战能力。
实验介绍
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
你将收获:
- 架构理解:掌握实时语音应用的完整技术链路(ASR→LLM→TTS)
- 技能提升:学会申请、配置与调用火山引擎AI服务
- 定制能力:通过代码修改自定义角色性格与音色,实现“从使用到创造”
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
更多推荐


 9
 0
- 0


 已为社区贡献9条内容

所有评论(0)