
AI大模型应用盘点:如何通过大模型技术提升开发效率
快速体验
在开始今天关于 AI大模型应用盘点:如何通过大模型技术提升开发效率 的探讨之前,我想先分享一个最近让我觉得很有意思的全栈技术挑战。
我们常说 AI 是未来,但作为开发者,如何将大模型(LLM)真正落地为一个低延迟、可交互的实时系统,而不仅仅是调个 API?
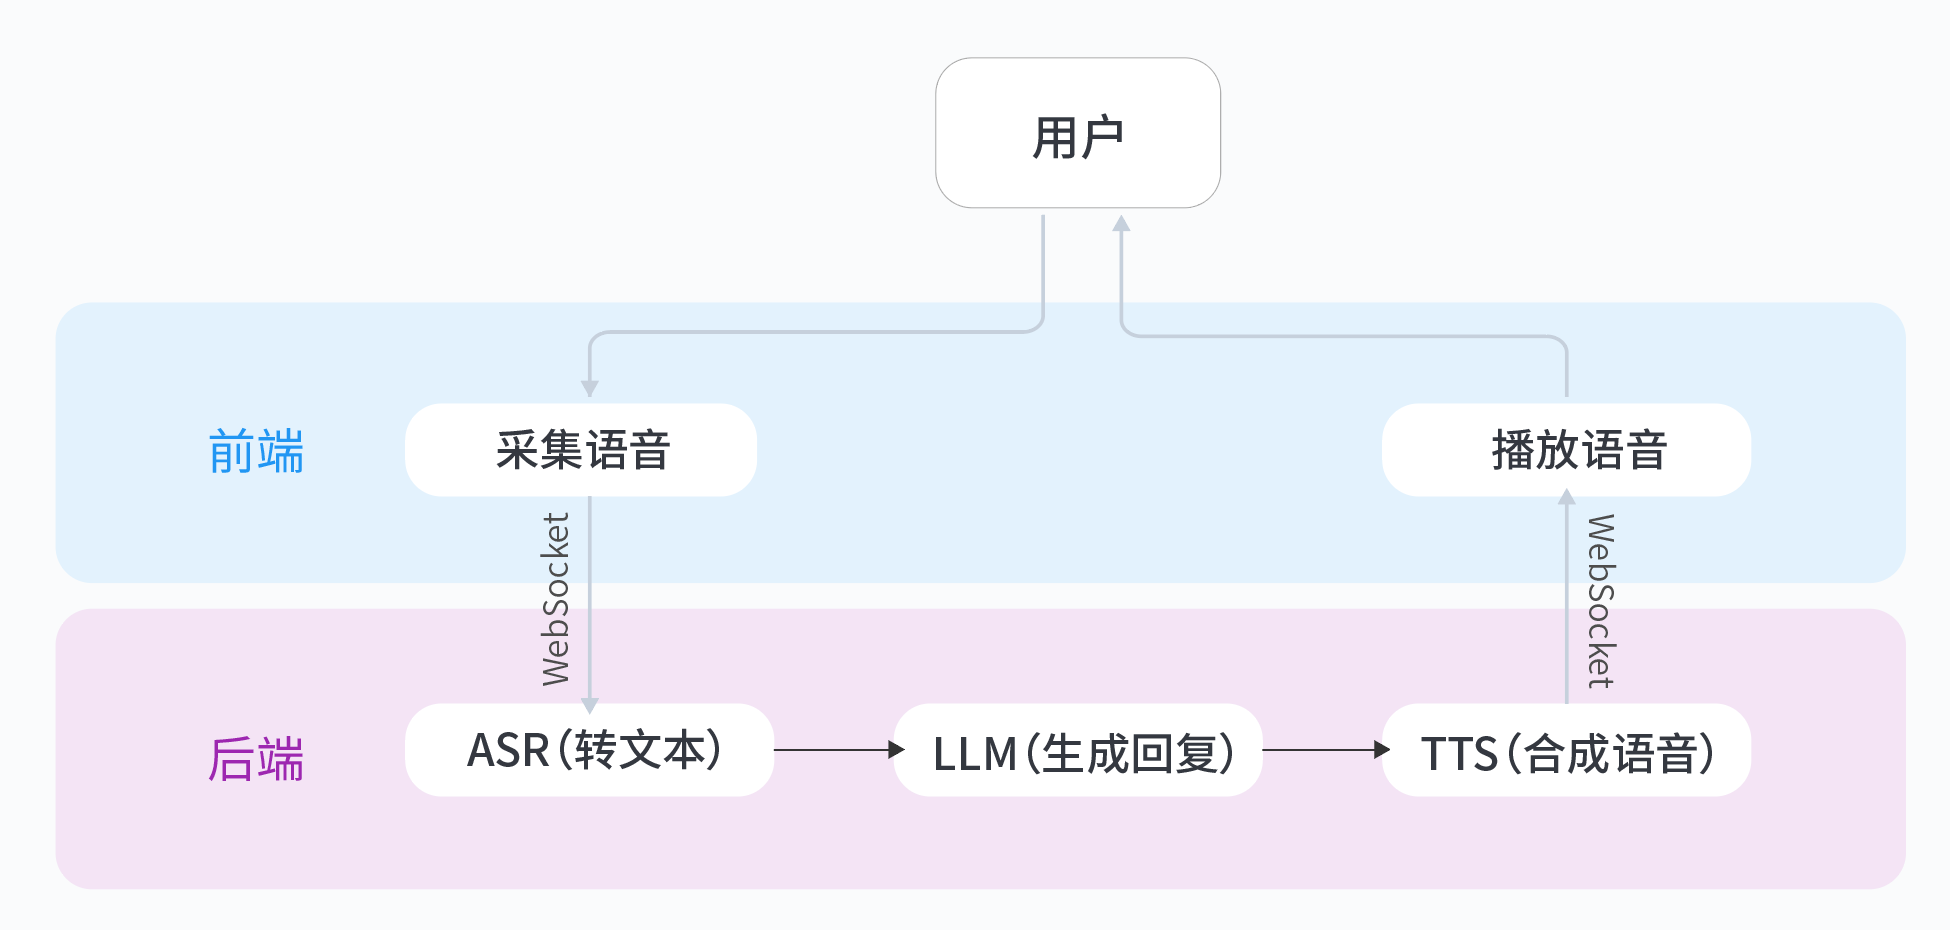
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
AI大模型应用盘点:如何通过大模型技术提升开发效率
背景痛点:传统开发流程的效率瓶颈
在传统软件开发流程中,开发者常常面临以下效率瓶颈:
- 重复性代码编写:业务代码中存在大量模式化片段(如CRUD接口),手动编写耗时且易出错
- 测试用例构造:需要人工设计边界条件和异常场景,覆盖率难以保证
- 文档维护:代码变更后文档更新滞后,形成"僵尸文档"
- 调试耗时:异常排查依赖开发者经验,问题定位效率低下
以Java Spring Boot项目为例,开发一个简单的用户管理模块通常需要: - 40%时间用于编写重复的Controller/Service代码 - 30%时间构造测试用例 - 20%时间编写API文档 - 10%时间处理意外异常
技术选型对比:主流大模型能力矩阵
| 模型类型 | 代码生成 | 测试生成 | 文档生成 | 调试辅助 | 适用场景 |
|---|---|---|---|---|---|
| Codex系列 | ★★★★★ | ★★★☆ | ★★★★ | ★★★☆ | 全栈开发 |
| ChatGPT | ★★★★☆ | ★★★★ | ★★★★★ | ★★★★ | 通用任务 |
| Claude | ★★★☆ | ★★★★ | ★★★★☆ | ★★★★☆ | 逻辑严谨型任务 |
| Gemini | ★★★★ | ★★★☆ | ★★★☆ | ★★★★ | 多模态场景 |
| 开源模型(LLaMA) | ★★☆ | ★★☆ | ★★★ | ★★☆ | 私有化部署需求 |
核心实现:典型效率提升案例
案例1:自动化CRUD代码生成
# 使用OpenAI API生成Spring Boot Controller
import openai

prompt = """
根据以下User实体类生成完整的Spring Boot Controller:
@Entity
public class User {
    @Id @GeneratedValue Long id;
    String username;
    String email;
    LocalDateTime createdAt;
}

要求:
1. 包含标准的CRUD端点
2. 使用Lombok简化代码
3. 添加Swagger注解
4. 包含参数校验
"""

response = openai.ChatCompletion.create(
    model="gpt-4",
    messages=[{"role": "user", "content": prompt}],
    temperature=0.3
)
print(response.choices[0].message.content)
生成结果示例:
@RestController
@RequestMapping("/api/users")
@RequiredArgsConstructor
@Tag(name = "User Management")
public class UserController {
    private final UserRepository userRepository;

    @PostMapping
    @Operation(summary = "Create new user")
    public ResponseEntity<User> createUser(@Valid @RequestBody User user) {
        user.setCreatedAt(LocalDateTime.now());
        return ResponseEntity.ok(userRepository.save(user));
    }
    // 其他CRUD方法...
}
案例2:智能测试用例生成
// 使用Claude生成JUnit测试用例
const anthropic = require('@anthropic-ai/sdk');

const client = new anthropic.Client(process.env.ANTHROPIC_API_KEY);

const response = await client.complete({
    prompt: `为以下Java方法生成边界条件测试用例:
public static int divide(int dividend, int divisor) {
    if (divisor == 0) throw new IllegalArgumentException();
    return dividend / divisor;
}

要求:
1. 使用JUnit5
2. 覆盖所有边界情况
3. 包含异常测试`,
    model: "claude-2",
    max_tokens: 500
});

console.log(response.completion);
生成结果示例:
@Test
void divide_NormalCase_ReturnsCorrectResult() {
    assertEquals(2, MathUtils.divide(10, 5));
}

@Test
void divide_DivideByZero_ThrowsException() {
    assertThrows(IllegalArgumentException.class,
        () -> MathUtils.divide(1, 0));
}

@Test
void divide_MaxValue_DividesCorrectly() {
    assertEquals(Integer.MAX_VALUE,
        MathUtils.divide(Integer.MAX_VALUE, 1));
}
性能考量:关键指标平衡
- 延迟优化:
- 代码补全:要求<500ms响应,推荐使用小型专用模型
-
文档生成:可接受2-3秒延迟,使用大参数模型提升质量
-
准确率提升:
- 通过few-shot learning提供示例
- 设置temperature=0.3减少随机性
-
添加类型约束(如"返回TypeScript类型定义")
-
成本控制:
- 非实时任务使用gpt-3.5-turbo
- 对长文档采用分块处理
- 缓存频繁使用的生成结果
避坑指南:实战经验分享
- 提示工程陷阱:
- 避免模糊需求(如"写个好函数")
-
应该明确:"用Python实现快速排序,要求:
- 处理None输入
- 时间复杂度O(nlogn)
- 包含类型注解"
-
代码集成问题:
- 始终人工审核生成代码
- 设置安全边界(如禁止执行eval)
-
添加静态分析工具检查
-
模型局限应对:
- 对复杂逻辑采用分步生成
- 超过上下文窗口时自动拆分需求
- 关键业务代码补充单元测试
总结与展望
将大模型集成到开发工作流时,建议:
- 从非关键路径开始(如文档生成)
- 建立质量评估指标(如代码通过率)
- 逐步构建企业专属提示库
- 与现有工具链(IDE/CI)深度集成
未来可探索方向: - 实时协作编程助手 - 自动化架构设计 - 智能故障根因分析
想体验大模型如何提升开发效率?可以尝试从0打造个人豆包实时通话AI动手实验,快速构建AI应用原型。在实际使用中,我发现其代码生成和调试建议对加速开发周期确有显著帮助。
实验介绍
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
你将收获:
- 架构理解:掌握实时语音应用的完整技术链路(ASR→LLM→TTS)
- 技能提升:学会申请、配置与调用火山引擎AI服务
- 定制能力:通过代码修改自定义角色性格与音色,实现“从使用到创造”
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
更多推荐


 14
 0
- 0


 已为社区贡献9条内容

所有评论(0)