
基于ACP大模型题库的AI辅助开发实践:从数据准备到模型集成
快速体验
在开始今天关于 基于ACP大模型题库的AI辅助开发实践:从数据准备到模型集成 的探讨之前,我想先分享一个最近让我觉得很有意思的全栈技术挑战。
我们常说 AI 是未来,但作为开发者,如何将大模型(LLM)真正落地为一个低延迟、可交互的实时系统,而不仅仅是调个 API?
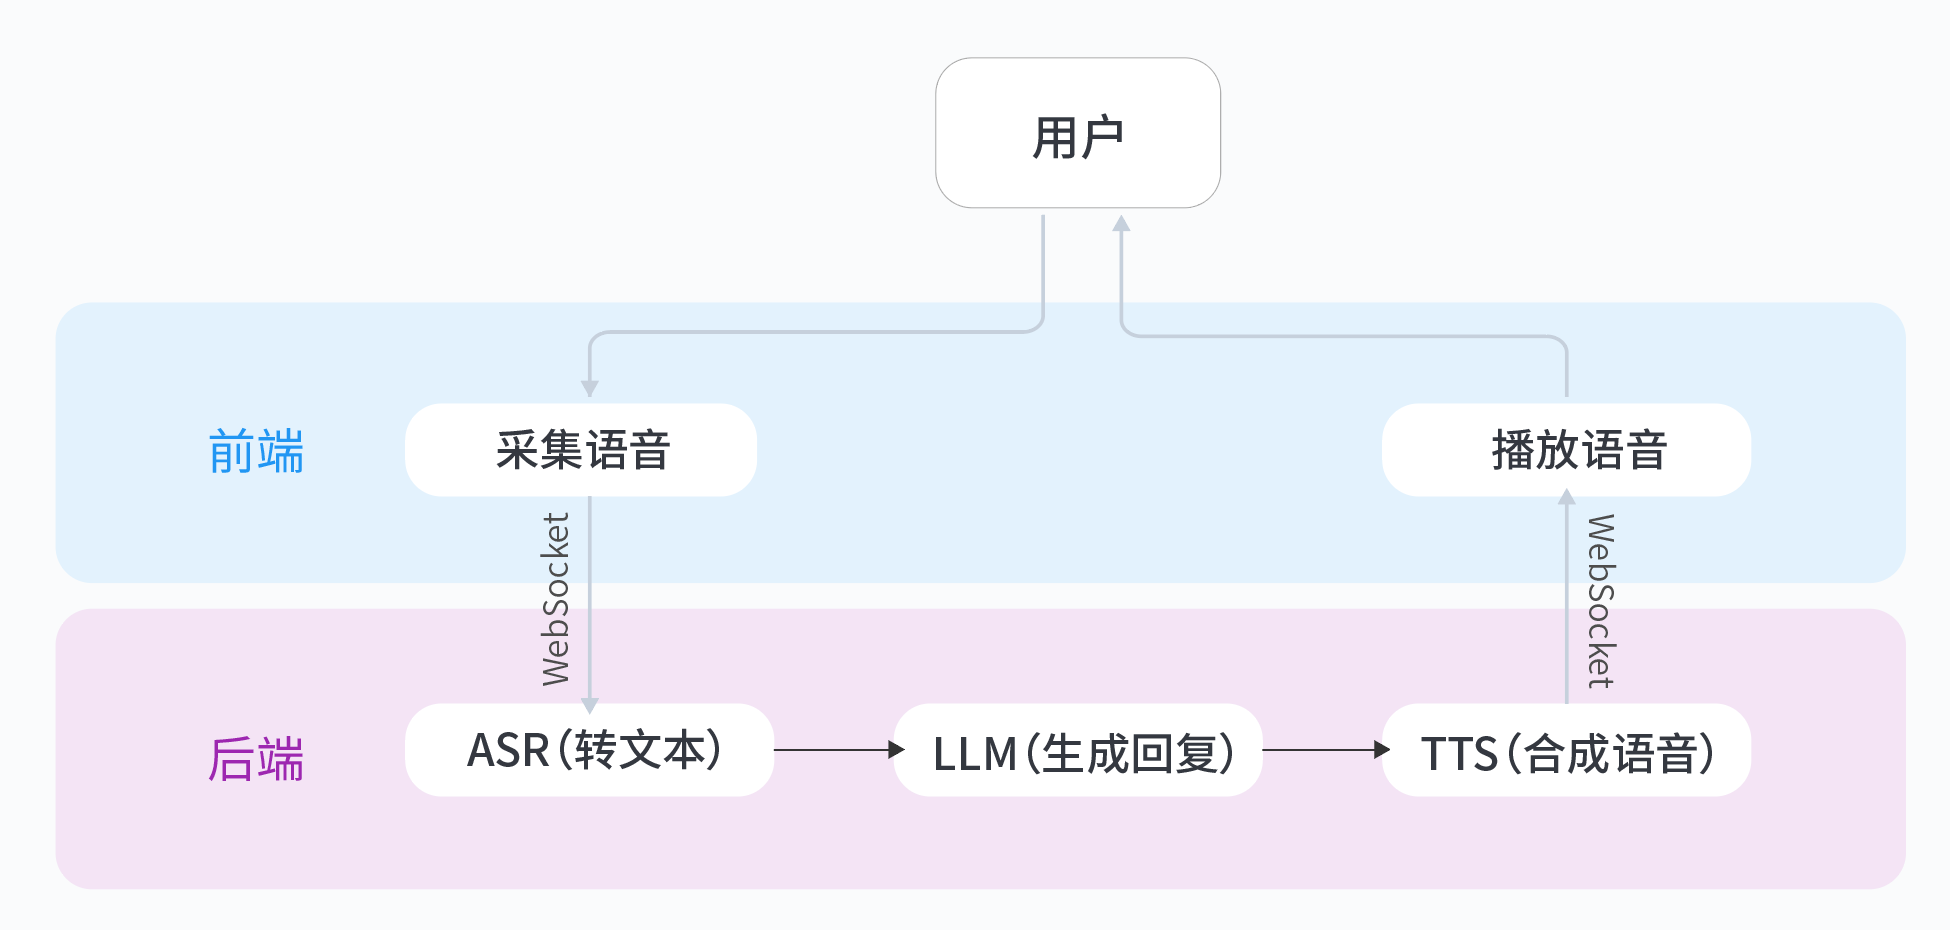
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
基于ACP大模型题库的AI辅助开发实践:从数据准备到模型集成
背景痛点:AI开发中的数据困境
在AI应用开发过程中,数据质量往往成为制约模型性能的关键瓶颈。开发者常面临以下问题:
- 数据获取成本高:自建数据集需要投入大量人力进行采集和标注,特别是专业领域数据获取难度更大。
- 标注质量不稳定:众包标注存在主观性差异,导致数据一致性差,影响模型训练效果。
- 领域覆盖有限:公开数据集往往局限于常见场景,难以满足垂直领域的特殊需求。
这些问题直接导致模型在实际应用中表现不佳,需要反复调整和优化,延长了开发周期。
技术选型:为什么选择ACP大模型题库
ACP大模型题库作为专业AI训练数据源,具有以下优势:
- 海量高质量数据:千万级标注样本,覆盖教育、医疗、金融等多个垂直领域。
- 专业标注团队:由领域专家参与标注,确保数据准确性和一致性。
- 持续更新机制:题库定期扩充和优化,保持数据时效性。
与传统数据源对比:
| 特性 | ACP题库 | 公开数据集 | 自建数据 |
|---|---|---|---|
| 数据规模 | ★★★★★ | ★★☆ | ★☆☆ |
| 标注质量 | ★★★★★ | ★★☆ | ★★★☆ |
| 领域覆盖 | ★★★★☆ | ★★☆ | ★★★★★ |
| 获取成本 | ★★★☆☆ | ★★★★★ | ★☆☆☆☆ |
核心实现:从数据到模型
数据预处理流程
使用Python进行数据清洗和准备的典型流程:
import pandas as pd
from sklearn.model_selection import train_test_split

# 加载ACP题库数据
df = pd.read_csv('acp_dataset.csv')

# 数据清洗
def clean_text(text):
    # 去除特殊字符
    text = text.replace('\n', ' ').replace('\r', '')
    # 统一全半角符号
    text = text.replace('(', '(').replace(')', ')')
    return text.strip()

df['text'] = df['text'].apply(clean_text)

# 处理缺失值
df = df.dropna(subset=['text', 'label'])

# 划分训练集和验证集
train_df, val_df = train_test_split(df, test_size=0.2, random_state=42)

print(f"训练集样本数: {len(train_df)}")
print(f"验证集样本数: {len(val_df)}")
模型微调方案
使用Hugging Face Transformers进行few-shot learning微调:
from transformers import AutoTokenizer, AutoModelForSequenceClassification
from transformers import Trainer, TrainingArguments
import torch

# 加载预训练模型
model_name = "bert-base-chinese"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForSequenceClassification.from_pretrained(model_name, num_labels=5)

# 数据预处理
def preprocess_function(examples):
    return tokenizer(examples["text"], truncation=True, padding='max_length', max_length=128)

train_dataset = train_df.map(preprocess_function, batched=True)
val_dataset = val_df.map(preprocess_function, batched=True)

# 训练参数设置
training_args = TrainingArguments(
    output_dir='./results',
    num_train_epochs=3,
    per_device_train_batch_size=16,
    evaluation_strategy="epoch",
    save_strategy="epoch",
)

# 创建Trainer实例
trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=train_dataset,
    eval_dataset=val_dataset,
)

# 开始训练
trainer.train()
系统集成:模型服务化
使用Flask将训练好的模型封装为REST API:
from flask import Flask, request, jsonify
import torch
from transformers import pipeline

app = Flask(__name__)

# 加载微调后的模型
classifier = pipeline("text-classification", model="./results/checkpoint-1000")

@app.route('/predict', methods=['POST'])
def predict():
    data = request.get_json()
    text = data['text']

    # 执行预测
    result = classifier(text)

    return jsonify({
        'label': result[0]['label'],
        'score': float(result[0]['score'])
    })

if __name__ == '__main__':
    app.run(host='0.0.0.0', port=5000)
性能考量与优化
推理延迟优化
- 模型量化:将FP32模型转换为INT8,减少计算量和内存占用
- 批处理预测:合并多个请求,提高GPU利用率
- 缓存机制:对常见查询结果进行缓存
内存监控方案
import psutil
import time

def monitor_memory():
    while True:
        mem = psutil.virtual_memory()
        print(f"内存使用率: {mem.percent}%")
        time.sleep(60)

# 启动监控线程
import threading
t = threading.Thread(target=monitor_memory)
t.daemon = True
t.start()
避坑指南
数据泄露防范
- 严格分离训练集、验证集和测试集
- 避免在预处理阶段使用全局统计量
- 使用时间序列数据时注意未来信息泄露
模型版本控制
- 使用MLflow或DVC管理模型版本
- 每次训练记录超参数和评估指标
- 生产环境采用蓝绿部署策略
实践建议
想要亲身体验基于ACP题库的AI开发流程?可以在Google Colab上快速复现这个案例:
- 访问ACP大模型题库官网获取样例数据
- 打开Colab笔记本,安装必要依赖
- 按照本文代码示例逐步执行
通过这个完整流程,你将掌握从数据准备到模型部署的全套技能,为实际项目开发打下坚实基础。ACP题库提供的高质量数据能显著减少数据清洗工作量,让你更专注于模型优化和业务逻辑实现。
实验介绍
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
你将收获:
- 架构理解:掌握实时语音应用的完整技术链路(ASR→LLM→TTS)
- 技能提升:学会申请、配置与调用火山引擎AI服务
- 定制能力:通过代码修改自定义角色性格与音色,实现“从使用到创造”
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
更多推荐


 9
 0
- 0


 已为社区贡献11条内容

所有评论(0)