
【Kubernetes专项】基于亲和性、污点、容忍度的多种调度策略
六、Pod高级实战:基于亲和性、污点、容忍度的多种调度策略
6.1 标签
6.1.1 什么是标签?
标签其实就是一对键值对(Key/value),被关联到对象上,比如Pod;
标签的作用其实就是“见名知意”,一眼就知道这个资源的特点,资源的作用;
标签可以用来划分特定的对象(比如:版本、服务类型…)
- 每个对象可以有多个标签,但是 key 的值必须是唯一的
创建标签之后,也可以方便我们对资源进行分组管理。
如果对Pod打标签,之后就可使用标签来查看、删除指定的Pod
6.1.2 查看资源标签
# 新建几个Pod资源
[root@k8s-master1 ~]# cd pod
[root@k8s-master1 pod]# kubectl apply -f pod-tomcat.yaml
[root@k8s-master1 pod]# kubectl apply -f nginx-deploy.yaml
# 新建完成之后,查看一下
[root@k8s-master1 pod]# kubectl get pods

# 查看在此命名空间下所有Pod资源标签(-n default 忽略)
[root@k8s-master1 pod]# kubectl get pods --show-labels

# 在此命名空间下查看某个Pod资源的标签
[root@k8s-master1 pod]# kubectl get pods tomcat-test --show-labels

# 查看在此命名空间下标签为c的Pod资源
[root@k8s-master1 pod]# kubectl get pods -l c
# 查看在此命名空间下标签为app的Pod资源
[root@k8s-master1 pod]# kubectl get pods -l app
# 查看在此命名空间下标签为releases的Pod资源
[root@k8s-master1 pod]# kubectl get pods -l release

# 查看在此命名空间下标签为releases的Pod资源的Key值(-L)
[root@k8s-master1 pod]# kubectl get pods -L release
NAME          READY   STATUS    RESTARTS   AGE    RELEASE
tomcat-test   1/1     Running   0          2m4s   v1


# 查看所有命名空间下Pod资源的标签
[root@k8s-master1 pod]# kubectl get pods --all-namespaces --show-labels
6.1.3 打标签示例
# 实操测试
[root@k8s-master1 ~]# cd pod
# 先创建一个Pod资源
[root@k8s-master1 pod]# kubectl apply -f pod-first.yaml
pod/tomcat-test created

# 查看Pod资源状态
[root@k8s-master1 pod]# kubectl get pods
NAME          READY   STATUS    RESTARTS   AGE
tomcat-test   1/1     Running   0          4s
# 查看Pod资源此时所拥有的所有标签
[root@k8s-master1 pod]# kubectl get pods --show-labels
NAME          READY   STATUS    RESTARTS   AGE   LABELS
tomcat-test   1/1     Running   0          10s   app=tomcat

# 第一种方法:利用命令去增添此Pod资源的
[root@k8s-master1 pod]# kubectl label pods tomcat-test release=v1

# 第二种方法:去yaml文件里面添加标签,然后apply -f 更新文件
[root@k8s-master1 pod]# vim pod-first.yaml
...
metadata:
  labels:
    app: tomcat
    a: b
    c: d
[root@k8s-master1 pod]# kubectl apply -f pod-first.yaml

[root@k8s-master1 pod]# kubectl get pods --show-labels
NAME          READY   STATUS    RESTARTS   AGE     LABELS
tomcat-test   1/1     Running   0          2m20s   a=b,app=tomcat,c=d,release=v1
6.1.4 删除标签
# 单个资源
kubectl label <资源类型ps:pods,nodes> <资源名称> <标签键>-	# 标签后面加个‘-’,一定没有空格!

# 批量删除
kubectl label <资源类型> --all <标签键>-
6.2 node 节点选择器
我们在创建Pod资源的时候,Pod会根据schduler进行调度,那么默认会调度到随机的一个工作节点,
如果,我们想要Pod调度到指定的节点或者调度到一些具有相同特点的node节点,怎么办呢?
可以使用Pod中的nodeName或者nodeSelector字段指定要调度到的node节点。
6.2.1 nodeName
指定Pod节点运行在哪个具体的node上,示例如下:
n1 && n2 ~]# ctr -n k8s.io images import tomcat.tar.gz
n1 && n2 ~]# ctr -n k8s.io images import busybox.tar.gz

[root@k8s-master1 pod]# vim test_nodeName.yaml
apiVersion: v1
kind: Pod
metadata:
  labels:
    app: myapp
    env: dev
  name: test-nodename
  namespace: default
spec:
  nodeName: k8s-node1.kaser.org		# 指示调度器schduler调度到node1上
  containers:
    - name: tomcat-pod-java				# 第一个容器:tomcat
      image: tomcat:8.5-jre8-alpine
      imagePullPolicy: IfNotPresent
      ports:
        - containerPort: 8080
    - name: busybox						# 第二个容器:busybox
      image: busybox:latest
      imagePullPolicy: IfNotPresent
      command:
        - "/bin/sh"
        - "-c"
        - "sleep 3600"

[root@k8s-master1 pod]# kubectl apply -f test_nodeName.yaml
# 查看是否调度到node1节点上
[root@k8s-master1 pod]# kubectl get pods -owide
...... k8s-node1.kaser.org
6.2.2 nodeSelector
nodeSelector 是 Kubernetes 中最简单、最直接的节点选择约束机制,它允许你将 Pod 调度到具有特定标签的节点上。
Pod → nodeSelector → 匹配节点标签 → 调度到符合条件的节点,示例如下:
[root@k8s-master1 pod]# cp test_nodeName.yaml test_nodeName_1.yaml
[root@k8s-master1 pod]# vim test_nodeName_1.yaml
apiVersion: v1
kind: Pod
metadata:
  labels:
    app: myapp
    env: dev
  name: test-nodename-1
  namespace: default
spec:
  nodeSelector:
    disk: ceph				# 设置节点标签 disk: ceph
  containers:
    - name: tomcat-pod-java
      image: tomcat:8.5-jre8-alpine
      imagePullPolicy: IfNotPresent
      ports:
        - containerPort: 8080
    - name: busybox
      image: busybox:latest
      imagePullPolicy: IfNotPresent
      command:
        - "/bin/sh"
        - "-c"
        - "sleep 3600"

[root@k8s-master1 pod]# kubectl apply -f test_nodeName_1.yaml
[root@k8s-master1 pod]# kubectl get pods
NAME              READY   STATUS    RESTARTS   AGE
test-nodename-1   0/2     Pending   0          5s

[root@k8s-master1 pod]# kubectl describe pods test-nodename-1
  Warning  FailedScheduling  6m17s  default-scheduler  0/3 nodes are available: 1 node(s) had untolerated taint {node-role.kubernetes.io/control-plane: }, 2 node(s) didn't match Pod's node affinity/selector. preemption: 0/3 nodes are available: 3 Preemption is not helpful for scheduling.
# 显示这个k8s集群的三个几点都没有找到这个标签disk: ceph

# 自我测试一下,发现什么都没有
[root@k8s-master1 pod]# kubectl get nodes --show-labels | grep ceph

# 给 k8s-node2.kaser.org 打节点标签
[root@k8s-master1 pod]# kubectl label nodes k8s-node2.kaser.org disk=ceph

# 删除原先的Pod资源并apply重新加载yaml文件
[root@k8s-master1 pod]# kubectl delete pod test-nodename-1
[root@k8s-master1 pod]# kubectl apply -f test_nodeName_1.yaml

# 此时状态就由 Pending --> Running
[root@k8s-master1 pod]# kubectl get pods
NAME              READY   STATUS    RESTARTS   AGE
test-nodename-1   2/2     Running   0          2s

# 检查是否将其调度到node2的节点上去
[root@k8s-master1 pod]# kubectl get pods -owide
......k8s-node2.kaser.org

#
[root@k8s-master1 pod]# kubectl get nodes -l disk
NAME                  STATUS   ROLES   AGE   VERSION
k8s-node2.kaser.org   Ready    work    23h   v1.31.3
6.3 亲和性 Affinity
6.3.1 node Affinity node节点亲和性
节点亲和性是 K8s 中的一种调度机制,用于控制 Pod 被调度到特定节点的策略。
它基于节点的标签(Lables)定义规则,使调度过程更灵活灵活、精细,适用于需要特定节点资源。
# affinity
[root@k8s-master1 ~]# kubectl explain pods.spec.affinity
...
FIELDS:
  nodeAffinity
  podAffinity
  podAntiAffinity
# nodeAffinity
[root@k8s-master1 ~]# kubectl explain pods.spec.affinity.nodeAffinity
  preferredDuringSchedulingIgnoredDuringExecution
  # prefered表示有节点尽量满足这个位置定义的亲和性,这不是一个必须的条件,软亲和性
  requiredDuringSchedulingIgnoredDuringExecution
  # require表示必须有节点满足这个位置定义的亲和性,这是个硬性条件,硬亲和性
6.3.1.1 软亲和性
# preferredDuringSchedulingIgnoredDuringExecution
[root@k8s-master1 ~]# kubectl explain pods.spec.affinity.nodeAffinity.preferredDuringSchedulingIgnoredDuringExecution
...
  preference    <NodeSelectorTerm> -required-
  weight        <integer> -required-
软亲和性示例:
# 上传资源文件至工作节点,并手动导入
n1 && n2 ]# ctr -n k8s.io images import myapp-v1.tar.gz
# 编写yaml文件
[root@k8s-master1 pod]# vim pod-nodeaffinity-demo-2.yaml
apiVersion: v1
kind: Pod
metadata:
  labels:
    app: myapp
    env: dev
  name: pod-nodeaffinity-demo-2
  namespace: default
spec:
  affinity:
    nodeAffinity:
      preferredDuringSchedulingIgnoredDuringExecution:	# 软亲和性
      - preference:
          matchExpressions:
          - key: zone1
            operator: In
            values:
            - foo1					# 这里注意,两个新添的前面都要有 -,要不然会报错
            - bar1
        weight: 20					# 这里是权重20
      - preference:
          matchExpressions:
          - key: zone2
            operator: In
            values:
            - foo2
            - bar2
        weight: 10					# 这里是权重10,比上面的权重小
  containers:
  - image: docker.io/ikubernetes/myapp:v1
    imagePullPolicy: IfNotPresent
    name: myapp
# 实验1:软亲和性的特性(即使没有对应的标签,也会进行调度)
[root@k8s-master1 pod]# kubectl apply -f pod-nodeaffinity-demo-2.yaml
[root@k8s-master1 pod]# kubectl get pods
NAME                      READY   STATUS    RESTARTS   AGE
pod-nodeaffinity-demo-2   1/1     Running   0          8s	# Running状态

# 查看调度到了哪个工作节点上
[root@k8s-master1 pod]# kubectl get pods -owide
k8s- node2.kaser.org   <none>           <none>
# 实验2:软亲和性的关键参数weight权重
# weight权重是相对权重!	-- 权重越高,Pod调度的几率就越大

# 先删除Pod资源以免影响实验效果
[root@k8s-master1 pod]# kubectl delete pod pod-nodeaffinity-demo-2

[root@k8s-master1 pod]# kubectl get nodes
NAME                    STATUS   ROLES           AGE   VERSION
k8s-master1.kaser.org   Ready    control-plane   13d   v1.31.3
k8s-node1.kaser.org     Ready    work            13d   v1.31.3
k8s-node2.kaser.org     Ready    work            13d   v1.31.3

# 查看yaml文件的权重部分
[root@k8s-master1 pod]# more pod-nodeaffinity-demo-2.yaml

      - preference:
          matchExpressions:
          - key: zone1
            operator: In
            values:
            - foo1
            - bar1
        weight: 20
      - preference:
          matchExpressions:
          - key: zone2
            operator: In
            values:
            - foo2
            - bar2
        weight: 10

# 并给节点打标签!
[root@k8s-master1 pod]# kubectl label nodes k8s-node1.kaser.org zone1=foo1
[root@k8s-master1 pod]# kubectl label nodes k8s-node2.kaser.org zone2=foo2

# 此时权重:node1 -- 20;node2 -- 10
# 一会测试看看是否将Pod调度到node1(权重高:20>10,优先调度)上
[root@k8s-master1 pod]# kubectl apply -f pod-nodeaffinity-demo-2.yaml
# 成功!
[root@k8s-master1 pod]# kubectl get pods -owide
k8s-node1.kaser.org   <none>           <none>
# 为了下面的实验效果,将一部分资源删除
[root@k8s-master1 pod]# kubectl label nodes k8s-node1.kaser.org zone1-
[root@k8s-master1 pod]# kubectl label nodes k8s-node2.kaser.org zone2-
[root@k8s-master1 pod]# kubectl delete pod pod-nodeaffinity-demo-2
6.3.1.2 硬亲和性
# requiredDuringSchedulingIgnoredDuringExecution
[root@k8s-master1 ~]# kubectl explain pods.spec.affinity.nodeAffinity.requiredDuringSchedulingIgnoredDuringExecution
...
  nodeSelectorTerms     <[]NodeSelectorTerm> -required-
# nodeSelectorTerms
[root@k8s-master1 ~]# kubectl explain pods.spec.affinity.nodeAffinity.requiredDuringSchedulingIgnoredDuringExecution.nodeSelectorTerms
...
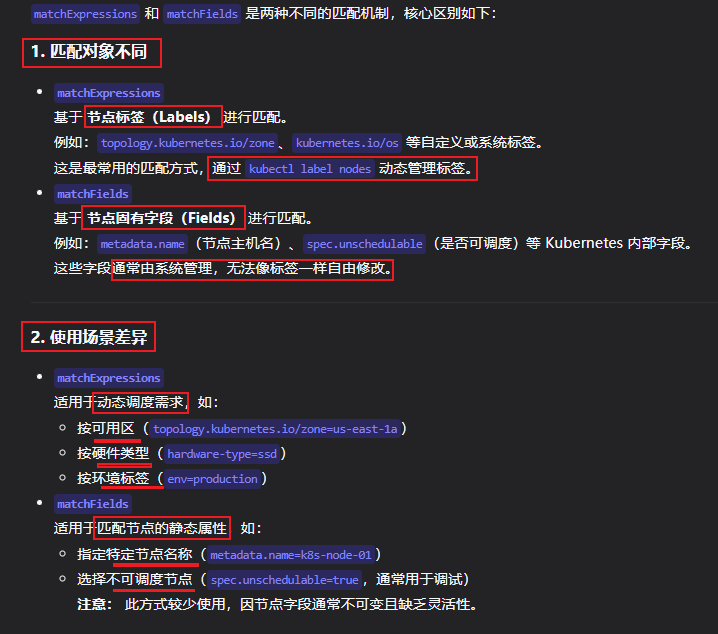
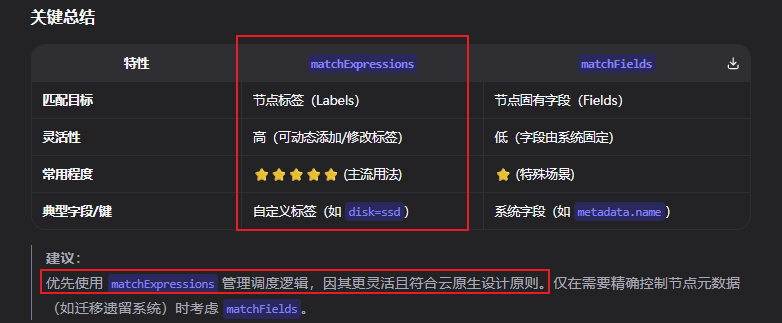
  matchExpressions      <[]NodeSelectorRequirement>		# 匹配表达式的
  matchFields   <[]NodeSelectorRequirement>				# 匹配字段的
# matchExpressions
[root@k8s-master1 ~]# kubectl explain pods.spec.affinity.nodeAffinity.requiredDuringSchedulingIgnoredDuringExecution.nodeSelectorTerms.matchExpressions
...
FIELDS:
  key   <string> -required-				# 检查label

  operator      <string> -required-		# 坐等值选则还是不等值选则
    Possible enum values:
     - `"DoesNotExist"`
     - `"Exists"`
     - `"Gt"`
     - `"In"`
     - `"Lt"`
     - `"NotIn"`

  values        <[]string>				# 给定值
# matchFields
[root@k8s-master1 ~]# kubectl explain pods.spec.affinity.nodeAffinity.requiredDuringSchedulingIgnoredDuringExecution.nodeSelectorTerms.matchFields
...
FIELDS:
  key   <string> -required-

  operator      <string> -required-
    Possible enum values:
     - `"DoesNotExist"`
     - `"Exists"`
     - `"Gt"`
     - `"In"`
     - `"Lt"`
     - `"NotIn"`

  values        <[]string>
硬亲和性示例:
# 上传资源文件至工作节点,并手动导入	(上面的演示实验要是上传了,就不用管了)
n1 && n2 ]# ctr -n k8s.io images import myapp-v1.tar.gz

# 控制节点写下yaml文件
[root@k8s-master1 ~]# vim pod-nodeaffinity-demo.yaml
apiVersion: v1
kind: Pod
metadata:
  labels:
    app: myapp
    env: dev
  name: pod-nodeaffinity-demo
  namespace: default
spec:
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
        - matchExpressions:
          - key: zone
            operator: In
            values:
            - foo
            - bar
  containers:
  - image: docker.io/ikubernetes/myapp:v1
    imagePullPolicy: IfNotPresent
    name: myapp

[root@k8s-master1 ~]# kubectl apply -f pod-nodeaffinity-demo.yaml
# 发现Pod资源处于Pending状态
[root@k8s-master1 ~]# kubectl get pods
NAME                    READY   STATUS    RESTARTS   AGE
pod-nodeaffinity-demo   0/1     Pending   0          11m

# 查看Pod的详细信息显示,三个节点都匹配不到:不存在的标签key=foo,key=bar(会导致 Pod 无法调度)
[root@k8s-master1 ~]# kubectl describe pods pod-nodeaffinity-demo
Warning  FailedScheduling  2m59s (x2 over 7m59s)  default-scheduler  0/3 nodes are available: 1 node(s) had untolerated taint {node-role.kubernetes.io/control-plane: }, 2 node(s) didn't match Pod's node affinity/selector. preemption: 0/3 nodes are available: 3 Preemption is not helpful for scheduling.

# 由于使用的是硬亲和性,条件是必须得满足,因此打标签测试

# 查看nodes
[root@k8s-master1 ~]# kubectl get nodes
NAME                    STATUS   ROLES           AGE   VERSION
k8s-master1.kaser.org   Ready    control-plane   13d   v1.31.3
k8s-node1.kaser.org     Ready    work            13d   v1.31.3
k8s-node2.kaser.org     Ready    work            13d   v1.31.3
# 给node1打标签
[root@k8s-master1 ~]# kubectl label nodes k8s-node1.kaser.org zone=foo

# 查看Pod状态
[root@k8s-master1 ~]# kubectget pods
NAME                    READY   STATUS    RESTARTS   AGE
pod-nodeaffinity-demo   1/1     Running   0          18m

# 查看被调度node1上,成功!
[root@k8s-master1 ~]# kubectl get pods -owide
k8s-node1.kaser.org   <none>           <none>
# 删除资源,避免影响下面的实验:
[root@k8s-master1 pod]# kubectl label nodes k8s-node1.kaser.org zone-
[root@k8s-master1 pod]# kubectl delete pod pod-nodeaffinity-demo
6.3.2 pod Affinity pod节点亲和性
第一个pod随机选则一个节点,做为评判后续的pod能否到达这个pod所在的节点上的运行方式,这就称为pod亲和性。
我们怎么判定哪些节点是相同位置的,哪些节点是不同位置的;我们在定义pod亲和性时需要有一个前提,哪些pod在同一个位置,哪些pod不在同一个位置,这个位置是怎么定义的,标准是什么?以节点名称为标准,这个节点名称相同的表示是同一个位置,节点名称不相同的表示不是一个位置。
- podaffinity:
- pod和pod更倾向腻在一起,把相近的pod结合到相近的位置,如同一区域,同一机架,这样的话pod和pod之间更好通信,比方说有两个机房,这两个机房部署的集群有1000台主机,那么我们希望把nginx和tomcat都部署同一个地方的node节点上,可以提高通信效率;
- podunaffinity:
- pod和pod更倾向不腻在一起,如果部署两套程序,那么这两套程序更倾向于反亲和性,这样相互之间不会有影响。
# 演示
[root@k8s-master1 pod]# kubectl explain pods.spec.affinity.podAffinity
...
# 软亲和性:
  preferredDuringSchedulingIgnoredDuringExecution       <[]WeightedPodAffinityTerm>
# 硬亲和性:
  requiredDuringSchedulingIgnoredDuringExecution        <[]PodAffinityTerm>
# 以硬亲和性为例(只列出重要的):
[root@k8s-master1 pod]# kubectl explain pods.spec.affinity.podAffinity.requiredDuringSchedulingIgnoredDuringExecution
...
  labelSelector <LabelSelector>
...
  topologyKey   <string> -required-		# 位置拓扑的键
# labelSelector
[root@k8s-master1 pod]# kubectl explain pods.spec.affinity.podAffinity.requiredDuringSchedulingIgnoredDuringExecution.labelSelector
...
  matchExpressions      <[]LabelSelectorRequirement>		# 重要!
  matchLabels   <map[string]string>
# matchExpressions
[root@k8s-master1 pod]# kubectl explain pods.spec.affinity.podAffinity.requiredDuringSchedulingIgnoredDuringExecution.labelSelector.matchExpressions
...
  key   <string> -required-
  operator      <string> -required-
  values        <[]string>
topologyKey:
位置拓扑的键,这个是必须字段
怎么判断是不是同一个位置:
rack=rack1
row=row1
使用rack的键是同一个位置
使用row的键是同一个位置
labelSelector:
我们要判断pod跟别的pod亲和,跟哪个pod亲和,需要靠labelSelector,通过labelSelector选则一组能作为亲和对象的pod资源
namespace:
labelSelector需要选则一组资源,那么这组资源是在哪个名称空间中呢,通过namespace指定,如果不指定namespaces,那么就是当前创建pod的名称空间
Pod节点亲和性示例:
# 定义两个Pod,第一个Pod作为基准,第二个Pod跟着它走
[root@k8s-master1 pod]# vim pod-required-affinity-demo-1.yaml
# 此时pod-first并没有指定要调度到哪个节点(因此随机调度)
[root@k8s-master1 pod]# kubectl apply -f pod-required-affinity-demo-1.yaml
apiVersion: v1
kind: Pod
metadata:
  name: pod-first
  namespace: default
  labels:
    app2: myapp2
    env: dev
spec:
  containers:
  - name: myapp
    image: docker.io/ikubernetes/myapp:v1
    imagePullPolicy: IfNotPresent

# 此时调度到了node2上
[root@k8s-master1 pod]# kubectl get pods -owide
pod-first   1/1     k8s-node2.kaser.org

# 编写pod-second的yaml文件
# 下面表示创建的pod必须与拥有app2=myapp2标签的pod在一个节点上
[root@k8s-master1 pod]# vim pod-required-affinity-demo-2.yaml
apiVersion: v1
kind: Pod
metadata:
  name: pod-second
  namespace: default
  labels:
    app2: backend
    env: dev
spec:
  containers:
  - name: busybox
    image: docker.io/library/busybox:latest
    imagePullPolicy: IfNotPresent
    command: ["sh","-c","sleep 3600"]
  affinity:								# 注意!!!
    podAffinity:						# pod节点亲和性
      requiredDuringSchedulingIgnoredDuringExecution:	# 硬亲和
      - labelSelector:					# 标签选择器
          matchExpressions:				# 跟随 key=myapp2 的pod
          - {key: "app2",operator: "In",values: ["myapp2"]}
        topologyKey: kubernetes.io/hostname	# 位置拓扑的键

##############################################################
# 示例:寻找位置拓扑的键 --> topologyKey: kubernetes.io/hostname
[root@k8s-master1 ~]# kubectl get nodes --show-labels
...kubernetes.io/hostname=k8s-master1.kaser.org...
...kubernetes.io/hostname=k8s-node1.kaser.org...
...kubernetes.io/hostname=k8s-node2.kaser.org...
#############################################################

[root@k8s-master1 pod]# kubectl apply -f pod-required-affinity-demo-2.yaml
# 因此,构成pod亲和性
[root@k8s-master1 pod]# kubectl get pods -owide
pod-first    k8s-node2.kaser.org
pod-second   k8s-node2.kaser.org
6.3.3 pod AntiAffinity pod节点反亲和性
pod节点反亲和性示例1:
# 定义两个pod,第一个pod作为基准,第二个跟它调度相反节点
[root@k8s-master1 pod]# vim pod-required-anti-affinity-demo-1.yaml
apiVersion: v1
kind: Pod
metadata:
  name: pod-first
  labels:
    app1: myapp1
    tier: frontend
spec:
    containers:
    - name: myapp
      image: ikubernetes/myapp:v1
      imagePullPolicy: IfNotPresent

[root@k8s-master1 pod]# kubectl apply -f pod-required-anti-affinity-demo-1.yaml
pod-first    k8s-node2.kaser.org
[root@k8s-master1 pod]# vim pod-required-anti-affinity-demo-2.yaml
apiVersion: v1
kind: Pod
metadata:
  name: pod-second
  labels:
    app: backend
spec:
  containers:
  - name: busybox
    image: docker.io/library/busybox:latest
    imagePullPolicy: IfNotPresent
    command: ["sh","-c","sleep 3600"]
  affinity:
    podAntiAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
      - labelSelector:
          matchExpressions:
          - {key: app1,operator: In,values: ["myapp1"]}
        topologyKey: kubernetes.io/hostname

[root@k8s-master1 pod]# kubectl apply -f pod-required-anti-affinity-demo-2.yaml

[root@k8s-master1 pod]# kubectl get pods -owide
pod-first    k8s-node2.kaser.org
pod-second   k8s-node1.kaser.org

# 删除资源,以免影响后续实验
[root@k8s-master1 pod]# kubectl delete pods pod-first pod-second --force
pod节点反亲和性示例2:
# 换一个topologykey zone
[root@k8s-master1 pod]# kubectl get nodes
NAME                    STATUS   ROLES           AGE   VERSION
k8s-master1.kaser.org   Ready    control-plane   14d   v1.31.3
k8s-node1.kaser.org     Ready    work            13d   v1.31.3
k8s-node2.kaser.org     Ready    work            13d   v1.31.3

# 打两个标签
[root@k8s-master1 pod]# kubectl label nodes k8s-node1.kaser.org zone=foo
[root@k8s-master1 pod]# kubectl label nodes k8s-node2.kaser.org zone=foo

# 编写yaml
[root@k8s-master1 pod]# vim pod-first-required-anti-affinity-demo-1.yaml
apiVersion: v1
kind: Pod
metadata:
  name: pod-first
  labels:
    app3: myapp3
    tier: frontend
spec:
    containers:
    - name: myapp
      image: ikubernetes/myapp:v1
      imagePullPolicy: IfNotPresent

[root@k8s-master1 pod]# kubectl apply -f pod-first-required-anti-affinity-demo-1.yaml

# pod资源被调度到node2
[root@k8s-master1 pod]# kubectl get pods -owide
pod-first   k8s-node2.kaser.org   <none>           <none>

# 编写yaml
[root@k8s-master1 pod]# vim pod-first-required-anti-affinity-demo-2.yaml
apiVersion: v1
kind: Pod
metadata:
  name: pod-second
  labels:
    app: backend
spec:
  containers:
  - name: busybox
    image: docker.io/library/busybox:latest
    imagePullPolicy: IfNotPresent
    command: ["sh","-c","sleep 3600"]
  affinity:
    podAntiAffinity:			# pod反亲和性
      requiredDuringSchedulingIgnoredDuringExecution:	# 硬亲和性
      - labelSelector:
          matchExpressions:
          - {key: "app3",operator: "In",values: ["myapp3"]}
        topologyKey: zone

[root@k8s-master1 pod]# kubectl apply -f pod-first-required-anti-affinity-demo-2.yaml

# 查看状态(发现状态为Pending!)
# 首先:pod反亲和性的标签选择性和topologkey都是互斥的,因此Pending
[root@k8s-master1 pod]# kubectl get pods -owide
pod-first    Running   k8s-node2.kaser.org
pod-second   Pending   <none>
# 详细查看
[root@k8s-master1 pod]# kubectl describe pods pod-second
...
Warning  FailedScheduling  21s   default-scheduler  0/3 nodes are available: 1 node(s) had untolerated taint {node-role.kubernetes.io/control-plane: }, 2 node(s) didn't match pod anti-affinity rules. preemption: 0/3 nodes are available: 1 Preemption is not helpful for scheduling, 2 No preemption victims found for incoming pod.
podaffinity			pod节点亲和性,pod倾向于哪个pod
poduntiaffinity		pod反亲和性
nodeaffinity		node节点亲和性,pod倾向于哪个node
6.4 污点 Taints、容忍度 Tolerations
6.4.1 污点 Taints
- 作用对象:节点Node
- 目的:排斥不满足条件的Pod,防止调度到特定节点
- 组成:
<key>=<value>:<effect>key:污点标识value:可选值(可为空)effect:排斥行为类型(关键)
| Effect类型 | 行为 |
|---|---|
NoSchedule | 禁止新 Pod 调度,担已运行的不影响 |
PreferNoSchedule | 尽量避免调度(软性排斥,调度器会优先选择其他节点) |
NoExecute | 禁止新 Pod 调度并驱逐已运行的不兼容的 Pod(硬性排斥、触发驱逐) |
6.4.2 容忍度 Tolerations
- 作用对象:Pod
- 目的:声明Pod可以容忍节点的特定污点
- 匹配规则:
tolerations:
- key: "key1"           # 污点 key
  operator: "Equal"     # 匹配操作符(Equal/Exists)
  value: "value1"       # 污点 value(仅当 operator=Equal 时有效)
  effect: "NoSchedule"  # 污点 effect
  tolerationSeconds: 30 # 仅对 NoExecute 有效:容忍后继续运行的秒数
6.4.3 核心机制详解
6.4.3.1 调度阶段匹配规则
- 必要条件:Pod 要调度到节点,必须容忍该节点所有污点
- 节点有污点 A 和 B → Pod 需同时容忍 A 和 B
- effect 精确匹配:
- Pod 的容忍
effect: NoSchedule无法匹配 节点的effect: NoExecute - 示例:Master 节点污点
control-plane:NoSchedule需要 Pod 显式声明effect: NoSchedule的容忍
- Pod 的容忍
6.4.3.2 运行阶段行为(NoExecute 专属)
- 场景:节点新增
NoExecute污点时- 无容忍的 Pod:立即驱逐
- 有容忍但无
tolerationSeconds:永不驱逐 - 有容忍且指定
tolerationSeconds:容忍期结束后驱逐
tolerations:
- key: "node.kubernetes.io/not-ready"
  effect: "NoExecute"
  tolerationSeconds: 300  # 节点失联后 5 分钟内不驱逐
6.4.4 特殊匹配规则
| operator | 匹配条件 | 示例场景 |
|---|---|---|
Equal | 完全匹配 key=value:effect | GPU 节点专用 Pod |
Exists | 仅匹配 key 和 effect(忽略 value) | 容忍所有 control-plane 污点 |
空 key + Exists | 匹配所有指定 effect 的污点(无论 key/value) | 容忍所有 NoExecute 污点 |
正确示例:
节点污点:disk=ssd:NoSchedule
Pod 容忍:- key: "disk" operator: "Equal" value: "ssd" effect: "NoSchedule"
6.4.5 示例
[root@k8s-master1 pod]# kubectl get nodes
NAME                    STATUS   ROLES           AGE   VERSION
k8s-master1.kaser.org   Ready    control-plane   14d   v1.31.3
k8s-node1.kaser.org     Ready    work            14d   v1.31.3
k8s-node2.kaser.org     Ready    work            14d   v1.31.3

[root@k8s-master1 pod]# kubectl explain nodes.spec.taints
...
  effect        <string> -required-
     - `"NoExecute"`		# 最低容忍度
     	即影响pod调度过程,又影响现存pod资源
     	(简单来说:没符合条件且没被调度的pod来不了,没符合条件且被调度的pod被驱逐)
     - `"NoSchedule"`		# 其次容忍度
     	只影响pod调度过程,现存的pod不影响
     - `"PreferNoSchedule"`	# 最高容忍度
     	最好不调度,但是也可以,是NoScheduler的更柔性版本

  key   <string> -required-
...
  value <string>
    The taint value corresponding to the taint key.


[root@k8s-master1 pod]# kubectl describe nodes k8s-master1.kaser.org | grep Taints
Taints:             node-role.kubernetes.io/control-plane:NoSchedule
# master的污点为 :NoScheduler
# 因此,创建的pod都不会调度到这个master上,因为我们创建的pod没有容忍度

# 选一个再来看看,在master的pod有什么容忍度?
[root@k8s-master1 pod]# kubectl get pods -n kube-system -owide | grep master
...
# 在筛选出来里面的挑一个查看
[root@k8s-master1 pod]# kubectl describe pods kube-apiserver-k8s-master1.kaser.org -n kube-system | grep Tolerations
Tolerations:       :NoExecute op=Exists

# 可以看到这个pod的容忍度是NoExecute,则可以调度到
示例1:
# 将node2当成生产环境专用节点,其余node是测试节点
[root@k8s-master1 pod]# kubectl get nodes
NAME                    STATUS   ROLES           AGE   VERSION
k8s-master1.kaser.org   Ready    control-plane   14d   v1.31.3
k8s-node1.kaser.org     Ready    work            14d   v1.31.3
k8s-node2.kaser.org     Ready    work            14d   v1.31.3

# 给node2打污点,pod如果不容忍就不会调度到node2上,只会调度到node1上
[root@k8s-master1 pod]# kubectl taint node k8s-node2.kaser.org node-type=production:NoSchedule

[root@k8s-master1 pod]# vim pod-taint.yaml
apiVersion: v1
kind: Pod
metadata:
  name: pod-taint
  labels:
    tomcat: pod-tomcat
spec:
  containers:
  - name: pod-taint
    ports:
    - containerPort: 8080
    image: docker.io/xianchao/tomcat-8.5-jre8:v1
    imagePullPolicy: IfNotPresent

[root@k8s-master1 pod]# kubectl apply -f pod-taint.yaml
# 确实调度到node1上,因为没有做任何的容忍度处理
[root@k8s-master1 pod]# kubectl get pods -owide
pod-taint   Running		k8s-node1.kaser.org
示例2:
# 将node1也打上污点,看看有什么效果
[root@k8s-master1 pod]# kubectl taint nodes k8s-node1.kaser.org node-type=dev:NoExecute

# pod状态由Running-->Pending
[root@k8s-master1 pod]# kubectl get pods -owide
pod-taint   Pending		<none>
# 编写yaml文件
[root@k8s-master1 pod]# vim pod-taint-1.yaml
apiVersion: v1
kind: Pod
metadata:
  name: myapp-deploy
  labels:
    app: myapp
spec:
  containers:
  - name: myapp
    ports:
    - name: http
      containerPort: 80
    image: docker.io/ikubernetes/myapp:v1
    imagePullPolicy: IfNotPresent
  tolerations:				# 容忍度的设置
  - key: "node-type"
    operator: "Equal"
    value: "production"
    effect: "NoExecute"
    tolerationSeconds: 3600

[root@k8s-master1 pod]# kubectl apply -f pod-taint-1.yaml

[root@k8s-master1 pod]# kubectl get pods
NAME           READY   STATUS    RESTARTS   AGE
myapp-deploy   0/1     Pending   0          16s
# 查看状态发现还是Pending;
# 是由于我们使用的是equal(等值匹配)
# 因此key和value,effect必须和node节点定义的污点完全匹配才可以,此时将“NoExecute”改为“NoScheduel”,并将容忍期删去即可

[root@k8s-master1 pod]# vim pod-taint-1.yaml
  tolerations:				# 容忍度的设置
  - key: "node-type"
    operator: "Equal"
    value: "production"
    effect: "NoSchedule"

[root@k8s-master1 pod]# kubectl delete pods myapp-deploy
[root@k8s-master1 pod]# kubectl apply -f pod-taint-1.yaml
# 再次查看,发现可以调度到node2上了
[root@k8s-master1 pod]# kubectl get pods -owide
myapp-deploy   Running   k8s-node2.kaser.org
示例3:
# 修改如下部分:
tolerations:
- key: "node-type"
  operator: "Exists"	# 不完全匹配,仅匹配key和effect(可以直接忽略value)
  value: ""
  effect: "NoSchedule"


[root@k8s-master1 pod]# kubectl delete pods myapp-deploy
[root@k8s-master1 pod]# vim pod-taint-1.yaml
...
  tolerations:
  - key: "node-type"
    operator: "Exists"		# Equal --> Exists,完全匹配 --> 不完全匹配
    value: ""
    effect: "NoSchedule"

[root@k8s-master1 pod]# kubectl apply -f pod-taint-1.yaml
[root@k8s-master1 pod]# kubectl get pods -owide
myapp-deploy   1/1     Running   k8s-node2.kaser.org


# 修改如下部分:
  tolerations:
  - key: "node-type"
    operator: "Exists"
    value: ""
    effect: ""			# 将effect删去

[root@k8s-master1 pod]# kubectl delete pods myapp-deploy
[root@k8s-master1 pod]# vim pod-taint-1.yaml
...
  tolerations:
  - key: "node-type"
    operator: "Exists"
    value: ""
    effect: ""

[root@k8s-master1 pod]# kubectl apply -f pod-taint-1.yaml

# 此时发现,还是还是可以运行Running且调度到node1(由于两个node节点都有node-type的key)
[root@k8s-master1 pod]# kubectl get pods -owide
myapp-deploy   1/1     Running   k8s-node1.kaser.org


# 为了避免影响后面实验,将资源与污点删去
[root@k8s-master1 pod]# kubectl taint nodes k8s-node1.kaser.org node-type:NoExecute-
[root@k8s-master1 pod]# kubectl taint nodes k8s-node2.kaser.org node-type-
更多推荐


 20
 0
- 0


 已为社区贡献37条内容

所有评论(0)