
机器学习实验——决策树
一、决策树的定义
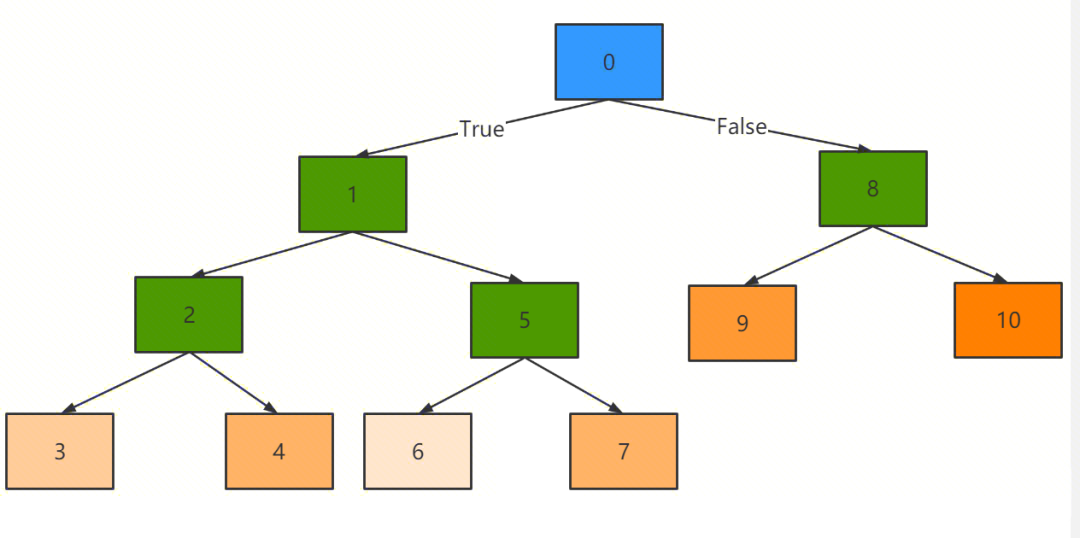
决策树是监督学习领域里一种既能做分类、又能处理回归任务的模型。它的核心思路特别贴近人类做决策的方式——通过一层一层地判断数据的特征,逐步缩小选择范围,最后给出明确的结果。因为整个判断过程会形成一个“根节点→中间节点→叶子节点”的树形结构(根节点是最初的判断条件,中间节点负责筛选中间特征,叶子节点就是最终的决策结果),所以才被叫做“决策树”。和那些复杂的算法比起来,理解它的决策逻辑根本不需要专业的数学知识,也是机器学习中解释性最强的“大众化算法”。
决策树的运行逻辑:从筛选特征到输出结果
决策树的核心运行规则是“逐层筛选、提前结束”,具体的流程可以总结为以下四步:
1. 从根节点开始,先选一个对决策结果影响最大的特征,作为第一个判断条件;
2. 根据这个特征的不同取值,生成多个分支(对应树形结构里的“枝干”),进入下一层的中间节点;
3. 每个中间节点会继续从还没使用过的特征里,挑选关键特征进行再次筛选,重复生成分支的过程;
4. 当某一个分支的特征筛选满足“决策阈值”(也就是不用再筛选其他特征,就能确定结果了),就停止筛选。这个分支的末端就是叶子节点,直接输出决策结果(这个过程有点像“逻辑短路”,不用把所有特征都遍历一遍)。
二、决策树的组成
决策树的核心是由节点和有向边组成的:中间节点对应着数据的特征,叶子节点代表最终的类别,有向边则用来关联特征的具体取值。做分类的时候,从根节点开始,逐次测试数据的属性,再沿着有向边把数据分配到对应的分支,最后到达叶子节点就能确定类别。从根节点到叶子节点的每一条路径,都对应着一套互不冲突且完整的递进规则。作为一种白盒模型,它的规则直观又好懂,是机器学习中非常“友好”的算法。
三、决策树的构建与熵的作用
构建决策树的核心环节是挑选合适的特征,而“熵”这个概念,正是衡量数据混乱程度的重要标准,它能帮我们确定选择特征的先后顺序。
1. 决策树中的熵:判断数据纯度的依据
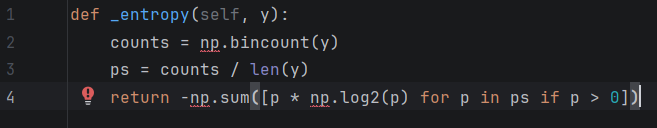
信息熵:专门用来衡量一个数据集的混乱程度。假设一个数据集D里包含K种不同类别,每种类别在数据集中的占比是pk,那信息熵的计算公式就是:H(D)=−∑k=1Kpk log2pk。熵的数值越大,说明数据的无序程度越高。比如如果一个数据集里所有数据都属于同一类别,它的熵就是0,代表数据完全纯净。
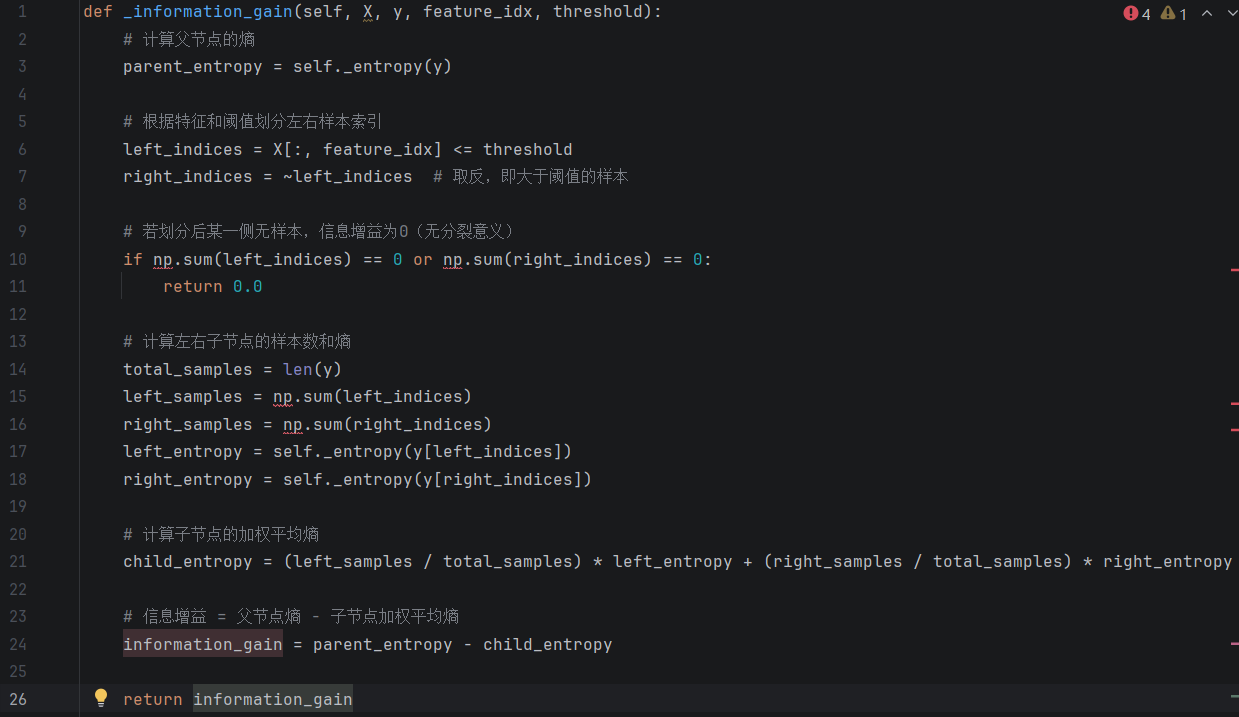
信息增益(ID3算法):用来评估某个特征在降低数据混乱度上的作用大小。计算方式是用父节点的熵,减去所有子节点熵的加权平均值,公式为:Gain(D,A)=H(D)−∑v=1V∣D∣∣Dv∣H(Dv)。这里的A是我们要评估的候选特征,Dv是当特征A取第v个值时,拆分出来的子数据集。信息增益的数值越大,说明这个特征对数据分类的区分能力越强,ID3算法就是依据这个指标来选择每一步的特征。
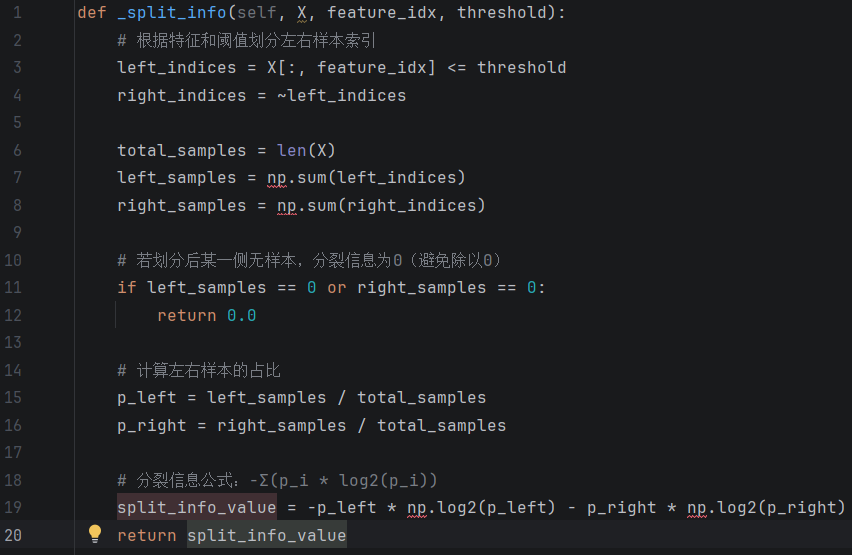
增益率(C4.5算法):因为信息增益有个缺点,就是会偏向那些取值种类多的特征,所以C4.5算法引入了增益率来解决这个问题。它的计算方式是信息增益除以这个特征的“固有值(IV)”,公式为:Gain_ratio(D,A)=IV(A)Gain(D,A)。其中固有值IV(A)=−∑v=1V∣D∣∣Dv∣log2∣D∣∣Dv∣,用来衡量特征取值的多样程度。增益率越高,说明这个特征用于分类的效率就越高。
2. 基于熵的决策树构建流程
决策树是通过不断递归划分数据集来构建的,每一步选择特征时,都以“熵”相关的指标作为依据,具体步骤如下:
确定根节点:先计算所有候选特征的信息增益或者增益率,挑选得分最高的那个特征,作为决策树的根节点。
生成子节点:根据根节点特征的每一个不同取值,把原始数据集划分成多个子数据集,每个子数据集对应生成一个子节点。
递归构建分支:对每个新生成的子节点,重复前面选择特征、划分数据集的步骤,直到满足停止条件。常见的停止条件包括:子数据集的熵为0(所有数据都是同一类别)、决策树的深度达到预设上限、子数据集中的样本数量太少等。
生成叶节点:当递归停止时,当前的子节点就会成为叶节点,叶节点对应的类别,就是这个分支最终的分类结果。
简单来说,决策树是以“熵”为指引,一层一层筛选出区分能力最强的特征,最终形成一套清晰易懂的“如果-那么”分类规则,这也是它作为“白盒模型”的核心优势所在。
四、决策树学习的目标
决策树学习的核心目的,是得到一个泛化能力出色的模型。也就是说,这个决策树不仅能在训练过的数据上表现良好,面对从未见过的新数据,也能做出准确的判断。要实现这个目标,需要做好以下几点:
1.选择合适的决策划分判断标准
2.设置合理的递归停止条件
3.采用恰当的剪枝策略优化模型
4.运用集成学习的方法,进一步提升模型的整体性能
五、决策树模型实战
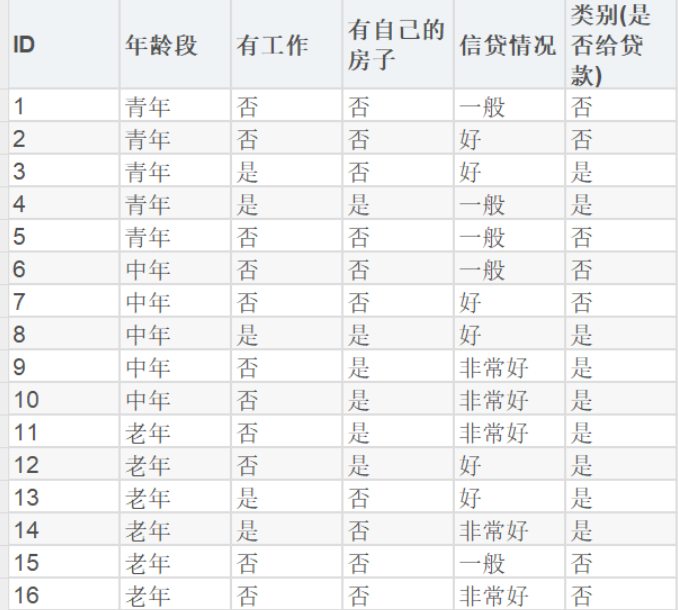
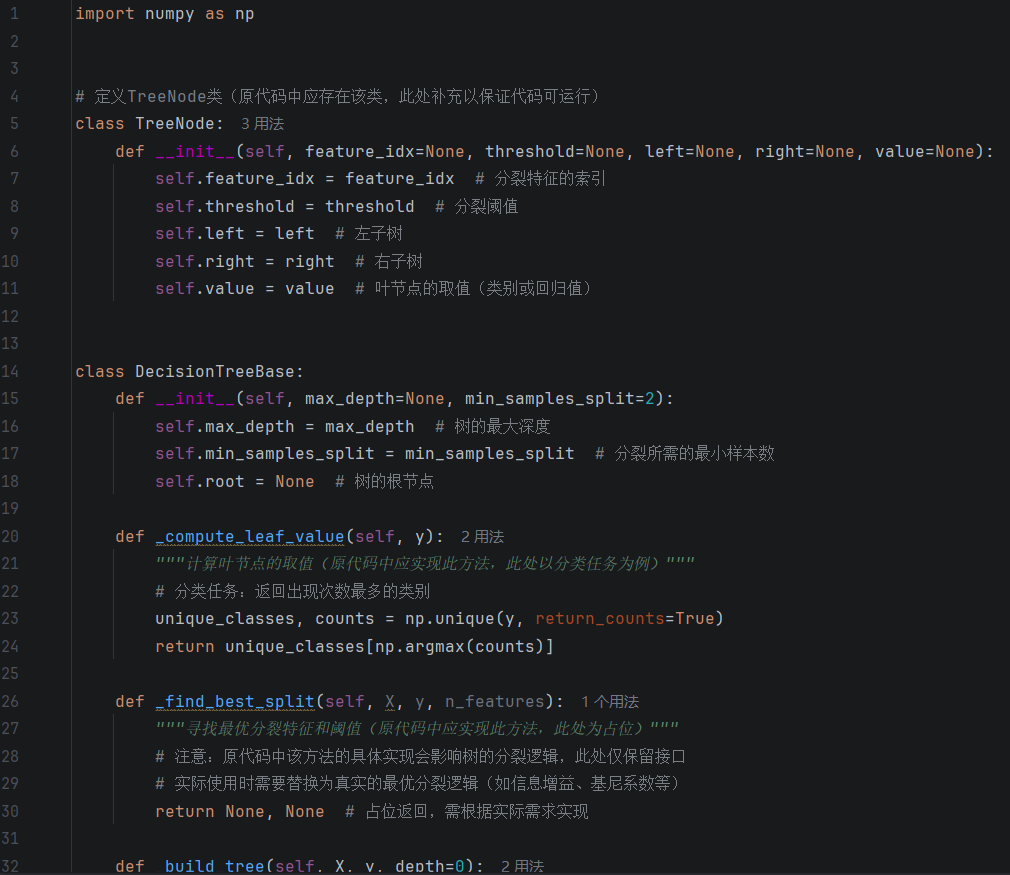
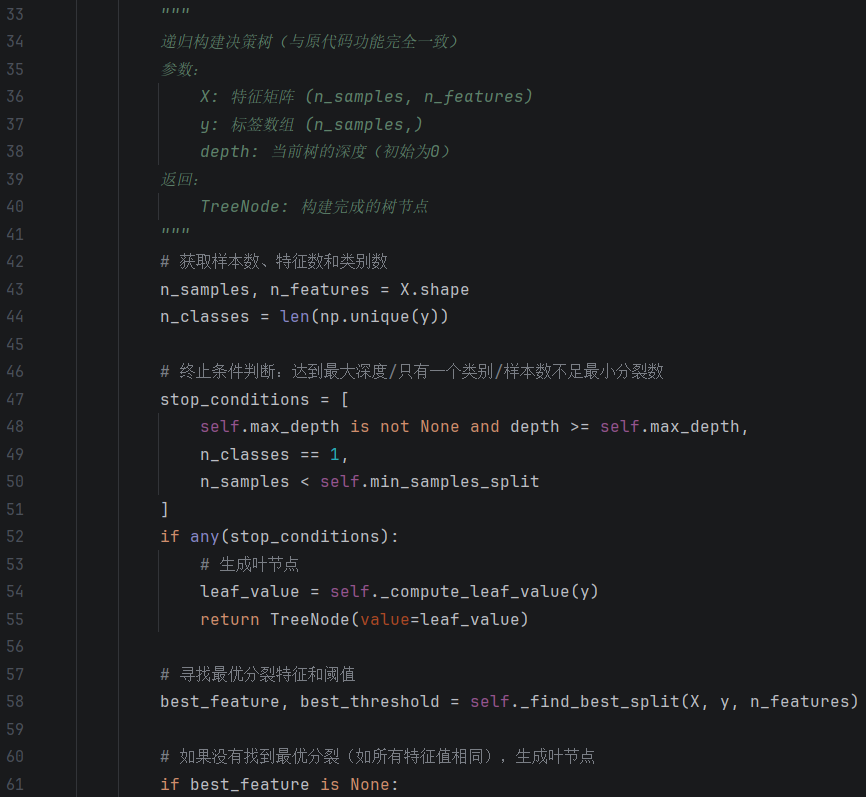
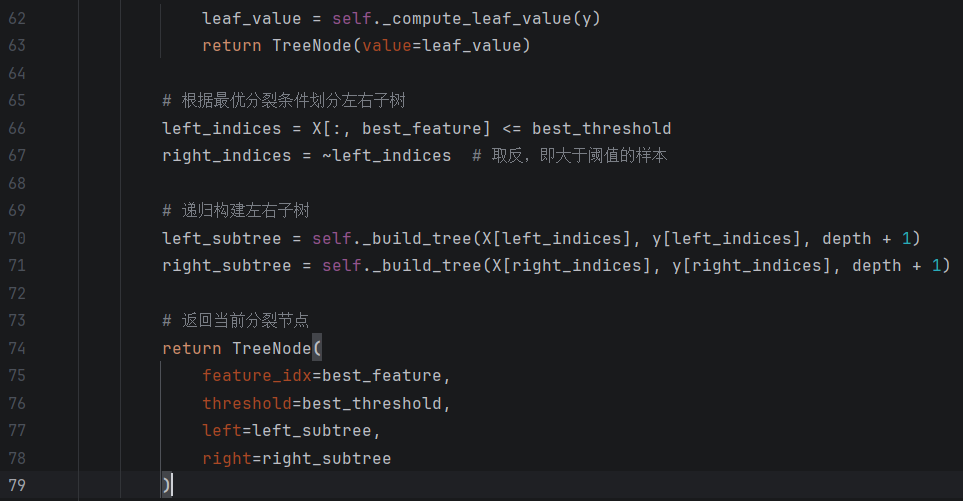
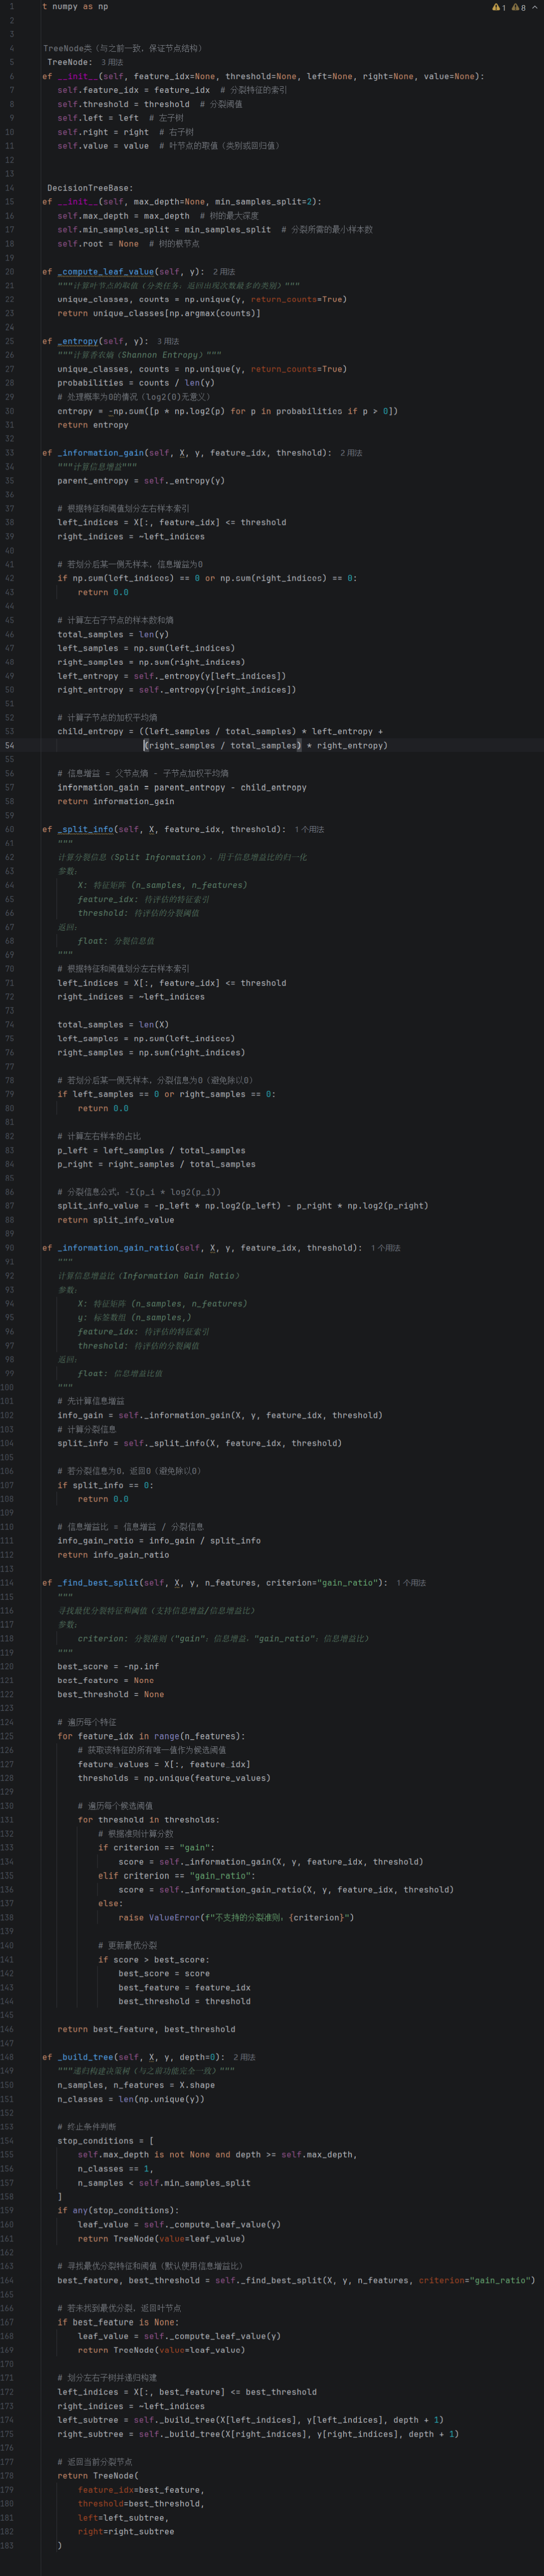
1.构建树:递归构建决策树,当满足达到最大深度,当前节点样本都属于同一类,样本数小于最小分裂数三个条件后停止,划分过程中,调用_find_best_split寻找最佳特征和阈值,根据划分结果递归构建左右子树
 2.计算熵:计算用于度量数据集的纯度或不确定性的熵,其值越小表示数据越纯净。
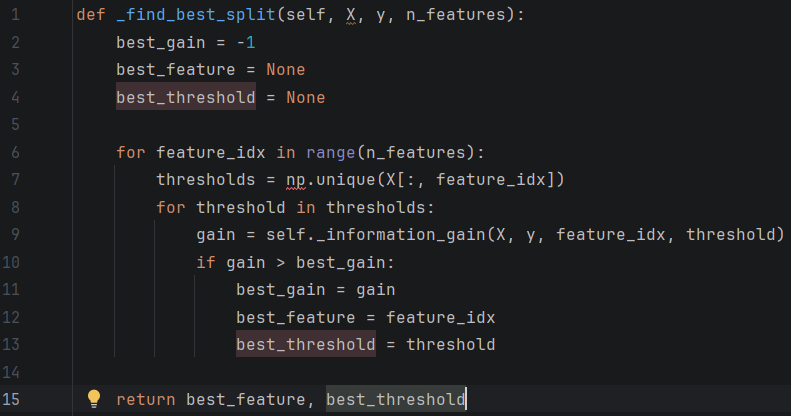
3.寻找最佳划分:遍历所有特征和可能的阈值,选择能带来最大信息增益的划分方式,最后返回最佳特征索引和划分阈值。
4.信息增益:计算按给定特征和阈值划分后的信息增益,信息增益越大表示划分效果越好。
5.4.5信息增益率
6.整体代码实现
更多推荐


 21
 0
- 0


 已为社区贡献4条内容

所有评论(0)