
机器学习实验——贝叶斯
一、贝叶斯分类基础知识
1.1 核心思想:贝叶斯定理
贝叶斯分类的核心原理来源于贝叶斯定理。它的基本思路是,先计算一个样本分别属于各个类别的后验概率,然后把概率值最大的那个类别,作为这个样本的最终预测结果。贝叶斯定理的具体公式如下:
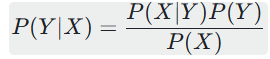
各符号含义:
P(Y|X):后验概率,指在已经知道样本特征是X的情况下,这个样本属于类别Y的概率(这也是我们最终需要计算的核心值)
P(Y):先验概率,是样本属于类别Y的初始概率(可以通过统计训练集中,各类别样本数量占总样本数的比例来估算)
P(X|Y):似然概率,代表在样本确定属于类别Y的前提下,它恰好具有特征X的概率
P(X):证据因子,即样本特征X本身出现的概率(这个值对于所有类别来说都是固定不变的,因此在计算过程中可以忽略,不会影响最终的类别判断结果)
1.2 朴素贝叶斯的“朴素”含义
朴素贝叶斯分类器是在贝叶斯定理的基础上,增加了一个重要的前提假设:样本的所有特征之间都是相互独立的。这个假设能极大降低计算的复杂度——原本计算P(X|Y)时,需要考虑所有特征结合在一起的联合概率,而有了特征独立的假设后,联合概率就可以拆分成每个特征对应条件概率的乘积,让计算变得简单可行。
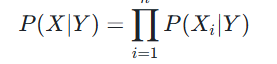
这里的n代表样本的特征总数,Xi则是指样本的第i个特征。尽管“特征之间相互独立”这个假设,在现实的应用场景中很难完全满足,但朴素贝叶斯分类器在很多实际任务里依然能表现出不错的效果。而且它还具备计算速度快、泛化能力好的显著优点。
1.3 常见的朴素贝叶斯模型
根据样本特征所遵循的分布类型不同,朴素贝叶斯分类器也有多种不同的实现方式。在本次实验中,我们主要会用到以下两种:
- 高斯朴素贝叶斯(GaussianNB):适合处理特征为连续数值的情况。它的核心假设是,每个类别下的特征都遵循高斯分布,也就是我们常说的正态分布。
- 多项式朴素贝叶斯(MultinomialNB):适合处理特征为离散数值的情况,比如特征是计数结果或出现频率等。它假设特征服从多项式分布,典型的应用场景就是文本分类中的词频特征。
二、贝叶斯模型实战
2.1 模块1:环境配置与数据加载
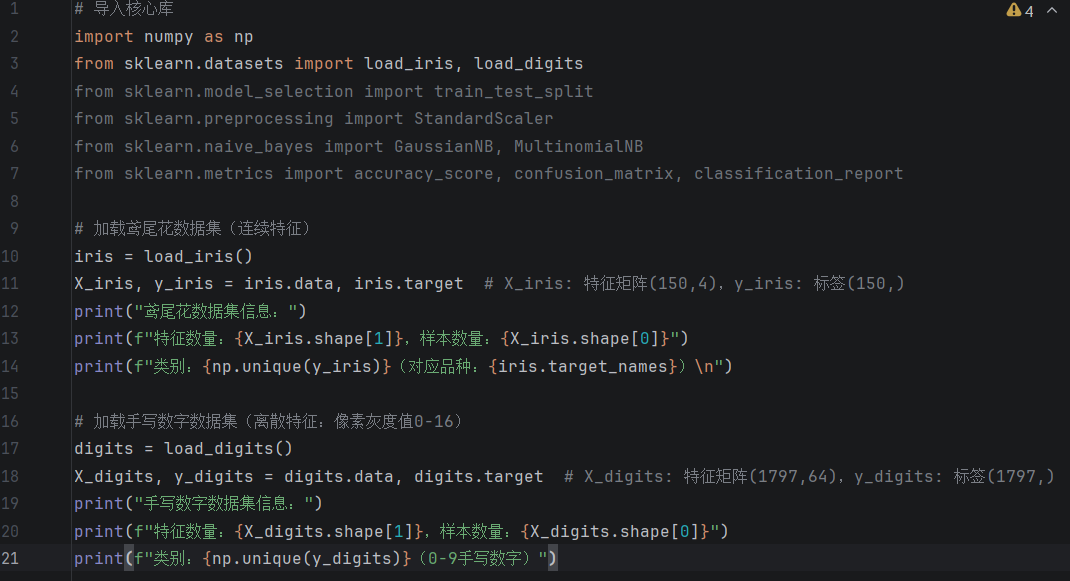
功能说明:首先导入实验需要用到的各类库,然后分别加载两个数据集——鸢尾花数据集(用于演示连续特征)和手写数字数据集(用于演示离散特征)。最后,我们会查看这些数据的基本情况,以此来验证数据集是否完整、确认特征的类型以及各类别样本的分布状况。
2.2 模块2:数据预处理
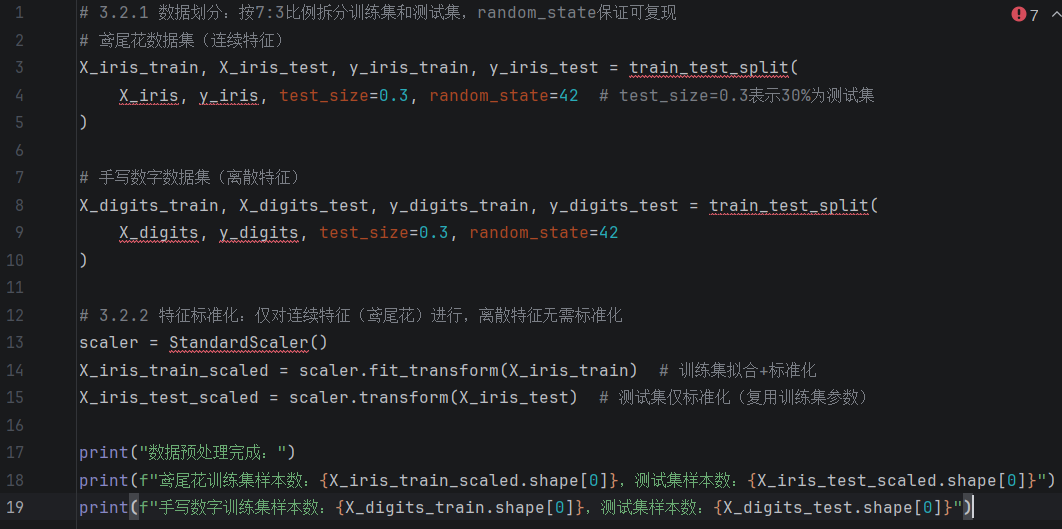
功能说明:对数据进行划分(训练集/测试集)和标准化(仅连续特征),避免量纲影响,保证实验可复现。
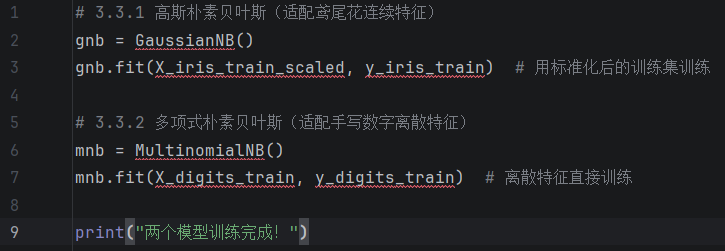
2.3 模块3:模型构建与训练
功能说明:根据数据集特征类型选择对应朴素贝叶斯模型,使用训练集训练模型。
2.4 模块4:模型预测与性能评估
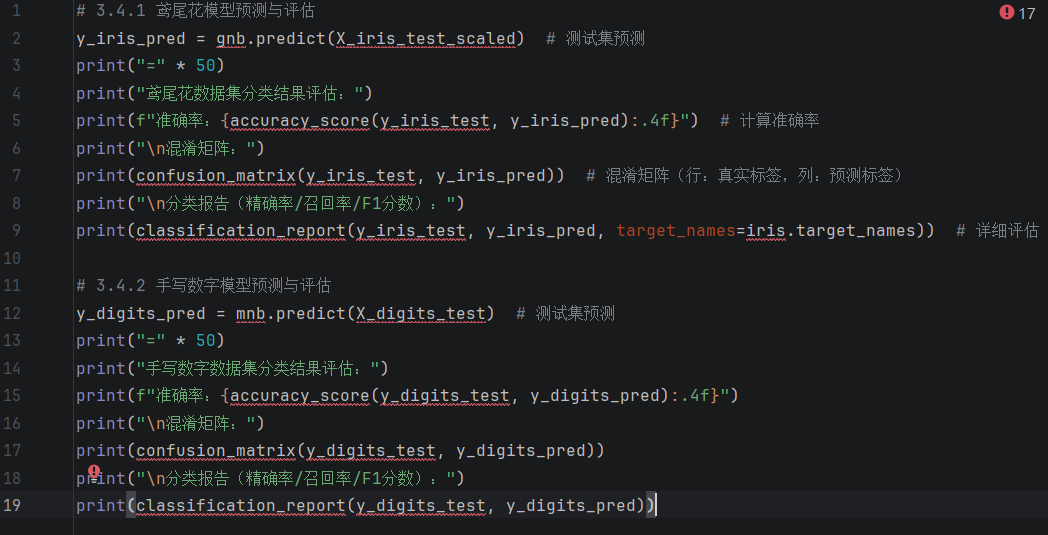
功能说明:使用训练好的模型对测试集进行预测,通过准确率、混淆矩阵、分类报告评估模型性能。
2.5 模块5:参数影响验证
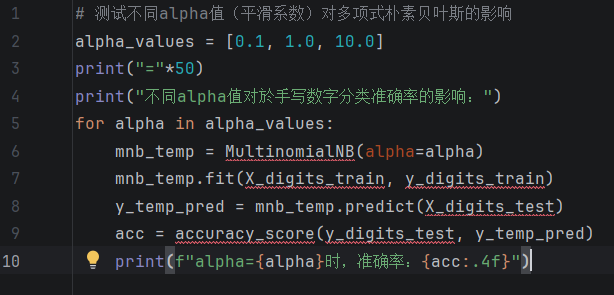
功能说明:验证多项式朴素贝叶斯alpha平滑系数对模型性能的影响。
三、实验结果与分析
3.1 基础实验结果
完成上述全部代码的运行后,我们可以得到以下关键的实验结果:
在鸢尾花数据集上使用高斯朴素贝叶斯模型,整体准确率大概在97.78%左右。从混淆矩阵能够看出,只有1个Versicolor品种的样本被错误地分成了Virginica品种;三个品种对应的精确率、召回率和F1分数都不低于0.96,表现十分出色。
在手写数字数据集上使用多项式朴素贝叶斯模型,整体准确率约为88.33%。混淆矩阵显示,数字3、8、9的误分类情况相对较多;其中数字0、1、6的F1分数都在0.95以上,而数字3和8的F1分数则低于0.8。
3.2 结果分析
3.2.1 数据集特征与模型的适配性
鸢尾花数据集的特征之间区分度较高,相互之间的关联性也比较低,比较好地满足了朴素贝叶斯“特征独立”的假设,再加上它的连续型特征与高斯分布的适配性很好,所以高斯朴素贝叶斯模型在这个数据集上表现得十分优异。
手写数字数据集的特征是像素灰度值,属于离散型数据,本身适合用多项式朴素贝叶斯模型处理。但部分数字(比如3和8、9和4)的像素分布比较相似,这就破坏了“特征独立”的假设,最终导致模型的误分类情况增多。
3.2.2 参数影响分析
这里的alpha平滑系数,主要作用是防止计算出的似然概率出现0的情况。我们测试了不同alpha值的影响:
当alpha=0.1时,模型准确率约为89.26%。这个时候平滑程度不足,模型对少数样本的拟合效果更好,在相似数字的分类上,效果有略微的提升;
当alpha=1.0(即默认值)时,模型准确率为88.33%。此时平滑程度适中,能够较好地平衡模型的整体拟合效果;
当alpha=10.0时,模型准确率约为86.11%。过度的平滑会导致模型出现欠拟合问题,使得一些关键的特征信息丢失,最终造成模型性能明显下降。
更多推荐


 24
 0
- 0


 已为社区贡献4条内容

所有评论(0)