
AI 辅助开发实战:基于机器学习的 anti bot scraping 防护系统设计与实现
快速体验
在开始今天关于 AI 辅助开发实战:基于机器学习的 anti bot scraping 防护系统设计与实现 的探讨之前,我想先分享一个最近让我觉得很有意思的全栈技术挑战。
我们常说 AI 是未来,但作为开发者,如何将大模型(LLM)真正落地为一个低延迟、可交互的实时系统,而不仅仅是调个 API?
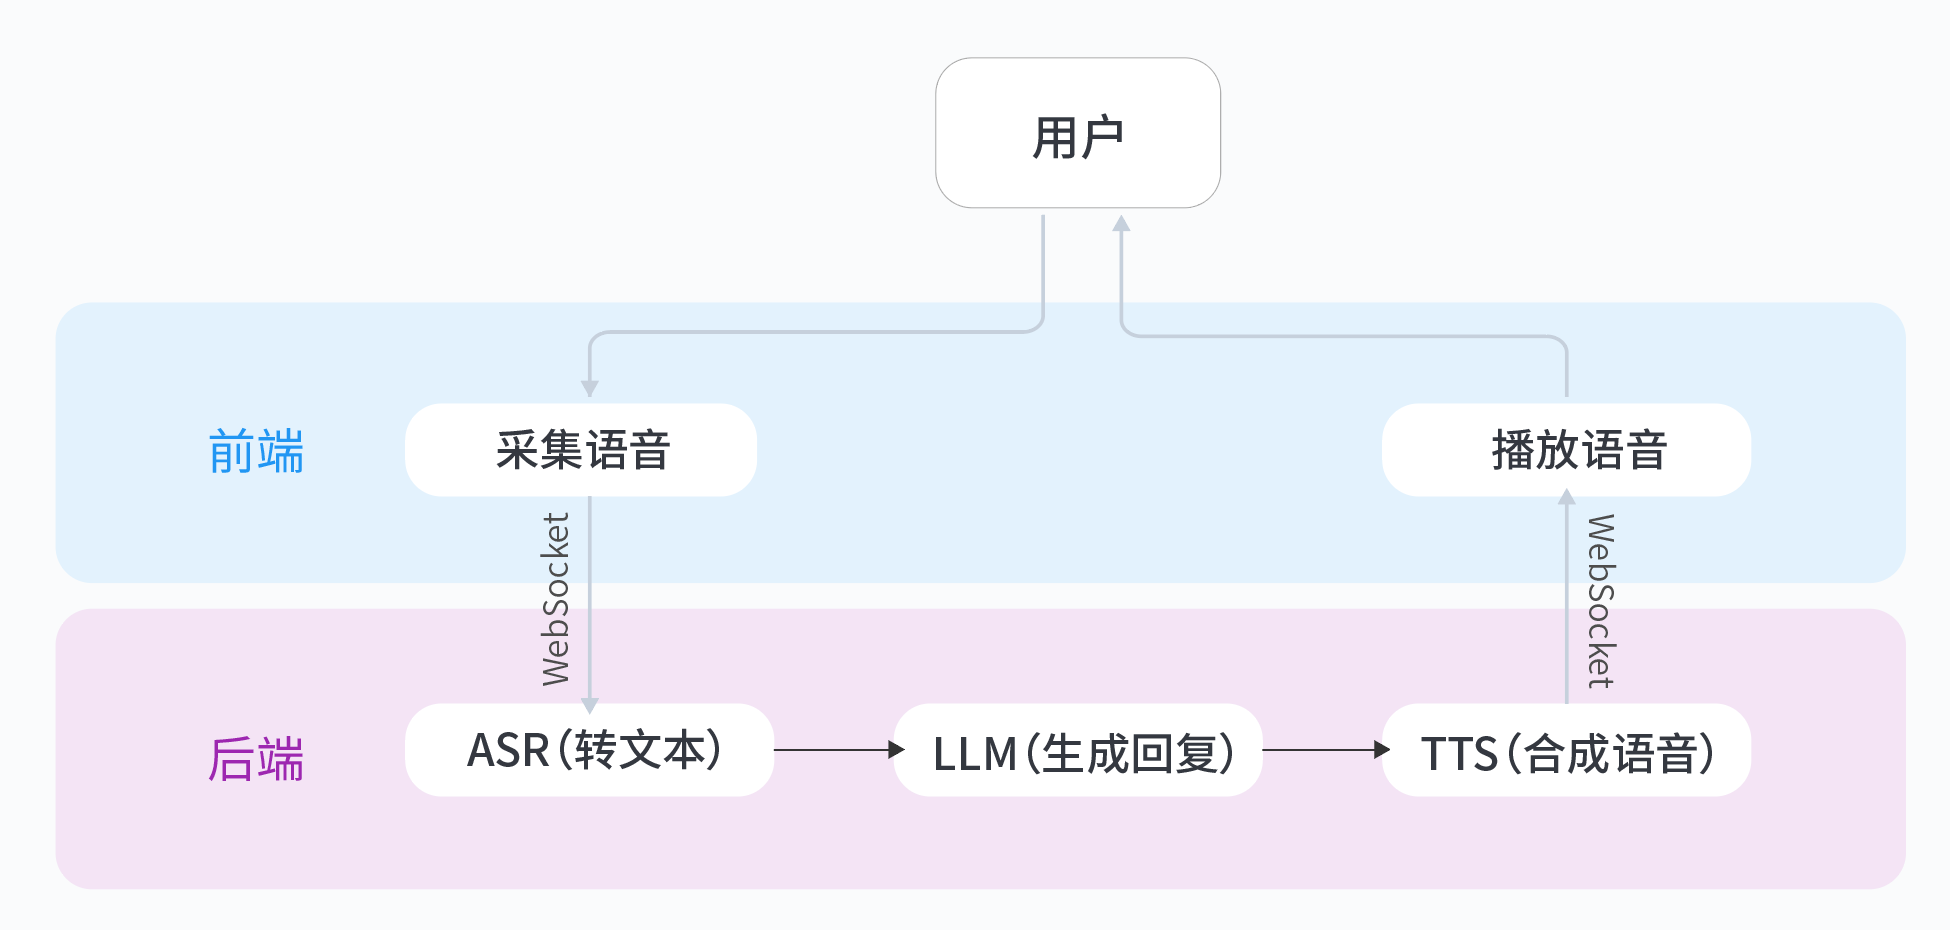
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
AI 辅助开发实战:基于机器学习的 anti bot scraping 防护系统设计与实现
背景与痛点:为什么需要AI防护?
网络爬虫已经从简单的数据收集工具演变为复杂的自动化攻击武器。恶意爬虫不仅会消耗服务器资源,还可能导致数据泄露、业务逻辑被滥用等风险。传统的防护手段主要依赖以下方式:
- IP黑名单:容易被攻击者通过代理池绕过
- 验证码:影响正常用户体验,且现代OCR技术已能破解简单验证码
- 速率限制:无法区分真实用户的突发流量和恶意爬虫
这些方法都存在明显的缺陷:要么容易被绕过,要么会产生大量误判。我们需要更智能的解决方案。
技术选型:规则引擎 vs 机器学习
在构建防护系统时,我们主要考虑两种技术路线:
-
基于规则的引擎
- 优点:实现简单,规则透明
- 缺点:维护成本高,难以应对新型攻击
-
机器学习模型
- 优点:能自动学习攻击模式,适应性强
- 缺点:需要标注数据,存在一定误判风险
对于现代Web应用,我们推荐采用混合方案:用机器学习模型作为主要判断依据,同时保留关键规则作为兜底策略。
核心实现:从特征到决策
特征提取:如何识别恶意爬虫
有效的特征工程是模型成功的关键。我们主要关注以下几类特征:
-
HTTP头特征
- User-Agent异常值
- Accept-Language缺失或不合理
- 缺少常见头字段(如Accept-Encoding)
-
行为模式特征
- 请求频率异常
- 页面访问顺序不符合用户习惯
- 鼠标移动轨迹异常(通过前端JS收集)
-
会话特征
- Cookie使用模式
- 登录尝试失败率
- 账号关联行为
模型训练:构建异常检测系统
我们使用Python和Scikit-learn实现一个简单的异常检测模型:
from sklearn.ensemble import IsolationForest
from sklearn.preprocessing import StandardScaler
import pandas as pd

# 加载标注好的数据集
data = pd.read_csv('traffic_data.csv')
features = data.drop(['label'], axis=1)
labels = data['label']

# 特征标准化
scaler = StandardScaler()
scaled_features = scaler.fit_transform(features)

# 训练隔离森林模型
model = IsolationForest(n_estimators=100, contamination=0.01)
model.fit(scaled_features)

# 保存模型
import joblib
joblib.dump(model, 'bot_detection_model.pkl')
joblib.dump(scaler, 'feature_scaler.pkl')
实时决策:集成到WAF
将训练好的模型集成到Web应用防火墙中:
- 在Nginx等反向代理层部署Lua脚本
- 实时提取请求特征并标准化
- 调用模型进行预测
- 对异常请求实施拦截或挑战
# Flask示例:实时预测端点
from flask import Flask, request
import joblib
import numpy as np

app = Flask(__name__)
model = joblib.load('bot_detection_model.pkl')
scaler = joblib.load('feature_scaler.pkl')

@app.route('/predict', methods=['POST'])
def predict():
    features = extract_features(request)  # 实现特征提取逻辑
    scaled = scaler.transform([features])
    score = model.decision_function(scaled)
    is_bot = score < -0.5  # 调整阈值平衡精确率和召回率
    return {'is_bot': bool(is_bot), 'score': float(score)}
性能考量:优化策略
在生产环境中部署时,需要考虑以下性能因素:
-
延迟优化
- 使用轻量级模型(如ONNX格式)
- 实现特征提取缓存
- 考虑模型蒸馏技术
-
吞吐量提升
- 批量预测代替单次预测
- 使用异步处理队列
- 水平扩展预测服务
-
资源消耗
- 监控模型内存占用
- 实现模型热更新
- 设置预测超时机制
避坑指南:常见问题与解决方案
在实际部署中,我们遇到过以下典型问题:
-
特征漂移
- 现象:模型效果随时间下降
- 解决:实现自动化特征监控和模型重训练流程
-
误判率高
- 现象:正常用户被拦截
- 解决:调整决策阈值,添加白名单机制
-
爬虫进化
- 现象:攻击者模仿正常用户行为
- 解决:引入行为生物特征分析
-
性能瓶颈
- 现象:高流量时延迟激增
- 解决:优化特征提取逻辑,使用更高效的数据结构
未来优化方向
虽然现有方案已经能有效识别大多数恶意爬虫,但仍有许多改进空间:
- 如何利用无监督学习减少对标注数据的依赖?
- 能否通过强化学习实现自适应防御策略?
- 如何平衡安全性和用户体验的trade-off?
- 跨站点的协同防御是否可行?
如果你对构建智能防护系统感兴趣,可以参考从0打造个人豆包实时通话AI实验,了解如何将AI能力集成到实际应用中。我在实践中发现,这种端到端的AI开发体验能帮助开发者快速掌握核心技术要点。
实验介绍
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
你将收获:
- 架构理解:掌握实时语音应用的完整技术链路(ASR→LLM→TTS)
- 技能提升:学会申请、配置与调用火山引擎AI服务
- 定制能力:通过代码修改自定义角色性格与音色,实现“从使用到创造”
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
更多推荐


 3
 0
- 0


 已为社区贡献11条内容

所有评论(0)