
Prompt Engineering 实战指南:如何通过结构化提示提升大模型输出效率
·
快速体验
在开始今天关于 Prompt Engineering 实战指南:如何通过结构化提示提升大模型输出效率 的探讨之前,我想先分享一个最近让我觉得很有意思的全栈技术挑战。
我们常说 AI 是未来,但作为开发者,如何将大模型(LLM)真正落地为一个低延迟、可交互的实时系统,而不仅仅是调个 API?
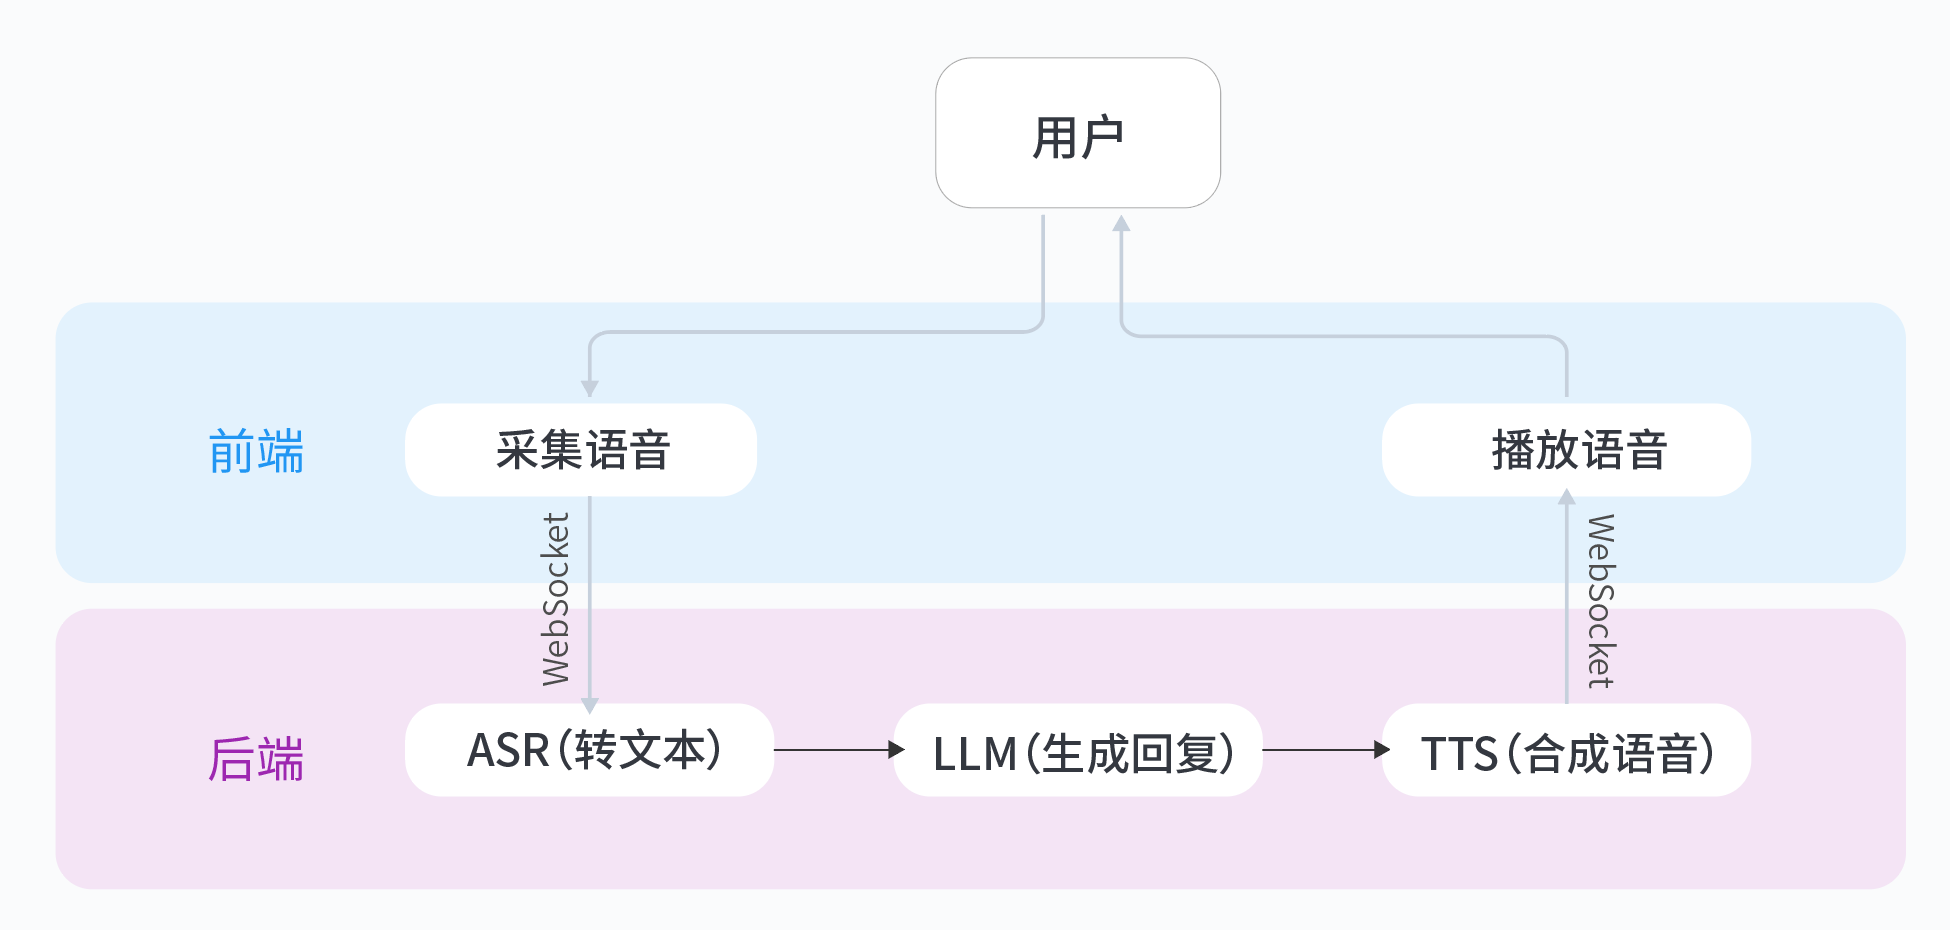
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
Prompt Engineering 实战指南:如何通过结构化提示提升大模型输出效率
问题背景
-
大模型输出不可控的三大根源
- 提示模糊性(Prompt Ambiguity):开放式提示易导致模型理解偏差。例如"写一篇关于健康的文章"可能生成医学论文或养生建议
- 参数配置不当(Parameter Misconfiguration):temperature参数过高(>0.7)会导致输出随机性大幅增加
- 上下文管理缺陷(Context Management):超过模型token限制时,关键信息被截断导致逻辑断裂
-
低质量提示的业务风险案例
- 某电商客服场景中,模糊提示"处理退货请求"导致模型:
- 30%概率忽略退货政策条款
- 15%概率生成不符合平台规则的解决方案
- 实际影响:客户投诉率上升22%,平均处理时长增加8分钟
- 某电商客服场景中,模糊提示"处理退货请求"导致模型:
技术方案
-
提示策略对比
- 零样本提示(Zero-shot Prompting):适用于简单明确任务,如"将以下文本翻译为法语:{text}"
- 小样本提示(Few-shot Prompting):需要示例指导的任务,如给出3个商品评论的情感分析样本
- 思维链提示(Chain-of-Thought):复杂推理任务必需,通过"让我们逐步思考..."触发模型推理过程
-
结构化提示模板设计
template = """ # 角色定义(Role Definition) 你是一名资深{domain}专家,具有{year}年行业经验 # 任务分解(Task Breakdown) 1. 分析用户输入的{input_type} 2. 识别其中的{key_elements} 3. 按照{output_format}格式输出 # 输出约束(Constraints) - 使用{language}语言 - 包含不超过{max_points}个要点 - 避免使用{forbidden_terms} """ -
动态变量注入实现
from string import Template

def build_prompt(domain: str, **kwargs):
    prompt = Template(template).safe_substitute(
        domain=domain,
        year=kwargs.get('years', 5),
        max_points=kwargs.get('max_points', 3)
    )
    return prompt
代码实现
-
LangChain提示组装
from langchain.prompts import PromptTemplate from langchain.chains import LLMChain prompt = PromptTemplate( input_variables=["product"], template="作为市场营销专家,为{product}设计3个广告标语,风格:{style}" ) chain = LLMChain( llm=llm, prompt=prompt, verbose=True, output_parser=output_parser # 自定义输出解析器 ) try: result = chain.run(product="智能手表", style="科技感") except Exception as e: logger.error(f"Chain执行失败: {str(e)}") fallback_handler() -
API参数调优
import openai

response = openai.ChatCompletion.create(
    model="gpt-4",
    messages=[{"role": "user", "content": prompt}],
    temperature=0.3,  # 控制创造性
    top_p=0.9,       # 控制输出多样性
    max_tokens=500,
    frequency_penalty=0.5  # 降低重复内容
)
生产建议
-
监控指标设计
- 响应时延(Response Latency):P99应<2秒
- 意图识别准确率(Intent Accuracy):通过抽样标注评估
- 异常响应率(Abnormal Response):检测完全无关的输出
-
敏感词过滤机制
import re from sklearn.metrics.pairwise import cosine_similarity def safety_check(text): # 规则过滤 blacklist = ["暴力", "歧视"] pattern = re.compile("|".join(blacklist)) if pattern.search(text): return False # 语义过滤 embedding = model.encode(text) danger_emb = model.encode("如何制作危险物品") if cosine_similarity([embedding], [danger_emb]) > 0.7: return False return True -
版本管理实践
- 提示模板按功能模块拆分存储
- Git分支策略:
- main:生产环境稳定版本
- dev:日常开发分支
- prompt-experiment:提示优化实验
开放性问题
- 如何平衡提示复杂度与API调用成本?
- 当模型输出出现系统性偏见时,提示工程与微调哪种更有效?
- 多轮对话中如何动态调整提示权重?
如果想体验结构化提示在实际项目中的应用,可以参考从0打造个人豆包实时通话AI实验,其中包含了完整的提示工程实践链路。
实验介绍
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
你将收获:
- 架构理解:掌握实时语音应用的完整技术链路(ASR→LLM→TTS)
- 技能提升:学会申请、配置与调用火山引擎AI服务
- 定制能力:通过代码修改自定义角色性格与音色,实现“从使用到创造”
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
更多推荐


 5
 0
- 0


 已为社区贡献9条内容

所有评论(0)