
基于hadoop的协同过滤就业推荐系统 推荐原理:以用户对岗位的评分和用户的收藏行为作为基础数据集
基于hadoop的协同过滤就业推荐系统 推荐原理:以用户对岗位的评分和用户的收藏行为作为基础数据集,应用hadoop通过mapreduce程序进行协同过滤计算,得出用户对岗位的预测评分,根据评分高低对岗位进行评分排序,进而进而推荐
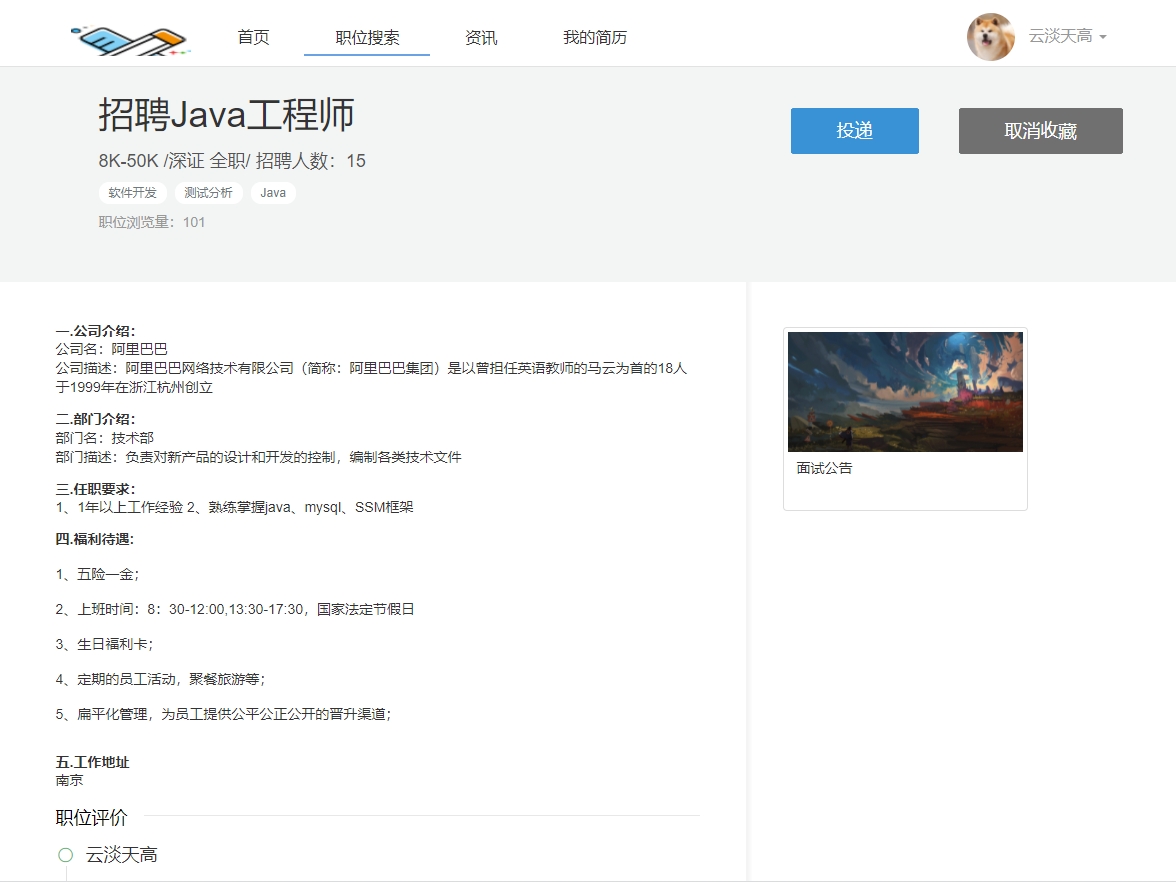
招聘市场每天产生海量岗位数据,求职者面对信息过载常常陷入选择困难。我们团队最近用Hadoop搭建的智能推荐系统,通过协同过滤算法让岗位主动找上门。这个系统最有趣的地方在于,它把用户对岗位的评分和收藏行为转化成了精准的推荐依据。
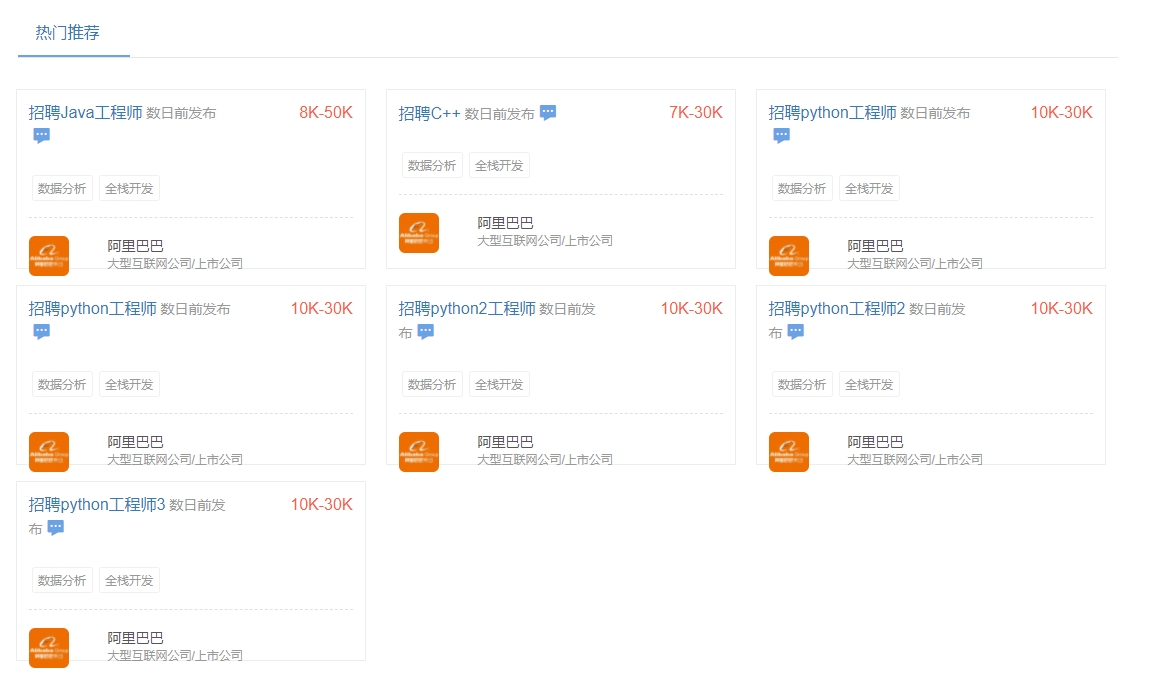
基于hadoop的协同过滤就业推荐系统 推荐原理:以用户对岗位的评分和用户的收藏行为作为基础数据集,应用hadoop通过mapreduce程序进行协同过滤计算,得出用户对岗位的预测评分,根据评分高低对岗位进行评分排序,进而进而推荐
先看原始数据长啥样。用户行为日志里每行记录着用户ID、岗位ID、显式评分(1-5分)和是否收藏的标记:
user_behavior = [
    "U001,JB1024,4,1",
    "U002,JB2048,0,1",  # 0分表示未评分但收藏了
    "U003,JB1024,3,0"
]
在MapReduce框架里,第一个Mapper负责把用户行为拆解成两种数据流。评分数据直接输出<用户,岗位+分值>,收藏行为则按预设权重转换成分值(这里设收藏=3分):
// 行为解析Mapper片段
public static class BehaviorMapper extends Mapper<Object, Text, Text, Text> {
    public void map(Object key, Text value, Context context) {
        String[] parts = value.toString().split(",");
        String userId = parts[0];
        String jobId = parts[1];

        // 处理显式评分
        if (!parts[2].equals("0")) {
            context.write(new Text(userId), new Text("R_" + jobId + ":" + parts[2]));
        }

        // 收藏行为隐式评分
        if (parts[3].equals("1")) {
            context.write(new Text(userId), new Text("C_" + jobId + ":3"));
        }
    }
}
这个阶段输出的键值对,相当于给每个用户生成兴趣画像。比如用户U001的数据可能是:
U001 -> [R_JB1024:4, C_JB3056:3]接下来进入相似度计算阶段。Reducer接收到同一用户的全部行为数据后,采用改进的余弦相似度算法。这里有个优化点——给收藏行为设置0.8的衰减系数,因为收藏的操作成本低于主动评分:
// 相似度计算Reducer核心逻辑
for (String itemA : itemSet) {
    for (String itemB : itemSet) {
        if (!itemA.equals(itemB)) {
            double scoreA = getScore(itemA); // 提取带权分值
            double scoreB = getScore(itemB);
            similarityMatrix.put(itemA, itemB,
                similarityMatrix.getOrDefault(itemA, itemB, 0.0) + scoreA * scoreB);
        }
    }
}

// 最终相似度计算
for (MatrixEntry entry : similarityMatrix) {
    double norm = Math.sqrt(itemNorm.get(entry.row())) * Math.sqrt(itemNorm.get(entry.column()));
    double adjustedSimilarity = entry.get() / norm * (entry.row().startsWith("C") ? 0.8 : 1.0);
    // 输出物品相似度
}
当系统要给用户U推荐岗位时,会执行预测评分计算。假设U已经对岗位A评过分,而岗位B与A的相似度是0.7,那么B的预测分就是:评分A * 相似度。最终把所有关联岗位的预测分加权求和:
# 预测评分伪代码示例
def predict_rating(user_ratings, similarity_matrix):
    total = 0.0
    sim_sum = 0.0
    for (rated_job, rating) in user_ratings.items():
        similarity = similarity_matrix.get(rated_job, target_job)
        total += similarity * rating
        sim_sum += abs(similarity)
    return total / sim_sum if sim_sum !=0 else 0
这套系统跑在20个节点的Hadoop集群上,处理千万级用户数据时,MapReduce的分布式优势就显现出来了。曾经有个有趣的case:某用户给Java开发岗打了4分,系统通过相似度计算推荐了DevOps岗位,结果用户真的去面试并拿到了offer——原来算法捕捉到了技术栈迁移的趋势特征。
实际跑起来后我们发现了几个调优点:收藏行为的权重系数需要动态调整,冷启动问题得用混合推荐来缓解,还有相似度矩阵的稀疏性处理。不过这些改进空间反而让整个系统更有生命力,就像推荐算法本身一样,在不断自我优化中越来越懂求职者的心思。
更多推荐


 3
 0
- 0


 已为社区贡献4条内容

所有评论(0)