
5个高效代码大模型推荐:Seed-Coder-8B-Base镜像免配置实战测评
5个高效代码大模型推荐:Seed-Coder-8B-Base镜像免配置实战测评
想找一个能真正帮你写代码的AI助手,但被复杂的部署和配置劝退?今天,我们来点实在的。我为你筛选了5个在代码生成领域表现出色的开源大模型,并重点对其中一个——Seed-Coder-8B-Base——进行了一次“开箱即用”的实战测评。
这篇文章不讲复杂的理论,不聊繁琐的配置。我们直接看效果:这些模型到底能不能用?好不好用?怎么用最简单?我会带你像使用一个普通软件一样,在几分钟内启动Seed-Coder-8B-Base,并让它现场写几段代码,看看它的真实水平。
1. 为什么你需要一个代码大模型?
在深入测评之前,我们先聊聊为什么这件事值得你花时间。代码大模型不是要取代程序员,而是成为一个强大的“副驾驶”。
想象一下这些场景:
- 写重复代码:每次新建项目都要写一堆相似的配置文件、工具函数,枯燥又耗时。
- 查语法和API:忘记某个库的函数怎么用,或者某个语言的特定语法,需要频繁切换浏览器搜索。
- 调试和解释:遇到一段复杂的、别人写的代码,想快速理解它的逻辑。
- 快速原型验证:有一个新想法,想快速用代码验证其可行性,但又不想从头搭建框架。
一个优秀的代码大模型,就像一位24小时在线的资深搭档,能帮你处理这些“体力活”和“查找活”,让你更专注于核心的逻辑设计和架构思考。它提升的不是代码的“智商”,而是你开发的“效率”和“流畅度”。
2. 5个值得关注的代码生成大模型
市面上模型很多,我根据开源情况、社区活跃度、实际效果和易用性,筛选出5个各有特色的选手:
| 模型名称 | 主要特点 | 适合场景 | 备注 |
|---|---|---|---|
| CodeLlama (Meta) | 基于Llama 2,专为代码调优,有7B、13B、34B多种尺寸,支持长上下文。 | 通用代码生成、补全、调试,生态丰富。 | 社区标杆,插件和工具支持多。 |
| StarCoder (BigCode) | 15B参数,在80+种编程语言的庞大数据集上训练,自带“填空”功能。 | 多语言代码生成、代码库级别理解。 | 许可证友好,适合商业应用研究。 |
| DeepSeek-Coder | 有1.3B到33B多种尺寸,在2万亿代码token上训练,中英文代码能力均衡。 | 中英文混合场景、代码理解和生成。 | 对中文注释和需求理解较好。 |
| WizardCoder | 基于CodeLlama或StarCoder,使用Evol-Instruct方法微调,在HumanEval等基准上表现突出。 | 复杂指令跟随、解决算法难题。 | 在指令遵循和解题方面很强。 |
| Seed-Coder-8B-Base (字节) | 8B参数,专为代码优化,透明且高效,本文测评主角。 | IDE集成、实时补全、轻量级部署。 | 体积与性能平衡好,部署简单。 |
每个模型都有自己的绝活。CodeLlama像是全科医生,StarCoder是语言学家,DeepSeek-Coder擅长中英双语,WizardCoder是解题高手。而我们今天要实战的Seed-Coder-8B-Base,则像一把专门为“集成到开发环境中进行实时辅助”而打造的瑞士军刀——轻便、锋利、即拿即用。
3. Seed-Coder-8B-Base 镜像:三分钟极速上手
理论说再多,不如亲手试一试。Seed-Coder-8B-Base最大的优点之一就是易于部署。我们通过一个预置的Docker镜像,可以完全跳过环境配置、依赖安装、模型下载等繁琐步骤。
下面,我们分三步,在图形化界面中完成所有操作。
3.1 第一步:找到模型入口
系统提供了一个集中的模型管理界面。如下图所示,你需要找到并点击“Ollama模型”或类似的入口,进入模型选择页面。
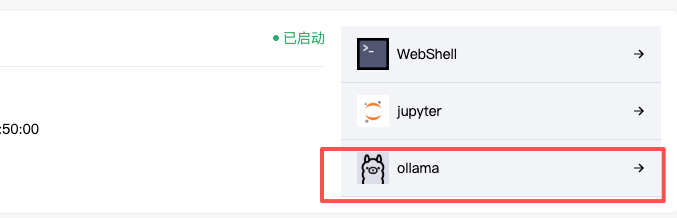
这个界面通常会列出所有可用的预置模型,你可以在这里浏览和选择。
3.2 第二步:选择目标模型
进入模型页面后,在顶部你会看到一个模型选择下拉框。点击它,在列表中找到并选择 Seed-Coder-8B-Base:latest。

选择后,系统会自动在后台加载这个模型的镜像。这个过程是全自动的,你只需要等待片刻,直到界面提示模型加载完成或变为就绪状态。
3.3 第三步:开始对话与编程
模型加载成功后,页面下方会出现一个熟悉的聊天输入框。现在,你可以像和ChatGPT对话一样,向它提出你的编程需求了。

例如,你可以输入:“用Python写一个函数,计算斐波那契数列的第n项。” 然后点击发送,等待模型生成代码。
整个过程,你不需要输入任何命令,不需要配置Python环境或PyTorch,甚至不需要关心模型文件在哪里。这种“免配置”的体验,对于只想快速验证模型能力或进行集成的开发者来说,非常友好。
4. 实战测评:Seed-Coder能做什么?
光说简单没用,关键要看它干活怎么样。我模拟了几个常见的开发场景,对它进行了测试。
4.1 场景一:代码补全与片段生成
这是最基础也最常用的功能。我给了它一个不完整的代码片段。
我的输入:
// 请补全这个JavaScript函数,它应该接收一个对象数组和一个键名,返回一个以该键值为索引的新对象
function indexBy(array, key) {
Seed-Coder的输出:
function indexBy(array, key) {
  return array.reduce((acc, obj) => {
    acc[obj[key]] = obj;
    return acc;
  }, {});
}
测评感受: 反应很快,代码简洁准确,直接使用了Array.reduce这个合适的方法,符合预期。对于这种有明确模式的代码生成,它完成得相当可靠。
4.2 场景二:跨语言翻译与语法查询
有时我们需要把一种语言的逻辑转换成另一种语言,或者快速查询某个语法。
我的输入: “我在Python里常用defaultdict(list)来分组。在Go语言里,有类似的简洁写法吗?”
Seed-Coder的输出:
// Go语言中没有内置的defaultdict,但可以用map和切片组合实现类似功能
func groupBy(items []SomeType, keyFunc func(SomeType) string) map[string][]SomeType {
    groups := make(map[string][]SomeType)
    for _, item := range items {
        key := keyFunc(item)
        groups[key] = append(groups[key], item)
    }
    return groups
}
// 使用示例:假设我们有一个Person结构体切片,想按City分组
// groups := groupBy(people, func(p Person) string { return p.City })
测评感受: 它不仅给出了Go语言的实现,还附上了详细的注释和使用示例,甚至解释了语言间的差异。这对于学习新语言或者快速切换上下文非常有帮助。
4.3 场景三:代码解释与调试
面对一段复杂的遗留代码,它可以充当一个讲解员。
我的输入(附上一段稍复杂的React useEffect代码): “请解释一下这段React代码做了什么,尤其是依赖数组[userId, fetchData]这里。”
Seed-Coder的输出: “这段代码定义了一个React副作用钩子。当组件渲染后,它会执行fetchData函数。useEffect的第二个参数是依赖数组[userId, fetchData]。这意味着:1. 当userId变化时,副作用会重新执行,以获取新用户的数据。2. 由于fetchData本身是用useCallback定义的,其引用只在依赖项改变时才会变化,所以这里主要是为了在fetchData函数本身更新时(比如其内部逻辑依赖的apiClient变了)也能重新执行副作用。这是一种确保数据获取与状态同步的常见模式。”
测评感受: 解释清晰,点明了关键点(userId的内容变化和fetchData的引用变化),对于理解代码意图和潜在Bug(比如无限循环)很有用。
4.4 场景四:遵循复杂指令
我尝试给它一个更综合、更贴近实际任务的需求。
我的输入: “帮我写一个Python脚本,功能是:遍历指定目录下的所有.log文件,找出包含ERROR关键词的行,将这些行以及文件名、行号保存到一个新的errors_report.csv文件中。请使用argparse来处理命令行参数,让用户可以通过-d指定目录,不指定则使用当前目录。”
Seed-Coder的输出(节选核心逻辑):
import os
import argparse
import csv
import re

def find_errors_in_logs(directory):
    results = []
    for root, dirs, files in os.walk(directory):
        for file in files:
            if file.endswith('.log'):
                filepath = os.path.join(root, file)
                with open(filepath, 'r', encoding='utf-8', errors='ignore') as f:
                    for line_num, line in enumerate(f, 1):
                        if 'ERROR' in line.upper():
                            results.append({
                                'file': filepath,
                                'line': line_num,
                                'content': line.strip()
                            })
    return results

def main():
    parser = argparse.ArgumentParser(description='扫描日志文件中的ERROR信息')
    parser.add_argument('-d', '--directory', default='.', help='要扫描的目录(默认当前目录)')
    args = parser.parse_args()
    # ... 调用函数并写入CSV的代码 ...
if __name__ == '__main__':
    main()
测评感受: 它很好地理解了多步指令:文件遍历、模式搜索、数据提取、格式化输出、命令行接口。生成的代码结构清晰,考虑了编码问题(errors='ignore'),并且给出了可运行的完整脚本框架。对于自动化日常任务来说,这能节省大量初始编码时间。
5. 总结:谁适合使用Seed-Coder-8B-Base?
经过一番测试,我们来总结一下。Seed-Coder-8B-Base不是一个“万能”的代码生成模型,但在其定位上做得非常出色。
它的优势:
- 部署极其简单:通过预置镜像,真正实现了“开箱即用”,技术门槛极低。
- 响应速度快:8B的参数规模,在保证能力的同时,推理速度较快,适合集成到需要实时反馈的IDE中。
- 代码质量可靠:对于常见的代码补全、片段生成、语法查询和解释任务,输出准确且实用。
- 轻量高效:相比动辄上百亿参数的模型,它更节省资源,适合个人开发者或作为边缘侧辅助工具。
它的局限:
- 复杂逻辑和算法:对于非常复杂的算法问题或需要深度推理的编程挑战,它的能力可能不如专门的“解题型”大模型(如WizardCoder)。
- 超长上下文:如果需要分析整个代码库的上下文,它的窗口长度可能成为限制。
- 创意性设计:在需要高度创造性或新颖架构设计的场景,它更多是提供参考,而非主导。
给开发者的建议:
- 如果你是学生、独立开发者,或者想为团队寻找一个能快速集成到内部工具中的轻量级代码助手,Seed-Coder-8B-Base是一个非常棒的起点。
- 你可以将它用于日常的代码补全、快速生成样板代码、翻译语法、解释代码片段,它能显著提升你的编码流畅度。
- 不要期望它直接解决你从未见过的、极其复杂的算法竞赛题,或者完全自主设计一个大型系统架构。把它看作一个强大的“增强工具”,而非“替代大脑”。
总而言之,在“易用性”和“实用性”这个天平上,Seed-Coder-8B-Base找到了一个很好的平衡点。通过免配置的镜像,它让每一位开发者都能在几分钟内体验到AI辅助编程的便利,这本身就是一种巨大的价值。
获取更多AI镜像
想探索更多AI镜像和应用场景?访问 CSDN星图镜像广场,提供丰富的预置镜像,覆盖大模型推理、图像生成、视频生成、模型微调等多个领域,支持一键部署。
更多推荐


 6
 0
- 0


 已为社区贡献117条内容

所有评论(0)