
【深度学习实验】—— YOLOv5 - C3 实现天气识别
·
- 🍨 本文为🔗365天深度学习训练营 中的学习记录博客
- 🍖 原作者:K同学啊
文章目录
1. 简介 & 数据集介绍
利用 YOLO v5 算法中的 C3 模块搭建网络以识别天气。
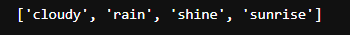
数据集中有 cloudy、rain、shine、sunrise 四类数据,每类数据 300 张左右的图片。
2. 环境
- 语言环境:Python 3.12.7
- 编译器:Jupyter Notebook
- 深度学习环境:torch—2.8.0 + cu126 / torchvision—0.23.1+cu126
3. 代码实现
3.1 前期准备
3.1.1 设置GPU & 导入库
import torch
import torch.nn as nn
import torchvision.transforms as transforms
import torchvision
from torchvision import transforms, datasets
import os, PIL, pathlib, warnings, random
import torch.nn.functional as F
import torchsummary as summary
import copy
import matplotlib.pyplot as plt
from datetime import datetime

warnings.filterwarnings("ignore")
plt.rcParams['font.sans-serif']    = ['SimHei']
plt.rcParams['axes.unicode_minus'] = False
plt.rcParams['figure.dpi']         = 100

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
device
3.1.2 标签查看
data_dir = './Data/weather_photos/'
data_dir = pathlib.Path(data_dir)

data_paths  = list(data_dir.glob('*'))
classeNames = [str(path).split("\\")[2] for path in data_paths]
classeNames
3.2 YOLOv5-C3 模型
3.2.1 图片转换读取
train_transforms = transforms.Compose([
    transforms.Resize([224, 224]),
    transforms.RandomHorizontalFlip(),
    transforms.ToTensor(),
    transforms.Normalize(
        mean=[0.485, 0.456, 0.406],
        std=[0.229, 0.224, 0.225])
])

test_transform = transforms.Compose([
    transforms.Resize([224, 224]),
    transforms.ToTensor(),
    transforms.Normalize(
        mean=[0.485, 0.456, 0.406],
        std=[0.229, 0.224, 0.225])
])

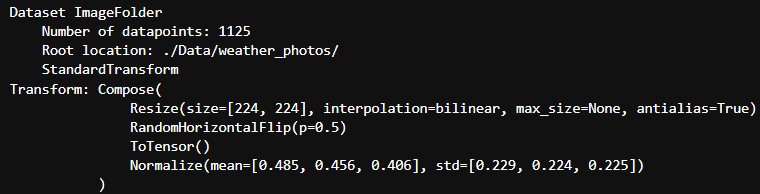
total_data = datasets.ImageFolder("./Data/weather_photos/",transform=train_transforms)
total_data
total_data.class_to_idx

3.2.2 数据集划分
train_size = int(0.8 * len(total_data))
test_size  = len(total_data) - train_size
train_dataset, test_dataset = torch.utils.data.random_split(total_data, [train_size, test_size])
train_dataset, test_dataset
batch_size = 4

train_dl = torch.utils.data.DataLoader(train_dataset,
                                           batch_size=batch_size,
                                           shuffle=True,
                                           num_workers=1)
test_dl = torch.utils.data.DataLoader(test_dataset,
                                          batch_size=batch_size,
                                          shuffle=True,
                                          num_workers=1)
for X, y in test_dl:
    print("Shape of X [N, C, H, W]: ", X.shape)
    print("Shape of y: ", y.shape, y.dtype)
    break

3.2.3 YOLOv5-C3 模型建立
def autopad(k, p=None):  # kernel, padding
    # Pad to 'same'
    if p is None:
        p = k // 2 if isinstance(k, int) else [x // 2 for x in k]  # auto-pad
    return p

class Conv(nn.Module):
    # Standard convolution
    def __init__(self, c1, c2, k=1, s=1, p=None, g=1, act=True):  # ch_in, ch_out, kernel, stride, padding, groups
        super().__init__()
        self.conv = nn.Conv2d(c1, c2, k, s, autopad(k, p), groups=g, bias=False)
        self.bn = nn.BatchNorm2d(c2)
        self.act = nn.SiLU() if act is True else (act if isinstance(act, nn.Module) else nn.Identity())

    def forward(self, x):
        return self.act(self.bn(self.conv(x)))

class Bottleneck(nn.Module):
    # Standard bottleneck
    def __init__(self, c1, c2, shortcut=True, g=1, e=0.5):  # ch_in, ch_out, shortcut, groups, expansion
        super().__init__()
        c_ = int(c2 * e)  # hidden channels
        self.cv1 = Conv(c1, c_, 1, 1)
        self.cv2 = Conv(c_, c2, 3, 1, g=g)
        self.add = shortcut and c1 == c2

    def forward(self, x):
        return x + self.cv2(self.cv1(x)) if self.add else self.cv2(self.cv1(x))

class C3(nn.Module):
    # CSP Bottleneck with 3 convolutions
    def __init__(self, c1, c2, n=1, shortcut=True, g=1, e=0.5):  # ch_in, ch_out, number, shortcut, groups, expansion
        super().__init__()
        c_ = int(c2 * e)  # hidden channels
        self.cv1 = Conv(c1, c_, 1, 1)
        self.cv2 = Conv(c1, c_, 1, 1)
        self.cv3 = Conv(2 * c_, c2, 1)  # act=FReLU(c2)
        self.m = nn.Sequential(*(Bottleneck(c_, c_, shortcut, g, e=1.0) for _ in range(n)))

    def forward(self, x):
        return self.cv3(torch.cat((self.m(self.cv1(x)), self.cv2(x)), dim=1))

class model_K(nn.Module):
    def __init__(self):
        super(model_K, self).__init__()

        # 卷积模块
        self.Conv = Conv(3, 32, 3, 2)

        # C3模块1
        self.C3_1 = C3(32, 64, 3, 2)

        # 全连接网络层,用于分类
        self.classifier = nn.Sequential(
            nn.Linear(in_features=802816, out_features=100),
            nn.ReLU(),
            nn.Linear(in_features=100, out_features=4)
        )

    def forward(self, x):
        x = self.Conv(x)
        x = self.C3_1(x)
        x = torch.flatten(x, start_dim=1)
        x = self.classifier(x)

        return x

device = "cuda" if torch.cuda.is_available() else "cpu"
print("Using {} device".format(device))

model = model_K().to(device)
model
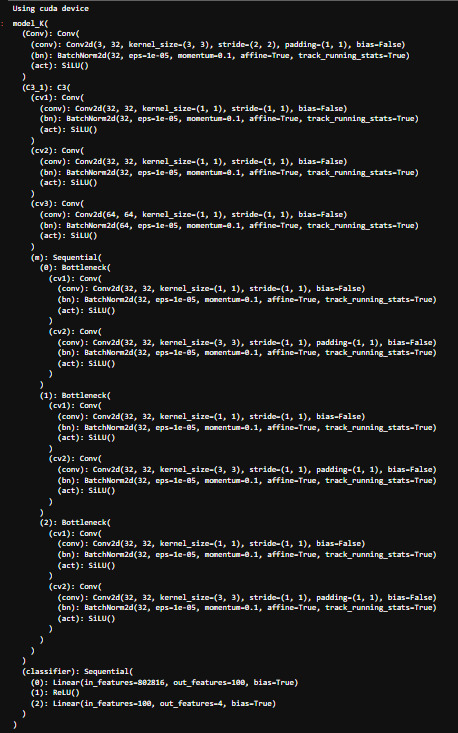
summary.summary(model, (3, 224, 224))
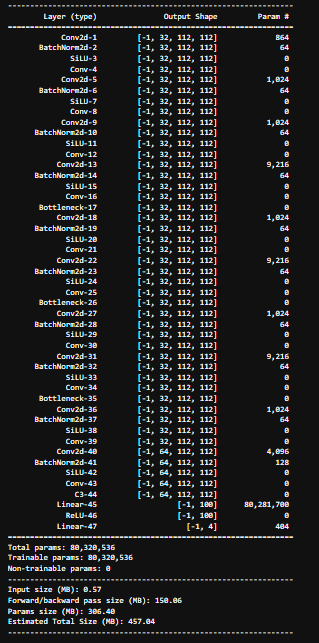
3.2.4 训练 & 测试函数
def train(dataloader, model, loss_fn, optimizer):
    size = len(dataloader.dataset)
    num_batches = len(dataloader)

    train_loss, train_acc = 0, 0

    for X, y in dataloader:
        X, y = X.to(device), y.to(device)


        pred = model(X)
        loss = loss_fn(pred, y)
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
        train_acc  += (pred.argmax(1) == y).type(torch.float).sum().item()
        train_loss += loss.item()

    train_acc  /= size
    train_loss /= num_batches

    return train_acc, train_loss


def test (dataloader, model, loss_fn):
    size        = len(dataloader.dataset)
    num_batches = len(dataloader)
    test_loss, test_acc = 0, 0


    with torch.no_grad():
        for imgs, target in dataloader:
            imgs, target = imgs.to(device), target.to(device)

            target_pred = model(imgs)
            loss        = loss_fn(target_pred, target)

            test_loss += loss.item()
            test_acc  += (target_pred.argmax(1) == target).type(torch.float).sum().item()

    test_acc  /= size
    test_loss /= num_batches

    return test_acc, test_loss
3.2.5 参数设定 & 正式训练
optimizer  = torch.optim.Adam(model.parameters(), lr= 1e-4)
loss_fn    = nn.CrossEntropyLoss()

epochs     = 20

train_loss = []
train_acc  = []
test_loss  = []
test_acc   = []

best_acc = 0

for epoch in range(epochs):

    model.train()
    epoch_train_acc, epoch_train_loss = train(train_dl, model, loss_fn, optimizer)

    model.eval()
    epoch_test_acc, epoch_test_loss = test(test_dl, model, loss_fn)


    if epoch_test_acc > best_acc:
        best_acc   = epoch_test_acc
        best_model = copy.deepcopy(model)

    train_acc.append(epoch_train_acc)
    train_loss.append(epoch_train_loss)
    test_acc.append(epoch_test_acc)
    test_loss.append(epoch_test_loss)


    lr = optimizer.state_dict()['param_groups'][0]['lr']

    template = ('Epoch:{:2d}, Train_acc:{:.1f}%, Train_loss:{:.3f}, Test_acc:{:.1f}%, Test_loss:{:.3f}, Lr:{:.2E}')
    print(template.format(epoch+1, epoch_train_acc*100, epoch_train_loss,
                          epoch_test_acc*100, epoch_test_loss, lr))


PATH = './best_model.pth'
torch.save(best_model.state_dict(), PATH)

print('Done')
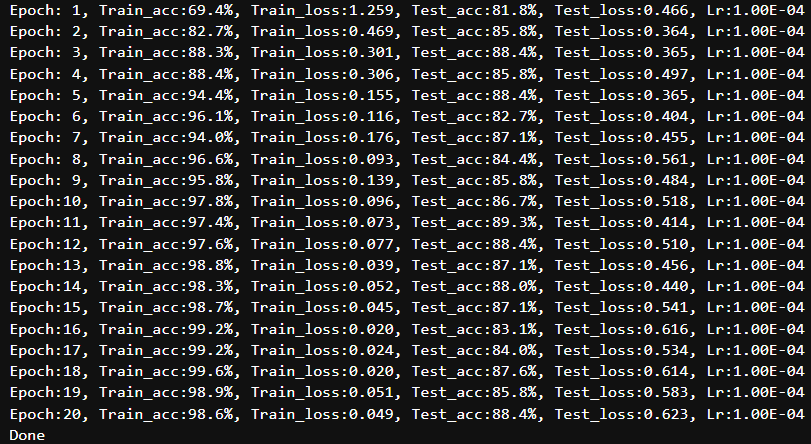
3.2.6 结果可视化
current_time = datetime.now()

epochs_range = range(epochs)

plt.figure(figsize=(12, 3))
plt.subplot(1, 2, 1)

plt.plot(epochs_range, train_acc, label='Training Accuracy')
plt.plot(epochs_range, test_acc, label='Test Accuracy')
plt.legend(loc='lower right')
plt.title('Training and Validation Accuracy')
plt.xlabel(current_time)

plt.subplot(1, 2, 2)
plt.plot(epochs_range, train_loss, label='Training Loss')
plt.plot(epochs_range, test_loss, label='Test Loss')
plt.legend(loc='upper right')
plt.title('Training and Validation Loss')
plt.show()
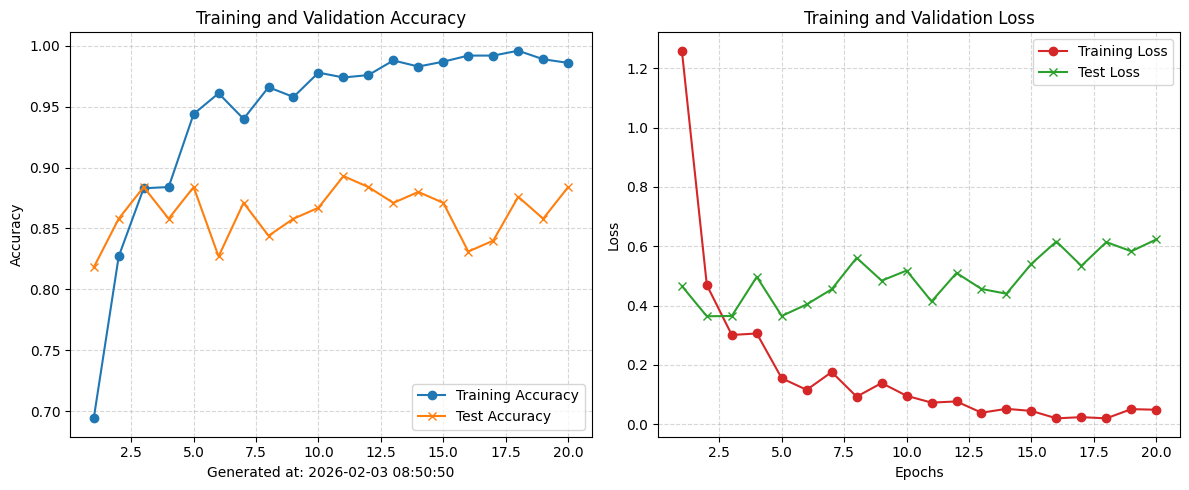
3.2.7 模型评估
best_model.eval()
epoch_test_acc, epoch_test_loss = test(test_dl, best_model, loss_fn)
epoch_test_acc, epoch_test_loss

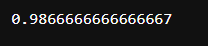
epoch_test_acc
更多推荐
 12
 0
- 0


 已为社区贡献29条内容

所有评论(0)