
实验四 Python 网络爬虫——大数据采集
一、实验基本原理
运用 Jupyter notebook 平台编写实例 Python 程序。
二、实验目的:
1、认识数据爬虫在大数据挖掘中的重要作用。
2、掌握使用 urllib、requests、BeautifulSoup 等方法进行爬虫。
3、了解 Python 中使用 Scrapy 框架进行网络爬虫的方法。
三、具体要求:
1、学习并掌握 python 在网络爬虫中常用类库的使用方法,如 requests、BeautifulSoup、urllib、openyxl、Workbook、pandas、matplotlib 等,熟知这些库的作用及程序编写中的调用方法,理解大数据挖掘的基本思想。
2、结合之前实验内容所学方法,利用列表和字典等数据结构存储从网页中爬取下来的数据,通过切片操作分割字符串,利用文件操作保存爬取数据到文件中。
四、实验环境:
1、Windows 10 电脑一台。
2、Anaconda、Python、Jupyter notebook 平台。
五、实验内容:
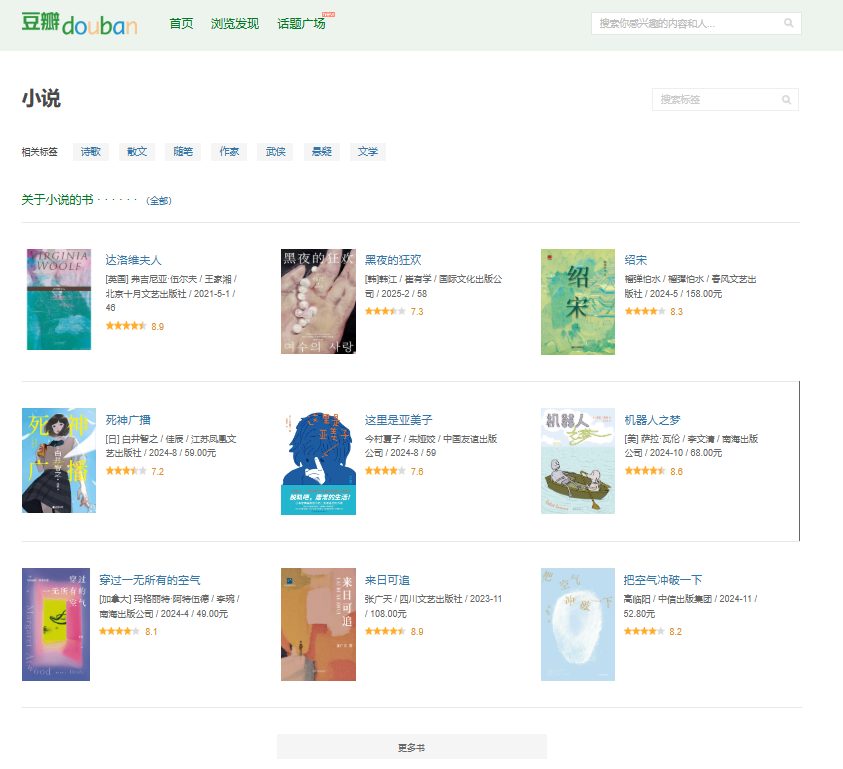
实例 1:爬取豆瓣小说页面的相关信息
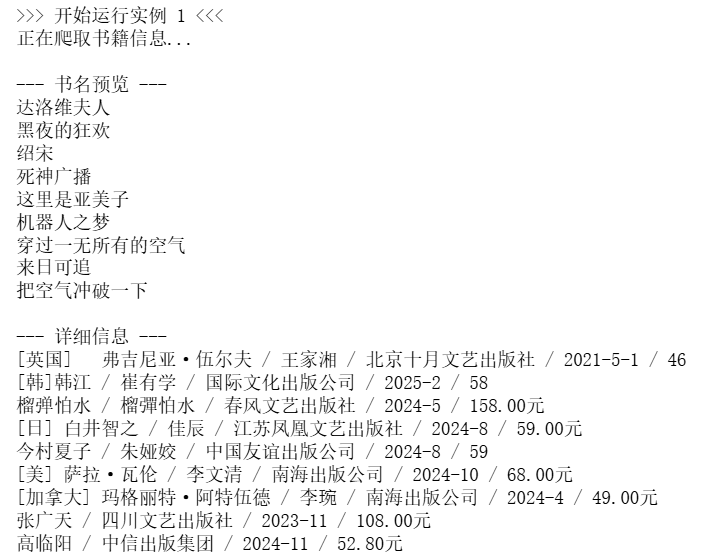
爬取豆瓣小说主页(https://www.douban.com/tag/小说/?focus=book)的 9 部小说信息,包括小说的书名、作者、译者、出版社、出版日期和价格等公开信息数据,并在 jupyter notebook 中进行输出显示。
豆瓣小说主页页面如下所示:
import requests
from bs4 import BeautifulSoup

def instance1_crawl():
    url = "https://www.douban.com/tag/小说/?focus=book"

    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.124 Safari/537.36"
    }

    try:
        # 为了防止出现ProxyError,这里强制不使用代理
        proxies = {"http": None, "https": None}

        # 发送请求
        response = requests.get(url, headers=headers, proxies=proxies, timeout=10)
        soup = BeautifulSoup(response.text, 'html.parser')

        # 找到包含书籍信息的列表 (限制爬取9部)
        book_list = soup.find_all("dd", limit=9)

        books_data = []

        print("正在爬取书籍信息...\n")
        print("--- 书名预览 ---")

        # 获取标题并解析数据
        for book in book_list:
            # 提取标题
            title_tag = book.find("a", class_="title")
            title = title_tag.get_text(strip=True)
            print(title)

            # 提取详细信息字符串
            desc_tag = book.find("div", class_="desc")
            desc_text = desc_tag.get_text(strip=True) if desc_tag else "未知信息"

            # 解析字符串
            parts = desc_text.split('/')
            parts = [p.strip() for p in parts]

            # 初始化字段 (处理可能缺失的情况)
            author = parts[0] if len(parts) > 0 else ""
            price = parts[-1] if len(parts) > 0 else ""
            date = parts[-2] if len(parts) > 1 else ""
            publisher = parts[-3] if len(parts) > 2 else ""
            translator = parts[1] if len(parts) >= 5 else ""

            # 存入列表
            books_data.append({
                "书名": title,
                "作者": author,
                "译者": translator,
                "出版社": publisher,
                "出版日期": date,
                "价格": price,
                "原始信息": desc_text
            })

        print("\n--- 详细信息 ---")
        # 输出详细信息
        for b in books_data:
            print(f"{b['原始信息']}")

        return books_data

    except Exception as e:
        print(f"爬取失败: {e}")
        return []

# 运行实例 1 并将结果保存到全局变量中
print(">>> 开始运行实例 1 <<<")
crawled_data = instance1_crawl()
输出显示:
实例 2:将上题网页中爬取的数据存储到文件中。
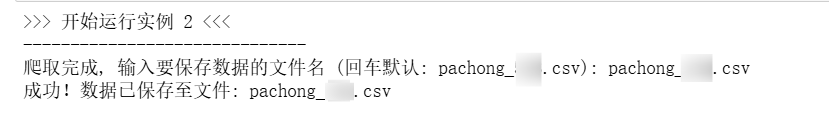
将上题从豆瓣小说主页所爬取到的 9 部小说信息进行简单的预处理,然后保存到文件 pachong_XYY.csv 中,其中 X 是你的 1 位班号(如 4 班为 4),YY 是你的后两位学号。
import pandas as pd

class_id = "X"
student_id = "YY"
default_filename = f"pachong_{class_id}{student_id}.csv"

def instance2_save(data, default_name):
    # 检查是否有数据
    if not data:
        print("错误:没有获取到数据。请务必先运行实例 1 的代码!")
        return

    # 获取文件名输入
    print("-" * 30)
    user_input = input(f"爬取完成, 输入要保存数据的文件名 (回车默认: {default_name}): ")
    save_name = user_input if user_input else default_name

    # 强制加后缀
    if not save_name.endswith('.csv'):
        save_name += '.csv'

    # 转换为 DataFrame
    df = pd.DataFrame(data)

    # 整理列顺序
    columns = ["书名", "作者", "译者", "出版社", "出版日期", "价格"]
    # 确保列存在 (防止空数据报错)
    df = df[columns] if not df.empty else pd.DataFrame(columns=columns)

    # 保存文件 (使用 utf-8-sig 防止 Excel 中文乱码)
    try:
        df.to_csv(save_name, index=False, encoding='utf-8-sig')
        print(f"成功!数据已保存至文件: {save_name}")
    except Exception as e:
        print(f"保存文件失败: {e}")

# 运行实例 2
print(">>> 开始运行实例 2 <<<")
# 检查实例1的数据是否存在
if 'crawled_data' in locals():
    instance2_save(crawled_data, default_filename)
else:
    print("错误:请先运行上面的【实例 1】代码块!")
输出:
六:思考题
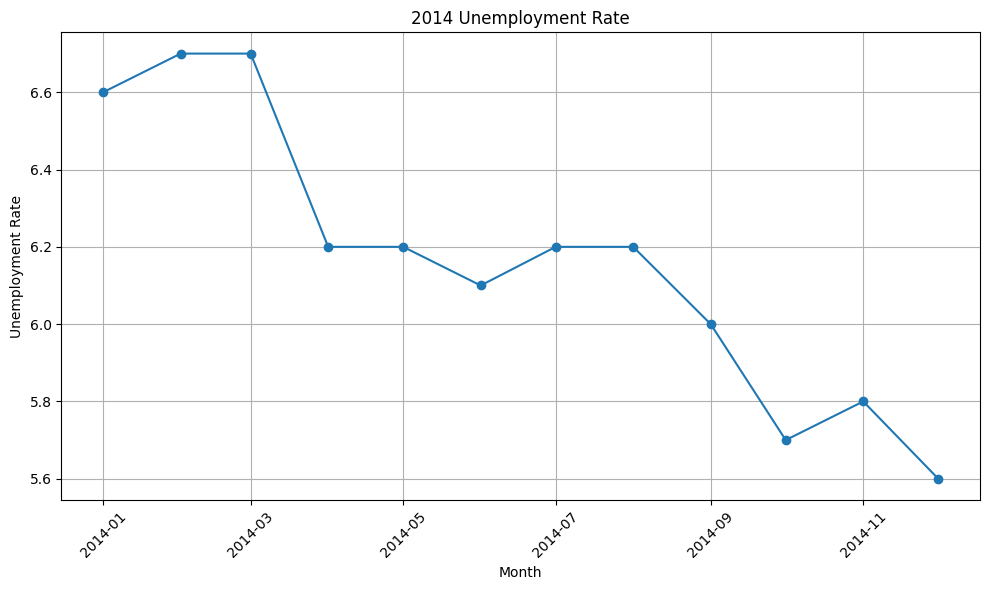
爬取自编网页美国 2014-2015 年的失业率数据,保存到.csv 文件中并将数据可视化。
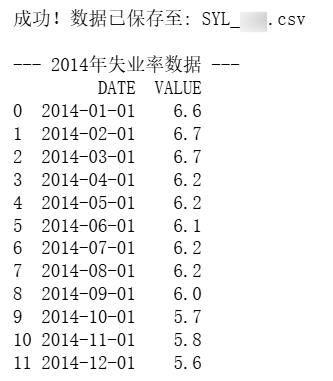
爬取附件里自编网页(unrate.htm)中的美国 2014-2015 年失业率,将数据保存到SYL_XYY.csv(X 为 1 位班号,YYY 为后 2 位学号)文件中,然后读入文件中的数据,将其中美国 2014 年的失业率进行数据可视化,先输出其 DATE 与 VALUE 的值,然后绘制曲线图。
输出示例:
import pandas as pd
import matplotlib.pyplot as plt
from bs4 import BeautifulSoup
import os


file_path = r"E:\大三上\wutao\人工智能与大数据\实验\shiyan2\unrate.htm"

class_id = "X"
student_id = "YY"
csv_output_name = f"SYL_{class_id}{student_id}.csv"

def process_and_plot():
    # 读取并解析 HTML 文件
    try:
        with open(file_path, 'r', encoding='gbk') as f:
            soup = BeautifulSoup(f, 'html.parser')
    except UnicodeDecodeError:
        # 如果 gbk 不行,尝试 gb18030
        print("GBK 读取失败,尝试使用 gb18030 读取...")
        with open(file_path, 'r', encoding='gb18030') as f:
            soup = BeautifulSoup(f, 'html.parser')
    except FileNotFoundError:
        print(f"错误:找不到文件,请检查路径是否正确:\n{file_path}")
        return
    except Exception as e:
        print(f"读取文件出错: {e}")
        return

    data = []
    # 查找表格的所有行
    rows = soup.find_all('tr')

    # 遍历每一行
    for row in rows:
        # 查找当前行里的所有单元格
        cols = row.find_all(['td', 'th'])
        # 提取文本并去除空格
        cols_text = [ele.get_text(strip=True) for ele in cols]

        # 只有当这一行不为空时才添加 (防止空行导致格式错误)
        if cols_text:
            data.append(cols_text)

    # 转换为 DataFrame
    if not data:
        print("错误:未在文件中找到表格数据。")
        return

    df = pd.DataFrame(data[1:], columns=data[0])

    # 保存为 CSV 文件
    try:
        df.to_csv(csv_output_name, index=False, encoding='utf-8-sig')
        print(f"成功!数据已保存至: {csv_output_name}")
    except Exception as e:
        print(f"保存 CSV 失败: {e}")

    # 数据可视化 (2014年数据)
    try:
        # 数据清洗:转换类型
        df['DATE'] = pd.to_datetime(df['DATE'])
        df['VALUE'] = pd.to_numeric(df['VALUE'])
    except Exception as e:
        print(f"数据格式转换错误 (请检查网页数据格式): {e}")
        return

    # 筛选 2014 年数据
    df_2014 = df[df['DATE'].dt.year == 2014].copy()

    # 按时间排序 (防止网页数据乱序)
    df_2014 = df_2014.sort_values(by='DATE')

    # 输出 2014 年的 DATE 和 VALUE
    print("\n--- 2014年失业率数据 ---")
    print(df_2014)

    # 绘图
    plt.figure(figsize=(10, 6))
    plt.plot(df_2014['DATE'], df_2014['VALUE'], marker='o', linestyle='-', color='tab:blue')

    # 设置图表标题和标签
    plt.title("2014 Unemployment Rate")
    plt.xlabel("Month")
    plt.ylabel("Unemployment Rate")

    # 设置横轴日期格式,使其更美观
    plt.xticks(rotation=45)
    plt.grid(True)

    # 显示图表
    plt.tight_layout()
    plt.show()

# 执行程序
if __name__ == "__main__":
    process_and_plot()
更多推荐
 16
 0
- 0


 已为社区贡献1条内容

所有评论(0)