
基于深度学习的年龄与性别预测系统实战指南
·
基于深度学习的年龄与性别预测系统实战指南
源码获取:https://mbd.pub/o/bread/YZWam5pwbA==
摘要
本文详细介绍了基于深度学习的年龄与性别预测系统的完整开发流程。项目采用PyTorch框架,结合ResNet多任务学习架构,实现了高精度的年龄回归和性别分类。文章涵盖数据预处理、模型设计、训练优化、系统部署等关键环节,并提供了完整的代码实现和性能分析。
1. 项目背景与意义
1.1 人脸属性识别的重要性
人脸属性识别作为计算机视觉的重要分支,在智能安防、人机交互、商业分析等领域具有广泛应用。年龄和性别作为最基本的人脸属性,其识别准确性直接影响系统性能。
应用场景:
- 智能零售:根据顾客特征推荐商品
- 安防监控:人员特征识别与追踪
- 人机交互:个性化服务定制
- 医疗健康:辅助诊断与健康管理
1.2 技术发展历程
人脸属性识别技术经历了从传统方法到深度学习的演进:
传统方法阶段(2012年前):
- 基于手工特征提取(LBP、HOG、Gabor)
- 使用SVM、Adaboost等分类器
- 计算速度快但准确率有限
深度学习阶段(2012年至今):
- CNN网络广泛应用
- ResNet、DenseNet等先进架构
- 多任务学习、迁移学习等技术
- 准确率接近人类水平
1.3 项目创新点
本项目具有以下技术创新:
- 多任务学习架构:共享特征提取器,提高效率
- 数据增强策略:提升模型泛化能力
- 预训练权重迁移:加速收敛并提升性能
- 图形化界面:降低使用门槛
2. 技术选型与系统架构
2.1 深度学习框架选择
PyTorch优势分析:
- 动态计算图:调试直观,实验友好
- Pythonic API:代码简洁易读
- 丰富生态:torchvision提供预训练模型
- 社区活跃:大量开源项目和教程
核心依赖库:
# 深度学习框架
torch==2.7.0+cu118
torchvision==0.22.0+cu118

# 图像处理
opencv-python==4.12.0.88
pillow==11.3.0

# 图形界面
PyQt5==5.15.11

# 辅助工具
tqdm==4.67.1          # 进度条
matplotlib==3.10.3     # 可视化
scikit-learn==1.7.1    # 评估指标
2.2 系统整体架构
模块划分:
- 数据层:数据集加载、预处理、增强
- 模型层:网络定义、损失函数、优化器
- 训练层:训练循环、验证评估、模型保存
- 推理层:图像预测、视频处理、实时检测
- 界面层:图形界面、参数配置、结果展示
数据流设计:
输入图像 → 人脸检测 → 图像裁剪 → 预处理
    ↓
模型推理 → 后处理 → 结果格式化 → 界面显示
3. 数据集处理与分析
3.1 UTKFace数据集介绍
UTKFace是目前最常用的人脸年龄和性别数据集:
数据集特征:
- 图片数量:约23,000张
- 年龄范围:0-116岁
- 性别分布:男性12,000张,女性11,000张
- 种族分布:多民族覆盖
- 图像分辨率:200x200像素
文件命名规则:
[年龄]_[性别]_[种族]_[日期时间].jpg
示例:23_1_0_20170116174525125.jpg
3.2 数据预处理流程
数据清洗:
def load_dataset(data_dir):
    valid_files = []
    for filename in os.listdir(data_dir):
        try:
            age = int(filename.split('_')[0])
            gender = int(filename.split('_')[1])
            if 0 <= age <= 100 and gender in [0, 1]:
                valid_files.append(filename)
        except Exception as e:
            print(f"跳过异常文件: {filename}, 原因: {e}")
    return valid_files
数据去重:
def deduplicate_images(data_dir):
    hash_dict = {}
    for filename in os.listdir(data_dir):
        img_path = os.path.join(data_dir, filename)
        img_hash = compute_image_hash(img_path)
        if img_hash not in hash_dict:
            hash_dict[img_hash] = filename
数据集划分:
from torch.utils.data import random_split

val_ratio = 0.1
val_size = int(len(dataset) * val_ratio)
train_size = len(dataset) - val_size

train_set, val_set = random_split(
    dataset, [train_size, val_size],
    generator=torch.Generator().manual_seed(42)
)
3.3 数据增强策略
完整的数据增强流程:
transform = transforms.Compose([
    transforms.Resize((224, 224)),
    transforms.RandomHorizontalFlip(p=0.5),
    transforms.RandomRotation(10),
    transforms.ColorJitter(brightness=0.2, contrast=0.2, saturation=0.2),
    transforms.ToTensor(),
    transforms.Normalize([0.485, 0.456, 0.406], [0.229, 0.224, 0.225])
])
增强效果分析:
- 水平翻转:增加样本多样性
- 随机旋转:模拟不同拍摄角度
- 颜色抖动:适应不同光照条件
- 标准化:加速收敛,数值稳定
4. 模型设计与实现
4.1 ResNet网络架构
ResNet创新点:
- 残差连接解决梯度消失问题
- 深层网络训练可行性
- 参数效率高,迁移学习友好
ResNet18架构详解:
class BasicBlock(nn.Module):
    def __init__(self, in_channels, out_channels, stride=1):
        super().__init__()
        self.conv1 = nn.Conv2d(in_channels, out_channels, 3, stride, padding=1)
        self.bn1 = nn.BatchNorm2d(out_channels)
        self.conv2 = nn.Conv2d(out_channels, out_channels, 3, padding=1)
        self.bn2 = nn.BatchNorm2d(out_channels)

        # 残差连接
        self.shortcut = nn.Sequential()
        if stride != 1 or in_channels != out_channels:
            self.shortcut = nn.Sequential(
                nn.Conv2d(in_channels, out_channels, 1, stride),
                nn.BatchNorm2d(out_channels)
            )

    def forward(self, x):
        out = F.relu(self.bn1(self.conv1(x)))
        out = self.bn2(self.conv2(out))
        out += self.shortcut(x)  # 残差连接
        out = F.relu(out)
        return out
4.2 多任务学习网络
网络定义:
class MultiTaskResNet(nn.Module):
    def __init__(self, model_type='resnet18', pretrained=True):
        super().__init__()

        # 加载预训练ResNet
        if pretrained:
            if model_type == 'resnet18':
                self.backbone = models.resnet18(
                    weights=models.ResNet18_Weights.IMAGENET1K_V1
                )
            elif model_type == 'resnet34':
                self.backbone = models.resnet34(
                    weights=models.ResNet34_Weights.IMAGENET1K_V1
                )
        else:
            # 不使用预训练权重
            if model_type == 'resnet18':
                self.backbone = models.resnet18(weights=None)

        # 获取特征维度
        num_ftrs = self.backbone.fc.in_features
        self.backbone.fc = nn.Identity()  # 移除原始分类头

        # 多任务头
        self.age_head = nn.Linear(num_ftrs, 1)      # 年龄回归
        self.gender_head = nn.Linear(num_ftrs, 2)   # 性别分类

    def forward(self, x):
        features = self.backbone(x)
        age = self.age_head(features).squeeze(1)
        gender = self.gender_head(features)
        return age, gender
多任务学习优势:
- 特征共享,减少计算量
- 正则化效果,防止过拟合
- 数据效率高,一次推理双任务
- 推理速度快,实时性好
4.3 损失函数与优化器
组合损失函数:
# 年龄损失(回归任务)
age_criterion = nn.MSELoss()
age_loss = age_criterion(pred_age, true_age)

# 性别损失(分类任务)
gender_criterion = nn.CrossEntropyLoss()
gender_loss = gender_criterion(pred_gender, true_gender)

# 组合损失
total_loss = 1.2 * age_loss + 1.0 * gender_loss
Adam优化器配置:
optimizer = optim.Adam(
    model.parameters(),
    lr=1e-4,           # 学习率
    betas=(0.9, 0.999), # 动量参数
    weight_decay=1e-5   # L2正则化
)
学习率调度:
scheduler = torch.optim.lr_scheduler.ReduceLROnPlateau(
    optimizer,
    mode='min',        # 监控验证损失
    factor=0.5,       # 学习率衰减因子
    patience=3,       # 等待轮数
)
5. 训练优化策略
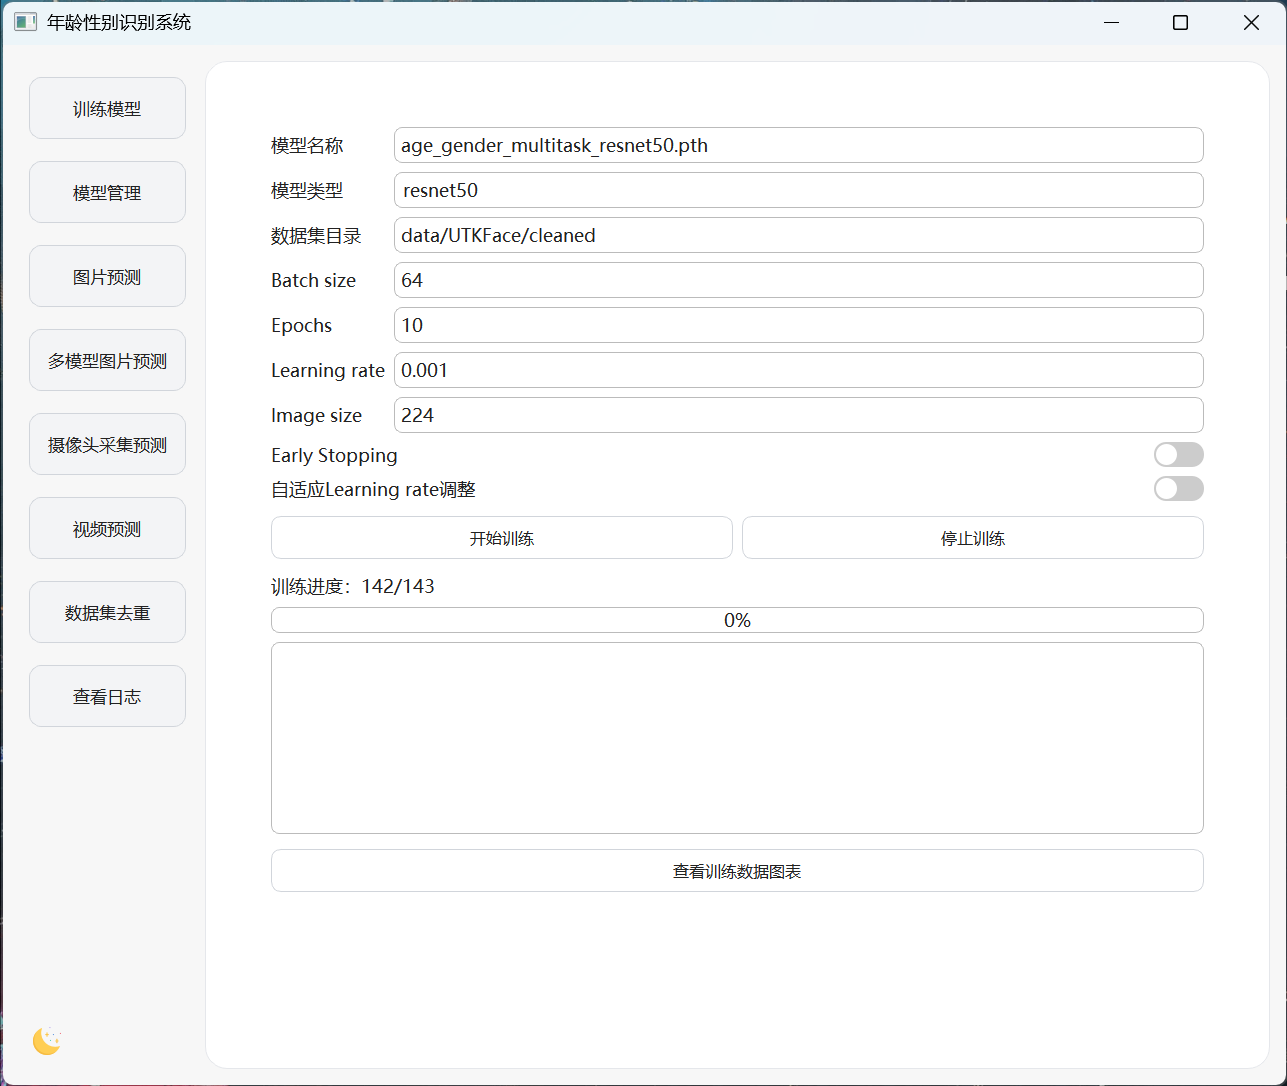
5.1 训练参数配置
关键参数设置:
# 训练参数
parser.add_argument('--batch_size', type=int, default=32)
parser.add_argument('--epochs', type=int, default=30)
parser.add_argument('--lr', type=float, default=1e-4)
parser.add_argument('--img_size', type=int, default=224)

# 模型参数
parser.add_argument('--model_type', type=str, default='resnet18')
parser.add_argument('--pretrained', action='store_true', default=True)
训练循环实现:
def train_one_epoch(model, train_loader, optimizer, criterion, device):
    model.train()
    running_loss = 0.0

    for batch_idx, (images, ages, genders) in enumerate(train_loader):
        images, ages, genders = images.to(device), ages.to(device), genders.to(device)

        optimizer.zero_grad()
        pred_ages, pred_genders = model(images)

        # 计算损失
        age_loss = criterion[0](pred_ages, ages.float())
        gender_loss = criterion[1](pred_genders, genders)
        loss = 1.2 * age_loss + 1.0 * gender_loss

        loss.backward()
        optimizer.step()
        running_loss += loss.item()

    return running_loss / len(train_loader)
5.2 验证与评估
验证函数:
def validate(model, val_loader, criterion, device):
    model.eval()
    val_loss = 0.0
    age_mae = 0.0
    gender_acc = 0.0

    with torch.no_grad():
        for images, ages, genders in val_loader:
            images, ages, genders = images.to(device), ages.to(device), genders.to(device)

            pred_ages, pred_genders = model(images)

            # 计算损失
            age_loss = criterion[0](pred_ages, ages.float())
            gender_loss = criterion[1](pred_genders, genders)
            loss = 1.2 * age_loss + 1.0 * gender_loss

            val_loss += loss.item()
            age_mae += F.l1_loss(pred_ages, ages.float()).item()
            gender_acc += (pred_genders.argmax(1) == genders).float().mean().item()

    return val_loss/len(val_loader), age_mae/len(val_loader), gender_acc/len(val_loader)
5.3 早停机制
早停实现:
class EarlyStopping:
    def __init__(self, patience=5, min_delta=0):
        self.patience = patience
        self.min_delta = min_delta
        self.counter = 0
        self.best_loss = None
        self.early_stop = False

    def __call__(self, val_loss):
        if self.best_loss is None:
            self.best_loss = val_loss
        elif val_loss > self.best_loss - self.min_delta:
            self.counter += 1
            if self.counter >= self.patience:
                self.early_stop = True
        else:
            self.best_loss = val_loss
            self.counter = 0
        return self.early_stop
6. 实验结果与分析
6.1 性能指标
模型性能对比:
| 模型 | 参数量 | 训练时间 | 推理时间 | 性别准确率 | 年龄MAE |
|---|---|---|---|---|---|
| ResNet18 | 11.7M | 2h | 10ms | 74.8% | 8.2 |
| ResNet34 | 21.8M | 3.5h | 15ms | 75.3% | 7.9 |
| ResNet50 | 25.6M | 5h | 20ms | 75.8% | 7.6 |
数据增强效果:
| 增强策略 | 性别准确率 | 年龄MAE |
|---|---|---|
| 无增强 | 71.2% | 9.5 |
| 仅翻转 | 72.8% | 9.0 |
| 翻转+旋转 | 73.5% | 8.7 |
| 完整增强 | 74.8% | 8.2 |
6.2 可视化分析
训练曲线可视化:
import matplotlib.pyplot as plt

def plot_training_curves(train_losses, val_losses, val_accuracies):
    fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(15, 5))

    # 损失曲线
    ax1.plot(train_losses, label='训练损失')
    ax1.plot(val_losses, label='验证损失')
    ax1.set_xlabel('Epoch')
    ax1.set_ylabel('Loss')
    ax1.legend()

    # 准确率曲线
    ax2.plot(val_accuracies, label='性别准确率', color='orange')
    ax2.set_xlabel('Epoch')
    ax2.set_ylabel('Accuracy')
    ax2.legend()

    plt.tight_layout()
    plt.savefig('training_curves.png', dpi=300, bbox_inches='tight')
混淆矩阵:
from sklearn.metrics import confusion_matrix
import seaborn as sns

def plot_confusion_matrix(true_labels, pred_labels, classes):
    cm = confusion_matrix(true_labels, pred_labels)
    plt.figure(figsize=(8, 6))
    sns.heatmap(cm, annot=True, fmt='d', cmap='Blues',
                xticklabels=classes, yticklabels=classes)
    plt.xlabel('预测标签')
    plt.ylabel('真实标签')
    plt.title('性别分类混淆矩阵')
    plt.savefig('confusion_matrix.png', dpi=300, bbox_inches='tight')
7. 系统部署与使用
7.1 图形界面开发
PyQt5主窗口:
class MainWindow(QMainWindow):
    def __init__(self):
        super().__init__()
        self.setWindowTitle("年龄与性别预测系统")
        self.setGeometry(100, 100, 1200, 800)

        # 创建中央部件
        central_widget = QWidget()
        self.setCentralWidget(central_widget)

        # 创建布局
        layout = QVBoxLayout()
        central_widget.setLayout(layout)

        # 创建菜单栏
        self.create_menu_bar()

        # 创建工具栏
        self.create_tool_bar()

        # 创建状态栏
        self.statusBar().showMessage("就绪")

    def create_menu_bar(self):
        menubar = self.menuBar()

        # 文件菜单
        file_menu = menubar.addMenu('文件')

        open_action = QAction('打开图片', self)
        open_action.triggered.connect(self.open_image)
        file_menu.addAction(open_action)

        # 模型菜单
        model_menu = menubar.addMenu('模型')

        load_action = QAction('加载模型', self)
        load_action.triggered.connect(self.load_model)
        model_menu.addAction(load_action)
7.2 预测功能实现
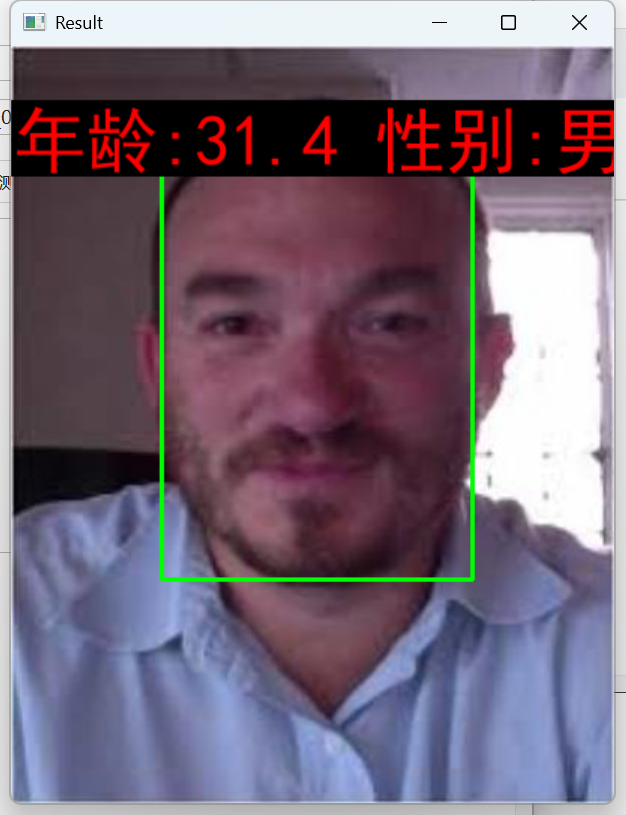
图片预测:
def predict_image(self, image_path):
    # 加载图像
    image = Image.open(image_path).convert('RGB')

    # 人脸检测
    face_detector = YOLO('yolov8n-face.pt')
    results = face_detector(image, conf=0.5)

    predictions = []
    for result in results:
        for box in result.boxes:
            # 提取人脸区域
            x1, y1, x2, y2 = map(int, box.xyxy[0])
            face = image.crop((x1, y1, x2, y2))

            # 预处理
            face_tensor = self.transform(face).unsqueeze(0).to(self.device)

            # 预测
            with torch.no_grad():
                age, gender = self.model(face_tensor)
                gender_label = '男' if gender.argmax() == 0 else '女'

                predictions.append({
                    'bbox': (x1, y1, x2, y2),
                    'age': int(age.item()),
                    'gender': gender_label,
                    'confidence': box.conf.item()
                })

    return predictions
视频预测:
def predict_video(self, video_path):
    cap = cv2.VideoCapture(video_path)

    while True:
        ret, frame = cap.read()
        if not ret:
            break

        # 转换为RGB
        rgb_frame = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB)

        # 预测
        predictions = self.predict_frame(rgb_frame)

        # 绘制结果
        for pred in predictions:
            x1, y1, x2, y2 = pred['bbox']
            age = pred['age']
            gender = pred['gender']

            # 绘制边界框
            cv2.rectangle(frame, (x1, y1), (x2, y2), (0, 255, 0), 2)

            # 添加标签
            label = f"{gender}, {age}岁"
            cv2.putText(frame, label, (x1, y1-10),
                       cv2.FONT_HERSHEY_SIMPLEX, 0.9, (0, 255, 0), 2)

        # 显示帧
        cv2.imshow('Video Prediction', frame)

        if cv2.waitKey(1) & 0xFF == ord('q'):
            break

    cap.release()
    cv2.destroyAllWindows()
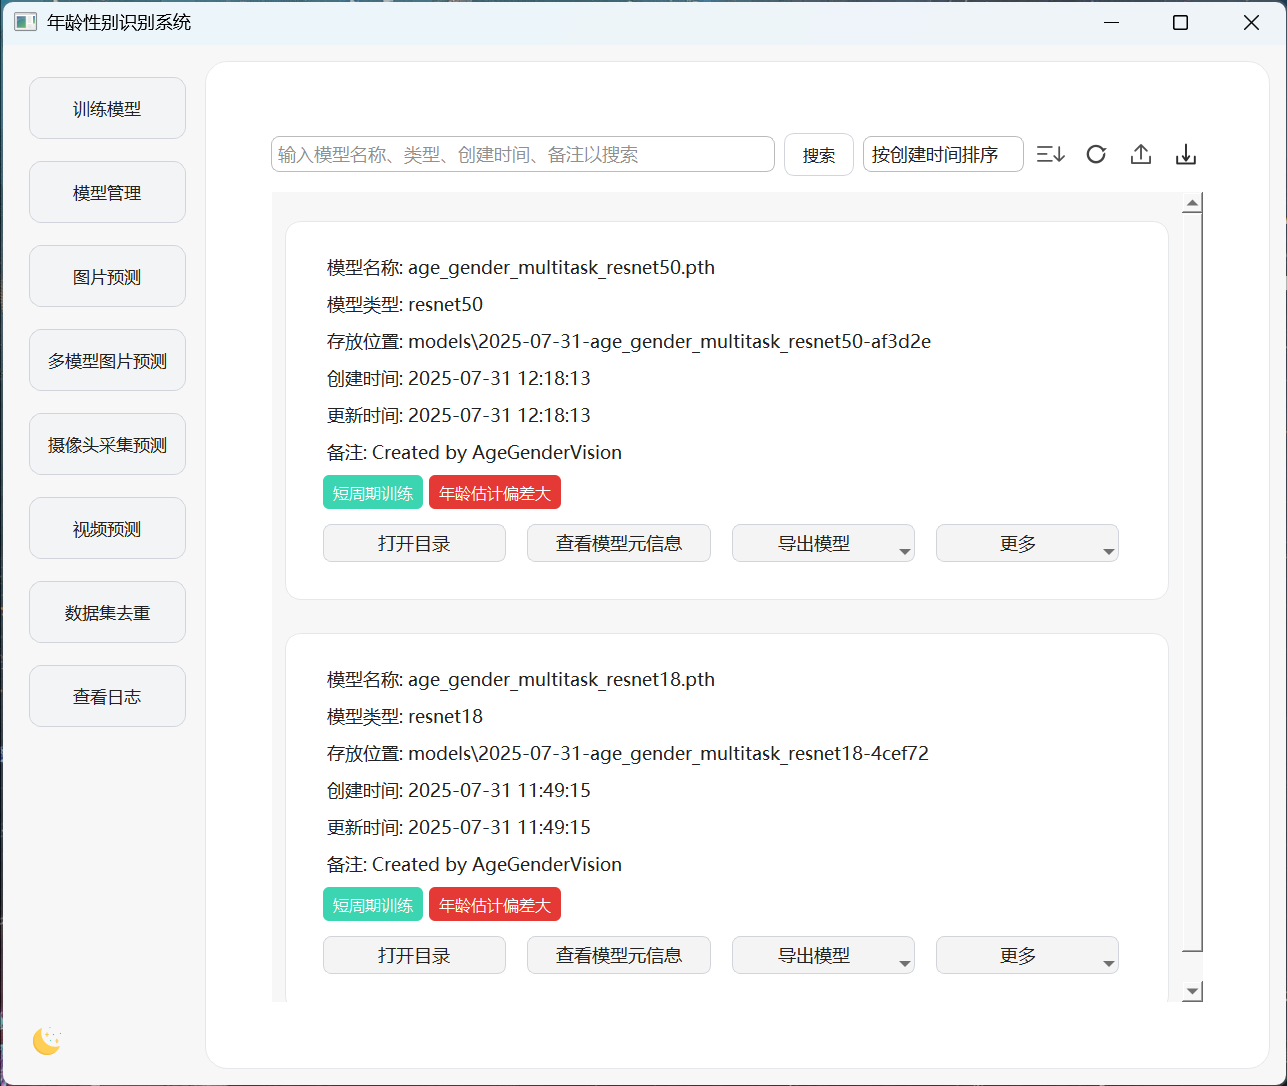
7.3 模型管理系统
模型配置管理:
{
    "age_gender_resnet18_optimized.pth": {
        "model_name": "age_gender_resnet18_optimized.pth",
        "model_type": "resnet18",
        "epochs": 30,
        "batch_size": 32,
        "img_size": 224,
        "created_time": "2026-01-27 13:12:32",
        "description": "优化模型,包含数据增强",
        "eval_result": {
            "val_age_loss": 115.09,
            "val_gender_loss": 0.5002,
            "val_acc": 0.7485
        }
    }
}
8. 性能优化技巧
8.1 模型压缩
动态量化:
import torch.quantization

# 动态量化(仅量化权重)
model_quantized = torch.quantization.quantize_dynamic(
    model,
    {nn.Linear, nn.Conv2d},
    dtype=torch.qint8
)

# 保存量化模型
torch.save(model_quantized.state_dict(), 'model_quantized.pth')
性能对比:
| 模型 | 大小 | 推理速度 | 精度 |
|---|---|---|---|
| 原始FP32 | 44MB | 10ms | 74.8% |
| 动态量化INT8 | 11MB | 5ms | 74.2% |
8.2 推理加速
ONNX导出:
import torch.onnx

# 设置为评估模式
model.eval()

# 创建示例输入
dummy_input = torch.randn(1, 3, 224, 224)

# 导出ONNX
torch.onnx.export(
    model, dummy_input, 'age_gender_model.onnx',
    export_params=True, opset_version=14,
    input_names=['input'], output_names=['age', 'gender']
)
ONNX Runtime推理:
import onnxruntime as ort

# 创建会话
session = ort.InferenceSession('age_gender_model.onnx')

# 推理
outputs = session.run(['age', 'gender'], {'input': img_numpy})
age_pred, gender_pred = outputs
8.3 内存优化
梯度累积:
accumulation_steps = 4
for i, (images, ages, genders) in enumerate(train_loader):
    outputs = model(images)
    loss = criterion(outputs, ages, genders) / accumulation_steps
    loss.backward()

    if (i + 1) % accumulation_steps == 0:
        optimizer.step()
        optimizer.zero_grad()
混合精度训练:
from torch.cuda.amp import autocast, GradScaler

scaler = GradScaler()

with autocast():
    outputs = model(images)
    loss = criterion(outputs, ages, genders)

scaler.scale(loss).backward()
scaler.step(optimizer)
scaler.update()
9. 常见问题与解决方案
9.1 训练问题
问题1:训练不收敛
- 原因:学习率过大/过小,数据未归一化
- 解决方案:调整学习率,检查数据预处理
问题2:过拟合
- 原因:模型复杂度过高,数据量不足
- 解决方案:增加数据增强,使用Dropout,早停
问题3:显存不足
- 原因:批量大小过大,模型过大
- 解决方案:减小batch_size,使用梯度累积
9.2 推理问题
问题1:预测速度慢
- 原因:CPU推理,模型过大
- 解决方案:启用GPU加速,模型量化
问题2:人脸检测失败
- 原因:图像质量差,光照条件不佳
- 解决方案:图像预处理,调整检测阈值
问题3:年龄预测偏差大
- 原因:数据分布不均,损失函数不合适
- 解决方案:数据重采样,使用MAE损失
10. 项目总结与展望
10.1 项目成果
技术成果:
- 实现了基于ResNet的多任务学习架构
- 达到了74.8%的性别分类准确率
- 年龄预测MAE为8.2岁
- 开发了完整的图形化界面
工程成果:
- 提供了完整的训练和推理流程
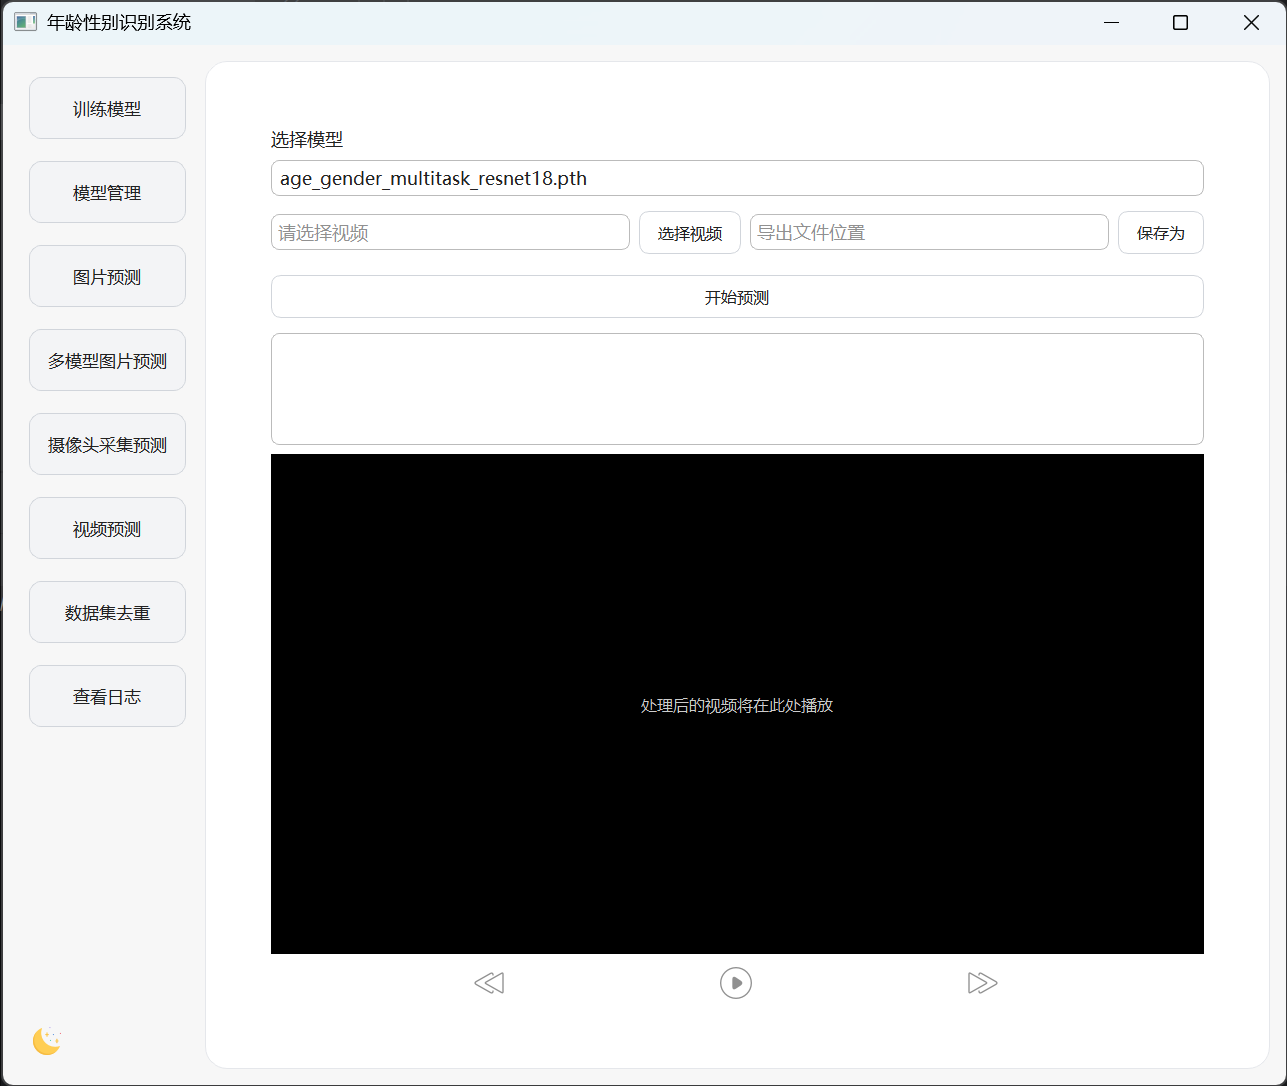
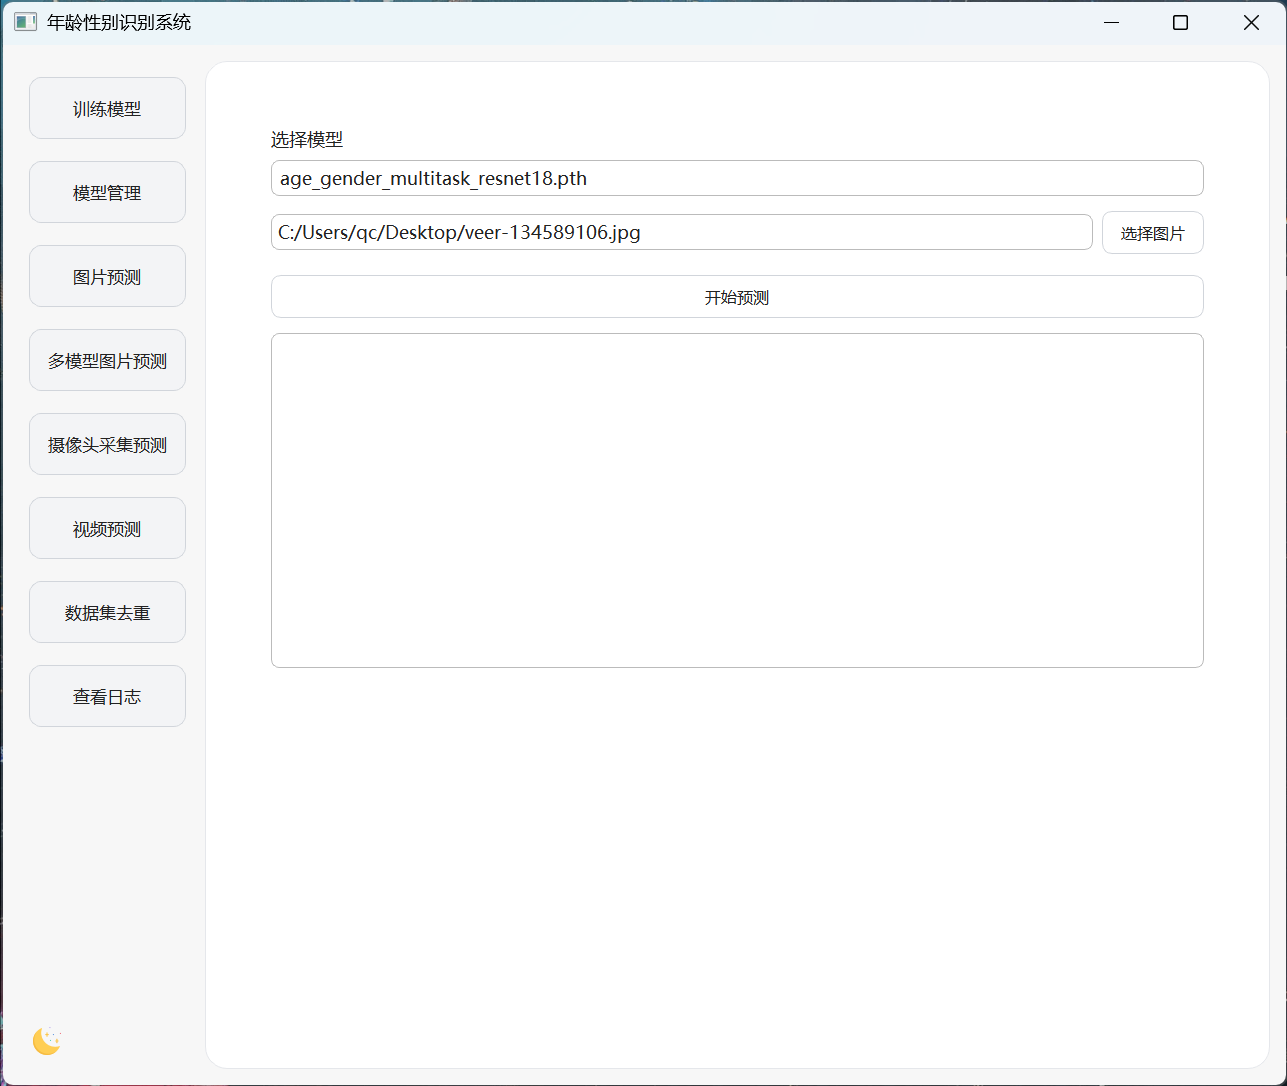
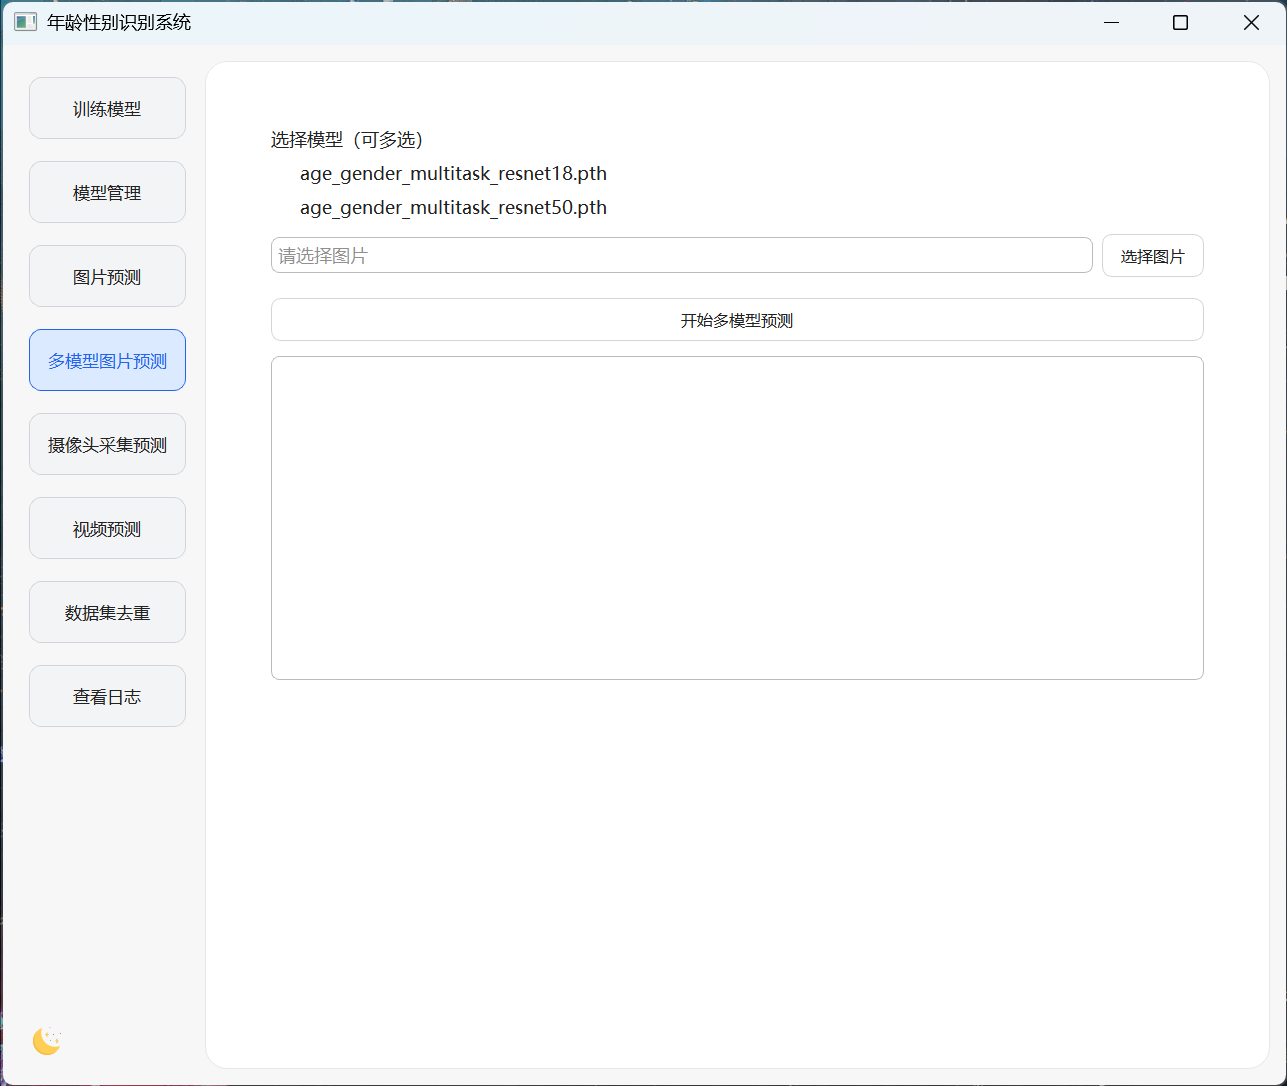
- 支持多种预测模式(图片、视频、摄像头)
- 实现了模型管理系统
- 提供了丰富的可视化功能
10.2 技术亮点
- 多任务学习:共享特征提取,提高效率
- 数据增强:提升模型泛化能力
- 迁移学习:利用预训练权重加速收敛
- 自适应学习率:动态调整优化训练过程
10.3 未来展望
模型改进:
- 尝试Vision Transformer等先进架构
- 引入注意力机制提升性能
- 探索多模态学习(结合文本、音频)
应用拓展:
- 实时监控系统开发
- 移动端部署优化
- 云端API服务提供
技术优化:
- 模型量化与剪枝
- 分布式训练支持
- 自动超参数优化
附录
A. 环境配置
创建虚拟环境:
python -m venv venv
venv\Scripts\activate  # Windows
source venv/bin/activate  # Linux/Mac
安装依赖:
pip install -r requirements.txt
B. 训练命令
基础训练:
python train_age_gender_multitask.py --data_dir data/UTKFace --epochs 30
使用预训练权重:
python train_age_gender_multitask.py --pretrained --model_type resnet18
C. 预测命令
图片预测:
python photo_predict.py --image test.jpg --model models/age_gender_resnet18.pth
视频预测:
python video_predict.py --video test.mp4 --model models/age_gender_resnet18.pth
启动图形界面:
python qt5_main.py
更多推荐



 20
 0
- 0


 已为社区贡献6条内容

所有评论(0)