
深度学习实战:食品图像分类
·
这次我们的项目是一个半监督学习的图像分类任务,既有带标签数据,也有无标签数据。先通过带标签数据训练模型,在模型的基础上,尝试着取预测无标签数据,如果结果达到了一定的置信度,就可以选择相信这些数据,将其加入到数据集中训练模型。
为了实验可复现,需要固定随机种子
def seed_everything(seed):
    torch.manual_seed(seed)
    torch.cuda.manual_seed(seed)
    torch.cuda.manual_seed_all(seed)
    torch.backends.cudnn.benchmark = False
    torch.backends.cudnn.deterministic = True
    random.seed(seed)
    np.random.seed(seed)
    os.environ['PYTHONHASHSEED'] = str(seed)
#################################################################
seed_everything(0)
###############################################
接下来,依旧是数据集、模型、超参这三部分的书写。
首先,数据集部分。对于一张图片来说,图片的大、拍摄的光线、镜头的角度、对比度等等一系列都会影响模型的判断,所以需要对数据进行预处理,人为的扩充数据集。这里就用到了 transform 。
transform 第一,可以将原始图片转换为模型可以接受的张量格式。第二,可以进行数据增强,对训练数据进行随机变换,从而扩充数据集,防止过拟合,提高鲁棒性。
常见的增强操作有
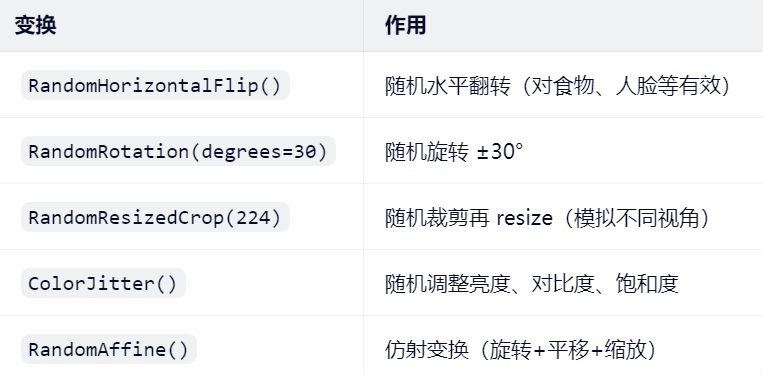
需要注意的是,数据增强只用在训练集上,验证/测试集不能使用!
train_trainsform = transforms.Compose(
    [
        transforms.ToPILImage(),    #图片是224 224 3   模型要求3,224,224
        transforms.RandomResizedCrop(224),  #放大裁切
        transforms.RandomRotation(50),      #50度以内随机变换
        transforms.ToTensor()
    ]
)
val_trainsform = transforms.Compose(    #注意验证和测试的时候用原图
    [
        transforms.ToPILImage(),    #图片是224 224 3   模型要求3,224,224
        transforms.ToTensor()
    ]
)
下面进入数据集类。
这次,我们把读取文件的函数也定义在这个类里。
对于图片来说,数据量就是这里的 jpg 文件的数量,需要创建一个四维的数组(图像编号,长、高、维度)来存储数据,还有需要注意的是,我们的初始文件地址用的是存放图像文件的文件夹地址,而具体每一个图像的地址需要拼接上文件名,其他的与之前的模型类似。
其次,我们还要建一个半监督数据集,按照开头描述的逻辑进行即可。
下面来到模型部分,我们使用的是ResNet18的架构,没有太多需要额外赘述。
训练过程与之前的回归模型一致。下面给出完整的代码。
import random
import torch
import torch.nn as nn
import numpy as np
import os
from torch.utils.data import Dataset,DataLoader
from tqdm import tqdm  #显示循环进度
from PIL import Image   #读取图片
from torchvision import transforms
import time
import matplotlib
matplotlib.use("QtAgg")
import matplotlib.pyplot as plt
from model_utils.model import initialize_model

#好复现,可以固定随机种子
def seed_everything(seed):
    torch.manual_seed(seed)
    torch.cuda.manual_seed(seed)
    torch.cuda.manual_seed_all(seed)
    torch.backends.cudnn.benchmark = False
    torch.backends.cudnn.deterministic = True
    random.seed(seed)
    np.random.seed(seed)
    os.environ['PYTHONHASHSEED'] = str(seed)
#################################################################
seed_everything(0)
###############################################


model_name = 'resnet18'
##########################################

HW = 224


train_trainsform = transforms.Compose(
    [
        transforms.ToPILImage(),    #图片是224 224 3   模型要求3,224,224
        transforms.RandomResizedCrop(224),  #放大裁切
        transforms.RandomRotation(50),      #50度以内随机变换
        transforms.ToTensor()
    ]
)
val_trainsform = transforms.Compose(    #注意验证和测试的时候用原图
    [
        transforms.ToPILImage(),    #图片是224 224 3   模型要求3,224,224
        transforms.ToTensor()
    ]
)

class food_Dataset(Dataset):
    def __init__(self, path, mode="train"):
        self.mode = mode
        if mode == "semi":
            self.X = self.read_file(path)
        else:
            self.X, self.Y = self.read_file(path)
            self.Y = torch.LongTensor(self.Y)   #标签转化为长整型
        if mode == "train":
            self.transform = train_trainsform    #数据变换
        else:
            self.transform = val_trainsform

    def read_file(self, path):

        if self.mode == "semi":
            file_list = os.listdir(path)

            xi = np.zeros((len(file_list), HW, HW, 3), dtype=np.uint8)  # rgb是整数,所以我们读的也得转为整数,这句代码实际上是创建了一个四维的空数组,数组元素类型是unsignedint 0~255
            yi = np.zeros((len(file_list)), dtype=np.uint8)

            # 列出文件夹下所有文件的名字
            for j, img_name in enumerate(file_list):  # 既可以读到下标也可以读到下标的值
                img_path = os.path.join(path, img_name) #这里的路径是拼接上文件具体名字的具体路径 例如:path = "D:/data/00", img_name = "apple.jpg" → img_path = "D:/data/00/apple.jpg"
                img = Image.open(img_path)  # 读进来的图片大小是512*512
                img = img.resize((HW, HW))  # 我们模型常用的大小是224*224,调整大小
                xi[j, ...] = img    #放入数组,j是图像的索引, ... 表示所有的维度,也就是说第j张图的所有像素和通道
            print("读到了%d个数据" % len(xi))
            return xi
        else:
            for i in tqdm(range(11)):
                file_dir = path + "/%02d" % i
                file_list = os.listdir(file_dir)

                xi = np.zeros((len(file_list), HW, HW, 3), dtype=np.uint8)  # rgb是整数,所以我们读的也得转为整数
                yi = np.zeros((len(file_list)), dtype=np.uint8)

                # 列出文件夹下所有文件的名字
                for j, img_name in enumerate(file_list):  # 既可以读到下标也可以读到下标的值
                    img_path = os.path.join(file_dir, img_name)
                    img = Image.open(img_path)  # 读进来的图片大小是512*512
                    img = img.resize((HW, HW))  # 我们模型常用的大小是224*224
                    xi[j, ...] = img
                    yi[j] = i

                if i == 0:
                    X = xi
                    Y = yi
                else:
                    X = np.concatenate((X, xi), axis=0)
                    Y = np.concatenate((Y, yi), axis=0)
            print("读到了%d个数据" % len(Y))
            return X, Y

    def __getitem__(self, item):
        if self.mode == "semi":
            return self.transform(self.X[item]),self.X[item]
        else:
            return self.transform(self.X[item]), self.Y[item]

    def __len__(self):
        return len(self.X)


class semiDataset(Dataset):
    def __init__(self, no_label_loder, model, device, thres=0.99):
        x, y = self.get_label(no_label_loder, model, device, thres)
        if x == []:
            self.flag = False
        else:
            self.flag = True
            self.x = np.array(x)
            self.y = torch.LongTensor(y)
            self.transform = train_trainsform

    def get_label(self, no_label_loder, model, device, thres):
        model = model.to(device)
        pred_prob = []      #概率值
        labels = []         #对应的标签
        x = []
        y = []
        soft = nn.Softmax(dim=1)
        with torch.no_grad():
            for bat_x, _ in no_label_loder:
                bat_x = bat_x.to(device)
                pred = model(bat_x)
                pred_soft = soft(pred)
                pred_max, pred_value = pred_soft.max(1)
                pred_prob.extend(pred_max.cpu().numpy().tolist())
                labels.extend(pred_value.cpu().numpy().tolist())

        for index, prob in enumerate(pred_prob):
            if prob > thres:
                x.append(no_label_loder.dataset[index][1])     #调用到原始的getitem
                y.append(labels[index])
        return x, y

    def __getitem__(self, item):
        return self.transform(self.x[item]), self.y[item]
    def __len__(self):
        return len(self.x)

def get_semi_loader(no_label_loader, model, device, thres):
    semiset = semiDataset(no_label_loader, model, device, thres)
    if semiset.flag == False:
        return None
    else:
        semi_loader = DataLoader(semiset, batch_size=16, shuffle=False)
        return semi_loader

class myModel(nn.Module):
    def __init__(self, num_class):
        super(myModel, self).__init__()
        # 3*224*224 -> 512*7*7 -> 拉直 -> 全连接分类
        self.conv1 = nn.Conv2d(3, 64, 3 , 1, 1)      #输入特征图数量(通道数) 输出特征图数量(卷积核数) 卷积核大小 步长 padding
        self.bn1 = nn.BatchNorm2d(64)
        self.relu1 = nn.ReLU()
        self.pool1 = nn.MaxPool2d(2)        # ->64*112*112


        self.layer1 = nn.Sequential(    #另一种写法,这样更方便
            nn.Conv2d(64, 128, 3, 1, 1),
            nn.BatchNorm2d(128),
            nn.ReLU(),
            nn.MaxPool2d(2)  # ->112*56*56
        )

        self.layer2 = nn.Sequential(
            nn.Conv2d(128, 256, 3, 1, 1),
            nn.BatchNorm2d(256),
            nn.ReLU(),
            nn.MaxPool2d(2)  # ->256*28*28
        )

        self.layer3 = nn.Sequential(  # 另一种写法,这样更方便
            nn.Conv2d(256, 512, 3, 1, 1),
            nn.BatchNorm2d(512),
            nn.ReLU(),
            nn.MaxPool2d(2)  # ->512*14*14
        )

        self.pool2 = nn.MaxPool2d(2)    # ->512*7*7
        self.fc1 = nn.Linear(25088, 1000)   #25088 -> 1000
        self.relu2 = nn.ReLU()
        self.fc2 = nn.Linear(1000, num_class)   #1000 -> 11

    def forward(self, x):
        x = self.conv1(x)
        x = self.bn1(x)
        x = self.relu1(x)
        x = self.pool1(x)
        x = self.layer1(x)
        x = self.layer2(x)
        x = self.layer3(x)
        x = self.pool2(x)
        x = x.view(x.size()[0], -1)     #拉直
        x = self.fc1(x)
        x = self.relu2(x)
        x = self.fc2(x)
        return x

def train_val(model, train_loader, val_loader, no_label_loader, device, epochs, optimizer, loss, thres, save_path):
    model = model.to(device)
    semi_loader = None
    plt_train_loss = []
    plt_val_loss = []

    plt_train_acc = []
    plt_val_acc = []

    max_acc = 0.0

    for epoch in range(epochs):
        train_loss = 0.0
        val_loss = 0.0
        semi_loss = 0.0
        train_acc = 0.0
        val_acc = 0.0
        semi_acc = 0.0
        start_time = time.time()

        model.train()   #模型调整为训练模式
        for batch_x, batch_y in train_loader:
            x, target = batch_x.to(device), batch_y.to(device)
            pred = model(x)
            train_bat_loss = loss(pred, target)
            train_bat_loss.backward()
            optimizer.step()        #更新模型
            optimizer.zero_grad()
            train_loss += train_bat_loss.cpu().item()
            train_acc += np.sum(np.argmax(pred.detach().cpu().numpy(), axis=1) == target.cpu().numpy())

        plt_train_loss.append(train_loss / train_loader.__len__())
        plt_train_acc.append(train_acc / train_loader.dataset.__len__())    #记录准确率

        if semi_loader != None:
            for batch_x, batch_y in semi_loader:
                x, target = batch_x.to(device), batch_y.to(device)
                pred = model(x)
                semi_bat_loss = loss(pred, target)
                semi_bat_loss.backward()
                optimizer.step()        #更新模型
                optimizer.zero_grad()
                semi_loss += semi_bat_loss.cpu().item()
                semi_acc += np.sum(np.argmax(pred.detach().cpu().numpy(), axis=1) == target.cpu().numpy())
            print("半监督数据集的训练准确率为",semi_acc/ train_loader.dataset.__len__())

        model.eval()    #验证模式
        with torch.no_grad():
            for batch_x, batch_y in val_loader:
                x, target = batch_x.to(device), batch_y.to(device)
                pred = model(x)
                val_bat_loss = loss(pred, target)
                val_loss += val_bat_loss.cpu().item()
                val_acc += np.sum(np.argmax(pred.detach().cpu().numpy(), axis=1) == target.cpu().numpy())
        plt_val_loss.append(val_loss / val_loader.__len__())
        plt_val_acc.append(val_acc / val_loader.dataset.__len__())

        if epoch % 3 == 0 and plt_val_acc[-1] > 0.6:
            semiLoder = get_semi_loader(no_label_loader, model, device, thres)

        if val_acc > max_acc:
            os.makedirs(os.path.dirname(save_path), exist_ok=True)
            torch.save(model.state_dict(), save_path)
            max_acc = val_acc

        print("[%03d/%03d] %2.2f sec(s) Trainloss: %.6f |Valloss: %.6f Trainacc: %.6f |Valacc: %.6f" % \
              (epoch, epochs, time.time()-start_time, plt_train_loss[-1], plt_val_loss[-1], plt_train_acc[-1], plt_val_acc[-1])
              )

    plt.plot(plt_train_loss)
    plt.plot(plt_val_loss)
    plt.title("loss")
    plt.legend(["train", "val"])
    plt.show()

    plt.plot(plt_train_acc)
    plt.plot(plt_val_acc)
    plt.title("acc")
    plt.legend(["train", "val"])
    plt.show()

train_path = r"D:\深度学习\食品分类\food_classification\food-11\training\labeled"
val_path = r"D:\深度学习\食品分类\food_classification\food-11\validation"

# train_path = r"D:\深度学习\食品分类\food_classification\food-11_sample\training\labeled"
# val_path = r"D:\深度学习\食品分类\food_classification\food-11_sample\validation"
no_label_path = r"D:\深度学习\食品分类\food_classification\food-11_sample\training\unlabeled\00"


train_set = food_Dataset(train_path, "train")
val_set = food_Dataset(val_path, "val")
no_label_set = food_Dataset(no_label_path, "semi")

train_loader = DataLoader(train_set, batch_size=16, shuffle=True)
val_loader = DataLoader(val_set, batch_size=16, shuffle=True)
no_label_loader = DataLoader(no_label_set, batch_size=16, shuffle=False)

# model = myModel(11)

# from torchvision.models import resnet18
# model = resnet18(pretrained=True)
# in_features = model.fc.in_features      #分类头
# model.fc = nn.Linear(in_features, 11)

model, _ = initialize_model("resnet18", 11, use_pretrained=True)

lr = 0.001
loss = nn.CrossEntropyLoss()
optimizer = torch.optim.AdamW(model.parameters(), lr=lr, weight_decay=1e-4)
device = "cuda" if torch.cuda.is_available() else "cpu"
save_path = "model_save/best_model.pth"
epochs = 15
thres = 0.99


train_val(model, train_loader, val_loader, no_label_loader, device, epochs, optimizer, loss, thres, save_path)
更多推荐


 3
 0
- 0


 已为社区贡献7条内容

所有评论(0)