
深度学习linear代码学习
# 替换原来的Agg配置
import matplotlib
matplotlib.use('TkAgg', force=True) # 改用TkAgg GUI后端
# import matplotlib
# matplotlib.use('Agg', force=True)
# print('强制设置后:', matplotlib.get_backend())
import torch
import matplotlib.pyplot as plt # 画图的
import random #随机
#生成变量X与Y
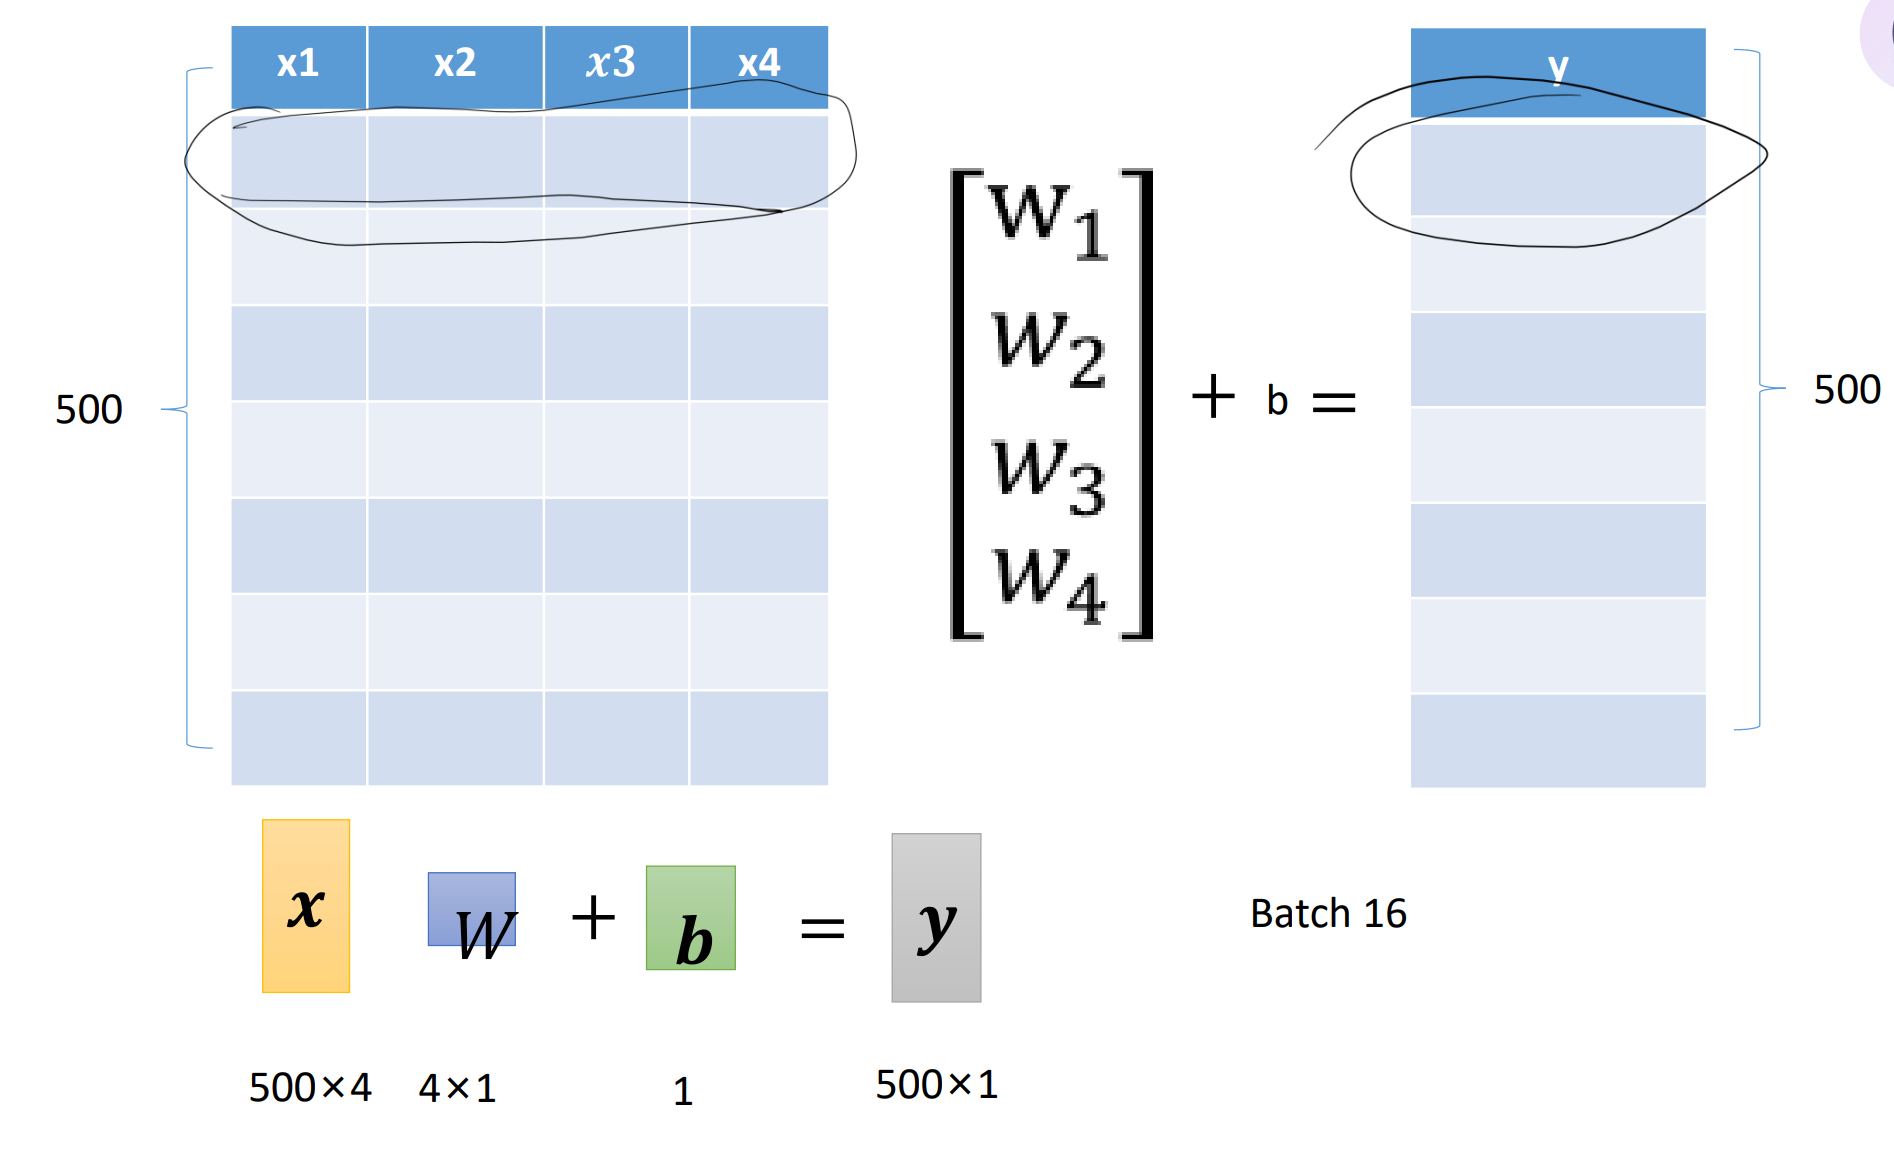
def create_data(w, b, data_num): #生成数据
x = torch.normal(0, 1, (data_num, len(w)))
y = torch.matmul(x, w) + b #matmul表示矩阵相乘
noise = torch.normal(0, 0.01, y.shape) #噪声要加到y上
y += noise
return x, y
num = 500
true_w = torch.tensor([8.1,2,2,4])
true_b = torch.tensor(1.1)
X, Y = create_data(true_w, true_b, num)
plt.scatter(X[:, 3], Y, 1)
plt.show()
#按批取数据,例如一次取16个
def data_provider(data, label, batchsize): #每次访问这个函数, 就能提供一批数据
length = len(label)
indices = list(range(length))
#我不能按顺序取 把数据打乱
random.shuffle(indices)
for each in range(0, length, batchsize):
get_indices = indices[each: each+batchsize]
get_data = data[get_indices]
get_label = label[get_indices]
yield get_data,get_label #有存档点的return
batchsize = 16
# for batch_x, batch_y in data_provider(X, Y, batchsize):
# print(batch_x, batch_y)
# break
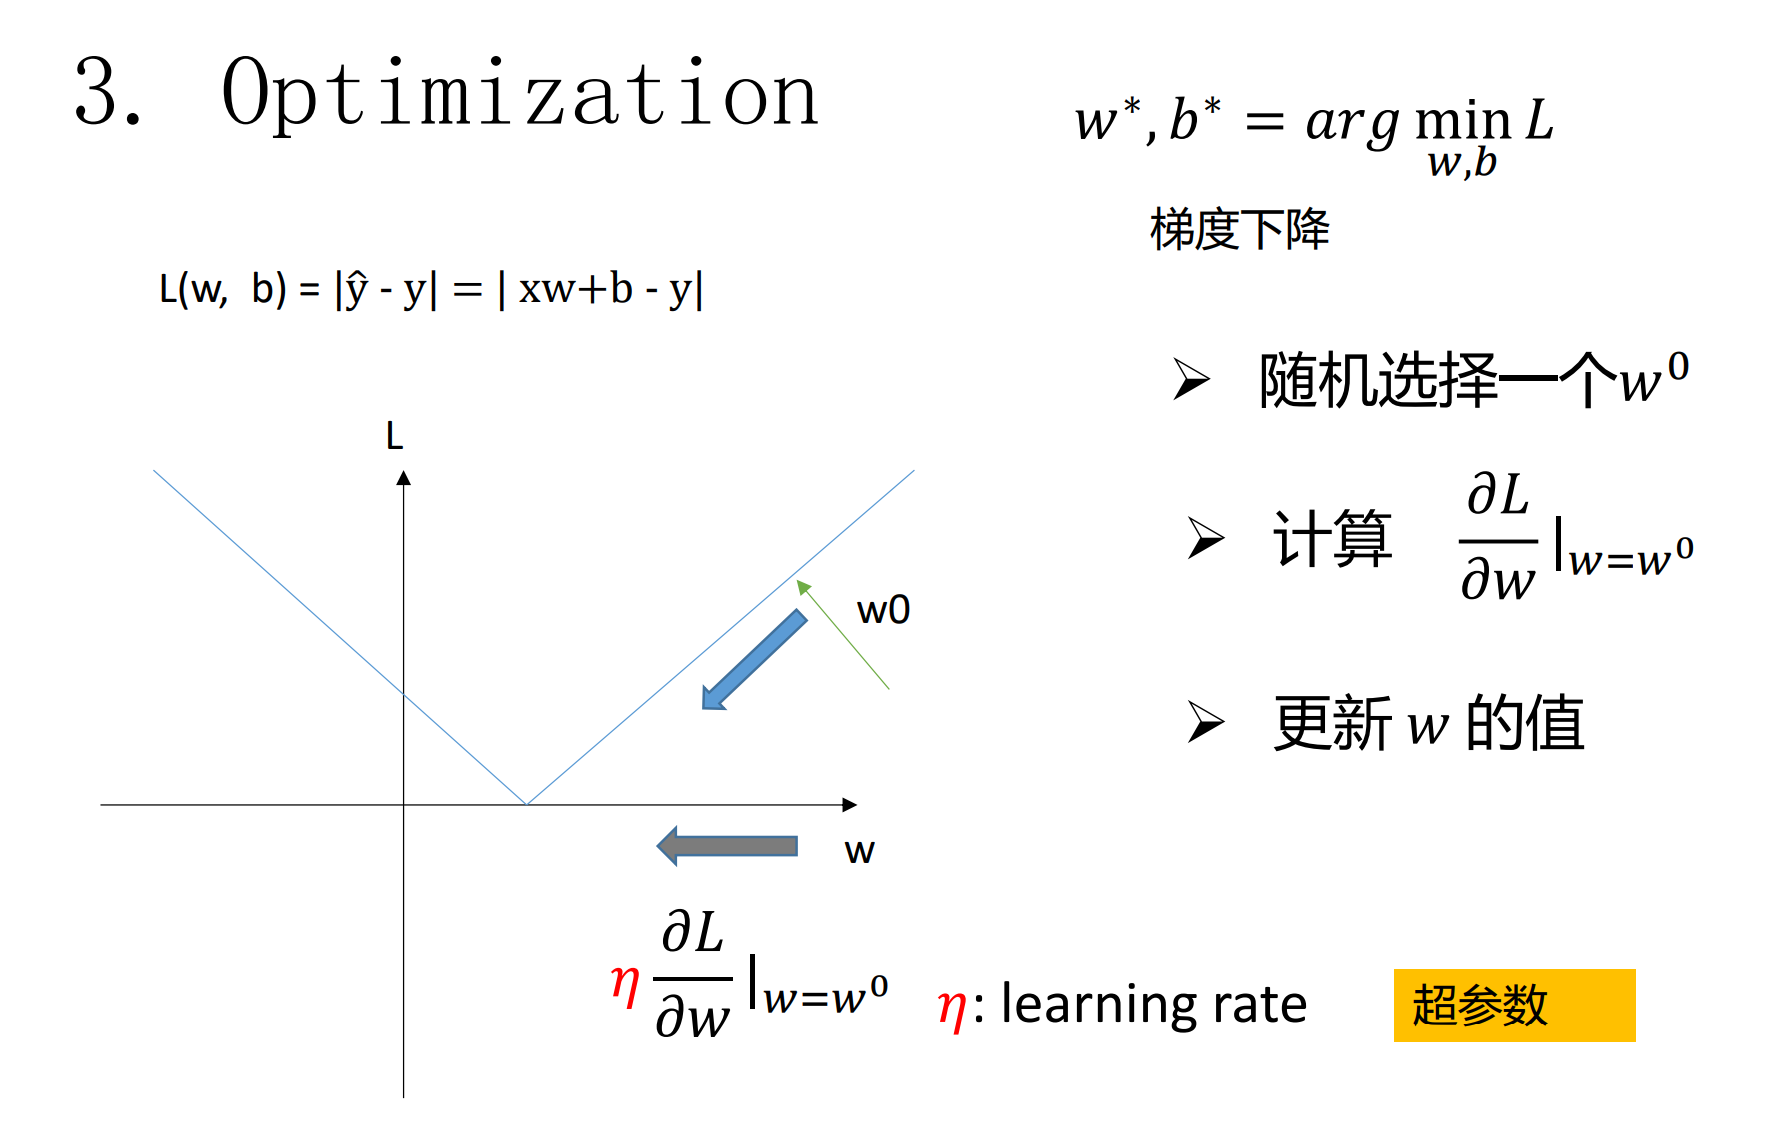
#计算损失函数,并根据学习率下降梯度
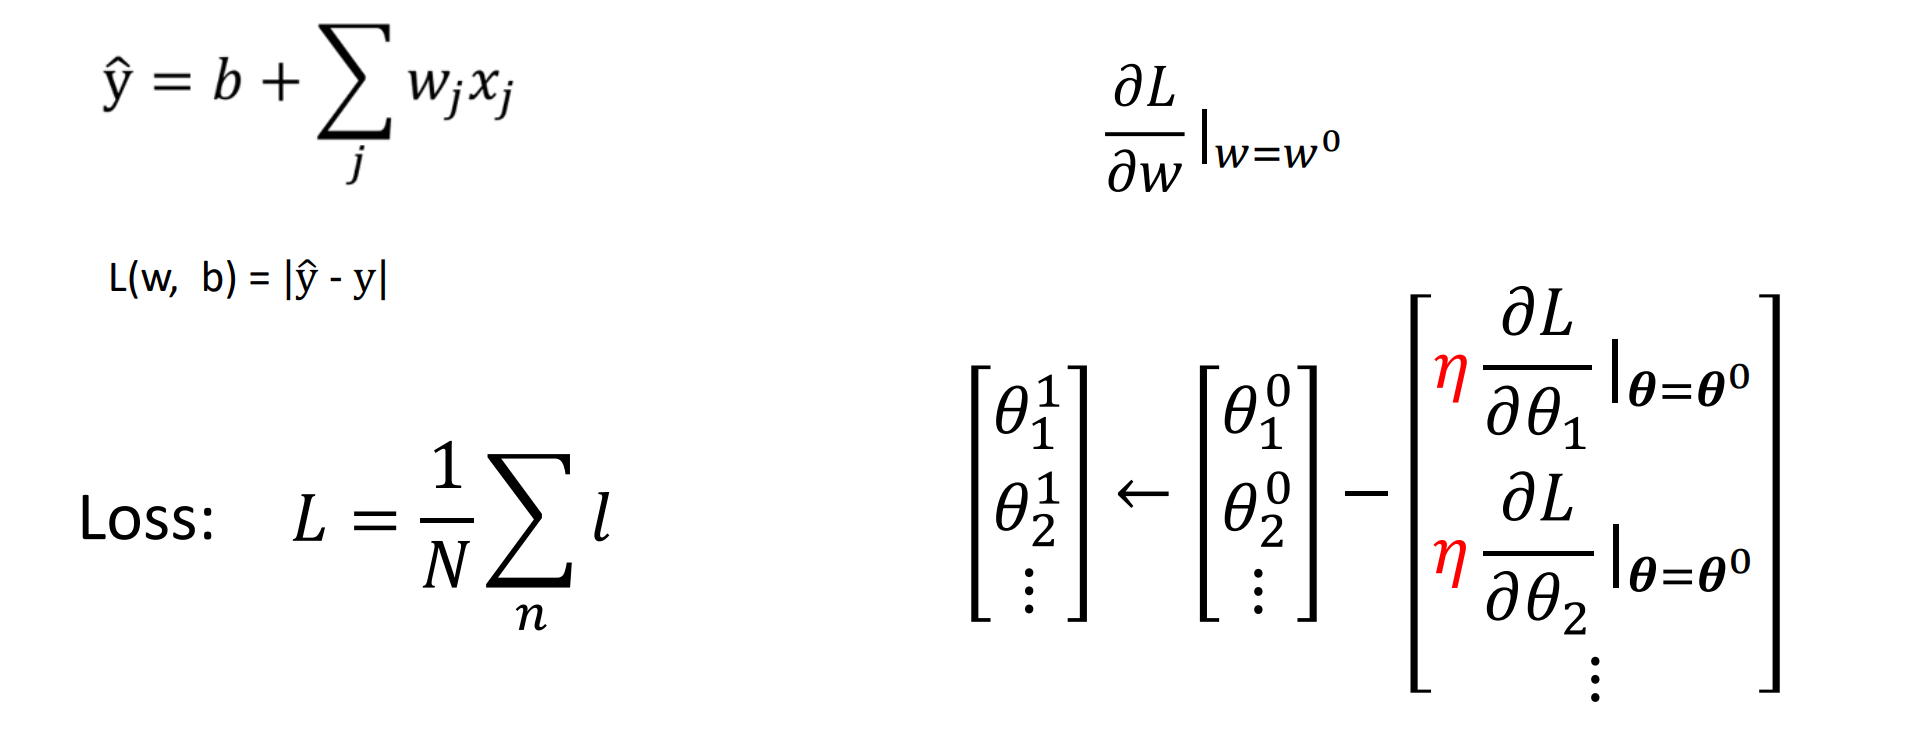
def fun(x, w, b):
pred_y = torch.matmul(x, w) + b
return pred_y
def maeLoss(pre_y, y):
return torch.sum(abs(pre_y-y))/len(y)
def sgd(paras, lr): #随机梯度下降,更新参数
with torch.no_grad(): #属于这句代码的部分,不计算梯度
for para in paras:
para -= para.grad * lr #不能写成 para = para - para.grad*lr
para.grad.zero_() #使用过的梯度,归0
lr = 0.03
w_0 = torch.normal(0, 0.01, true_w.shape, requires_grad=True) #这个w需要计算梯度
b_0 = torch.tensor(0.01, requires_grad=True)
print(w_0, b_0)
训练50轮,看50遍数据
epochs = 50
for epoch in range(epochs):
data_loss = 0
for batch_x, batch_y in data_provider(X, Y, batchsize):
pred_y = fun(batch_x,w_0, b_0)
loss = maeLoss(pred_y, batch_y)
loss.backward()
sgd([w_0, b_0], lr)
data_loss += loss
print("epoch %03d: loss: %.6f"%(epoch, data_loss))
print("真实的函数值是", true_w, true_b)
print("训练得到的参数值是", w_0, b_0)
#可视化
idx = 0
plt.plot(X[:, idx].detach().numpy(), X[:, idx].detach().numpy()*w_0[idx].detach().numpy()+b_0.detach().numpy())
plt.scatter(X[:, idx], Y, 1)
plt.show()
Q:感觉似懂非懂,张量这一块,比如我有X,Y,根据初始化w和b计算pre_y与y之间的loss,然后根据梯度下降,调整w和b
A:你的理解完全正确!整个流程就是一个“找参数”的过程。
你现在的困惑点可能在于:这中间的数据(张量)到底经历了什么变化? 为什么一堆数进去,最后就能算出怎么改参数?
为了帮你彻底打通“任督二脉”,我们不再看枯燥的代码,而是把张量看作“各种形状的积木”。我们来跟踪一下,在一个 batch(16条数据)的训练循环里,这些积木的形状是怎么变的。
我们可以把这个过程想象成一个**“大漏斗”**:
第一阶段:前向传播(积木变小,漏斗向下)
目标:从一堆数据,浓缩成一个代表“错误程度”的数字。
-
输入 X (Data):
-
形状:
[16, 4](16行样本,4列特征) 。+1
-
形象: 一个 16x4 的 Excel 表格。
-
形状:
-
参数 w (Weights) 和 b (Bias):
-
形状: w 是
[4, 1](4个权重,对应4个特征),b 是[1](1个偏置) 。 -
形象: w 是一条竖着的积木,b 是一个小方块。
-
形状: w 是
-
第一步运算:矩阵乘法
x @ w-
操作: 用 16x4 的表格 乘以 4x1 的条。
-
形状变化:
[16, 4] * [4, 1] = [16, 1]。 -
结果: 得到了 16 个初步预测值。这一步把 4 个特征“压缩”成了 1 个预测值。
-
-
第二步运算:加偏置
+ b-
操作: 给这 16 个数每一个都加上 b。
-
结果
pred_y: 形状依然是[16, 1]。这是模型猜出来的 16 个答案。
-
-
第三步运算:算损失
loss-
操作: 拿猜出来的
pred_y(16个) 和真实的batch_y(16个) 做减法,取绝对值,然后求和取平均 。+1
-
形状变化关键点:
[16, 1]vs[16, 1]→ 算出一个平均数。 -
结果
loss: 形状变成了[](标量,0维张量)。 -
理解: 无论你有多少数据,最后必须浓缩成唯一个数字(比如
loss = 3.5)。这个数字告诉你:“总的来说,你这次考得很差。”
-
操作: 拿猜出来的
第二阶段:反向传播(原路返回,指哪打哪)
目标:利用那个唯一的 loss,倒回去告诉 w 和 b 该怎么改。
这就是你困惑的 loss.backward():
-
起点: 唯一的数字
loss(比如 3.5)。 -
PyTorch 的问题: “为了让这 3.5 变小,当初那 4 个 w 分别贡献了多少错误?”
-
梯度张量 (
w.grad) 的诞生:-
因为 w 的形状是
[4, 1],所以算出来的梯度w.grad形状必须也是[4, 1]。 -
它是怎么算出来的?PyTorch 沿着刚才的路径倒推(链式法则)。它发现 w1 乘的是 x1,所以 w1 的梯度跟 x1 的数据有关。
-
关键理解:
grad就像是 w 的影子。w 长什么样,grad就长什么样。
-
第三阶段:参数更新(微调旋钮)
目标:修改 w 和 b。
-
代码:
w_0 -= w_0.grad * lr -
实质: 这是一个点对点的减法。
-
w0 (形状
[4, 1]) 减去 w0.grad (形状[4, 1])。 -
比如 w0 的第一个数是 8.0,对应的梯度是 0.1(意思是这变大导致了错误),学习率是 0.01。
-
新 w0=8.0−(0.1×0.01)=7.999。
-
总结你的困惑
“根据初始化w和b计算pre_y与y之间的loss”
是的,这是一个数据降维的过程(从矩阵 -> 向量 -> 一个标量)。
“然后根据梯度下降,调整w和b”
是的,这是一个形状匹配的过程。 虽然 loss 只是一个数,但因为 PyTorch 记住了它是怎么算出来的,所以它能“反向”分裂出和 w 一样形状的梯度矩阵,告诉每个权重参数该怎么变。
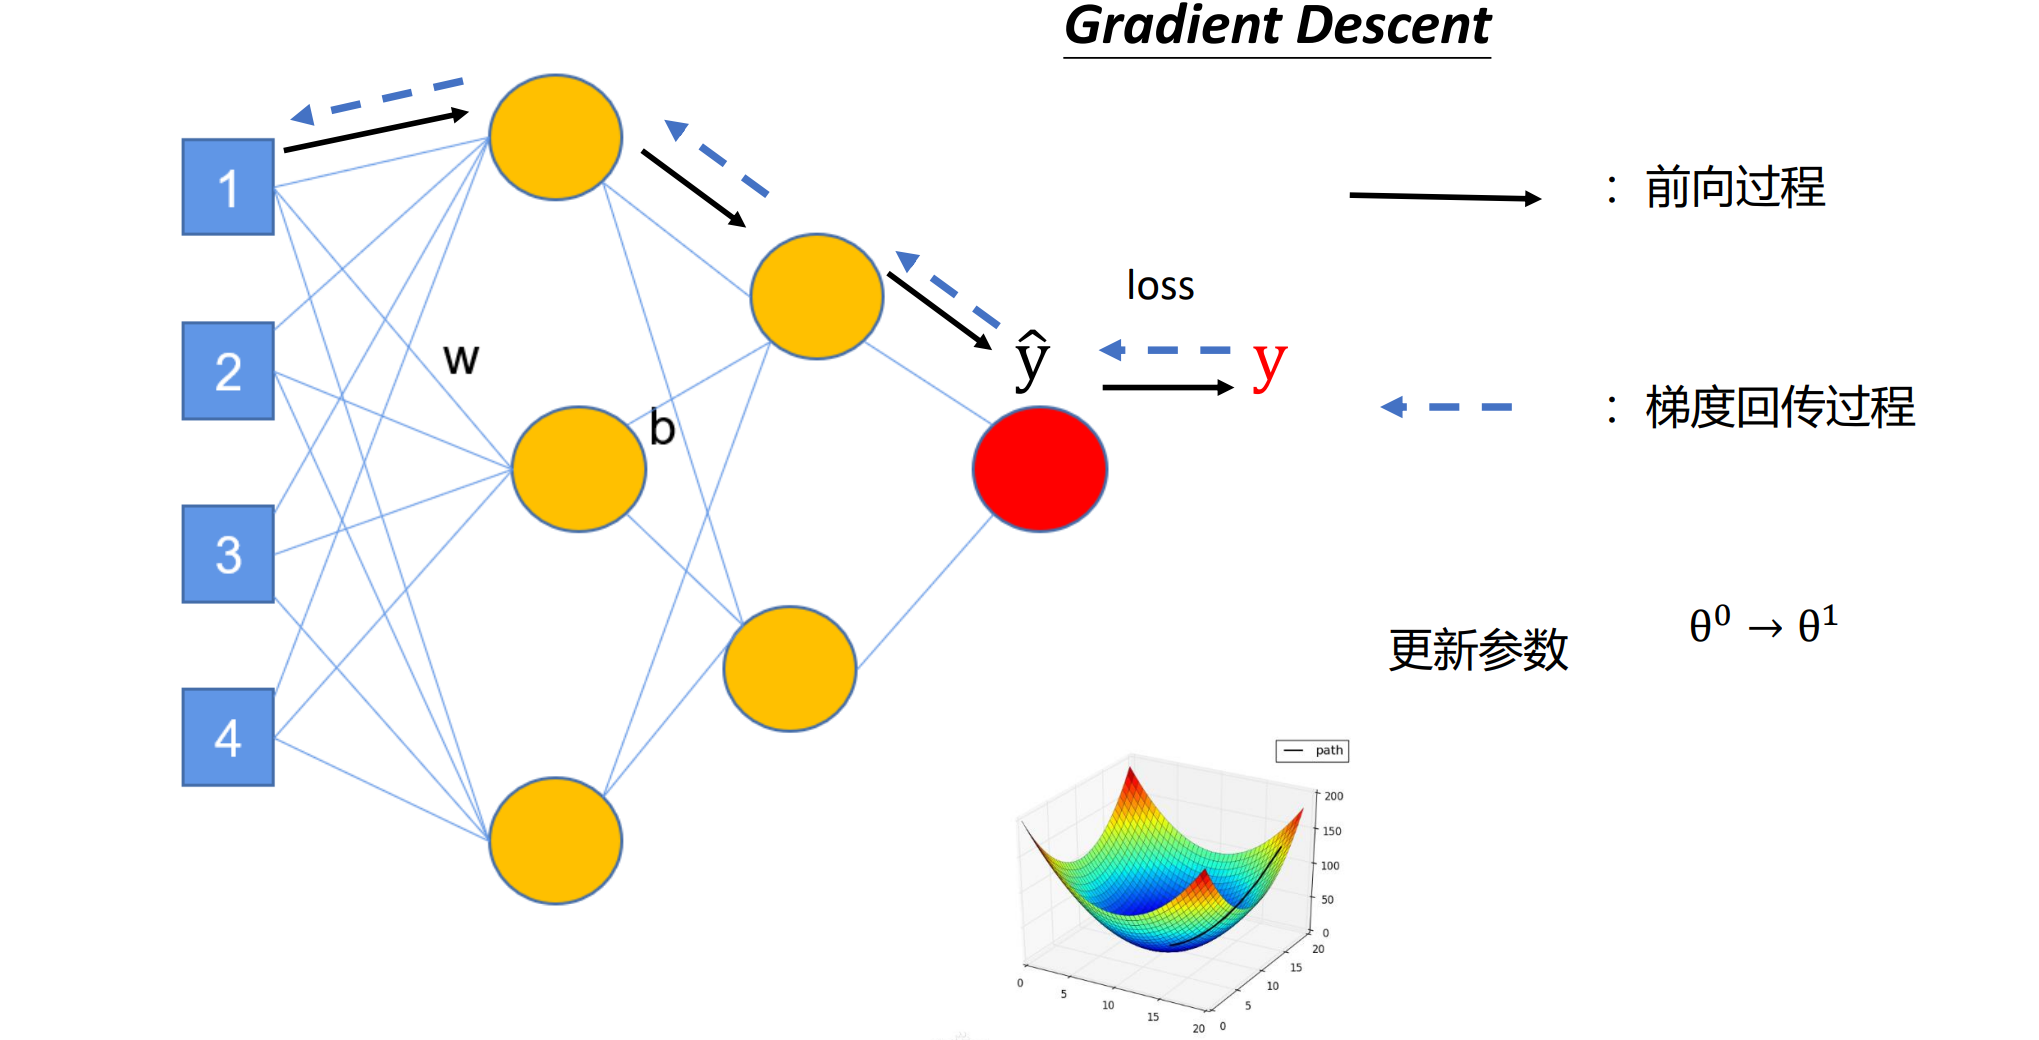
可视化建议: 你看 PDF 第 3 页的那张图 :
-
左边蓝色的方块是 X(输入)。
-
中间黄色的圆圈是 w(参数)。
-
最右边红色的圆圈是
loss。 -
前向传播是从左往右走到红球。
-
反向传播是从红球出发,沿着线回到黄球,告诉黄球该怎么变。
更多推荐


 26
 0
- 0


 已为社区贡献3条内容

所有评论(0)