
大模型第一期:10分钟让你完成机器学习入门
完成机器学习入门可以从以下方面进行:
目录
一、机器学习概念、术语
1、什么是机器学习,有什么作用
2、机器学习和人工智能、深度学习有什么关系
3、机器学习常用术语
二、机器学习算法类型
1、有监督学习
2、无监督学习
3、半监督学习
4、强化学习
三、算法详细介绍(入门)
1、KNN算法
2、线性回归
3、逻辑回归
4、决策树
5、集成学习
6、朴素贝叶斯
7、聚类算法
四、机器学习模型训练/建模流程
五、拟合效果评估
六、鸢尾花实战KNN
一、机器学习概念、术语
1、什么是机器学习,有什么作用
机器学习是实现人工智能的一种途径,让机器通过海量的“数据”学习规律,而不是依靠人类写死的规则。
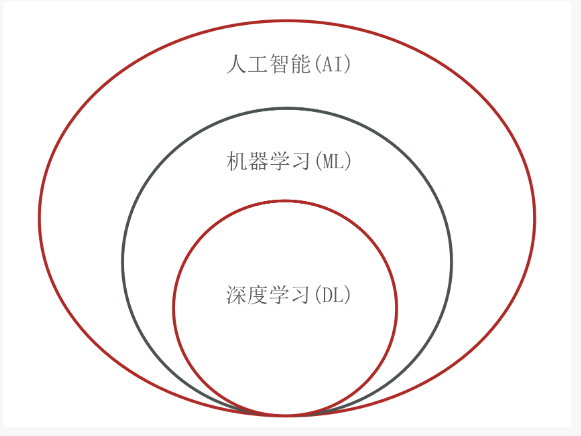
2、机器学习和人工智能、深度学习有什么关系
AI: 人工智能:模仿人类思维、行动
ML: 机器学习:是AI的一种途径,通过学习海量数据掌握特征
DL:深度学习:是机器学习的一种特殊算法,它不需要数据的特征和标签即可完成学习
简而言之,可以理解为三层嵌套,AI包括机器学习,深度学习是机器学习中特殊的一种分支。
3、机器学习常用术语
举例:我想要预测某地的房价,我使用了历史3年该市所有楼盘每月的房价数据(训练集),其中每个月每个楼盘的一条数据叫做一个样本,楼盘所有信息,包括时间叫做这个样本的(特征),房价是每个样本的(标签),如果我抽取训练集中几条数据作为验证模型训练结果的样本,这叫(验证集),如果模型训练完成后,我找了几条数据做测试,看预测的准不准,这叫(测试集)
1)样本:用于训练的每一条数据就叫一个样本
2)特征:一个样本的所有属性/能对样本结果产生影响的属性就叫做特征/属性
3)标签:在样本中模型训练想要预测的结果值
4)训练集:足够大、具有代表性训练样本数据
一般命名规则:
x_train 训练集特征命名
y_train 训练集标签命名
5)验证集:训练集和测试集之间,用于调整超参数或者选择最优模型的样本数据
一般可以怎么做验证集呢?
交叉验证:将训练集随机分成k份,轮流用k-1份训练,1份验证
留出法:在训练集中直接划10%-20%作为验证集
6)测试集:评估模型泛化能力:训练后检查模型举一反三的能力
一般命名规则:
x_test 测试集特征命名
y_test 测试集标签命名
二、机器学习算法类型
1、有监督学习:使用带标签的数据进行训练
代表算法:KNN、线性回归、逻辑回归、朴素贝叶斯、决策树、集成学习
可以做分类和回归任务,比如预测类别标签:垃圾邮件过滤、图像识别、医疗诊断等;预测连续数值:房价预测、天气预报、情感分析等
2、无监督学习:使用无标签数据训练
代表算法:聚类K-means算法、降维等
聚类:根据样本相似性自动分组:电商客户首次分类
降维:减少/合并样本特征数量、保留关键信息:数据可视化、图像压缩等
3、半监督学习:少量标签和大量无标签样本结合,这是目前最广泛的机器学习方式
为什么使用半监督?
因为现实中标签获取成本高,无标签数据多,监督学习依赖全标注数据,无监督学习无法利用标签学习,半监督学习结合两者优势,用少量标注+大量无标注数据伪标签训练模型,降低标注成本,提升数据利用率。
为什么引入伪标签?
伪标签是模型对无标签数据的预测结果,引入伪标签可以利用无标签数据结构信息迭代训练模型,若伪标签不准确会引入噪声导致模型泛化能力下降,因此需要专家验证伪标签可信度,仅将高精度伪标签加入训练集。
4、强化学习:代理通过与环境互动来学习最佳策略,并引入奖惩措施以学习最优策略
谨记:Agent代理+环境+奖惩+反馈
代表应用:无人驾驶、AlphaGo;通过试错和奖励措施使得模型能够自主学习。
三、算法详细介绍(入门)
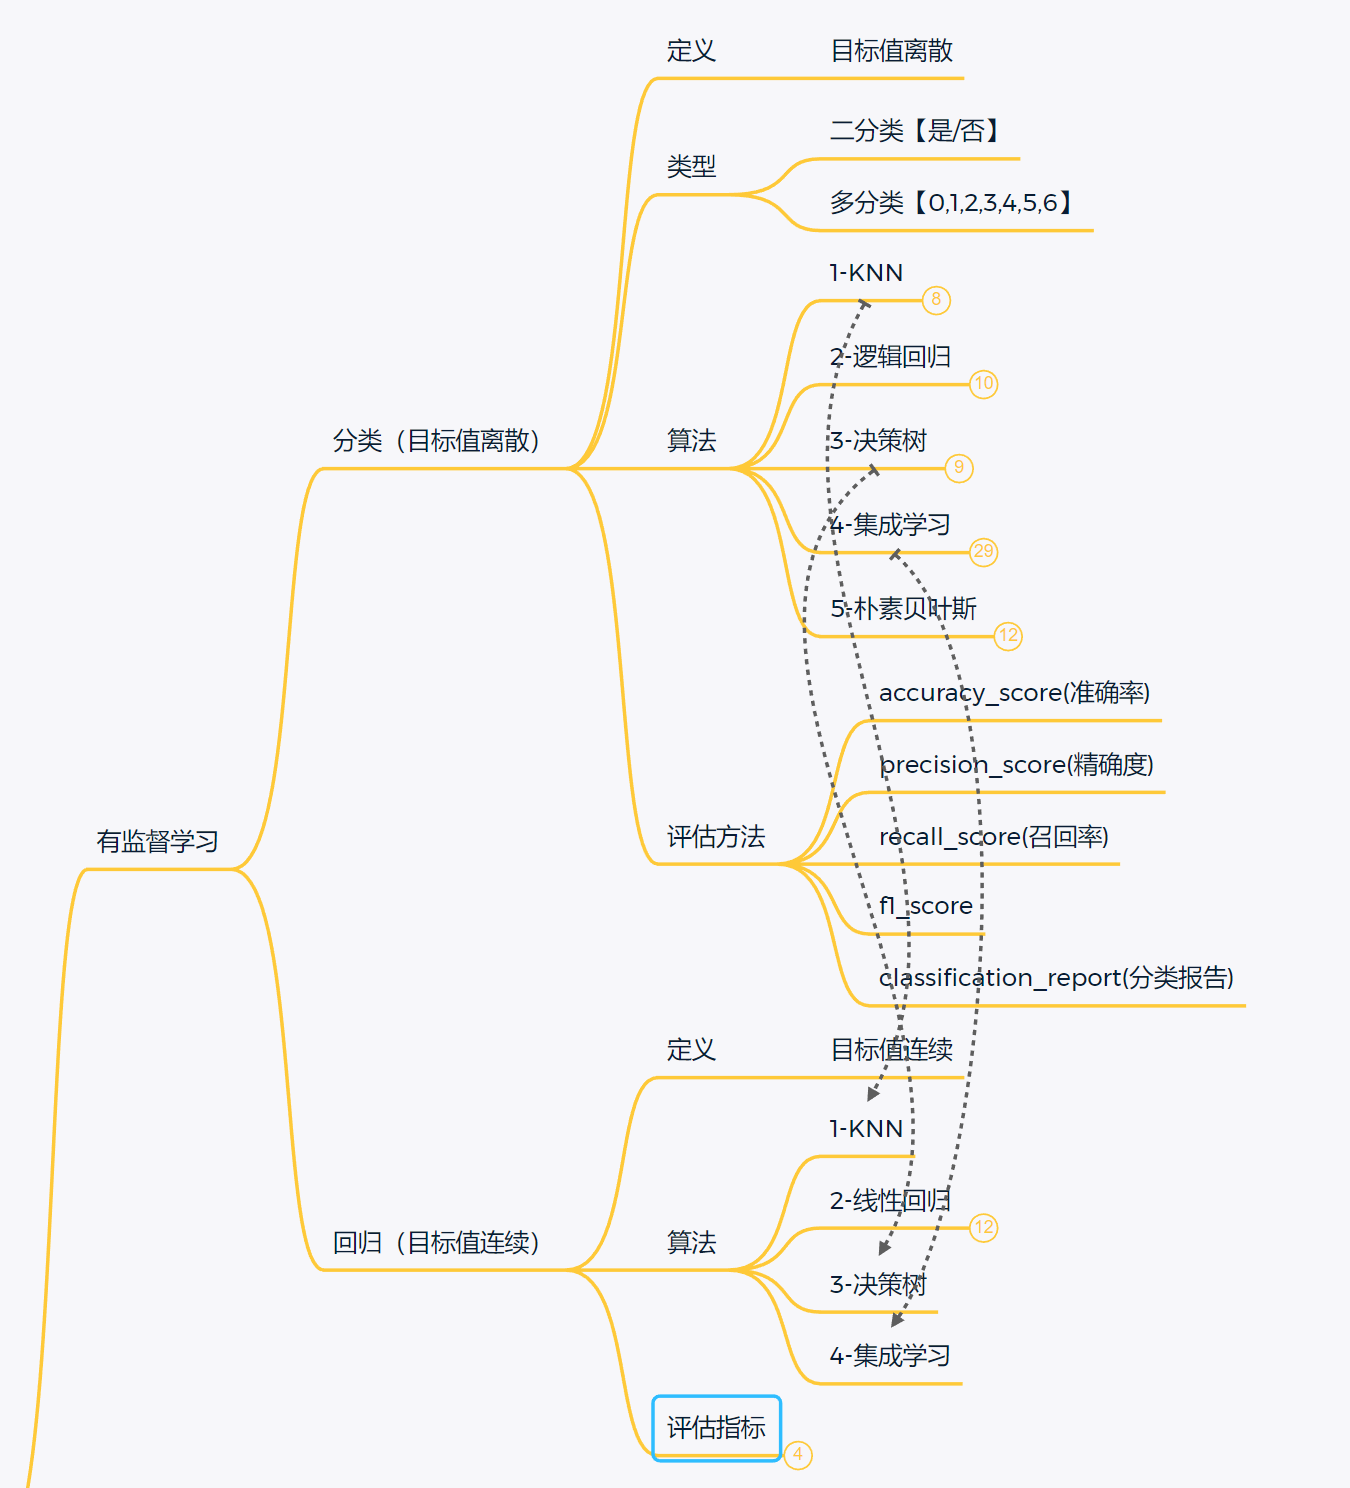
首先先画一张图看下算法之间的关系,在有监督学习中,除了线性回归只能做回归、逻辑回归只能做分类任务外,其他的都既做分类也可以做回归。挺奇怪的吧,一个回归算法只能做分类。
1、KNN算法(K Nearest Neighbor)
算法分类:有监督学习、分类、回归
算法思想:分类:距离预测目标最近的k个值大部分是什么分类,目标就是什么分类
回归:距离目标最近k个值的平均值
算法流程: 1.计算未知样本到每一个训练样本的距离
2.将训练样本根据距离大小升序排列
3.取出距离最近的 K 个训练样本
4.进行多数表决,统计 K 个样本中哪个类别的样本个数最多
5.将未知的样本归属到出现次数最多的类别/平均值
2、线性回归
算法分类:有监督学习、回归
算法思想:找到一条直线(线性方程)去拟合预测数据
3、逻辑回归算法
算法分类:有监督学习、分类
算法思想:在线性回归算出得分后,sigmoid函数把得分映射成0-1之间的概率,根据概率判断属于哪一类; sigmoid函数是激活函数,只需要知道它会将所有结果映射到0-1区间即可,此举能够消除量纲(极大极小异常值 )的影响。
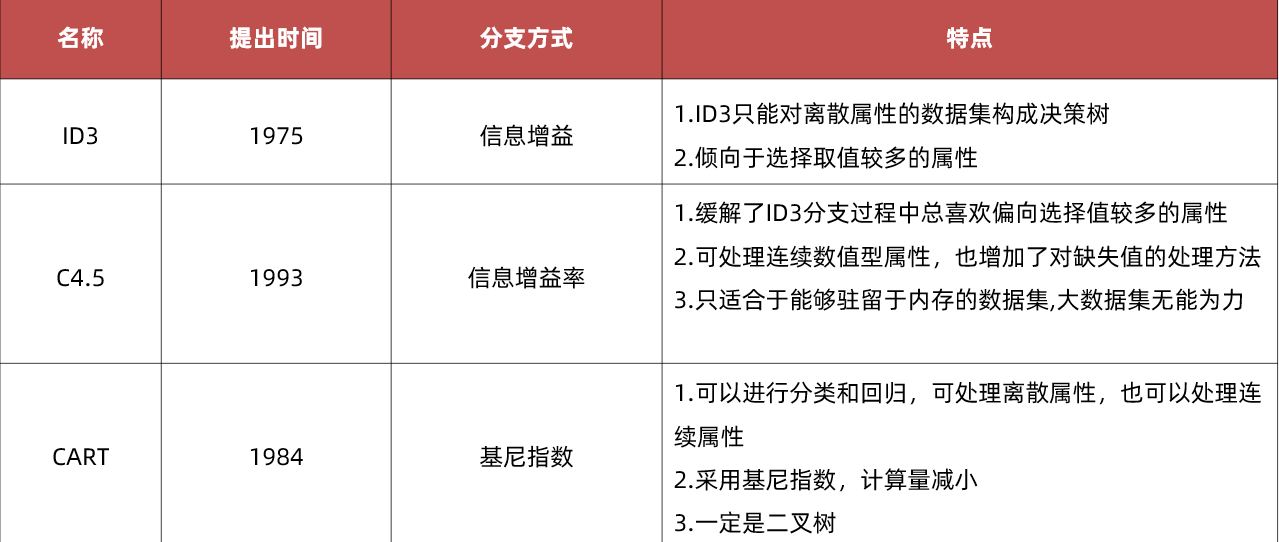
4、决策树算法
算法分类:有监督学习、分类 、回归
算法思想:树形结构+递归判断方式,只需要知道该算法逐层判断分类最终得出结果
5、集成学习算法
算法分类:有监督学习、分类 、回归
算法思想:把多个弱学习器组合起来,才形成一个精度更高的模型
代表思想:bagging装袋法:有放回抽样、平权投票、并行训练,代表随机森林算法
boosting提升法:无放回抽样、加权投票(对有修正错误的学习器增加权重)、串行训练(依赖前序学习器),代表GBDT\Adaboost\XGBoost\LightGBM
6、朴素贝叶斯算法
算法分类:有监督学习、分类
算法思想:利用概率值进行分类的一种机器学习算法
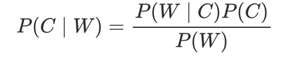
P(C) 表示 C 出现的概率,一般是目标值,先验概率
P(W | C) 表示 C 条件 W 出现的概率,条件概率
P(W) 表示 W 出现的概率
7、聚类算法
算法分类:无监督学习
算法思想:根据样本之间的相似性,将样本划分到不同的类别中;不同的相似度计算方法,会得到不同的聚类结果,常用的相似度计算方法有欧式距离法。
代表 K-means 算法:K:预先指定K的数量,means:每个簇的“质心”(簇内所有样本的平均值)
算法通过优化质心位置,最终让每个样本到其所属之心的举例最小化,从而实现相似样本的聚集
四、机器学习模型训练/建模流程
1、构建数据集
1)导入数据,我们需要对数据进行预处理,进行异常值检测、缺失值处理、数据清洗等操作;
如果缺失率高怎么办?无关重要的数据直接删除,重要的采用中位数填充或者让模型预测缺失值(半监督的伪标签)
2)切分数据集
将样本 数据拆分为 训练集、测试集(10%-20%),训练集可以在训练过程中留出部分验证集(留出法或者k折交叉验证方法);
2、构建模型
1)选择合适的算法模型,根据问题类型(回归/分类/聚类)选择(回归用线性回归,分类用逻辑回归等),设置学习率、决策树的深度、KNN的近邻数量等
3、特征工程,特征工程是一个巨大浩繁的工作,建议在真的接触到再好好研究。目前掌握入门理论即可
前面介绍了深度学习和机器学习的区别在于深度学习无需样本数据,其本质就在于深度学习不需要做特征工程;而特征工程在机器学习中的时间占比往往达到80%以上,一个好的特征工程决定了模型的上限。
特征工程五大模块:
1)特征提取:非结构化数据转结构化数据:文本转数字等
2)特征组合:多个特征组成新的特征,挖掘特征间的非线性关系
3)特征降维:减少特征维度,解决维度灾难
维度灾难就是“维度太多,样本太少”,模型会把噪声当作规律导致过拟合
4)特征选择:去除无关的特征或有干扰的特征
5)特征预处理:对提取后的特征做清洗和转换,统一各个特征的标准,比如归一化(0-1区间),标准化(-1,1)之间,编码等
4、模型训练
模型进行训练的过程,通过结果观察判断训练好坏。
5、模型预测
使用训练好的模型进行预测结果。
6、模型评估:
【重要】如何判断这种学习方式好坏呢?我们引入一些量化指标进行计算判断:
分类指标:
1)准确率:(TP + TN) / (TP + TN + FP + FN)
所有样本中,模型预测正确的比例。这是最直观的指标。详见下方混淆矩阵讲解
2)精确率:TP / (TP + FP)
所有预测为正例中,预测正确的比例
3)召回率:TP / (TP + FN)
所有样本中正例被预测正确的比例
4)F1-score:F1 = 2 × (精确率 × 召回率) / (精确率 + 召回率)
5)分类报告:就是统计各项指标的综合报告
以上也被称为混淆矩阵,也是深度学习中模型评估方法。
回归指标:
MSE(均方误差损失):(预测值-真实值)的平方和的平均值
MAE(平均绝对误差):(预测值-真实值)的绝对值之和的平均值
拟合效果评估
过拟合:
表现:模型在训练过程误差小,测试过程误差大;
原因:模型太复杂,学习到了样本的噪声
解决方案:增加真实样本数或者增强生成多样本,使用正则化技术惩罚模型噪声依赖,特征选择降维去除无关特征,决策树剪枝/使用简单模型,Droupout或早停法
欠拟合:
表现:模型在训练过程、测试过程误差都很大;
原因:模型太简单或者训练次数不够;
解决方案:增加特征数量、质量;选择更复杂的模型以便能够学习到规律;增加训练轮次;特征工程优化(特征选择去除冗余、降维、组合......),
正好拟合:
表现:模型在训练过程、测试过程误差都很小。
五、鸢尾花实战KNN
KNN算法实现鸢尾花案例
1:导入工具包
2:加载数据集并展示数据集
2.1: 加载数据集
2.2:展示数据集
3:特征工程(预处理-标准化)
3.1:数据集的划分
3.2:标准化
4:模型训练
4.1:实例化算法
4.2:调用fit方法训练
5:模型评估
6:模型预测
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
# 1:导入工具包
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.preprocessing import StandardScaler

# 2:加载数据集并展示数据集
#     2.1: 加载数据集
iris_data = load_iris()
# # 打印数据集的描述信息
# print("查看数据集的描述信息:", iris_data.data[:5])
# # 打印数据集的标签
# print("查看数据集的标签:", iris_data.target)
# # 打印数据集的标签名称
# print("查看数据集的标签名称:", iris_data.target_names)
# 打印数据集的属性名称
print("查看数据集的属性名称:", iris_data.feature_names)
# # 打印数据集的描述信息
# print("查看数据集的描述信息:", iris_data.DESCR)
#     2.2:展示数据集
# iris_df = pd.DataFrame(iris_data['data'], columns=iris_data.feature_names)
# iris_df['label'] = iris_data.target
# sns.lmplot(x="sepal length (cm)", y="sepal width (cm)", data=iris_df, hue="label", fit_reg=False)
# plt.show()

# 3:特征工程(预处理-标准化)
#     3.1:数据集的划分
x_train, x_test, y_train, y_test = train_test_split(iris_data.data, iris_data.target, test_size=0.3, random_state=22)
print("总的数据集大小:", len(iris_data.data))
print("训练集大小:", len(x_train))
print("测试集大小:", len(x_test))
#     3.2:标准化
# 实例化标准化对象
preprocess = StandardScaler()
# 对训练集进行标准化(消除量纲影响)
x_train = preprocess.fit_transform(x_train)
# 对测试集进行标准化(消除量纲影响)
x_test = preprocess.transform(x_test)

# 4:模型训练
#     4.1:实例化算法
model = KNeighborsClassifier(n_neighbors=3)
#     4.2:调用fit方法训练
model.fit(x_train, y_train)

# 5:模型评估
myscore = model.score(x_test, y_test)
print("模型评估的准确率:", myscore)
print('通过模型查看分类类别-->', model.classes_)

# 6:模型预测
x = [[5.1, 3.5, 1.4, 0.2]]
# 对新样本进行标准化(消除量纲影响)
x = preprocess.transform(x)
# 进行模型预测
result = model.predict(x)
print("预测结果:", result)
更多推荐



 10
 0
- 0


 已为社区贡献4条内容

所有评论(0)