
腾讯开源 | 架构与策略双重演进,开源音乐大模型 SongGeneration 2 发布
01 引言:突破开源音乐生成的技术瓶颈
在AI音乐生成领域,开源生态虽然发展迅速,但始终面临着两个核心痛点:音乐性差(旋律僵硬、编曲缺乏层次)以及歌词的准确性不足(容易出现发音含糊、吐字幻觉)。
今天,腾讯和清华大学人机语音交互实验室联合研发的音乐基础模型 SongGeneration 2正式推出。其核心优越性在于对底层架构和训练策略的全面升级,这赋予了 SongGeneration 2突破性的三大优势:
● 高音乐性:不仅旋律优美连贯,更能处理复杂的多轨编曲与空间层次。
● 高歌词准确性:大幅降低幻觉,实现清晰、准确的多语种咬字跟唱。
● 优秀的可控能力:精准遵循文本描述、音频提示等多种指令,深度控制音乐风格。
02 SOTA 性能:多维严苛评估,实现商业级跨越
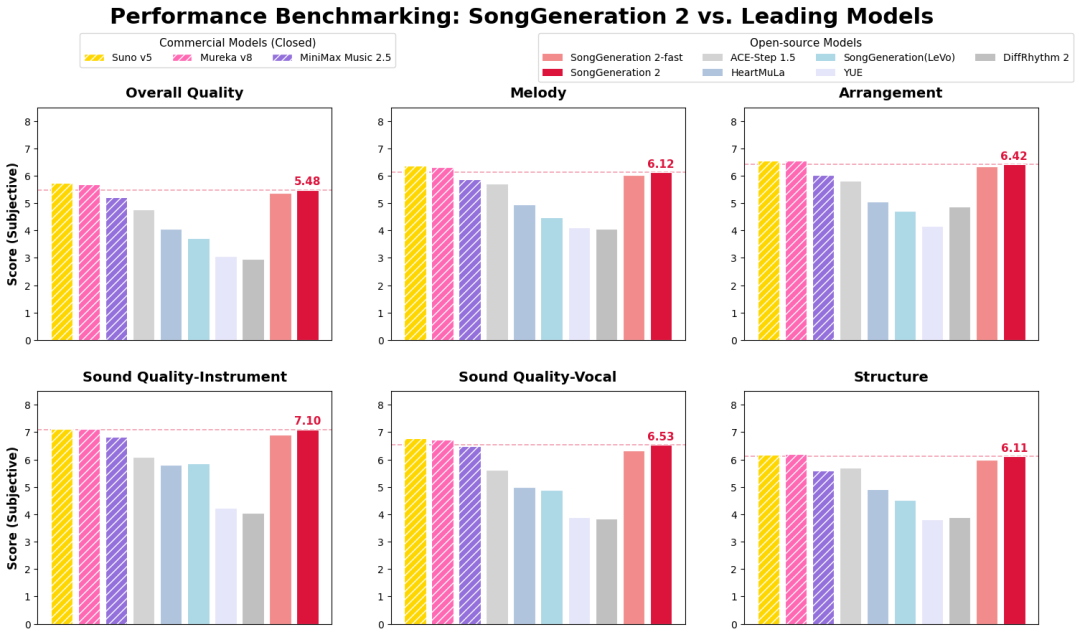
为了全面验证 SongGeneration 2的生成能力,我们组织了包含20位音乐专业人士的大规模盲测评估,从6个核心维度对3个顶尖的商业模型和6个顶尖的开源模型(各生成100首歌曲)进行了深度打分。评估维度全面覆盖:整体质量(Overall Quality)、旋律(Melody)、编曲 (Arrangement)、乐器音质(Sound Quality-Instrument)、人声音质(Sound Quality-Vocal)以及结构(Structure)。
● 全面超越开源基线:在上述所有6个评价维度中,SongGeneration 2均呈现出断崖式领先,显著超越了包括 ACE-Step 1.5、HeartMula、YUE、LeVo以及DiffRhythm 2在内的所有主流开源模型 。
● 主观听感媲美商业闭源系统:实验数据显示,SongGeneration 2 的整体生成质量已成功对齐商业级能力。在整体质量、旋律、编曲等多个维度上,SongGeneration 2 的表现甚至超过了MiniMax 2.5。
● 极致的文本指令对齐:除了质量与旋律的提升,评估还证明了模型具有出色的歌词遵循能力。SongGeneration 2的音素错误率(PER)仅为8.55%,仅次于MiniMax 2.5 (7.8%),显著优于顶尖商业模型Suno v5 (12.4%)和 Mureka v8 (9.96%),并在曲风、情绪、乐器三大维度的控制上逼近了商业顶级水平。
03 样本演示:遵循文本描述的高保真呈现
依托于架构与策略的升级,SongGeneration 2能够按照文本提示和歌词生成动听的音乐:
🎵 Demo 01:摇滚
输入指令:rock, motivational, electric guitar, bass guitar, drum kit
🎵 Demo 02:古风
输入指令:gufeng, rock, heartbroken, guzheng, electric guitar, percussion
🎵 Demo 03:POP
输入指令:synth-pop, sweet, synthesizer, drum machine, bass, backing vocals
🎵 Demo 04:爵士
输入指令:jazz, relaxed, piano, brass,drum kit
🎵 Demo 05:R&B
输入指令:r&b,laid-back, electric piano, bass guitar, drum machine,synthesizer
🎵 Demo 06:电子
输入指令:electronic, hype, 808 bass, drum machine, sampler
04 技术架构:混合式 LLM-扩散与分层表征建模
SongGeneration 2 高音乐性与高保真音质的基石,源于其独特的混合式 LLM-扩散架构 :
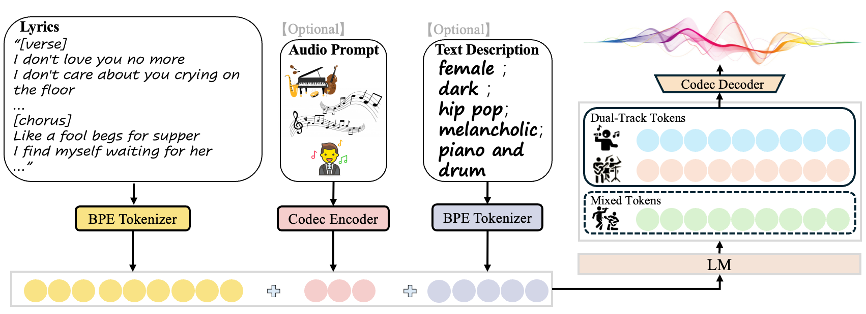
● “双核”分工协作:语言模型(LeLM)作为“作曲大脑”,负责统筹全局的音乐结构与演奏细节(解决如何演唱与演奏的问题);而扩散模型(Diffusion)则担任“高保真渲染器”,在语言模型的隐式指导下,合成极其复杂的声学细节 。
● 首创分层表征结构:为了兼顾音乐性、稳定性与音质,语言模型采用了并行建模的设计 :
○ 混合表征(Mixed Tokens):用于指导模型捕捉高层级的旋律、结构等核心语义信息 。
○ 多轨表征(Dual-Track Tokens):分别代表人声和伴奏轨道,在语义信息的基础上进一步确定不同轨道局部的细粒度声学变化 。
05 训练策略:自动化美学评估与多阶段渐进式后训练
为了彻底攻克开源模型“音乐性差”和“歌词幻觉”的两大痼疾,SongGeneration 2的训练策略并未停留在简单的数据堆料,而是进行了系统性的深度演进:
1. 暴力与精细并重的数据 Scaling
● 规模跃升:模型参数从2B扩展至4B,极大提升了对各种风格及歌词的控制稳定性 。
● 高效数据工程:利用SongPrep端到端模型精准解析歌曲结构与歌词,并借助Gemini 2.5完成高质量的歌曲描述标注,实现了高效、高精度的自动化训练数据管线。
● 解锁纯音乐建模:针对性地引入纯音乐训练数据,不仅赋予了模型纯音乐生成的能力,更大幅提升了对背景音乐的建模质感 。
2. 构建行业级自动化音乐美学评估框架
● 领域最大专家标注集:我们构建了包含11,717个样本的数据集(样本均由各顶尖模型生成并确保风格多样化)。该数据集由专业人士围绕人声音质、乐器音质、旋律设计、结构布局、编曲手法、混音处理及音乐性这七大核心维度进行了深度标注 。
● 闭环指导:基于此数据集训练的细粒度自动化音乐美学评估框架,在片段和整曲层面均与专家评分呈现高度相关性,这为后续的模型训练注入了至关重要的“音乐性先验知识” 。在推理阶段,我们还引入了基于音乐性标签的CFG策略,进一步拔高了生成结果的音乐性 。
3. 多阶段渐进式后训练
我们创新性地引入了“SFT -> 大规模离线 DPO -> 半在线 DPO”的多阶段渐进式后训练链路,层层递进地解决可控性、稳定性和音乐性的问题 :
● 第一阶段:监督微调 (SFT)。基于美学评估结果,按照固定比例从不同风格中挑选高质量歌曲进行SFT,从而收窄数据分布,构建坚实的高质量生成底座 。
● 第二阶段:大规模离线 DPO(解决歌词幻觉)。我们设定了极其苛刻的筛选条件:正例必须在“歌词准确度”和“可控性”上优于负例,且“音乐性”不能下降。为了获取足够的有效数据,我们利用低成本的离线强化学习生成了300万首数据,最终提炼出约20万对高质量正负样本。这一阶段成功解决了歌词幻觉问题,赋予了模型极高的稳定性,并极大提升了后续的训练效率。
● 第三阶段:半在线DPO(极致突破音乐性)。在确保歌词准确率和可控性不出现明显下降的前提下,我们将重点转向“音乐性”的拉升。模型会周期性地更新,并根据音乐性美学评分挑选正负例进行对齐,在保证稳定性的同时,实现了音乐性的极致突破。
06 开源计划与体验链接
目前,包含4B参数的SongGeneration-v2-large模型已正式开源 。它支持中英文等多语种生成,并通过文本描述、音频提示和风格预设提供多样化的控制方式。该模型可在配备22GB显存的消费级硬件上本地流畅运行,实现约0.82的RTF。为了实现即时体验,我们同步在HuggingFace Space平台提供SongGeneration-v2-Fast版本,该版本牺牲了一定的音质但换来了较快的生成速度 (可以在一分钟内生成一首完整歌曲)。
未来,我们将推出支持12G显存、RTF约为0.69的Medium 模型,并逐步开源自动化评估框架等核心组件。
模型链接直达:
● Github 仓库:
https://github.com/tencent-ailab/SongGeneration
● Hugging Face Space在线体验:
https://huggingface.co/spaces/tencent/SongGeneration
有奖调研🎁
希望“腾讯开源”的内容更对您胃口?点击参与 3 分钟小调研(仅 6 题),抽现金红包!
关注腾讯开源公众号
获取更多最新腾讯官方开源信息!
更多推荐



 0
 0
- 0


 已为社区贡献4条内容

所有评论(0)