
深度学习篇学习回顾与心得2(神经网络搭建,损失函数,梯度优化方法)
基础神经网络结构的搭建和参数计算
重点掌握
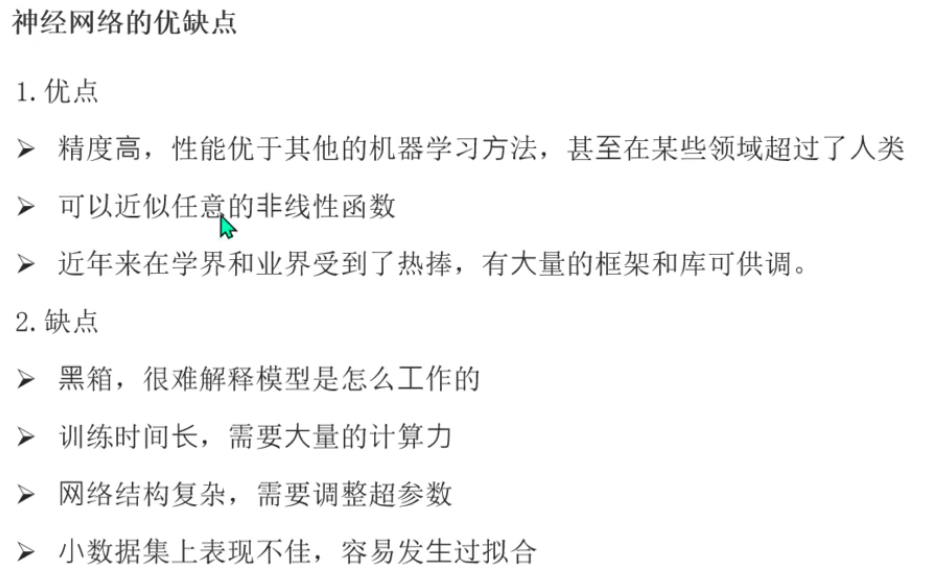
在pytorch中定义深度神经网络其实就是层堆叠的过程 ,继承自 nn.Module 实现两个方法:
- 在
__init__方法中定义网络中的层结构 ,主要是全连接层 ,并进行初始化 forward(前向传播)方法 ,在实例化模型的时候 ,底层会自动调用该函数 ,该函数中为初始化定义的 layer 传入数据 ,实现前向传播 等
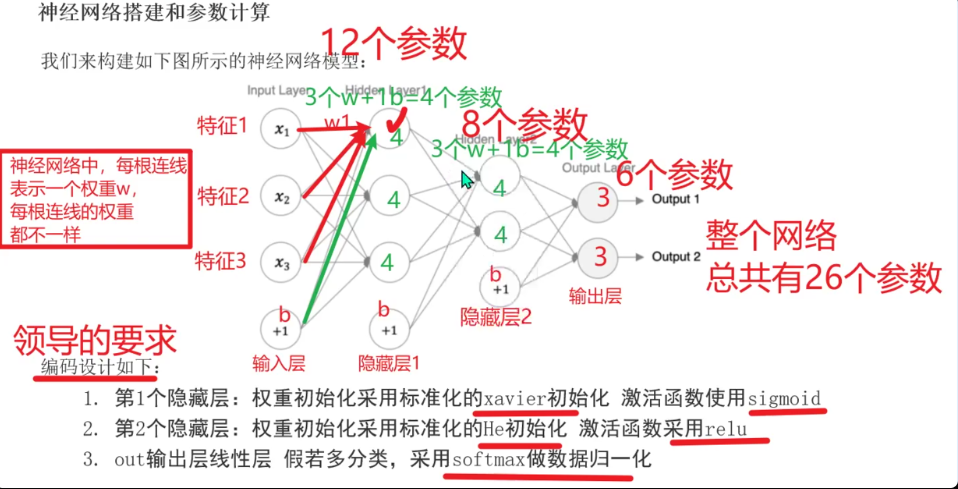
搭建神经网络的步骤:
1- 定义一个类,继承自torch.nn.Module
2- 实现两个方法:
2.1- _ init _ _:初始化方法。负责的工作内容如下:
a、初始化父类
b、设置属性值
c、定义神经网络结构:隐藏层有几层、输出层是怎样的等
d、参数初始化:w、b如何进行初始化
2.2 - forward:前向传播。将数据送入到搭建好的网络模型中,对模型进行训练,也就是前向传播的过程
损失函数
用来衡量模型参数质量的函数 ,衡量方式是比较网络输出( 预测值 ) 和 真实输出( 真实值 )
模型通过最小化损失函数的值 ,来调整参数 ,使其输出更接近真实值
重点: 多分类: CrossEntropyLoss
二分类: BCELoss Binary
回归: L1 ,L2 ,SmoothL1
多分类任务损失函数
loss=nn.CrossEntropyLoss()
如果使用CrossEntropyLoss() ,那么在输出层可以不用调用Softmax ,因为CrossEntropyLoss中自动调用Softmax
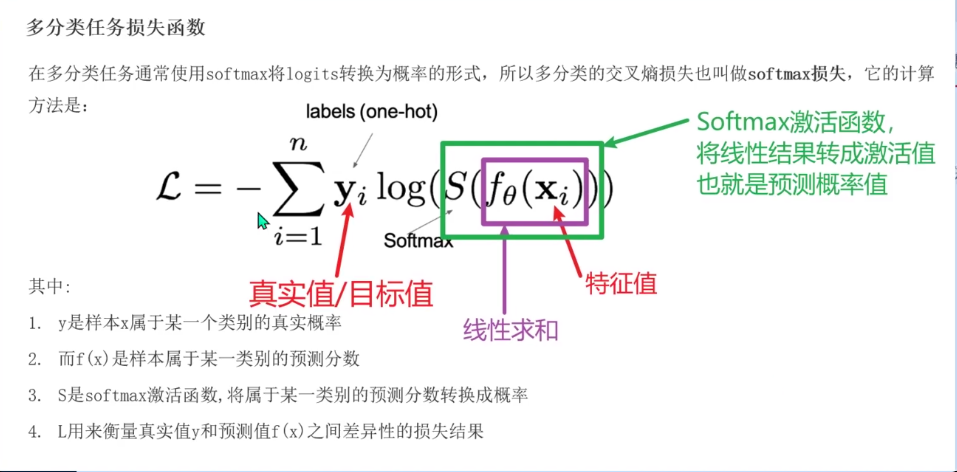
为什么带负号 ,因为log(底数是大于1的) 的图像是递增的 ,而衡量损失函数有优劣的标准是最小化损失函数 ,所以加个负号让log函数递减 ,方便衡量模型的拟合程度
二分类任务损失函数
loss=nn.BCELoss()
my_loss=loss(y_pred,y_true)
二分类任务中不再使用Softmax ,而是使用sigmoid ,那么损失函数也相应的进行调整
该公式与逻辑回归公式极其相似(完全一样)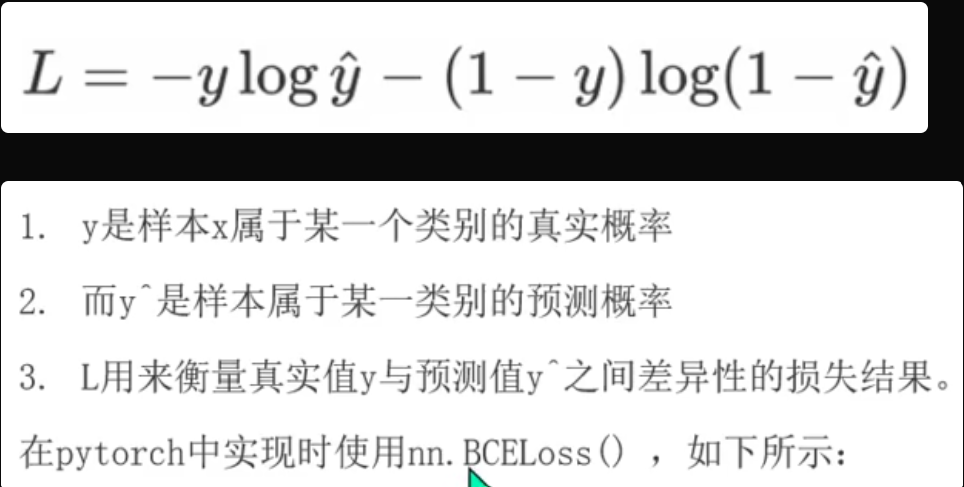
不需要掌握 ,实际工作中直接用CrossEntropyLoss即可
回归任务损失函数
- MAE损失函数 ( L1 Loss )
- loss=nn.L1Loss()
以绝对误差作为距离
- MSE损失函数( L2 Loss )
- loss=nn.MSELoss()
以绝对误差平方和作为距离
- Smooth L1损失函数
- loss=nn.SmoothL1Loss()
分段函数综合了L1 L2损失函数
一些神经网络训练的基本概念
三个基础概念:
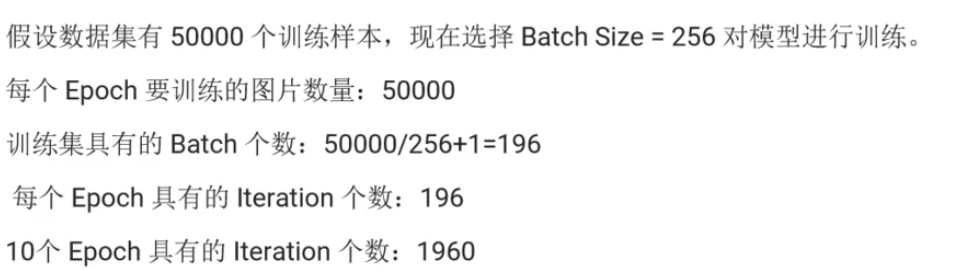
- Epoch : 对全部数据反复重复训练的轮次
- Batch_size : 每轮训练每批次样本的数量
- Iteration : 对于某一轮的全部数据 ,按批次训练完全部数据所需要的次数
具体了解见pytorch框架模拟线性回归代码
- 反向传播( BP算法 ) back propagation
- 反向传播利用链式法则对神经网络中的各个节点的权重进行更新
利用损失函数 error 值 ,从后往前 ,结合梯度下降算法 ,依次求各个参数的偏导 ,并进行参数(w和b)更新
w新=w旧-学习率*梯度(损失函数的导数值)
前向传播: 训练网络模型, 得到预测结果
反向传播: 更新权重w和偏置b,使模型拟合效果更好
梯度下降优化方法
当我们使用梯度下降算法优化权重参数时 ,可能会碰到以下情况:
- 碰到平缓区域 ,梯度值较小 ,参数优化变慢
- 碰到鞍点 ,梯度为0 ,参数无法优化(梯度消失)
- 碰到局部最小值 ,参数不是最优
这就是我们使用梯度下降算法时的一些痛点:
这时我们就可以通过一些方法对学习率 ,梯度值进行优化
常见优化方法如下
- Momentum 只优化梯度值
- RMSProp 只优化学习率
- AdaGrad 只有花学习率
- Adam 同时优化学习率和梯度值
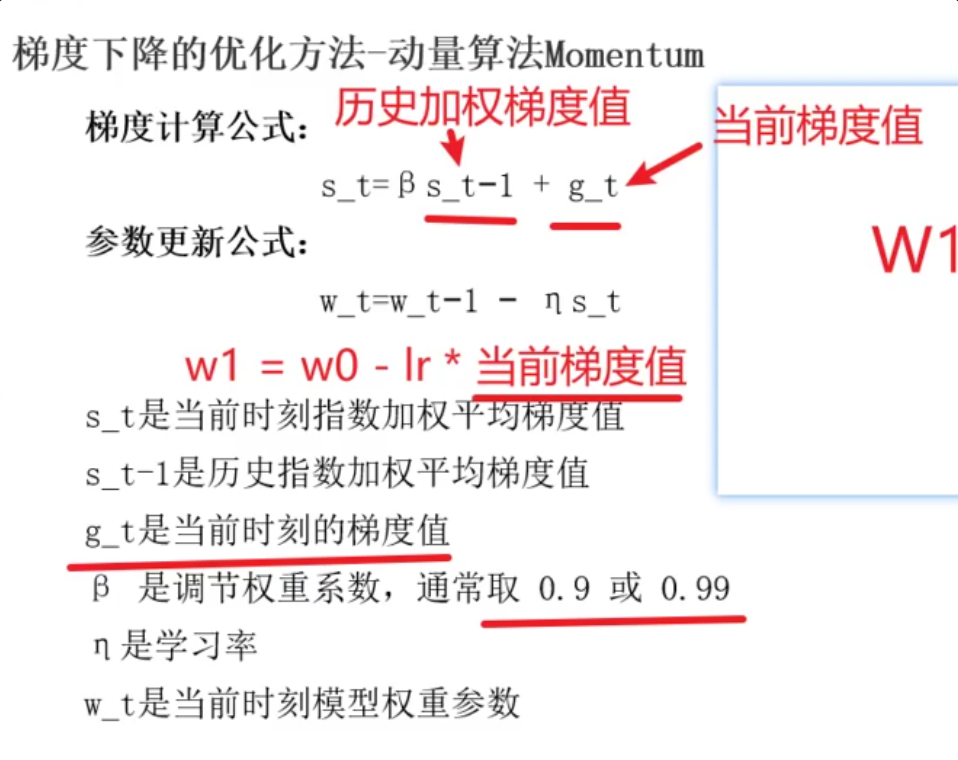
Momentum动量法
optimizer 汉译:优化器 SGD 是随机梯度下降
optimizer=torch.optim.SGD( params=[w],lr=0.01,Momentum=0.9 )
只优化梯度
一定程度上缓解 平缓 鞍点 问题
AdaGrad
optimizer=torch.optim.Adagrad( params=[w],lr=0.01 )
只优化学习率
通过对不同参数分量使用不同的学习率 ,AdaGrad学习率总体会逐渐减小
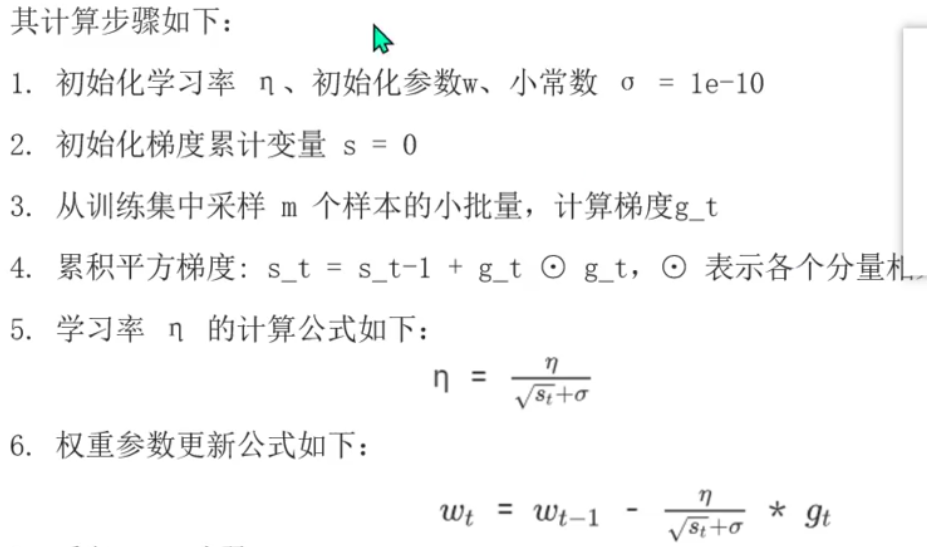
AdaGrad 缺点可能使得学习率过早过量的降低 ,导致模型训练后期学习率太小 ,较难找到最优解
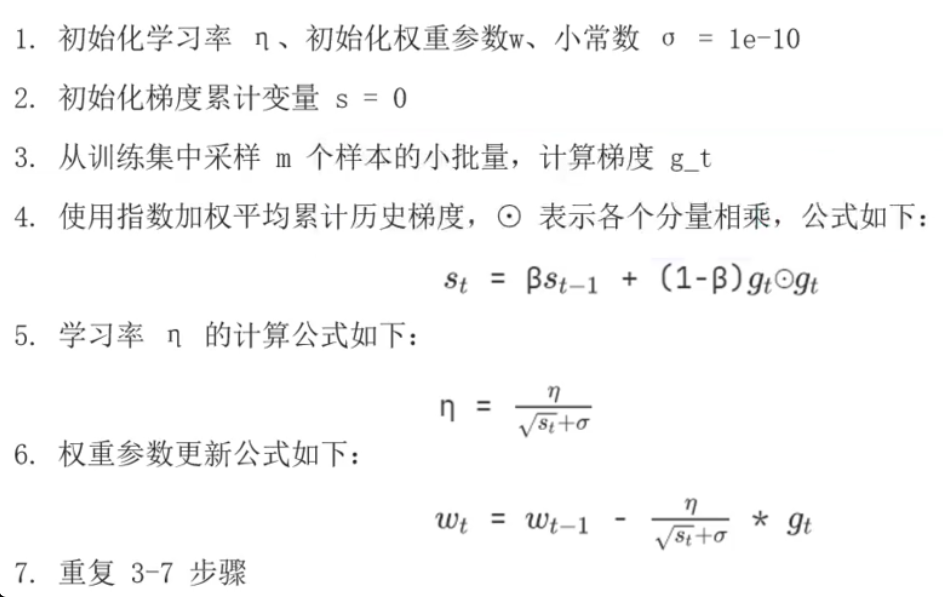
RMSProp
optimizer=torch.optim.RMSProp( [w],lr=0.01,alpha=0.9 )
只优化学习率
是对AdaGrad的优化 ,最主要的不同是 ,其使用指数加权平均梯度替换历史梯度的平方和
Adam
optimizer=torch.optim.Adam( [w],lr=0.01,betas=[0.9,0.99] )
同时优化梯度和学习率 ,推荐首选使用
将Momentum 和 RMSProp 算法结合在一起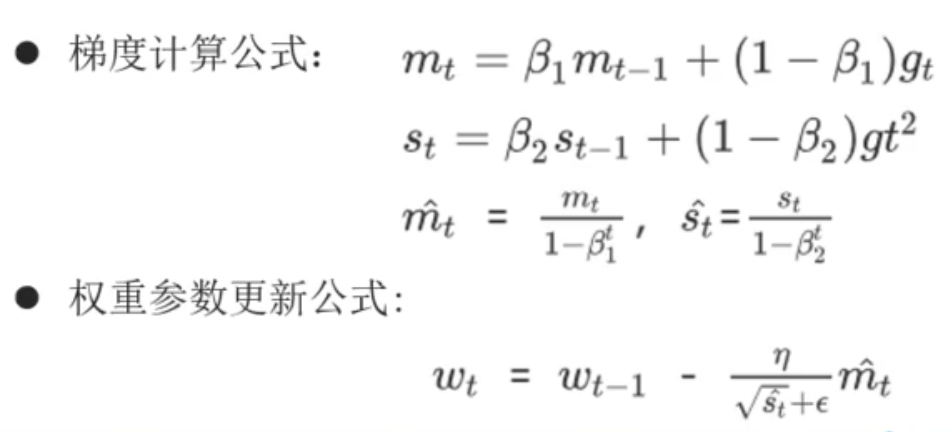
`
此处为分割优化方法处,上面的部分是自动优化学习率 ,下面的是手动优化学习率
学习率衰减优化方法(理解)
痛点: 在训练神经网络时 ,一般情况下学习率都会随着训练而变化 ,主要由于训练后期, 如果学习率过大 ,会造成梯度震荡 ,学习率过小 ,又会造成收敛变慢
-
等间隔学习率衰减
-
scheduler_lr=lr_scheduler.StepLR(optimizer,step_size=50,gamma=0.5)
-
指定间隔学习率衰减
-
scheduler_lr=optim.lr_scheduler.MultiStepLR(optimizer,milestones=[70,60,50],gamma=0.5)
-
指数学习率衰减
-
scheduler_lr=optim.lr_scheduler.ExponentialLR(optimizer,gamma=0.5)
正则化方法
神经网络中模型参数较多 ,在数据量不足的情况下 ,很容易过拟合
Dropout(随机失活)(掌握)
dropout=nn.Dropout(p=0.4)
model.train() 设置为训练模式
训练过程( 训练模式: model.train(): 允许神经元失活 )中 ,让神经元以超参数 p 的概率停止工作或者激活被置为0 ,未被置为0 ( 未失活的神经元 )的进行缩放 ,缩放比例为 1/(1-p)
model.eval() 设置为测试模式
测试过程( 测试模式: model.eval(): 不允许神经元失活 )中 ,随机失活不起作用
BN(批量统一化)(了解)
m=nn.BatchNorm2d(2,eps=1e-05,momentum=0.1,affine=True)
先对数据标准化 ,在对数据重构(缩放+平移)
更多推荐


 6
 0
- 0


 已为社区贡献4条内容

所有评论(0)