
SkillsBot上机器学习12个 Skill必装的技能
🧠 机器学习 Skill 技能说明书
数据来源:SkillsBot AI 技能库 - 机器学习分类
采集时间:2026-03-14
本文档整理了机器学习分类第一页共 13 个 Skill 技能,供参考选用。
页面截图
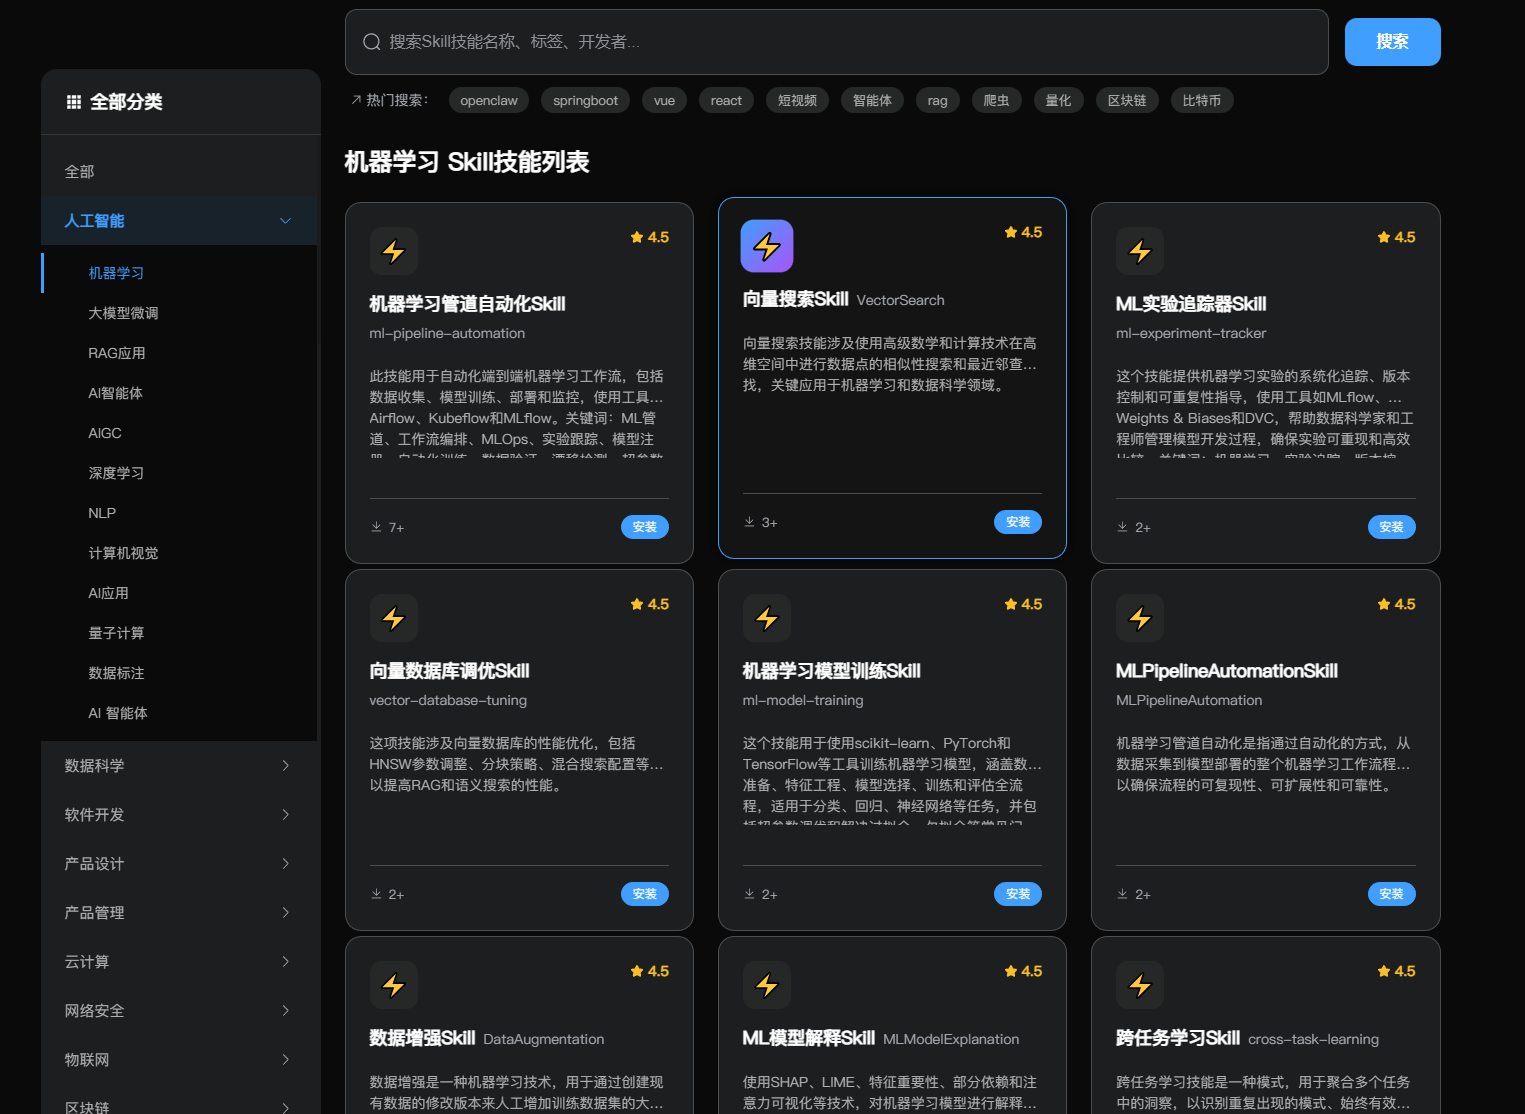
技能速览
| # | Skill 名称 | 功能描述 | 痛点解决 | 下载地址 |
|---|---|---|---|---|
| 1 | 机器学习管道自动化 | 自动化端到端机器学习工作流,涵盖数据收集、模型训练、部署和监控,集成 Airflow、Kubeflow、MLflow | 手动管理 ML 多阶段流程耗时费力、缺乏一致性与可重现性 | 详情页 |
| 2 | 向量搜索 | 使用高级数学技术在高维空间进行数据点相似性搜索和最近邻查找 | 传统关键词搜索无法理解语义,ML 场景下相似内容检索准确率低 | 详情页 |
| 3 | ML 实验追踪器 | 提供 ML 实验的系统化追踪、版本控制和可重复性指导,集成 MLflow、W&B、DVC | 实验结果散乱无序,难以复现和高效比较不同模型版本 | 详情页 |
| 4 | 向量数据库调优 | 向量数据库性能优化,含 HNSW 参数调整、分块策略、混合搜索配置 | RAG 和语义搜索性能差,向量检索延迟高、精度不足 | 详情页 |
| 5 | 机器学习模型训练 | 使用 scikit-learn、PyTorch、TensorFlow 训练 ML 模型,涵盖数据准备到评估全流程 | 新手难以系统掌握从数据预处理到模型评估的完整 ML 训练流程 | 详情页 |
| 6 | MLPipelineAutomation | 自动化方式实现数据采集到模型部署的完整机器学习工作流,保障流程可复现、可扩展、可靠 | ML 工作流缺乏标准化自动化框架,流程不可靠、难以扩展 | 详情页 |
| 7 | 数据增强 | 机器学习数据增强技术,涵盖图像、文本、音频、表格数据,包含几何变换、同义词替换等方法 | 训练数据不足导致模型泛化能力差、容易过拟合 | 详情页 |
| 8 | ML 模型解释 | 使用 SHAP、LIME、特征重要性等技术解释 ML 模型,提高透明度和可解释性 | ML 模型黑盒化严重,无法理解决策逻辑,难以调试和获取可操作洞察 | 详情页 |
| 9 | 跨任务学习 | 聚合多任务洞察,识别重复模式和有效策略,促进数据驱动的 AI 进化 | AI 系统缺乏跨任务经验积累与迁移能力,每次任务都从零开始 | 详情页 |
| 10 | Rust 机器学习领域技能 | 使用 Rust 构建和部署高性能 ML/AI 应用,涵盖 GPU 加速、ONNX、推理优化 | Python 生态 ML 部署性能不足,缺乏高效的 Rust ML 框架使用指导 | 详情页 |
| 11 | Optuna 超参数调优器 | 基于 Optuna 的自动化超参数优化工具,支持 TPE、CMA-ES、多目标优化和可视化分析 | 手动调参效率极低,缺乏智能搜索策略,难以找到全局最优超参数组合 | 详情页 |
| 12 | GPU 性能基准测试 | 自动化 GPU 性能基准测试和回归检测,测量内核执行时间、分析功耗和热特性 | GPU 性能难以量化评估,CI/CD 中无法自动检测性能回归问题 | 详情页 |
技能详细说明
1. 机器学习管道自动化
| 属性 | 内容 |
|---|---|
| Skill ID | ml-pipeline-automation |
| 评分 | ⚡ 4.5 |
| 安装量 | 7+ |
| 下载地址 | https://www.skillsbot.cn/skill/6671 |
功能描述
自动化端到端机器学习工作流,包括数据收集、模型训练、部署和监控,使用工具如 Airflow、Kubeflow 和 MLflow。支持 ML 管道编排、实验跟踪、模型注册、自动化训练、数据验证、漂移检测、超参数调优和容器化 ML。
痛点解决
ML 工程师手动管理数据采集→训练→部署→监控的复杂多阶段流程耗费大量时间,且难以保障可重现性和一致性。本技能通过 MLOps 工具链自动化整个流程,大幅提升 ML 项目的交付效率。
适用场景:MLOps 工程、企业级 ML 流水线、模型生命周期管理
2. 向量搜索
| 属性 | 内容 |
|---|---|
| Skill ID | VectorSearch |
| 评分 | ⚡ 4.5 |
| 安装量 | 3+ |
| 下载地址 | https://www.skillsbot.cn/skill/5492 |
功能描述
使用高级数学和计算技术在高维空间中进行数据点的相似性搜索和最近邻查找,关键应用于机器学习和数据科学领域,为语义理解和内容发现提供基础能力。
痛点解决
传统关键词搜索无法理解语义,在推荐系统、RAG 知识库、图像检索等场景中准确率低。本技能提供向量级相似性搜索能力,解决语义匹配和相似内容发现的核心需求。
适用场景:RAG 应用、推荐系统、知识库语义搜索、图像/文档相似检索
3. ML 实验追踪器
| 属性 | 内容 |
|---|---|
| Skill ID | ml-experiment-tracker |
| 评分 | ⚡ 4.5 |
| 安装量 | 2+ |
| 下载地址 | https://www.skillsbot.cn/skill/6434 |
功能描述
提供机器学习实验的系统化追踪、版本控制和可重复性指导,集成 MLflow、Weights & Biases(W&B)和 DVC,帮助数据科学家和工程师管理模型开发过程,确保实验可重现和高效比较。
痛点解决
数据科学家通常在本地散乱记录实验参数和结果,导致实验难以复现、团队协作困难、无法系统化比较不同模型版本的效果差异。
适用场景:ML 研究项目、模型迭代优化、团队协作式模型开发
4. 向量数据库调优
| 属性 | 内容 |
|---|---|
| Skill ID | vector-database-tuning |
| 评分 | ⚡ 4.5 |
| 安装量 | 2+ |
| 下载地址 | https://www.skillsbot.cn/skill/5491 |
功能描述
涉及向量数据库的性能优化,包括 HNSW 参数调整、分块策略、混合搜索配置等,以提高 RAG 和语义搜索的性能。专注于向量检索系统的精度与速度平衡优化。
痛点解决
搭建好向量数据库后性能不达预期,召回率低、查询延迟高是常见痛点。本技能提供系统性的调优方法论,帮助工程师针对不同业务场景找到最优配置参数。
适用场景:RAG 系统优化、语义搜索性能调优、生产级向量数据库运维
5. 机器学习模型训练
| 属性 | 内容 |
|---|---|
| Skill ID | ml-model-training |
| 评分 | ⚡ 4.5 |
| 安装量 | 2+ |
| 下载地址 | https://www.skillsbot.cn/skill/6672 |
功能描述
使用 scikit-learn、PyTorch 和 TensorFlow 等工具训练机器学习模型,涵盖数据准备、特征工程、模型选择、训练和评估全流程,适用于分类、回归、神经网络等任务,并包括超参数调优和解决过拟合、欠拟合等常见问题。
痛点解决
ML 入门者面对分散的工具生态和复杂的训练流程无从下手,技能提供从数据预处理到模型评估的完整操作指南,覆盖常见陷阱和解决方案。
适用场景:ML 入门学习、分类/回归任务建模、深度学习模型开发
6. MLPipelineAutomation
| 属性 | 内容 |
|---|---|
| Skill ID | MLPipelineAutomation |
| 评分 | ⚡ 4.5 |
| 安装量 | 2+ |
| 下载地址 | https://www.skillsbot.cn/skill/4899 |
功能描述
机器学习管道自动化是指通过自动化的方式,实现从数据采集到模型部署的整个机器学习工作流程,以确保流程的可复现性、可扩展性和可靠性,提供标准化的 ML 工程实践方法。
痛点解决
ML 项目缺乏标准化自动化框架,每个项目都需要重复搭建基础设施,导致资源浪费、质量参差不齐。本技能提供可复用的自动化管道模板和最佳实践。
适用场景:ML 工程标准化、企业 AI 基础设施建设、模型批量生产
7. 数据增强
| 属性 | 内容 |
|---|---|
| Skill ID | DataAugmentation |
| 评分 | ⚡ 4.5 |
| 安装量 | 1+ |
| 下载地址 | https://www.skillsbot.cn/skill/5516 |
功能描述
机器学习数据增强技能,通过创建现有数据的修改版本来人工增加训练数据集的大小和多样性,从而提高模型的泛化能力。涵盖图像(几何变换)、文本(同义词替换、反向翻译)、音频(音高移动)和表格数据(SMOTE 过采样)的增强方法。
痛点解决
真实世界中标注数据稀缺且昂贵,直接导致模型在小样本情况下过拟合、泛化能力差。本技能系统提供多模态数据增强策略,让"少数据"也能训练出高质量模型。
适用场景:小样本学习、图像分类、NLP 模型训练、不均衡数据集处理
8. ML 模型解释
| 属性 | 内容 |
|---|---|
| Skill ID | MLModelExplanation |
| 评分 | ⚡ 4.5 |
| 安装量 | 1+ |
| 下载地址 | https://www.skillsbot.cn/skill/4897 |
功能描述
使用 SHAP、LIME、特征重要性、部分依赖和注意力可视化等技术,对机器学习模型进行解释,以提高模型的透明度和可解释性,便于调试和获得可操作的洞察。
痛点解决
机器学习模型长期被当作黑盒使用,无法解释决策依据,在金融、医疗等高风险领域难以通过合规审查,也无法有效定位模型的失效原因。
适用场景:合规型 AI 应用、模型调试优化、AI 可信度审查、特征工程指导
9. 跨任务学习
| 属性 | 内容 |
|---|---|
| Skill ID | cross-task-learning |
| 评分 | ⚡ 4.5 |
| 安装量 | 1+ |
| 下载地址 | https://www.skillsbot.cn/skill/4395 |
功能描述
跨任务学习技能用于聚合多个任务中的洞察,以识别重复出现的模式、始终有效的策略、不断失败的策略、反复出现的瓶颈和不断出现的提案,从而促进数据驱动的进化和持续改进。
痛点解决
AI 系统在执行多任务时缺乏经验积累和知识迁移机制,每次任务都从零开始,无法从历史中学习提升效率。本技能建立系统化的跨任务知识沉淀和复用机制。
适用场景:迁移学习、AI Agent 持续优化、多任务 ML 系统建设
10. Rust 机器学习领域技能
| 属性 | 内容 |
|---|---|
| Skill ID | domain-ml |
| 评分 | ⚡ 4.5 |
| 安装量 | 1+ |
| 下载地址 | https://www.skillsbot.cn/skill/2599 |
功能描述
专注于使用 Rust 编程语言高效构建和部署机器学习与人工智能应用。涵盖内存效率、GPU 加速、模型可移植性等关键领域约束,提供设计模式和推荐框架(candle、tract、tch-rs),适用于高性能模型推理和训练。
痛点解决
Python 生态在 ML 部署性能和内存管理方面存在天然局限,而 Rust 的 ML 生态文档匮乏、学习曲线陡峭。本技能系统整理 Rust ML 工程的最佳实践,填补高性能 AI 推理开发的知识空白。
适用场景:高性能 ML 推理部署、边缘计算 AI、GPU 加速计算、ONNX 模型部署
11. Optuna 超参数调优器
| 属性 | 内容 |
|---|---|
| Skill ID | optuna-hyperparameter-tuner |
| 评分 | ⚡ 4.5 |
| 安装量 | 1+ |
| 下载地址 | https://www.skillsbot.cn/skill/461 |
功能描述
基于 Optuna 框架的自动化机器学习超参数优化工具,提供 TPE、CMA-ES、网格搜索等多种高级搜索算法,支持剪枝策略、多目标优化和可视化分析。帮助数据科学家和 AI 工程师高效提升模型性能。
痛点解决
超参数调优历来是 ML 工程中最费时费力的环节,手动网格搜索计算代价高且效果不佳。本技能通过 Optuna 的智能贝叶斯搜索等算法,自动高效地找到最优超参数组合。
适用场景:ML 模型性能优化、深度学习调参、自动化模型选择(AutoML)
12. GPU 性能基准测试
| 属性 | 内容 |
|---|---|
| Skill ID | gpu-benchmarking |
| 评分 | ⚡ 4.5 |
| 安装量 | 1+ |
| 下载地址 | https://www.skillsbot.cn/skill/2088 |
功能描述
专门用于自动化 GPU 性能基准测试和回归检测。能够设计微基准测试、测量内核执行时间、计算实际与理论性能、生成性能比较报告、在 CI/CD 中检测性能回归、分析功耗和热特性、基准测试内存带宽和延迟,并创建可复现的基准测试配置。
痛点解决
GPU 优化工作缺乏量化评估手段,性能回归难以在 CI/CD 流程中被及时发现,开发者无法系统性地分析 GPU 的实际利用效率和瓶颈所在。
适用场景:GPU 性能工程、深度学习框架优化、CI/CD 性能回归检测、硬件选型评估
技术方向分类
| 技术方向 | 相关技能 |
|---|---|
| 🔄 ML 工作流自动化 | 机器学习管道自动化、MLPipelineAutomation |
| 🔍 向量检索与数据库 | 向量搜索、向量数据库调优 |
| 📊 实验与模型管理 | ML 实验追踪器、ML 模型解释 |
| 🎯 模型训练与调优 | 机器学习模型训练、Optuna 超参数调优器、数据增强 |
| 🚀 高性能计算 | Rust 机器学习领域技能、GPU 性能基准测试 |
| 🧩 知识迁移 | 跨任务学习 |
文档由 WorkBuddy 自动生成整理 | 数据来源:SkillsBot 机器学习分类
更多推荐


 12
 0
- 0


 已为社区贡献14条内容

所有评论(0)