
云服务器部署大模型
·
云服务器部署大模型
1. 服务器配置


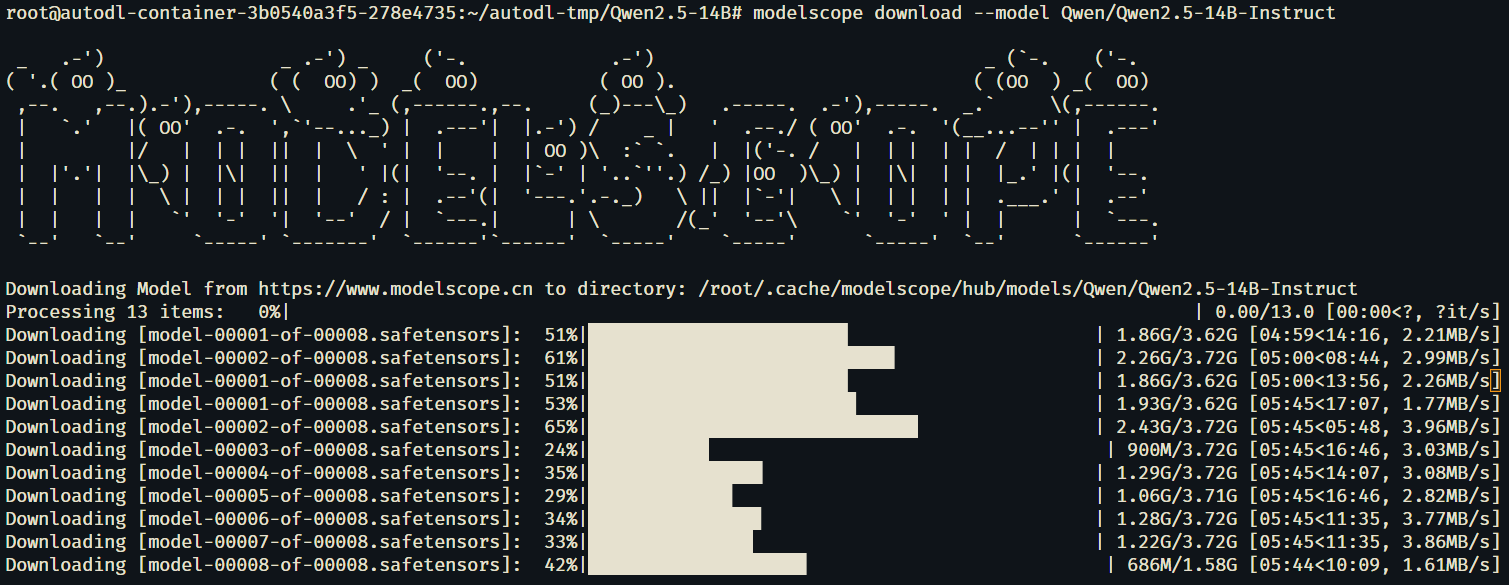
2. 大模型下载
千问2.5-14B-Instruct https://modelscope.cn/models/Qwen/Qwen2.5-14B-Instruct
pip install modelscope

modelscope download --model Qwen/Qwen2.5-14B-Instruct --local_dir /root/autodl-tmp/Qwen2.5-14B
3. 部署大模型
3.1 服务器环境
- PyTorch 2.8.0 + Python 3.12 + CUDA 12.8
- 2×RTX 5090 32GB(跑 14B 模型属于降维打击)
- x86 + Ubuntu 22.04
- 模型已下载到:/root/autodl-tmp/Qwen2.5-14B
# vllm
pip install vllm -U -i https://pypi.tuna.tsinghua.edu.cn/simple
3.2 部署Qwen2.5-14B
python -m vllm.entrypoints.openai.api_server \
  --model /root/autodl-tmp/Qwen2.5-14B \
  --tensor-parallel-size 2 \
  --host 0.0.0.0 \
  --port 8000 \
  --dtype auto \
  --gpu-memory-utilization 0.9 \
  --max-model-len 32768 \
  --trust-remote-code
另一种部署方式,之前的部署方式,回答问题太慢了
unset OMP_NUM_THREADS && export CUDA_VISIBLE_DEVICES=0,1 && python -m vllm.entrypoints.openai.api_server \
  --model /root/autodl-tmp/Qwen2.5-14B \
  --tensor-parallel-size 2 \
  --host 0.0.0.0 \
  --port 8000 \
  --dtype auto \
  --gpu-memory-utilization 0.9 \
  --max-model-len 4096 \
  --trust-remote-code \
  --enforce-eager
~/autodl-tmp# unset OMP_NUM_THREADS && export CUDA_VISIBLE_DEVICES=0,1 && python -m vllm.entrypoints.openai.api_server \
  --model /root/autodl-tmp/Qwen2.5-14B \
  --tensor-parallel-size 2 \
  --host 0.0.0.0 \
  --port 8000 \
  --dtype auto \
  --gpu-memory-utilization 0.9 \
  --max-model-len 4096 \
  --trust-remote-code \
  --enforce-eager \
  --served-model-name Qwen2.5-14B
(APIServer pid=9170) INFO 04-07 09:26:57 [utils.py:299]
(APIServer pid=9170) INFO 04-07 09:26:57 [utils.py:299]        █     █     █▄   ▄█
(APIServer pid=9170) INFO 04-07 09:26:57 [utils.py:299]  ▄▄ ▄█ █     █     █ ▀▄▀ █  version 0.19.0
(APIServer pid=9170) INFO 04-07 09:26:57 [utils.py:299]   █▄█▀ █     █     █     █  model   /root/autodl-tmp/Qwen2.5-14B
(APIServer pid=9170) INFO 04-07 09:26:57 [utils.py:299]    ▀▀  ▀▀▀▀▀ ▀▀▀▀▀ ▀     ▀
(APIServer pid=9170) INFO 04-07 09:26:57 [utils.py:299]
(APIServer pid=9170) INFO 04-07 09:26:57 [utils.py:233] non-default args: {'host': '0.0.0.0', 'model': '/root/autodl-tmp/Qwen2.5-14B', 'trust_remote_code': True, 'max_model_len': 4096, 'enforce_eager': True, 'served_model_name': ['Qwen2.5-14B'], 'tensor_parallel_size': 2}
(APIServer pid=9170) INFO 04-07 09:26:57 [model.py:549] Resolved architecture: Qwen2ForCausalLM
(APIServer pid=9170) INFO 04-07 09:26:57 [model.py:1678] Using max model len 4096
(APIServer pid=9170) INFO 04-07 09:26:57 [vllm.py:790] Asynchronous scheduling is enabled.
(APIServer pid=9170) WARNING 04-07 09:26:57 [vllm.py:848] Enforce eager set, disabling torch.compile and CUDAGraphs. This is equivalent to setting -cc.mode=none -cc.cudagraph_mode=none
(APIServer pid=9170) WARNING 04-07 09:26:57 [vllm.py:859] Inductor compilation was disabled by user settings, optimizations settings that are only active during inductor compilation will be ignored.
(APIServer pid=9170) INFO 04-07 09:26:58 [vllm.py:1025] Cudagraph is disabled under eager mode
(APIServer pid=9170) INFO 04-07 09:26:58 [compilation.py:290] Enabled custom fusions: norm_quant, act_quant
(EngineCore pid=9436) INFO 04-07 09:27:03 [core.py:105] Initializing a V1 LLM engine (v0.19.0) with config: model='/root/autodl-tmp/Qwen2.5-14B', speculative_config=None, tokenizer='/root/autodl-tmp/Qwen2.5-14B', skip_tokenizer_init=False, tokenizer_mode=auto, revision=None, tokenizer_revision=None, trust_remote_code=True, dtype=torch.bfloat16, max_seq_len=4096, download_dir=None, load_format=auto, tensor_parallel_size=2, pipeline_parallel_size=1, data_parallel_size=1, decode_context_parallel_size=1, dcp_comm_backend=ag_rs, disable_custom_all_reduce=False, quantization=None, enforce_eager=True, enable_return_routed_experts=False, kv_cache_dtype=auto, device_config=cuda, structured_outputs_config=StructuredOutputsConfig(backend='auto', disable_any_whitespace=False, disable_additional_properties=False, reasoning_parser='', reasoning_parser_plugin='', enable_in_reasoning=False), observability_config=ObservabilityConfig(show_hidden_metrics_for_version=None, otlp_traces_endpoint=None, collect_detailed_traces=None, kv_cache_metrics=False, kv_cache_metrics_sample=0.01, cudagraph_metrics=False, enable_layerwise_nvtx_tracing=False, enable_mfu_metrics=False, enable_mm_processor_stats=False, enable_logging_iteration_details=False), seed=0, served_model_name=Qwen2.5-14B, enable_prefix_caching=True, enable_chunked_prefill=True, pooler_config=None, compilation_config={'mode': <CompilationMode.NONE: 0>, 'debug_dump_path': None, 'cache_dir': '', 'compile_cache_save_format': 'binary', 'backend': 'inductor', 'custom_ops': ['all'], 'splitting_ops': [], 'compile_mm_encoder': False, 'cudagraph_mm_encoder': False, 'encoder_cudagraph_token_budgets': [], 'encoder_cudagraph_max_images_per_batch': 0, 'compile_sizes': [], 'compile_ranges_endpoints': [2048], 'inductor_compile_config': {'enable_auto_functionalized_v2': False, 'size_asserts': False, 'alignment_asserts': False, 'scalar_asserts': False, 'combo_kernels': True, 'benchmark_combo_kernel': True}, 'inductor_passes': {}, 'cudagraph_mode': <CUDAGraphMode.NONE: 0>, 'cudagraph_num_of_warmups': 0, 'cudagraph_capture_sizes': [], 'cudagraph_copy_inputs': False, 'cudagraph_specialize_lora': True, 'use_inductor_graph_partition': False, 'pass_config': {'fuse_norm_quant': True, 'fuse_act_quant': True, 'fuse_attn_quant': False, 'enable_sp': False, 'fuse_gemm_comms': False, 'fuse_allreduce_rms': False}, 'max_cudagraph_capture_size': 0, 'dynamic_shapes_config': {'type': <DynamicShapesType.BACKED: 'backed'>, 'evaluate_guards': False, 'assume_32_bit_indexing': False}, 'local_cache_dir': None, 'fast_moe_cold_start': True, 'static_all_moe_layers': []}
(EngineCore pid=9436) WARNING 04-07 09:27:03 [multiproc_executor.py:1014] Reducing Torch parallelism from 64 threads to 1 to avoid unnecessary CPU contention. Set OMP_NUM_THREADS in the external environment to tune this value as needed.
(EngineCore pid=9436) INFO 04-07 09:27:03 [multiproc_executor.py:134] DP group leader: node_rank=0, node_rank_within_dp=0, master_addr=127.0.0.1, mq_connect_ip=172.17.0.5 (local), world_size=2, local_world_size=2
(Worker pid=9700) INFO 04-07 09:27:10 [parallel_state.py:1400] world_size=2 rank=0 local_rank=0 distributed_init_method=tcp://127.0.0.1:51357 backend=nccl
(Worker pid=9701) INFO 04-07 09:27:10 [parallel_state.py:1400] world_size=2 rank=1 local_rank=1 distributed_init_method=tcp://127.0.0.1:51357 backend=nccl
(Worker pid=9701) <frozen importlib._bootstrap_external>:1297: FutureWarning: The cuda.cudart module is deprecated and will be removed in a future release, please switch to use the cuda.bindings.runtime module instead.
(Worker pid=9701) <frozen importlib._bootstrap_external>:1297: FutureWarning: The cuda.nvrtc module is deprecated and will be removed in a future release, please switch to use the cuda.bindings.nvrtc module instead.
(Worker pid=9700) <frozen importlib._bootstrap_external>:1297: FutureWarning: The cuda.cudart module is deprecated and will be removed in a future release, please switch to use the cuda.bindings.runtime module instead.
(Worker pid=9700) <frozen importlib._bootstrap_external>:1297: FutureWarning: The cuda.nvrtc module is deprecated and will be removed in a future release, please switch to use the cuda.bindings.nvrtc module instead.
(Worker pid=9700) INFO 04-07 09:27:10 [pynccl.py:111] vLLM is using nccl==2.27.5
(Worker pid=9700) WARNING 04-07 09:27:11 [symm_mem.py:66] SymmMemCommunicator: Device capability 12.0 not supported, communicator is not available.
(Worker pid=9701) WARNING 04-07 09:27:11 [symm_mem.py:66] SymmMemCommunicator: Device capability 12.0 not supported, communicator is not available.
(Worker pid=9700) WARNING 04-07 09:27:11 [custom_all_reduce.py:165] Custom allreduce is disabled because your platform lacks GPU P2P capability or P2P test failed. To silence this warning, specify disable_custom_all_reduce=True explicitly.
(Worker pid=9701) WARNING 04-07 09:27:11 [custom_all_reduce.py:165] Custom allreduce is disabled because your platform lacks GPU P2P capability or P2P test failed. To silence this warning, specify disable_custom_all_reduce=True explicitly.
(Worker pid=9700) INFO 04-07 09:27:11 [parallel_state.py:1716] rank 0 in world size 2 is assigned as DP rank 0, PP rank 0, PCP rank 0, TP rank 0, EP rank N/A, EPLB rank N/A
(Worker_TP0 pid=9700) INFO 04-07 09:27:11 [gpu_model_runner.py:4735] Starting to load model /root/autodl-tmp/Qwen2.5-14B...
(Worker_TP0 pid=9700) INFO 04-07 09:27:11 [cuda.py:334] Using FLASH_ATTN attention backend out of potential backends: ['FLASH_ATTN', 'FLASHINFER', 'TRITON_ATTN', 'FLEX_ATTENTION'].
(Worker_TP0 pid=9700) INFO 04-07 09:27:11 [flash_attn.py:596] Using FlashAttention version 2
Loading safetensors checkpoint shards:   0% Completed | 0/8 [00:00<?, ?it/s]
Loading safetensors checkpoint shards:  12% Completed | 1/8 [00:00<00:02,  2.43it/s]
Loading safetensors checkpoint shards:  25% Completed | 2/8 [00:00<00:02,  2.07it/s]
Loading safetensors checkpoint shards:  38% Completed | 3/8 [00:01<00:02,  2.02it/s]
Loading safetensors checkpoint shards:  50% Completed | 4/8 [00:01<00:02,  1.96it/s]
Loading safetensors checkpoint shards:  62% Completed | 5/8 [00:02<00:01,  1.99it/s]
Loading safetensors checkpoint shards:  75% Completed | 6/8 [00:02<00:01,  1.99it/s]
Loading safetensors checkpoint shards:  88% Completed | 7/8 [00:03<00:00,  2.00it/s]
Loading safetensors checkpoint shards: 100% Completed | 8/8 [00:03<00:00,  2.57it/s]
Loading safetensors checkpoint shards: 100% Completed | 8/8 [00:03<00:00,  2.21it/s]
(Worker_TP0 pid=9700)
(Worker_TP0 pid=9700) INFO 04-07 09:27:15 [default_loader.py:384] Loading weights took 3.63 seconds
(Worker_TP0 pid=9700) INFO 04-07 09:27:16 [gpu_model_runner.py:4820] Model loading took 13.93 GiB memory and 3.776843 seconds
(Worker_TP0 pid=9700) INFO 04-07 09:27:17 [gpu_worker.py:436] Available KV cache memory: 13.61 GiB
(EngineCore pid=9436) INFO 04-07 09:27:17 [kv_cache_utils.py:1319] GPU KV cache size: 148,704 tokens
(EngineCore pid=9436) INFO 04-07 09:27:17 [kv_cache_utils.py:1324] Maximum concurrency for 4,096 tokens per request: 36.30x
(Worker_TP0 pid=9700) 2026-04-07 09:27:17,869 - INFO - autotuner.py:262 - flashinfer.jit: [Autotuner]: Autotuning process starts ...
(Worker_TP1 pid=9701) 2026-04-07 09:27:17,869 - INFO - autotuner.py:262 - flashinfer.jit: [Autotuner]: Autotuning process starts ...
(Worker_TP1 pid=9701) 2026-04-07 09:27:17,883 - INFO - autotuner.py:268 - flashinfer.jit: [Autotuner]: Autotuning process ends
(Worker_TP0 pid=9700) 2026-04-07 09:27:17,884 - INFO - autotuner.py:268 - flashinfer.jit: [Autotuner]: Autotuning process ends
(EngineCore pid=9436) INFO 04-07 09:27:18 [core.py:283] init engine (profile, create kv cache, warmup model) took 1.93 seconds
(EngineCore pid=9436) INFO 04-07 09:27:19 [vllm.py:790] Asynchronous scheduling is enabled.
(EngineCore pid=9436) WARNING 04-07 09:27:19 [vllm.py:848] Enforce eager set, disabling torch.compile and CUDAGraphs. This is equivalent to setting -cc.mode=none -cc.cudagraph_mode=none
(EngineCore pid=9436) WARNING 04-07 09:27:19 [vllm.py:859] Inductor compilation was disabled by user settings, optimizations settings that are only active during inductor compilation will be ignored.
(EngineCore pid=9436) INFO 04-07 09:27:19 [vllm.py:1025] Cudagraph is disabled under eager mode
(EngineCore pid=9436) INFO 04-07 09:27:19 [compilation.py:290] Enabled custom fusions: norm_quant, act_quant
(APIServer pid=9170) INFO 04-07 09:27:19 [api_server.py:590] Supported tasks: ['generate']
(APIServer pid=9170) WARNING 04-07 09:27:19 [model.py:1435] Default vLLM sampling parameters have been overridden by the model's `generation_config.json`: `{'repetition_penalty': 1.05, 'temperature': 0.7, 'top_k': 20, 'top_p': 0.8}`. If this is not intended, please relaunch vLLM instance with `--generation-config vllm`.
(APIServer pid=9170) INFO 04-07 09:27:19 [hf.py:314] Detected the chat template content format to be 'string'. You can set `--chat-template-content-format` to override this.
(APIServer pid=9170) INFO 04-07 09:27:19 [api_server.py:594] Starting vLLM server on http://0.0.0.0:8000
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:37] Available routes are:
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /openapi.json, Methods: HEAD, GET
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /docs, Methods: HEAD, GET
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /docs/oauth2-redirect, Methods: HEAD, GET
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /redoc, Methods: HEAD, GET
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /tokenize, Methods: POST
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /detokenize, Methods: POST
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /load, Methods: GET
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /version, Methods: GET
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /health, Methods: GET
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /metrics, Methods: GET
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /v1/models, Methods: GET
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /ping, Methods: GET
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /ping, Methods: POST
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /invocations, Methods: POST
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /v1/chat/completions, Methods: POST
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /v1/chat/completions/batch, Methods: POST
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /v1/responses, Methods: POST
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /v1/responses/{response_id}, Methods: GET
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /v1/responses/{response_id}/cancel, Methods: POST
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /v1/completions, Methods: POST
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /v1/messages, Methods: POST
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /v1/messages/count_tokens, Methods: POST
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /inference/v1/generate, Methods: POST
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /scale_elastic_ep, Methods: POST
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /is_scaling_elastic_ep, Methods: POST
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /v1/chat/completions/render, Methods: POST
(APIServer pid=9170) INFO 04-07 09:27:19 [launcher.py:46] Route: /v1/completions/render, Methods: POST
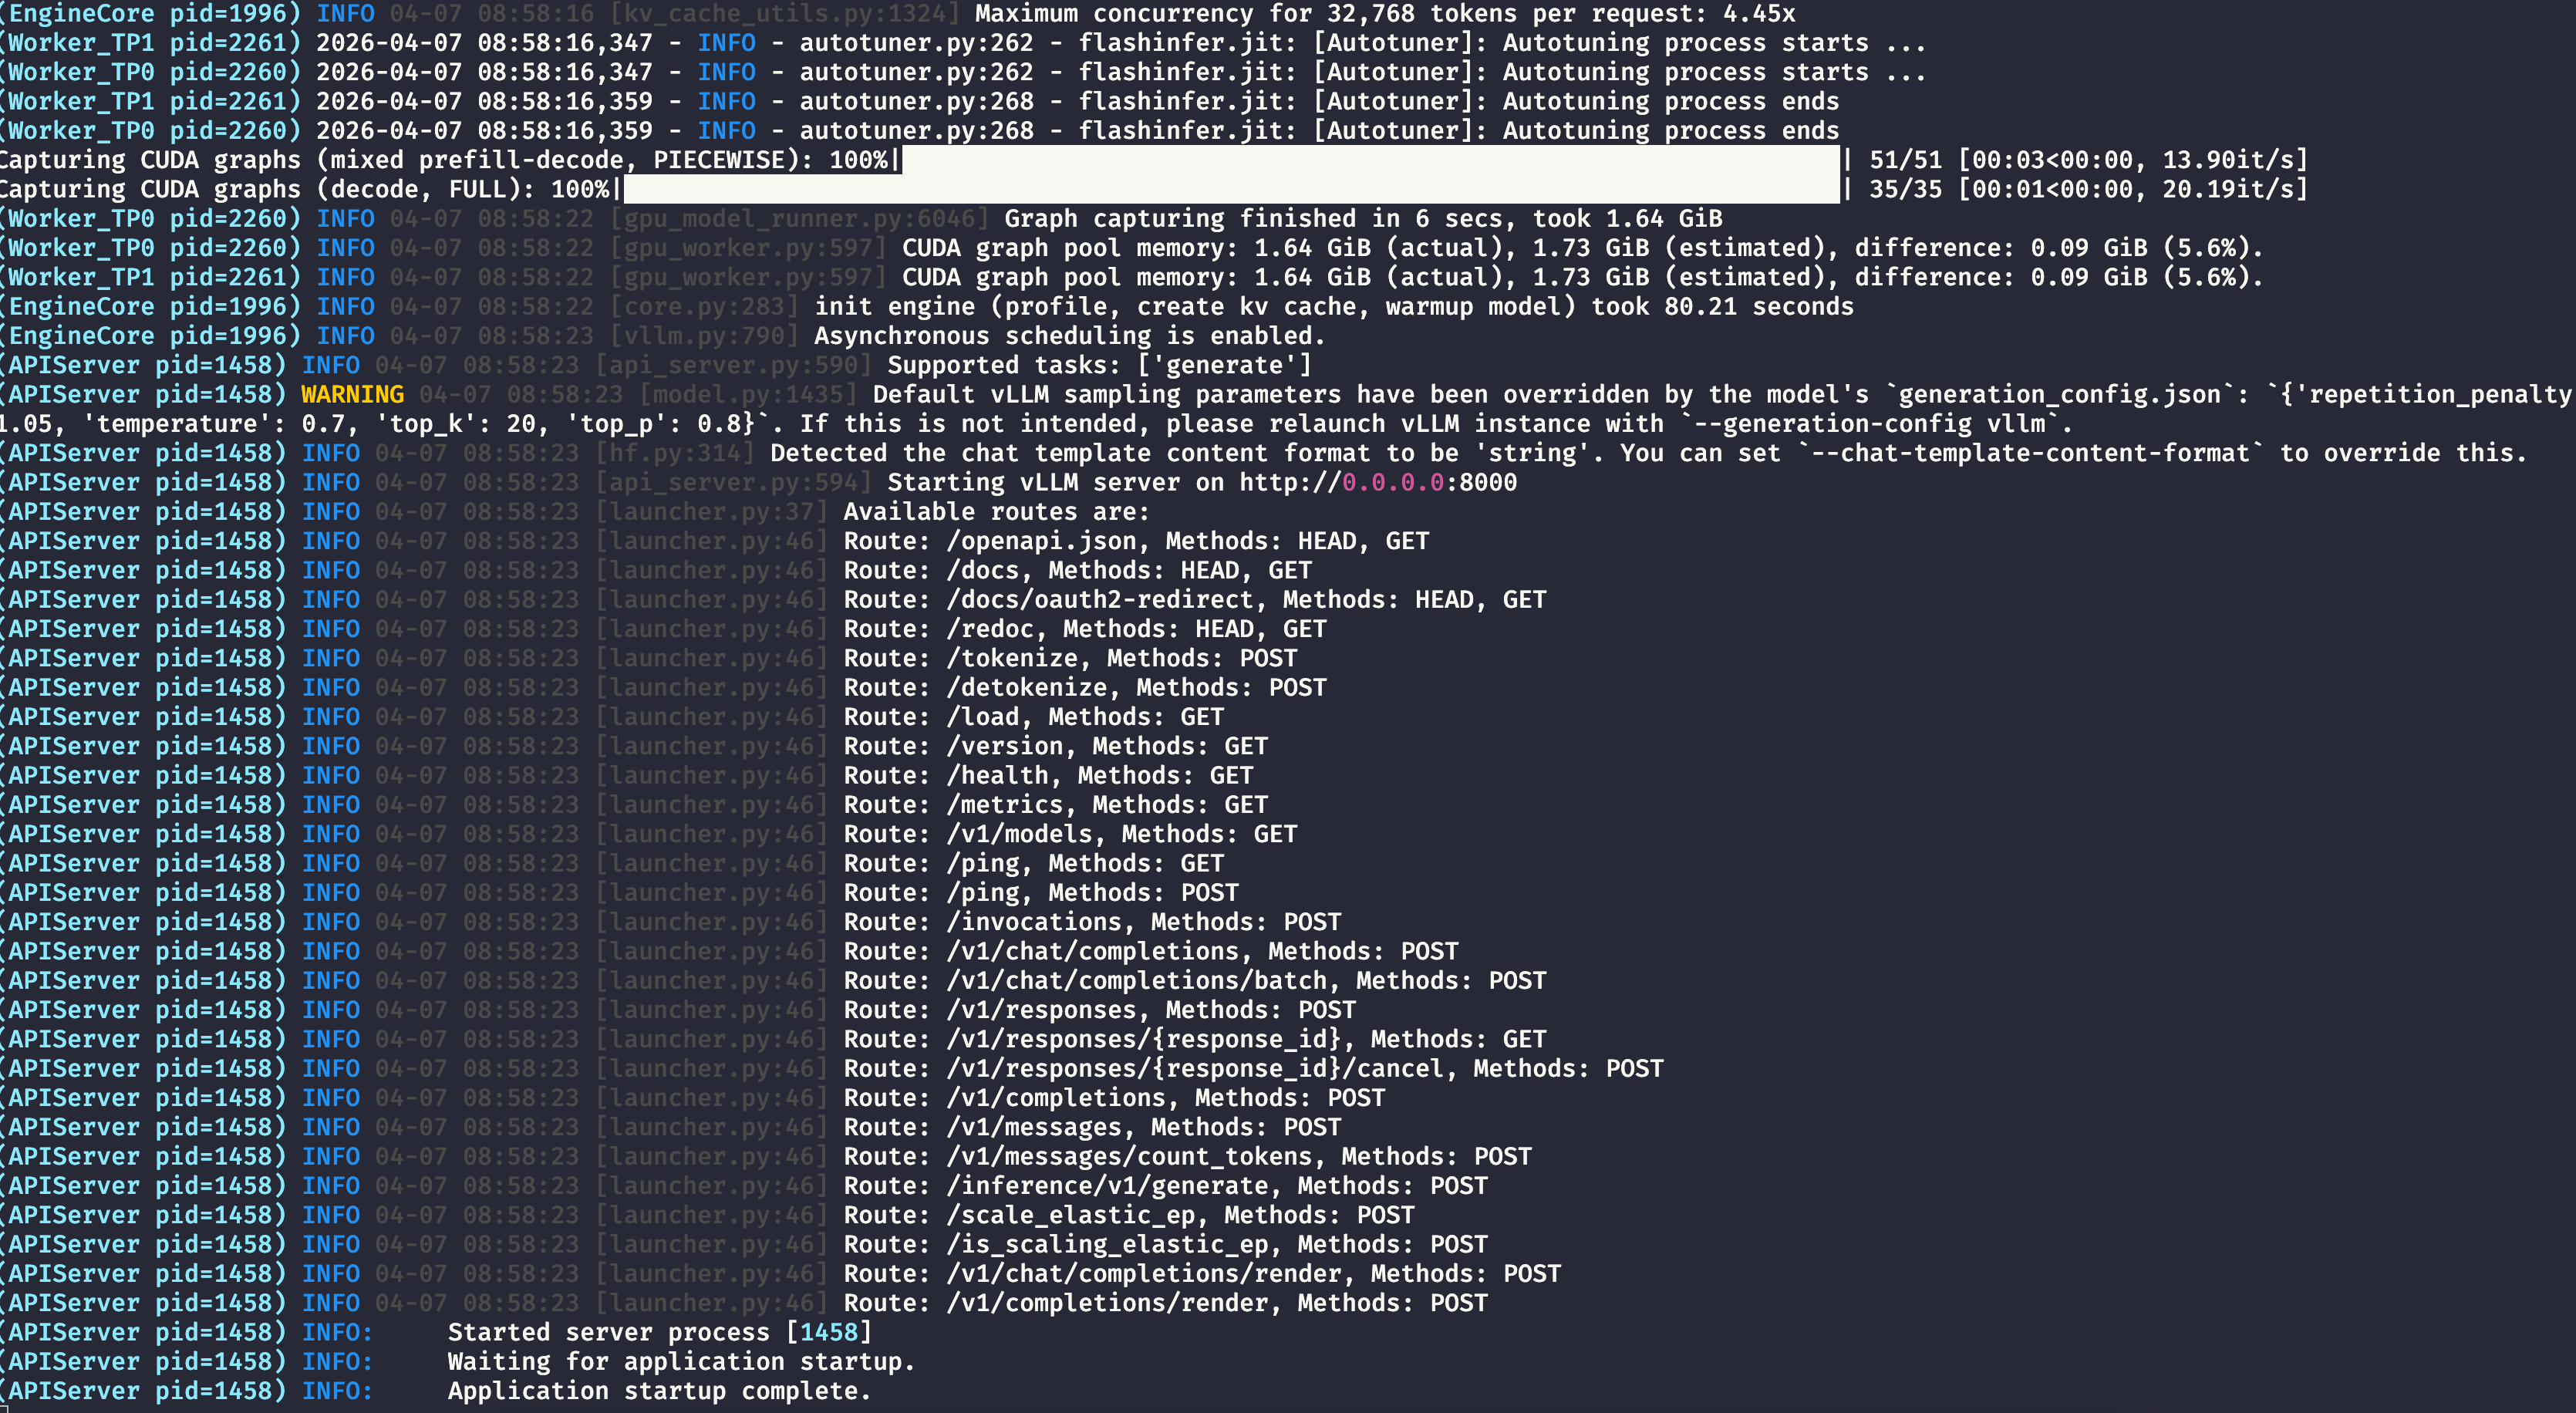
(APIServer pid=9170) INFO:     Started server process [9170]
(APIServer pid=9170) INFO:     Waiting for application startup.
(APIServer pid=9170) INFO:     Application startup complete.
root@autodl-container-3b0540a3f5-278e4735:~/autodl-tmp# pwd
/root/autodl-tmp
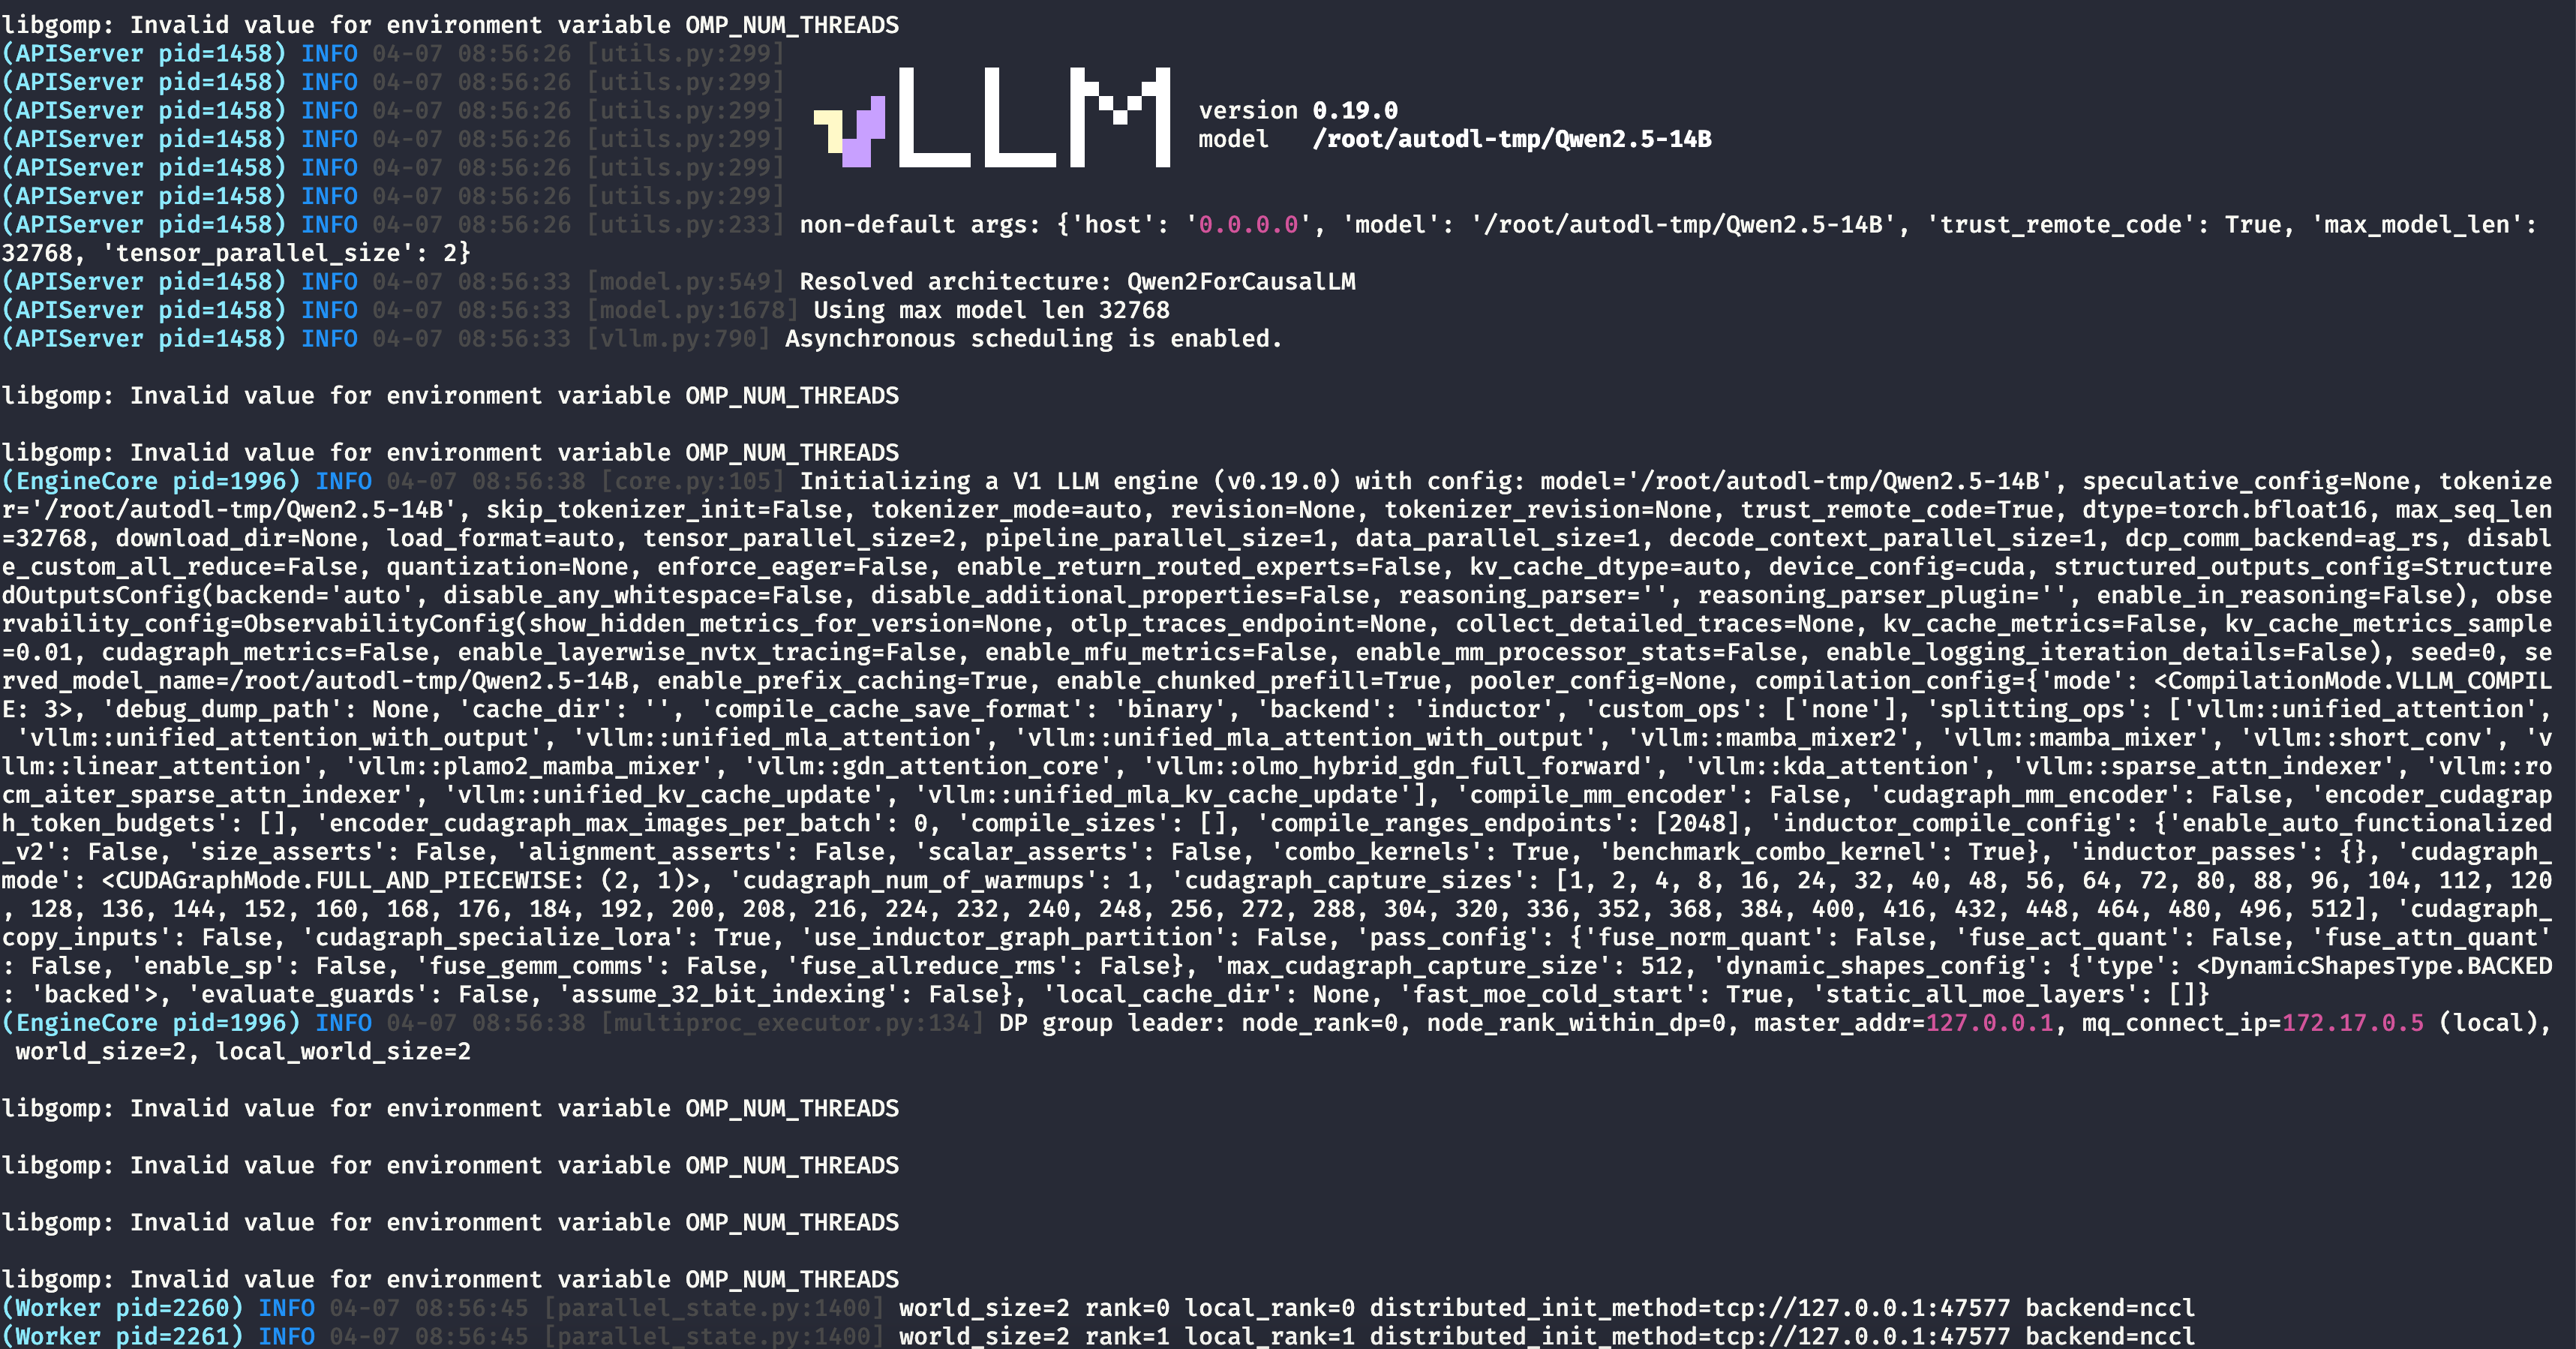
root@autodl-container-3b0540a3f5-278e4735:~/autodl-tmp# python -m vllm.entrypoints.openai.api_server \
  --model /root/autodl-tmp/Qwen2.5-14B \
  --tensor-parallel-size 2 \
  --host 0.0.0.0 \
  --port 8000 \
  --dtype auto \
  --gpu-memory-utilization 0.9 \
  --max-model-len 32768 \
  --trust-remote-code

libgomp: Invalid value for environment variable OMP_NUM_THREADS

libgomp: Invalid value for environment variable OMP_NUM_THREADS
(APIServer pid=1458) INFO 04-07 08:56:26 [utils.py:299]
(APIServer pid=1458) INFO 04-07 08:56:26 [utils.py:299]        █     █     █▄   ▄█
(APIServer pid=1458) INFO 04-07 08:56:26 [utils.py:299]  ▄▄ ▄█ █     █     █ ▀▄▀ █  version 0.19.0
(APIServer pid=1458) INFO 04-07 08:56:26 [utils.py:299]   █▄█▀ █     █     █     █  model   /root/autodl-tmp/Qwen2.5-14B
(APIServer pid=1458) INFO 04-07 08:56:26 [utils.py:299]    ▀▀  ▀▀▀▀▀ ▀▀▀▀▀ ▀     ▀
(APIServer pid=1458) INFO 04-07 08:56:26 [utils.py:299]
(APIServer pid=1458) INFO 04-07 08:56:26 [utils.py:233] non-default args: {'host': '0.0.0.0', 'model': '/root/autodl-tmp/Qwen2.5-14B', 'trust_remote_code': True, 'max_model_len': 32768, 'tensor_parallel_size': 2}
(APIServer pid=1458) INFO 04-07 08:56:33 [model.py:549] Resolved architecture: Qwen2ForCausalLM
(APIServer pid=1458) INFO 04-07 08:56:33 [model.py:1678] Using max model len 32768
(APIServer pid=1458) INFO 04-07 08:56:33 [vllm.py:790] Asynchronous scheduling is enabled.

libgomp: Invalid value for environment variable OMP_NUM_THREADS

libgomp: Invalid value for environment variable OMP_NUM_THREADS
(EngineCore pid=1996) INFO 04-07 08:56:38 [core.py:105] Initializing a V1 LLM engine (v0.19.0) with config: model='/root/autodl-tmp/Qwen2.5-14B', speculative_config=None, tokenizer='/root/autodl-tmp/Qwen2.5-14B', skip_tokenizer_init=False, tokenizer_mode=auto, revision=None, tokenizer_revision=None, trust_remote_code=True, dtype=torch.bfloat16, max_seq_len=32768, download_dir=None, load_format=auto, tensor_parallel_size=2, pipeline_parallel_size=1, data_parallel_size=1, decode_context_parallel_size=1, dcp_comm_backend=ag_rs, disable_custom_all_reduce=False, quantization=None, enforce_eager=False, enable_return_routed_experts=False, kv_cache_dtype=auto, device_config=cuda, structured_outputs_config=StructuredOutputsConfig(backend='auto', disable_any_whitespace=False, disable_additional_properties=False, reasoning_parser='', reasoning_parser_plugin='', enable_in_reasoning=False), observability_config=ObservabilityConfig(show_hidden_metrics_for_version=None, otlp_traces_endpoint=None, collect_detailed_traces=None, kv_cache_metrics=False, kv_cache_metrics_sample=0.01, cudagraph_metrics=False, enable_layerwise_nvtx_tracing=False, enable_mfu_metrics=False, enable_mm_processor_stats=False, enable_logging_iteration_details=False), seed=0, served_model_name=/root/autodl-tmp/Qwen2.5-14B, enable_prefix_caching=True, enable_chunked_prefill=True, pooler_config=None, compilation_config={'mode': <CompilationMode.VLLM_COMPILE: 3>, 'debug_dump_path': None, 'cache_dir': '', 'compile_cache_save_format': 'binary', 'backend': 'inductor', 'custom_ops': ['none'], 'splitting_ops': ['vllm::unified_attention', 'vllm::unified_attention_with_output', 'vllm::unified_mla_attention', 'vllm::unified_mla_attention_with_output', 'vllm::mamba_mixer2', 'vllm::mamba_mixer', 'vllm::short_conv', 'vllm::linear_attention', 'vllm::plamo2_mamba_mixer', 'vllm::gdn_attention_core', 'vllm::olmo_hybrid_gdn_full_forward', 'vllm::kda_attention', 'vllm::sparse_attn_indexer', 'vllm::rocm_aiter_sparse_attn_indexer', 'vllm::unified_kv_cache_update', 'vllm::unified_mla_kv_cache_update'], 'compile_mm_encoder': False, 'cudagraph_mm_encoder': False, 'encoder_cudagraph_token_budgets': [], 'encoder_cudagraph_max_images_per_batch': 0, 'compile_sizes': [], 'compile_ranges_endpoints': [2048], 'inductor_compile_config': {'enable_auto_functionalized_v2': False, 'size_asserts': False, 'alignment_asserts': False, 'scalar_asserts': False, 'combo_kernels': True, 'benchmark_combo_kernel': True}, 'inductor_passes': {}, 'cudagraph_mode': <CUDAGraphMode.FULL_AND_PIECEWISE: (2, 1)>, 'cudagraph_num_of_warmups': 1, 'cudagraph_capture_sizes': [1, 2, 4, 8, 16, 24, 32, 40, 48, 56, 64, 72, 80, 88, 96, 104, 112, 120, 128, 136, 144, 152, 160, 168, 176, 184, 192, 200, 208, 216, 224, 232, 240, 248, 256, 272, 288, 304, 320, 336, 352, 368, 384, 400, 416, 432, 448, 464, 480, 496, 512], 'cudagraph_copy_inputs': False, 'cudagraph_specialize_lora': True, 'use_inductor_graph_partition': False, 'pass_config': {'fuse_norm_quant': False, 'fuse_act_quant': False, 'fuse_attn_quant': False, 'enable_sp': False, 'fuse_gemm_comms': False, 'fuse_allreduce_rms': False}, 'max_cudagraph_capture_size': 512, 'dynamic_shapes_config': {'type': <DynamicShapesType.BACKED: 'backed'>, 'evaluate_guards': False, 'assume_32_bit_indexing': False}, 'local_cache_dir': None, 'fast_moe_cold_start': True, 'static_all_moe_layers': []}
(EngineCore pid=1996) INFO 04-07 08:56:38 [multiproc_executor.py:134] DP group leader: node_rank=0, node_rank_within_dp=0, master_addr=127.0.0.1, mq_connect_ip=172.17.0.5 (local), world_size=2, local_world_size=2

libgomp: Invalid value for environment variable OMP_NUM_THREADS

libgomp: Invalid value for environment variable OMP_NUM_THREADS

libgomp: Invalid value for environment variable OMP_NUM_THREADS

libgomp: Invalid value for environment variable OMP_NUM_THREADS
(Worker pid=2260) INFO 04-07 08:56:45 [parallel_state.py:1400] world_size=2 rank=0 local_rank=0 distributed_init_method=tcp://127.0.0.1:47577 backend=nccl
(Worker pid=2261) INFO 04-07 08:56:45 [parallel_state.py:1400] world_size=2 rank=1 local_rank=1 distributed_init_method=tcp://127.0.0.1:47577 backend=nccl
(Worker pid=2260) <frozen importlib._bootstrap_external>:1297: FutureWarning: The cuda.cudart module is deprecated and will be removed in a future release, please switch to use the cuda.bindings.runtime module instead.
(Worker pid=2261) <frozen importlib._bootstrap_external>:1297: FutureWarning: The cuda.cudart module is deprecated and will be removed in a future release, please switch to use the cuda.bindings.runtime module instead.
(Worker pid=2260) <frozen importlib._bootstrap_external>:1297: FutureWarning: The cuda.nvrtc module is deprecated and will be removed in a future release, please switch to use the cuda.bindings.nvrtc module instead.
(Worker pid=2261) <frozen importlib._bootstrap_external>:1297: FutureWarning: The cuda.nvrtc module is deprecated and will be removed in a future release, please switch to use the cuda.bindings.nvrtc module instead.
(Worker pid=2260) INFO 04-07 08:56:46 [pynccl.py:111] vLLM is using nccl==2.27.5
(Worker pid=2260) WARNING 04-07 08:56:46 [symm_mem.py:66] SymmMemCommunicator: Device capability 12.0 not supported, communicator is not available.
(Worker pid=2261) WARNING 04-07 08:56:46 [symm_mem.py:66] SymmMemCommunicator: Device capability 12.0 not supported, communicator is not available.
(Worker pid=2261) WARNING 04-07 08:56:46 [custom_all_reduce.py:165] Custom allreduce is disabled because your platform lacks GPU P2P capability or P2P test failed. To silence this warning, specify disable_custom_all_reduce=True explicitly.
(Worker pid=2260) WARNING 04-07 08:56:46 [custom_all_reduce.py:165] Custom allreduce is disabled because your platform lacks GPU P2P capability or P2P test failed. To silence this warning, specify disable_custom_all_reduce=True explicitly.
(Worker pid=2260) INFO 04-07 08:56:46 [parallel_state.py:1716] rank 0 in world size 2 is assigned as DP rank 0, PP rank 0, PCP rank 0, TP rank 0, EP rank N/A, EPLB rank N/A
(Worker_TP0 pid=2260) INFO 04-07 08:56:47 [gpu_model_runner.py:4735] Starting to load model /root/autodl-tmp/Qwen2.5-14B...
(Worker_TP0 pid=2260) INFO 04-07 08:56:47 [cuda.py:334] Using FLASH_ATTN attention backend out of potential backends: ['FLASH_ATTN', 'FLASHINFER', 'TRITON_ATTN', 'FLEX_ATTENTION'].
(Worker_TP0 pid=2260) INFO 04-07 08:56:47 [flash_attn.py:596] Using FlashAttention version 2
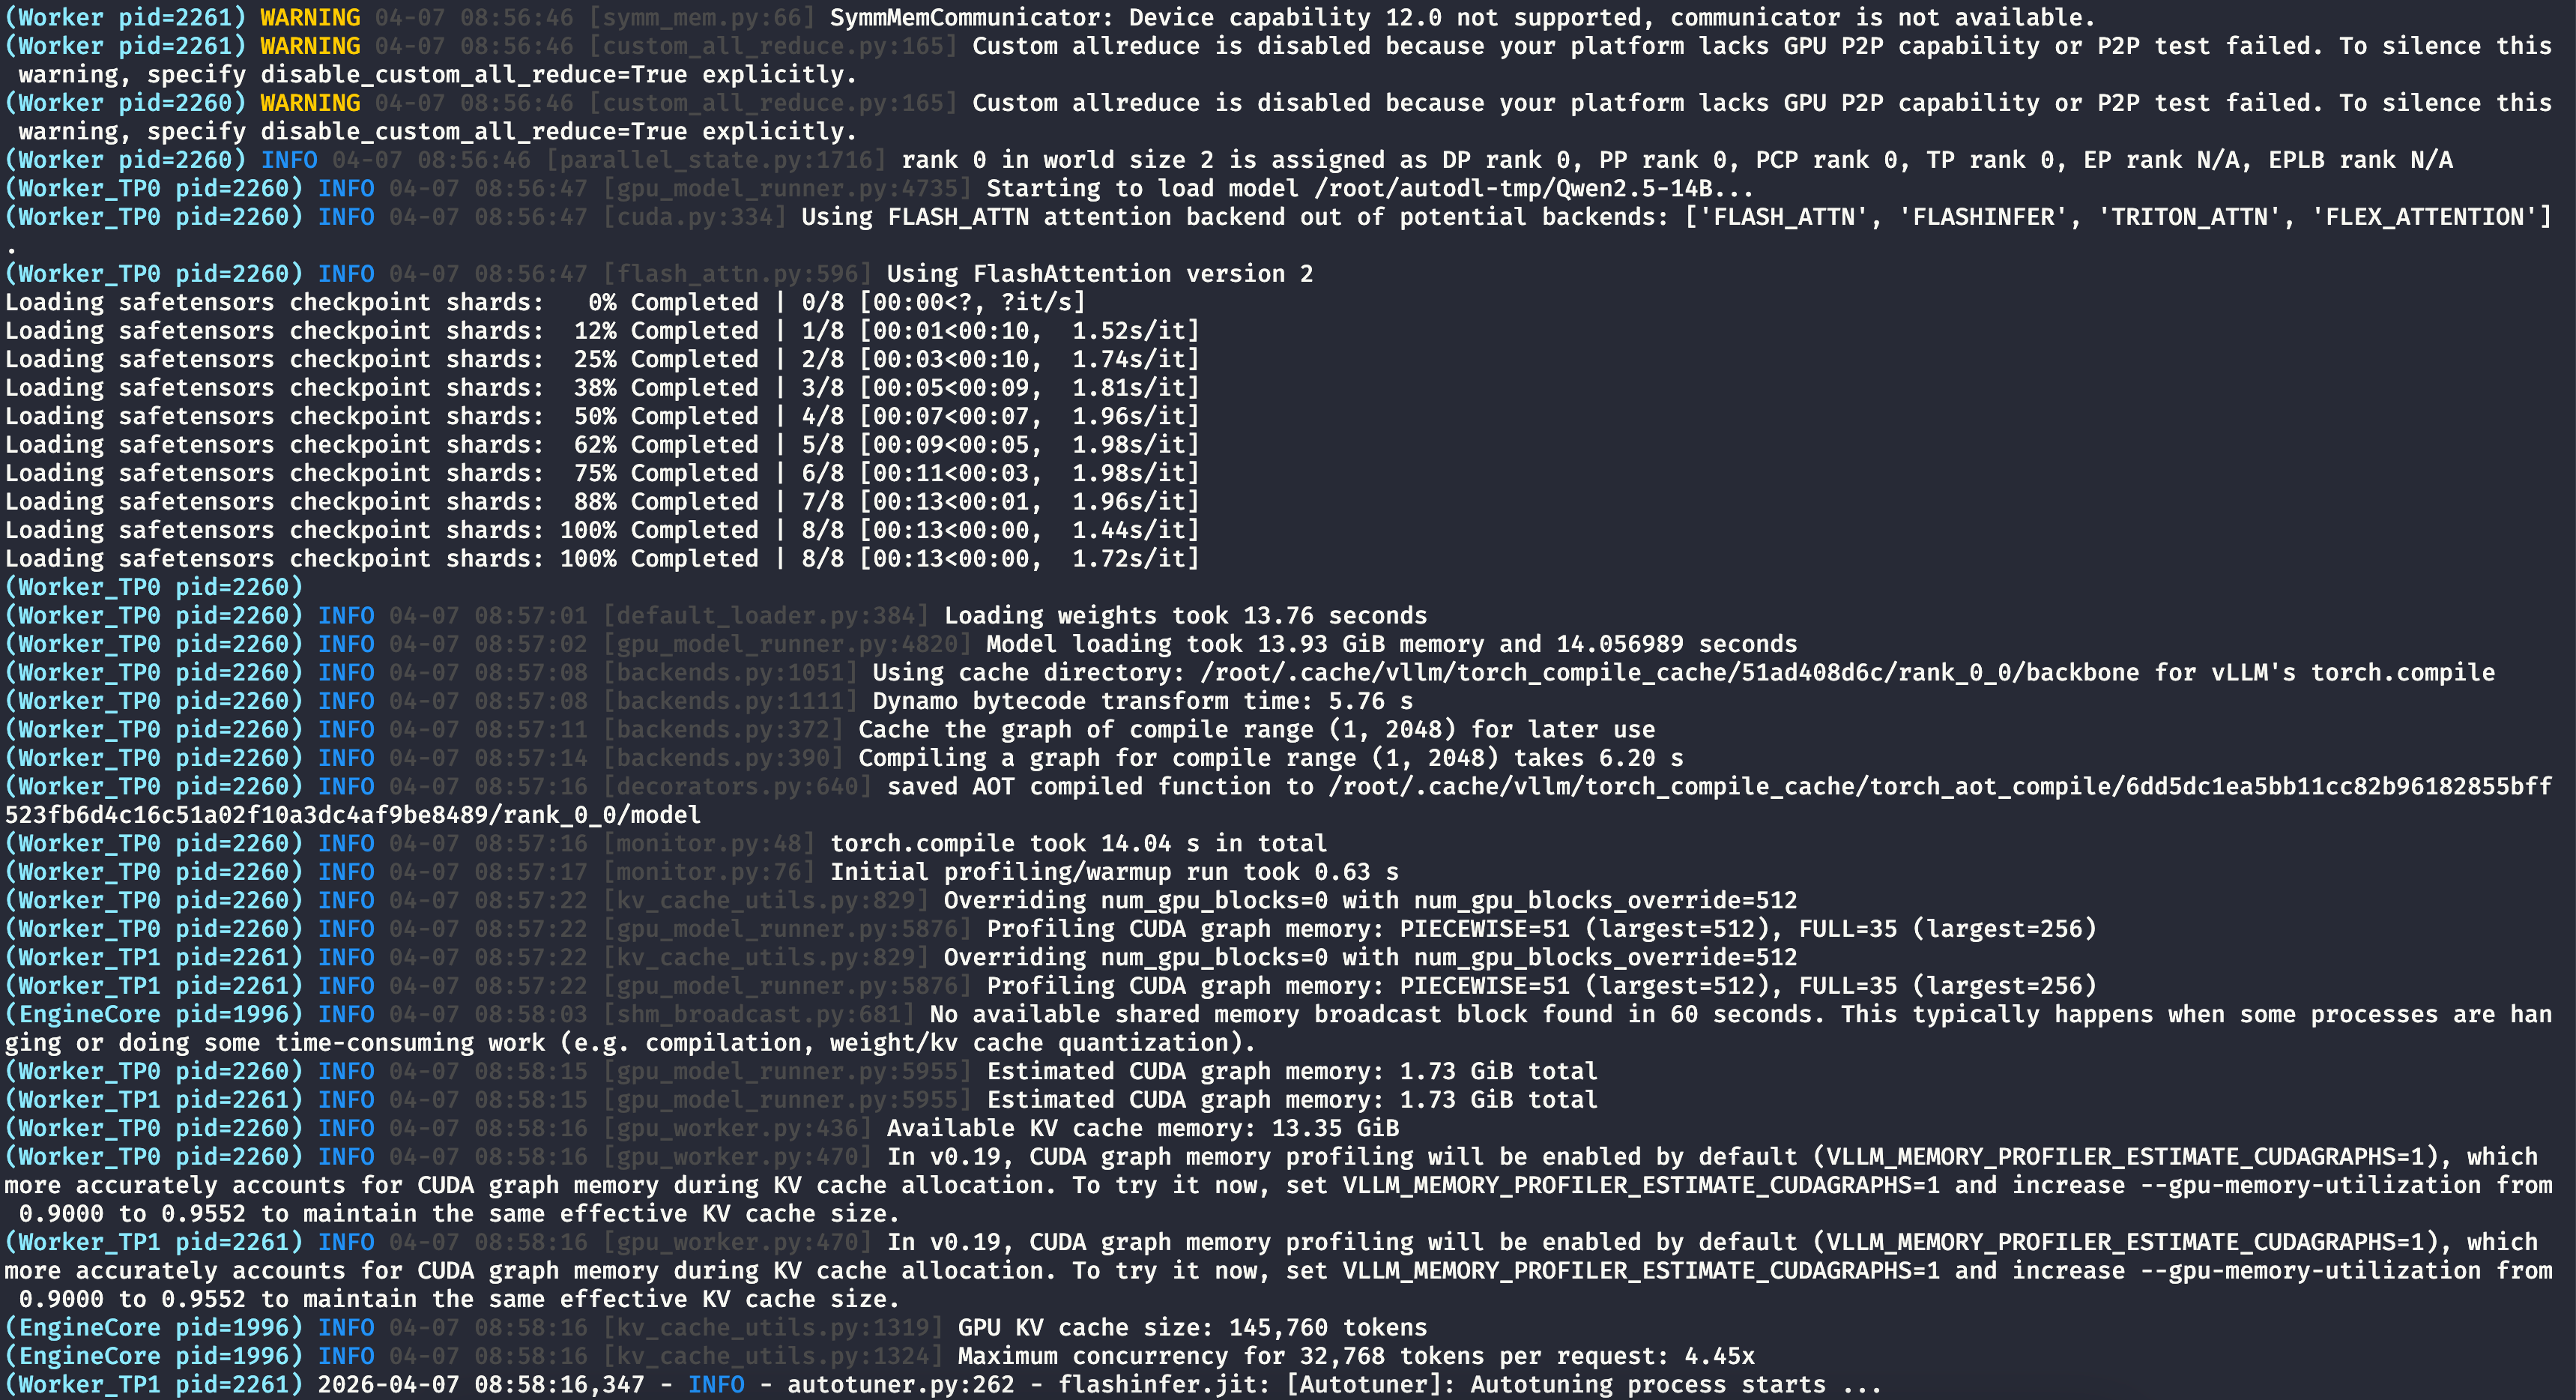
Loading safetensors checkpoint shards:   0% Completed | 0/8 [00:00<?, ?it/s]
Loading safetensors checkpoint shards:  12% Completed | 1/8 [00:01<00:10,  1.52s/it]
Loading safetensors checkpoint shards:  25% Completed | 2/8 [00:03<00:10,  1.74s/it]
Loading safetensors checkpoint shards:  38% Completed | 3/8 [00:05<00:09,  1.81s/it]
Loading safetensors checkpoint shards:  50% Completed | 4/8 [00:07<00:07,  1.96s/it]
Loading safetensors checkpoint shards:  62% Completed | 5/8 [00:09<00:05,  1.98s/it]
Loading safetensors checkpoint shards:  75% Completed | 6/8 [00:11<00:03,  1.98s/it]
Loading safetensors checkpoint shards:  88% Completed | 7/8 [00:13<00:01,  1.96s/it]
Loading safetensors checkpoint shards: 100% Completed | 8/8 [00:13<00:00,  1.44s/it]
Loading safetensors checkpoint shards: 100% Completed | 8/8 [00:13<00:00,  1.72s/it]
(Worker_TP0 pid=2260)
(Worker_TP0 pid=2260) INFO 04-07 08:57:01 [default_loader.py:384] Loading weights took 13.76 seconds
(Worker_TP0 pid=2260) INFO 04-07 08:57:02 [gpu_model_runner.py:4820] Model loading took 13.93 GiB memory and 14.056989 seconds
(Worker_TP0 pid=2260) INFO 04-07 08:57:08 [backends.py:1051] Using cache directory: /root/.cache/vllm/torch_compile_cache/51ad408d6c/rank_0_0/backbone for vLLM's torch.compile
(Worker_TP0 pid=2260) INFO 04-07 08:57:08 [backends.py:1111] Dynamo bytecode transform time: 5.76 s
(Worker_TP0 pid=2260) INFO 04-07 08:57:11 [backends.py:372] Cache the graph of compile range (1, 2048) for later use
(Worker_TP0 pid=2260) INFO 04-07 08:57:14 [backends.py:390] Compiling a graph for compile range (1, 2048) takes 6.20 s
(Worker_TP0 pid=2260) INFO 04-07 08:57:16 [decorators.py:640] saved AOT compiled function to /root/.cache/vllm/torch_compile_cache/torch_aot_compile/6dd5dc1ea5bb11cc82b96182855bff523fb6d4c16c51a02f10a3dc4af9be8489/rank_0_0/model
(Worker_TP0 pid=2260) INFO 04-07 08:57:16 [monitor.py:48] torch.compile took 14.04 s in total
(Worker_TP0 pid=2260) INFO 04-07 08:57:17 [monitor.py:76] Initial profiling/warmup run took 0.63 s
(Worker_TP0 pid=2260) INFO 04-07 08:57:22 [kv_cache_utils.py:829] Overriding num_gpu_blocks=0 with num_gpu_blocks_override=512
(Worker_TP0 pid=2260) INFO 04-07 08:57:22 [gpu_model_runner.py:5876] Profiling CUDA graph memory: PIECEWISE=51 (largest=512), FULL=35 (largest=256)
(Worker_TP1 pid=2261) INFO 04-07 08:57:22 [kv_cache_utils.py:829] Overriding num_gpu_blocks=0 with num_gpu_blocks_override=512
(Worker_TP1 pid=2261) INFO 04-07 08:57:22 [gpu_model_runner.py:5876] Profiling CUDA graph memory: PIECEWISE=51 (largest=512), FULL=35 (largest=256)
3.3 验证部署Qwen2.5-14B
curl http://localhost:8000/v1/models
{
    "object": "list",
    "data": [
        {
            "id": "/root/autodl-tmp/Qwen2.5-14B",
            "object": "model",
            "created": 1775523689,
            "owned_by": "vllm",
            "root": "/root/autodl-tmp/Qwen2.5-14B",
            "parent": null,
            "max_model_len": 32768,
            "permission": [
                {
                    "id": "modelperm-85be5bb9e5e2b9dd",
                    "object": "model_permission",
                    "created": 1775523689,
                    "allow_create_engine": false,
                    "allow_sampling": true,
                    "allow_logprobs": true,
                    "allow_search_indices": false,
                    "allow_view": true,
                    "allow_fine_tuning": false,
                    "organization": "*",
                    "group": null,
                    "is_blocking": false
                }
            ]
        }
    ]
}
root@autodl-container-3b0540a3f5-278e4735:~# curl http://localhost:8000/v1/chat/completions \
-H "Content-Type: application/json" \
-d '{
"model": "/root/autodl-tmp/Qwen2.5-14B",
"messages": [{"role": "user", "content": "你好,你是谁?"}]
}'
{"id":"chatcmpl-8b7546ccda4f14c9","object":"chat.completion","created":1775524082,"model":"/root/autodl-tmp/Qwen2.5-14B","choices":[{"index":0,"message":{"role":"assistant","content":"你好,我是由阿里云开发的大规模语言模型,称为通义千问。我可以参与各种对话,并提供信息和帮助。你有什么问题或需要讨论的话题吗?","refusal":null,"annotations":null,"audio":null,"function_call":null,"tool_calls":[],"reasoning":null},"logprobs":null,"finish_reason":"stop","stop_reason":null,"token_ids":null}],"service_tier":null,"system_fingerprint":null,"usage":{"prompt_tokens":34,"total_tokens":72,"completion_tokens":38,"prompt_tokens_details":null},"prompt_logprobs":null,"prompt_token_ids":null,"kv_transfer_params":null}
3.4 显卡使用情况
root@autodl-container-3b0540a3f5-278e4735:~# nvidia-smi
Tue Apr  7 09:06:09 2026
+-----------------------------------------------------------------------------------------+
| NVIDIA-SMI 580.76.05              Driver Version: 580.76.05      CUDA Version: 13.0     |
+-----------------------------------------+------------------------+----------------------+
| GPU  Name                 Persistence-M | Bus-Id          Disp.A | Volatile Uncorr. ECC |
| Fan  Temp   Perf          Pwr:Usage/Cap |           Memory-Usage | GPU-Util  Compute M. |
|                                         |                        |               MIG M. |
|=========================================+========================+======================|
|   0  NVIDIA GeForce RTX 5090        On  |   00000000:99:00.0 Off |                  N/A |
| 43%   25C    P8             13W /  575W |   31399MiB /  32607MiB |      0%      Default |
|                                         |                        |                  N/A |
+-----------------------------------------+------------------------+----------------------+
|   1  NVIDIA GeForce RTX 5090        On  |   00000000:AB:00.0 Off |                  N/A |
| 43%   25C    P8             11W /  575W |   31399MiB /  32607MiB |      0%      Default |
|                                         |                        |                  N/A |
+-----------------------------------------+------------------------+----------------------+

+-----------------------------------------------------------------------------------------+
| Processes:                                                                              |
|  GPU   GI   CI              PID   Type   Process name                        GPU Memory |
|        ID   ID                                                               Usage      |
|=========================================================================================|
|    0   N/A  N/A            2260      C   VLLM::Worker_TP0                      31390MiB |
|    1   N/A  N/A            2261      C   VLLM::Worker_TP1                      31390MiB |
+-----------------------------------------------------------------------------------------+
3.5 其他占用
root@autodl-container-3b0540a3f5-278e4735:~# ps -ef
UID         PID   PPID  C STIME TTY          TIME CMD
root          1      0  0 08:52 ?        00:00:00 bash /init/boot/boot.sh
root        893      1  1 08:52 ?        00:00:11 /bin/supervisord -c /init/supervisor/supervisor.ini
root        907    893  0 08:52 ?        00:00:01 autopanel serve --work-dir=/root/autodl-tmp --cache-dir=/root/autodl-tmp
root        913    893  0 08:52 ?        00:00:00 sshd: /usr/sbin/sshd -D [listener] 0 of 10-100 startups
root        915    893  0 08:52 ?        00:00:05 /root/miniconda3/bin/python /root/miniconda3/bin/tensorboard --host 0.0.0.0 --port 6007 --logdir /root/tf-logs
root        916    893  0 08:52 ?        00:00:00 proxy -c /init/proxy/proxy.ini
root        917    893  0 08:52 ?        00:00:01 /root/miniconda3/bin/python /root/miniconda3/bin/jupyter-lab --allow-root --config=/init/jupyter/jupyter_config.py
root        918    893  0 08:52 ?        00:00:00 proxy -c /init/proxy/proxy-hot-backup.ini
root       1024    915  0 08:52 ?        00:00:00 /root/miniconda3/lib/python3.12/site-packages/tensorboard_data_server/bin/server --logdir=/root/tf-logs --reload=5 --samples-per-
root       1307    913  0 08:52 ?        00:00:00 sshd: root@pts/0
root       1318   1307  0 08:52 pts/0    00:00:00 -bash
root       1458   1318  3 08:56 pts/0    00:00:19 python -m vllm.entrypoints.openai.api_server --model /root/autodl-tmp/Qwen2.5-14B --tensor-parallel-size 2 --host 0.0.0.0 --port
root       1995   1458  0 08:56 pts/0    00:00:00 /root/miniconda3/bin/python -c from multiprocessing.resource_tracker import main;main(45)
root       1996   1458  3 08:56 pts/0    00:00:22 VLLM::EngineCore
root       2260   1996 53 08:56 pts/0    00:05:26 VLLM::Worker_TP0
root       2261   1996 48 08:56 pts/0    00:04:59 VLLM::Worker_TP1
root       3035    913  0 08:56 ?        00:00:00 sshd: root@pts/1
root       3048   3035  0 08:56 pts/1    00:00:00 -bash
root       3736    913  0 09:06 ?        00:00:00 sshd: root@pts/2
root       3749   3736  0 09:06 pts/2    00:00:00 -bash
root       3799   3749  0 09:06 pts/2    00:00:00 ps -ef
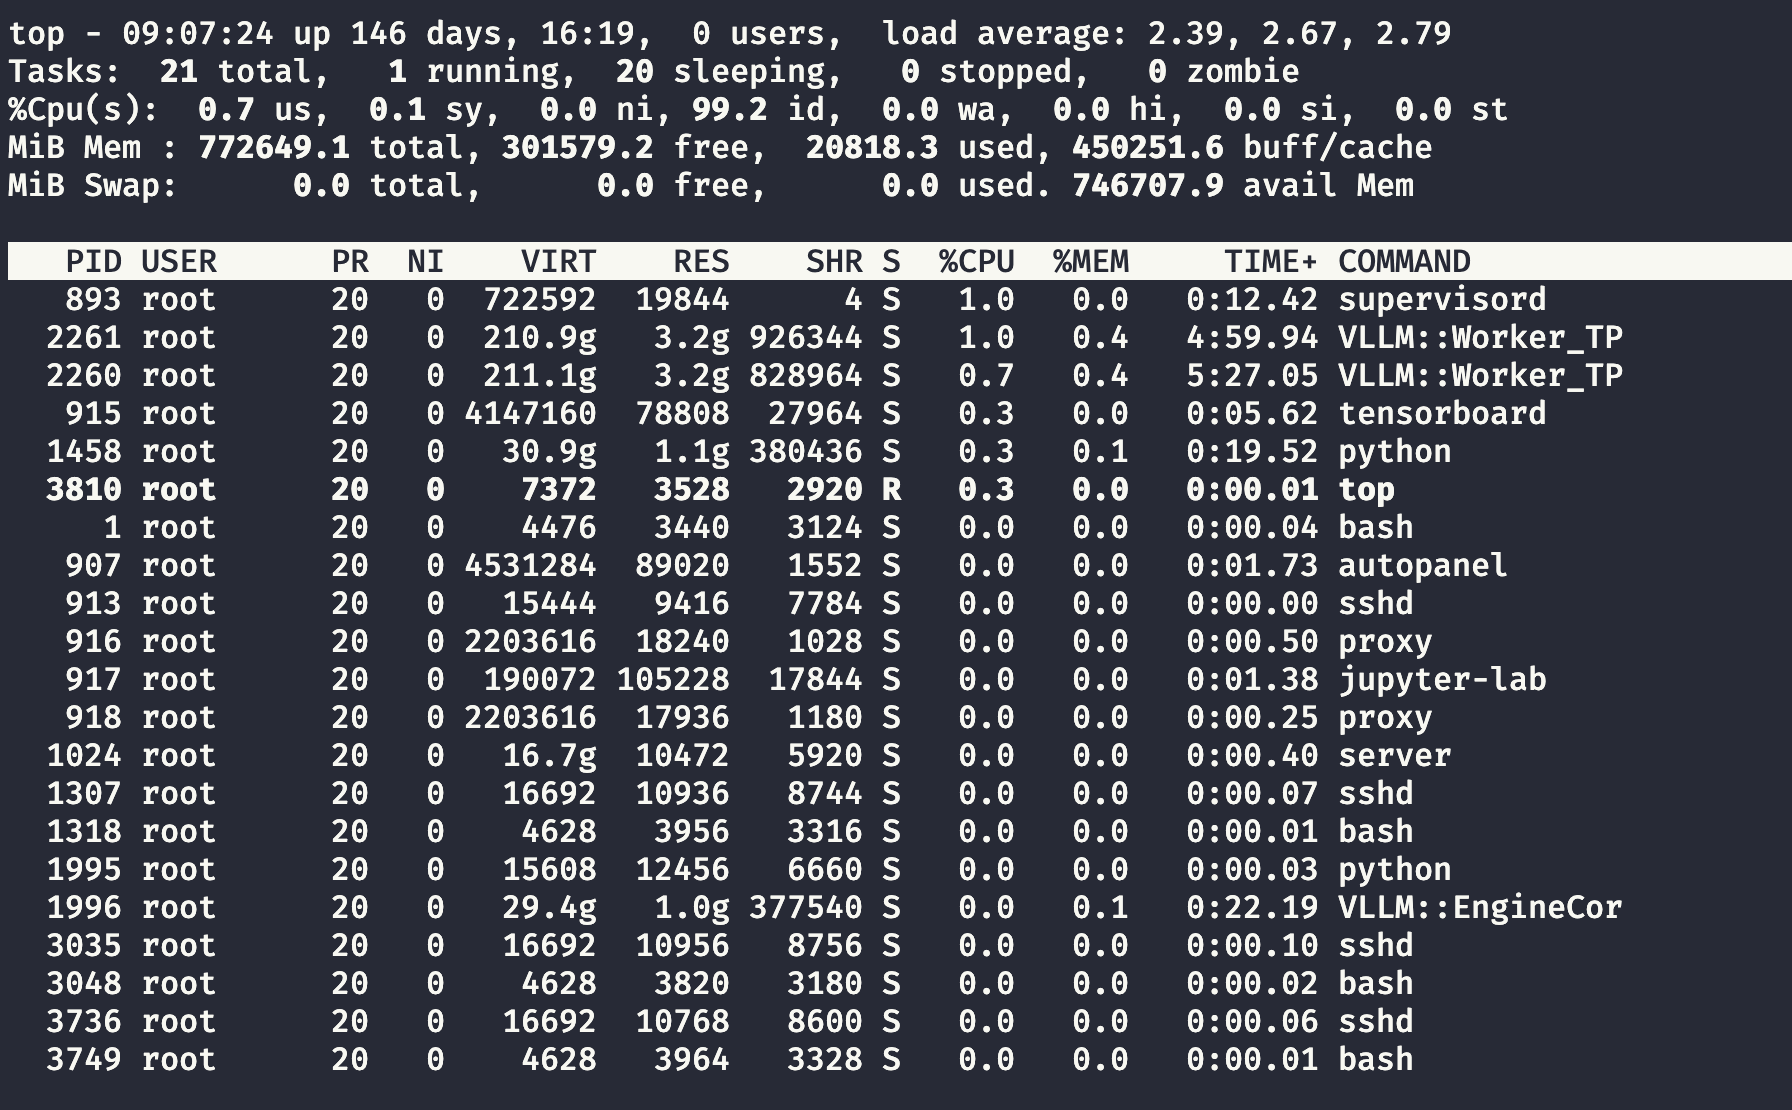
3.6 后台启动
root@autodl-container-3b0540a3f5-278e4735:~/autodl-tmp# unset OMP_NUM_THREADS
export CUDA_VISIBLE_DEVICES=0,1
nohup python -m vllm.entrypoints.openai.api_server \
--model /root/autodl-tmp/Qwen2.5-14B \
--tensor-parallel-size 2 \
--host 0.0.0.0 \
--port 8000 \
--dtype auto \
--gpu-memory-utilization 0.9 \
--max-model-len 4096 \
--trust-remote-code \
--enforce-eager \
root@autodl-container-3b0540a3f5-278e4735:~/autodl-tmp# tail -f -n 5000  vllm.log
nohup: ignoring input
(APIServer pid=10148) INFO 04-07 09:36:31 [utils.py:299]
(APIServer pid=10148) INFO 04-07 09:36:31 [utils.py:299]        █     █     █▄   ▄█
(APIServer pid=10148) INFO 04-07 09:36:31 [utils.py:299]  ▄▄ ▄█ █     █     █ ▀▄▀ █  version 0.19.0
(APIServer pid=10148) INFO 04-07 09:36:31 [utils.py:299]   █▄█▀ █     █     █     █  model   /root/autodl-tmp/Qwen2.5-14B
(APIServer pid=10148) INFO 04-07 09:36:31 [utils.py:299]    ▀▀  ▀▀▀▀▀ ▀▀▀▀▀ ▀     ▀
(APIServer pid=10148) INFO 04-07 09:36:31 [utils.py:299]
(APIServer pid=10148) INFO 04-07 09:36:31 [utils.py:233] non-default args: {'host': '0.0.0.0', 'model': '/root/autodl-tmp/Qwen2.5-14B', 'trust_remote_code': True, 'max_model_len': 4096, 'enforce_eager': True, 'served_model_name': ['Qwen2.5-14B'], 'tensor_parallel_size': 2}
(APIServer pid=10148) INFO 04-07 09:36:31 [model.py:549] Resolved architecture: Qwen2ForCausalLM
(APIServer pid=10148) INFO 04-07 09:36:31 [model.py:1678] Using max model len 4096
(APIServer pid=10148) INFO 04-07 09:36:31 [vllm.py:790] Asynchronous scheduling is enabled.
(APIServer pid=10148) WARNING 04-07 09:36:31 [vllm.py:848] Enforce eager set, disabling torch.compile and CUDAGraphs. This is equivalent to setting -cc.mode=none -cc.cudagraph_mode=none
(APIServer pid=10148) WARNING 04-07 09:36:31 [vllm.py:859] Inductor compilation was disabled by user settings, optimizations settings that are only active during inductor compilation will be ignored.
(APIServer pid=10148) INFO 04-07 09:36:31 [vllm.py:1025] Cudagraph is disabled under eager mode
(APIServer pid=10148) INFO 04-07 09:36:31 [compilation.py:290] Enabled custom fusions: norm_quant, act_quant
(EngineCore pid=10414) INFO 04-07 09:36:37 [core.py:105] Initializing a V1 LLM engine (v0.19.0) with config: model='/root/autodl-tmp/Qwen2.5-14B', speculative_config=None, tokenizer='/root/autodl-tmp/Qwen2.5-14B', skip_tokenizer_init=False, tokenizer_mode=auto, revision=None, tokenizer_revision=None, trust_remote_code=True, dtype=torch.bfloat16, max_seq_len=4096, download_dir=None, load_format=auto, tensor_parallel_size=2, pipeline_parallel_size=1, data_parallel_size=1, decode_context_parallel_size=1, dcp_comm_backend=ag_rs, disable_custom_all_reduce=False, quantization=None, enforce_eager=True, enable_return_routed_experts=False, kv_cache_dtype=auto, device_config=cuda, structured_outputs_config=StructuredOutputsConfig(backend='auto', disable_any_whitespace=False, disable_additional_properties=False, reasoning_parser='', reasoning_parser_plugin='', enable_in_reasoning=False), observability_config=ObservabilityConfig(show_hidden_metrics_for_version=None, otlp_traces_endpoint=None, collect_detailed_traces=None, kv_cache_metrics=False, kv_cache_metrics_sample=0.01, cudagraph_metrics=False, enable_layerwise_nvtx_tracing=False, enable_mfu_metrics=False, enable_mm_processor_stats=False, enable_logging_iteration_details=False), seed=0, served_model_name=Qwen2.5-14B, enable_prefix_caching=True, enable_chunked_prefill=True, pooler_config=None, compilation_config={'mode': <CompilationMode.NONE: 0>, 'debug_dump_path': None, 'cache_dir': '', 'compile_cache_save_format': 'binary', 'backend': 'inductor', 'custom_ops': ['all'], 'splitting_ops': [], 'compile_mm_encoder': False, 'cudagraph_mm_encoder': False, 'encoder_cudagraph_token_budgets': [], 'encoder_cudagraph_max_images_per_batch': 0, 'compile_sizes': [], 'compile_ranges_endpoints': [2048], 'inductor_compile_config': {'enable_auto_functionalized_v2': False, 'size_asserts': False, 'alignment_asserts': False, 'scalar_asserts': False, 'combo_kernels': True, 'benchmark_combo_kernel': True}, 'inductor_passes': {}, 'cudagraph_mode': <CUDAGraphMode.NONE: 0>, 'cudagraph_num_of_warmups': 0, 'cudagraph_capture_sizes': [], 'cudagraph_copy_inputs': False, 'cudagraph_specialize_lora': True, 'use_inductor_graph_partition': False, 'pass_config': {'fuse_norm_quant': True, 'fuse_act_quant': True, 'fuse_attn_quant': False, 'enable_sp': False, 'fuse_gemm_comms': False, 'fuse_allreduce_rms': False}, 'max_cudagraph_capture_size': 0, 'dynamic_shapes_config': {'type': <DynamicShapesType.BACKED: 'backed'>, 'evaluate_guards': False, 'assume_32_bit_indexing': False}, 'local_cache_dir': None, 'fast_moe_cold_start': True, 'static_all_moe_layers': []}
(EngineCore pid=10414) WARNING 04-07 09:36:37 [multiproc_executor.py:1014] Reducing Torch parallelism from 64 threads to 1 to avoid unnecessary CPU contention. Set OMP_NUM_THREADS in the external environment to tune this value as needed.
(EngineCore pid=10414) INFO 04-07 09:36:37 [multiproc_executor.py:134] DP group leader: node_rank=0, node_rank_within_dp=0, master_addr=127.0.0.1, mq_connect_ip=172.17.0.5 (local), world_size=2, local_world_size=2
(Worker pid=10679) INFO 04-07 09:36:43 [parallel_state.py:1400] world_size=2 rank=0 local_rank=0 distributed_init_method=tcp://127.0.0.1:46691 backend=nccl
(Worker pid=10680) INFO 04-07 09:36:44 [parallel_state.py:1400] world_size=2 rank=1 local_rank=1 distributed_init_method=tcp://127.0.0.1:46691 backend=nccl
(Worker pid=10679) <frozen importlib._bootstrap_external>:1297: FutureWarning: The cuda.cudart module is deprecated and will be removed in a future release, please switch to use the cuda.bindings.runtime module instead.
(Worker pid=10679) <frozen importlib._bootstrap_external>:1297: FutureWarning: The cuda.nvrtc module is deprecated and will be removed in a future release, please switch to use the cuda.bindings.nvrtc module instead.
(Worker pid=10679) INFO 04-07 09:36:44 [pynccl.py:111] vLLM is using nccl==2.27.5
(Worker pid=10680) <frozen importlib._bootstrap_external>:1297: FutureWarning: The cuda.cudart module is deprecated and will be removed in a future release, please switch to use the cuda.bindings.runtime module instead.
(Worker pid=10680) <frozen importlib._bootstrap_external>:1297: FutureWarning: The cuda.nvrtc module is deprecated and will be removed in a future release, please switch to use the cuda.bindings.nvrtc module instead.
(Worker pid=10679) WARNING 04-07 09:36:45 [symm_mem.py:66] SymmMemCommunicator: Device capability 12.0 not supported, communicator is not available.
(Worker pid=10680) WARNING 04-07 09:36:45 [symm_mem.py:66] SymmMemCommunicator: Device capability 12.0 not supported, communicator is not available.
(Worker pid=10680) WARNING 04-07 09:36:45 [custom_all_reduce.py:165] Custom allreduce is disabled because your platform lacks GPU P2P capability or P2P test failed. To silence this warning, specify disable_custom_all_reduce=True explicitly.
(Worker pid=10679) WARNING 04-07 09:36:45 [custom_all_reduce.py:165] Custom allreduce is disabled because your platform lacks GPU P2P capability or P2P test failed. To silence this warning, specify disable_custom_all_reduce=True explicitly.
(Worker pid=10679) INFO 04-07 09:36:45 [parallel_state.py:1716] rank 0 in world size 2 is assigned as DP rank 0, PP rank 0, PCP rank 0, TP rank 0, EP rank N/A, EPLB rank N/A
(Worker_TP0 pid=10679) INFO 04-07 09:36:45 [gpu_model_runner.py:4735] Starting to load model /root/autodl-tmp/Qwen2.5-14B...
(Worker_TP0 pid=10679) INFO 04-07 09:36:45 [cuda.py:334] Using FLASH_ATTN attention backend out of potential backends: ['FLASH_ATTN', 'FLASHINFER', 'TRITON_ATTN', 'FLEX_ATTENTION'].
(Worker_TP0 pid=10679) INFO 04-07 09:36:45 [flash_attn.py:596] Using FlashAttention version 2
Loading safetensors checkpoint shards:   0% Completed | 0/8 [00:00<?, ?it/s]
Loading safetensors checkpoint shards:  12% Completed | 1/8 [00:00<00:02,  2.51it/s]
Loading safetensors checkpoint shards:  25% Completed | 2/8 [00:00<00:02,  2.15it/s]
Loading safetensors checkpoint shards:  38% Completed | 3/8 [00:01<00:02,  2.08it/s]
Loading safetensors checkpoint shards:  50% Completed | 4/8 [00:01<00:01,  2.02it/s]
Loading safetensors checkpoint shards:  62% Completed | 5/8 [00:02<00:01,  2.02it/s]
Loading safetensors checkpoint shards:  75% Completed | 6/8 [00:02<00:00,  2.03it/s]
Loading safetensors checkpoint shards:  88% Completed | 7/8 [00:03<00:00,  2.04it/s]
Loading safetensors checkpoint shards: 100% Completed | 8/8 [00:03<00:00,  2.62it/s]
Loading safetensors checkpoint shards: 100% Completed | 8/8 [00:03<00:00,  2.26it/s]
(Worker_TP0 pid=10679)
(Worker_TP0 pid=10679) INFO 04-07 09:36:49 [default_loader.py:384] Loading weights took 3.55 seconds
(Worker_TP0 pid=10679) INFO 04-07 09:36:49 [gpu_model_runner.py:4820] Model loading took 13.93 GiB memory and 3.697453 seconds
(Worker_TP0 pid=10679) INFO 04-07 09:36:51 [gpu_worker.py:436] Available KV cache memory: 13.61 GiB
(EngineCore pid=10414) INFO 04-07 09:36:51 [kv_cache_utils.py:1319] GPU KV cache size: 148,704 tokens
(EngineCore pid=10414) INFO 04-07 09:36:51 [kv_cache_utils.py:1324] Maximum concurrency for 4,096 tokens per request: 36.30x
(Worker_TP0 pid=10679) 2026-04-07 09:36:51,624 - INFO - autotuner.py:262 - flashinfer.jit: [Autotuner]: Autotuning process starts ...
(Worker_TP1 pid=10680) 2026-04-07 09:36:51,624 - INFO - autotuner.py:262 - flashinfer.jit: [Autotuner]: Autotuning process starts ...
(Worker_TP0 pid=10679) 2026-04-07 09:36:51,639 - INFO - autotuner.py:268 - flashinfer.jit: [Autotuner]: Autotuning process ends
(Worker_TP1 pid=10680) 2026-04-07 09:36:51,639 - INFO - autotuner.py:268 - flashinfer.jit: [Autotuner]: Autotuning process ends
(EngineCore pid=10414) INFO 04-07 09:36:51 [core.py:283] init engine (profile, create kv cache, warmup model) took 1.95 seconds
(EngineCore pid=10414) INFO 04-07 09:36:52 [vllm.py:790] Asynchronous scheduling is enabled.
(EngineCore pid=10414) WARNING 04-07 09:36:52 [vllm.py:848] Enforce eager set, disabling torch.compile and CUDAGraphs. This is equivalent to setting -cc.mode=none -cc.cudagraph_mode=none
(EngineCore pid=10414) WARNING 04-07 09:36:52 [vllm.py:859] Inductor compilation was disabled by user settings, optimizations settings that are only active during inductor compilation will be ignored.
(EngineCore pid=10414) INFO 04-07 09:36:52 [vllm.py:1025] Cudagraph is disabled under eager mode
(EngineCore pid=10414) INFO 04-07 09:36:52 [compilation.py:290] Enabled custom fusions: norm_quant, act_quant
(APIServer pid=10148) INFO 04-07 09:36:52 [api_server.py:590] Supported tasks: ['generate']
(APIServer pid=10148) WARNING 04-07 09:36:53 [model.py:1435] Default vLLM sampling parameters have been overridden by the model's `generation_config.json`: `{'repetition_penalty': 1.05, 'temperature': 0.7, 'top_k': 20, 'top_p': 0.8}`. If this is not intended, please relaunch vLLM instance with `--generation-config vllm`.
(APIServer pid=10148) INFO 04-07 09:36:53 [hf.py:314] Detected the chat template content format to be 'string'. You can set `--chat-template-content-format` to override this.
(APIServer pid=10148) INFO 04-07 09:36:53 [api_server.py:594] Starting vLLM server on http://0.0.0.0:8000
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:37] Available routes are:
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /openapi.json, Methods: HEAD, GET
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /docs, Methods: HEAD, GET
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /docs/oauth2-redirect, Methods: HEAD, GET
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /redoc, Methods: HEAD, GET
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /tokenize, Methods: POST
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /detokenize, Methods: POST
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /load, Methods: GET
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /version, Methods: GET
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /health, Methods: GET
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /metrics, Methods: GET
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /v1/models, Methods: GET
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /ping, Methods: GET
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /ping, Methods: POST
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /invocations, Methods: POST
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /v1/chat/completions, Methods: POST
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /v1/chat/completions/batch, Methods: POST
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /v1/responses, Methods: POST
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /v1/responses/{response_id}, Methods: GET
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /v1/responses/{response_id}/cancel, Methods: POST
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /v1/completions, Methods: POST
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /v1/messages, Methods: POST
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /v1/messages/count_tokens, Methods: POST
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /inference/v1/generate, Methods: POST
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /scale_elastic_ep, Methods: POST
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /is_scaling_elastic_ep, Methods: POST
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /v1/chat/completions/render, Methods: POST
(APIServer pid=10148) INFO 04-07 09:36:53 [launcher.py:46] Route: /v1/completions/render, Methods: POST
(APIServer pid=10148) INFO:     Started server process [10148]
(APIServer pid=10148) INFO:     Waiting for application startup.
(APIServer pid=10148) INFO:     Application startup complete.
(APIServer pid=10148) INFO:     127.0.0.1:58736 - "POST /v1/chat/completions HTTP/1.1" 200 OK
(APIServer pid=10148) INFO 04-07 09:37:23 [loggers.py:259] Engine 000: Avg prompt throughput: 3.6 tokens/s, Avg generation throughput: 6.9 tokens/s, Running: 0 reqs, Waiting: 0 reqs, GPU KV cache usage: 0.0%, Prefix cache hit rate: 0.0%
(APIServer pid=10148) INFO 04-07 09:37:33 [loggers.py:259] Engine 000: Avg prompt throughput: 0.0 tokens/s, Avg generation throughput: 0.0 tokens/s, Running: 0 reqs, Waiting: 0 reqs, GPU KV cache usage: 0.0%, Prefix cache hit rate: 0.0%
3.7 通用 vLLM 部署脚本 run_vllm.sh
#!/bin/bash

###########################################################
#
#           【请在这里修改你的配置参数】
#
###########################################################

# 模型文件所在的本机目录
MODEL_PATH="/root/autodl-tmp/Qwen2.5-14B"

# 对外显示的模型名称
SERVED_MODEL_NAME="Qwen2.5-14B"

# 显卡编号  双卡=0,1  单卡=0
CUDA_DEVICES="0,1"

# 张量并行(几张显卡跑)
TENSOR_PARALLEL_SIZE=2

# 端口
PORT=8000

# 最大上下文长度
MAX_MODEL_LEN=4096

# 显存占用率
GPU_MEM_UTIL=0.9

# 精度 auto / bfloat16 / float16
DTYPE="auto"

# 日志文件路径
LOG_FILE="vllm_service.log"

###########################################################
#
#           【下面的内容不用动】
#
###########################################################

# 清理环境变量
unset OMP_NUM_THREADS
export CUDA_VISIBLE_DEVICES=$CUDA_DEVICES

# 停止旧服务(避免端口冲突)
echo "🔸 停止旧的 vLLM 服务..."
pkill -f "vllm.entrypoints.openai.api_server" > /dev/null 2>&1
sleep 2

# 后台启动服务
echo "🔸 启动 vLLM 服务中,请稍候..."
nohup python -m vllm.entrypoints.openai.api_server \
--model $MODEL_PATH \
--tensor-parallel-size $TENSOR_PARALLEL_SIZE \
--host 0.0.0.0 \
--port $PORT \
--dtype $DTYPE \
--gpu-memory-utilization $GPU_MEM_UTIL \
--max-model-len $MAX_MODEL_LEN \
--trust-remote-code \
--enforce-eager \
--served-model-name $SERVED_MODEL_NAME > $LOG_FILE 2>&1 &

# 获取PID
PID=$!
sleep 3

# 检查是否启动成功
if ps -p $PID > /dev/null; then
    echo ""
    echo "============================================================"
    echo "✅  vLLM 服务启动成功!"
    echo ""
    echo "📌 服务PID:            $PID"
    echo "📌 模型路径:           $MODEL_PATH"
    echo "📌 模型名称:           $SERVED_MODEL_NAME"
    echo "📌 服务端口:           $PORT"
    echo "📌 显卡:               $CUDA_DEVICES"
    echo "📌 最大上下文:         $MAX_MODEL_LEN"
    echo "📌 日志文件:           $LOG_FILE"
    echo ""
    echo "🔍 查看实时日志:        tail -f $LOG_FILE"
    echo "⏹️  停止服务:           kill -9 $PID  或者  pkill -f vllm"
    echo "🌐 访问地址:           http://localhost:$PORT/v1"
    echo "============================================================"
    echo ""
else
    echo "❌ 服务启动失败!请检查日志:tail -f $LOG_FILE"
fi
赋权运行
chmod +x run_vllm.sh
./run_vllm.sh
运行后看到的效果
🔸 停止旧的 vLLM 服务...
🔸 启动 vLLM 服务中,请稍候...

============================================================
✅  vLLM 服务启动成功!

📌 服务PID:           12345
📌 模型路径:           /root/autodl-tmp/Qwen2.5-14B
📌 模型名称:           Qwen2.5-14B
📌 服务端口:           8000
📌 显卡:               0,1
📌 最大上下文:         4096
📌 日志文件:           vllm_service.log

🔍 查看实时日志:        tail -f vllm_service.log
⏹️  停止服务:          kill -9 12345  或者  pkill -f vllm
🌐 访问地址:           http://localhost:8000/v1
============================================================
更多推荐


 1
 0
- 0


 已为社区贡献4条内容

所有评论(0)