
大数据运维:分布式集群基础配置全攻略
在大数据技术栈中,环境配置往往是初学者面临的第一道门槛。很多初学者在搭建 Hadoop 等分布式集群时,常常因为网络配置、SSH 免密登录等问题耗费大量时间。
本文将结合实操细节与运维核心理念,手把手教你完成分布式集群的基础环境配置,为后续的大数据组件部署打下坚实基础。
📚 目录
- 环境准备与网络规划
- 网络配置核心(NAT模式与静态IP)
- 系统环境优化(防火墙与时钟)
- JDK 与 Java 环境搭建
- 集群克隆与唯一性配置
- SSH 免密登录原理与实战
- 大数据运维的核心思考
1. 环境准备与网络规划 🌐
在开始之前,我们需要明确集群的网络架构。生产环境中,我们通常追求网络隔离与IP管理的便捷性。
- 网络模式选择:
- 桥接模式: 虚拟机与物理机同处一个网段,适合小型测试,但容易受物理网络变动影响。
- NAT 模式(推荐): 虚拟机通过物理机共享 IP。生产环境常用,能有效解决 IP 地址不足问题,并保证集群内部的独立性。
检查上网状态: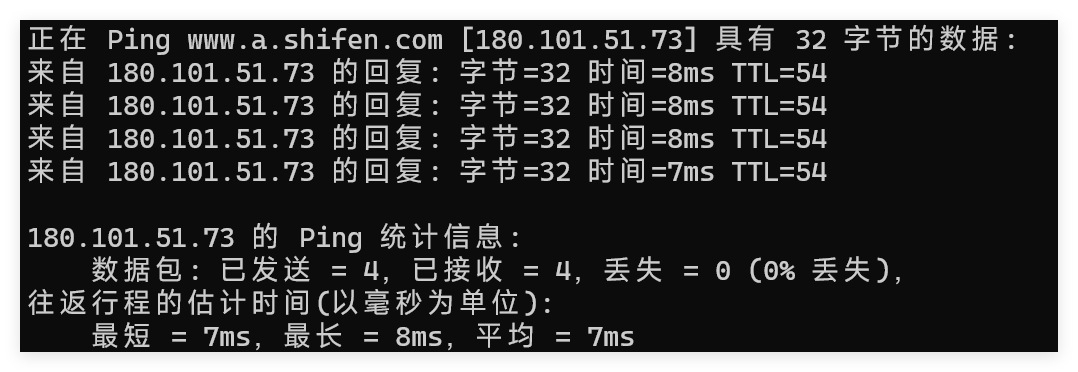
📝 集群规划示例:
表格
| 主机名 | IP 地址 | 角色 |
|---|---|---|
| bigdata01 | 192.168.2.128 | Master / NameNode |
| bigdata02 | 192.168.2.129 | Slave / DataNode |
| bigdata03 | 192.168.2.130 | Slave / DataNode |
2. 网络配置核心:NAT 模式与静态 IP ⚙️
为了让集群节点之间能够稳定通信,我们必须将动态 IP(DHCP)改为静态 IP。
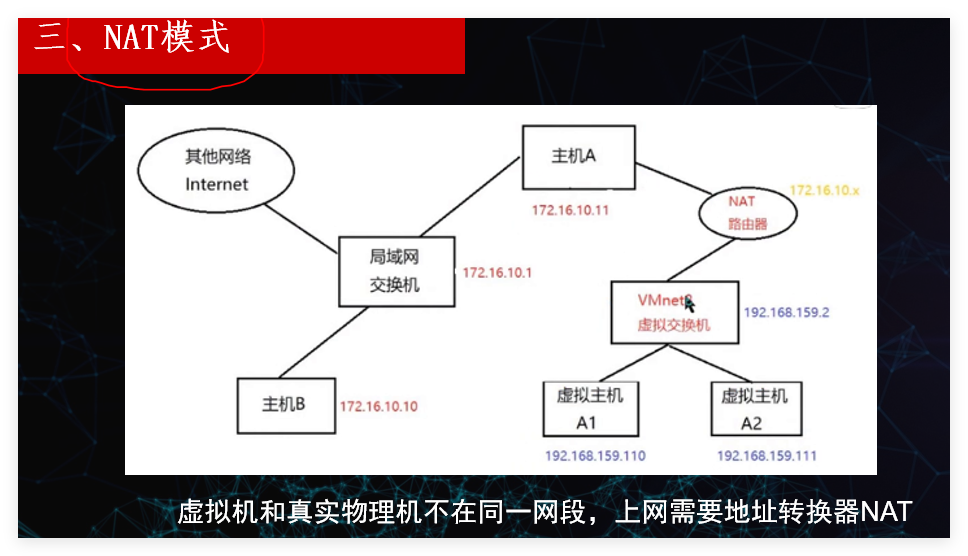 步骤 1:查看网关
在 VMware 中,点击 编辑 -> 虚拟网络编辑器,查看 NAT 模式的子网 IP 和网关 IP(例如网关为 192.168.2.2)。
步骤 2:修改网络配置文件
登录 Linux,编辑网卡配置文件:
vi /etc/sysconfig/network-scripts/ifcfg-ens33
关键参数修改如下:
BOOTPROTO=static(将 dhcp 改为 static)ONBOOT=yes(开机自启)IPADDR=192.168.2.128(根据规划设置)NETMASK=255.255.255.0(子网掩码)GATEWAY=192.168.2.2(网关)DNS1=119.29.29.29(公共 DNS)
步骤 3:配置 Hosts 映射
为了让机器能通过名字(而非 IP)互相访问,需修改 /etc/hosts 文件:
192.168.2.128 bigdata01
192.168.2.129 bigdata02
192.168.2.130 bigdata03
💡 运维小贴士: 这一步在 Windows 物理机上也需要同步修改(路径:
C:\Windows\System32\drivers\etc\hosts),以便从本地进行连接测试。
步骤 4:重启网络
systemctl restart network.service
3. 系统环境优化:防火墙与时钟同步 ⏰
为什么需要关闭防火墙?
在集群环境中,节点之间需要通过各种端口(如 HDFS 的 9000,YARN 的 8088 等)进行高频通信。如果防火墙未关闭,很容易导致“乌龙事件”——服务明明启动了,却无法访问。在学习阶段,建议关闭防火墙。
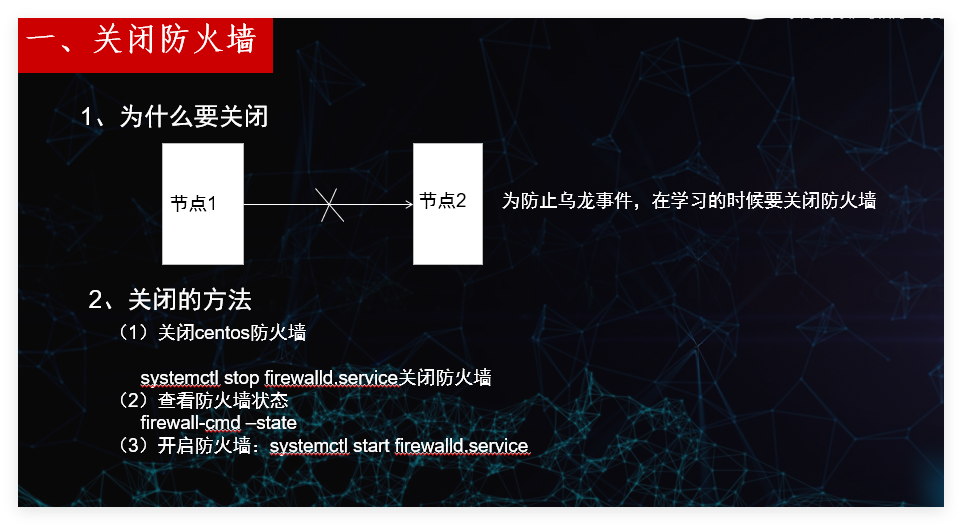
- 关闭防火墙命令:
systemctl stop firewalld.service
systemctl disable firewalld.service
时钟同步的重要性
大数据处理对时间敏感。如果集群中各节点时间不一致,可能会导致任务执行异常或数据错乱。
- 安装并启动 NTP:
yum install ntp ntpdate -y
systemctl start ntpd
systemctl enable ntpd
# 手动同步一次
ntpdate -u ntp1.aliyun.com
4. 安装开发环境 JDK ☕
Hadoop 是基于 Java 开发的,因此必须配置 JDK 环境。
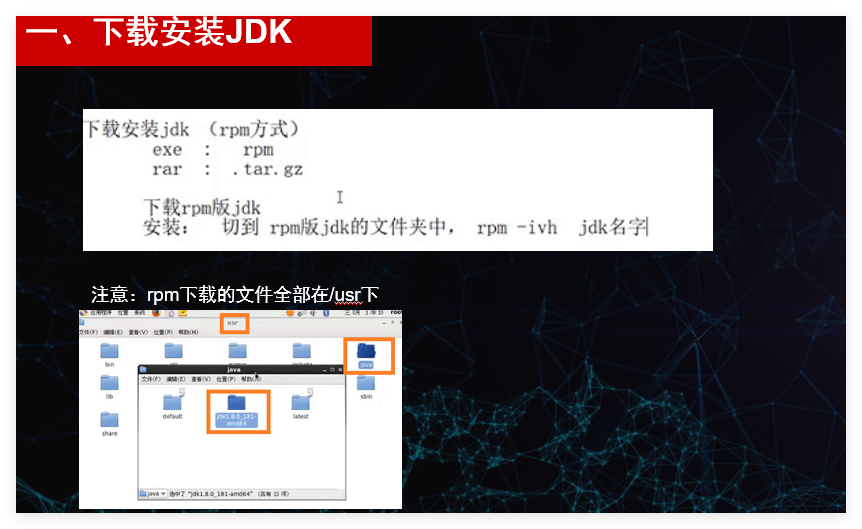
- 上传并解压 JDK 到
/usr/local/或/opt/目录。 - 配置环境变量 (
/etc/profile):export JAVA_HOME=/usr/java/jdk1.8.0_181-amd64 export PATH=$PATH:$JAVA_HOME/bin - 生效配置:
source /etc/profile - 验证: 输入
java -version,若显示版本号则成功。
5. 集群克隆与唯一性配置 🖥️
为了快速搭建多节点环境,我们通常采用“模板机克隆”法。
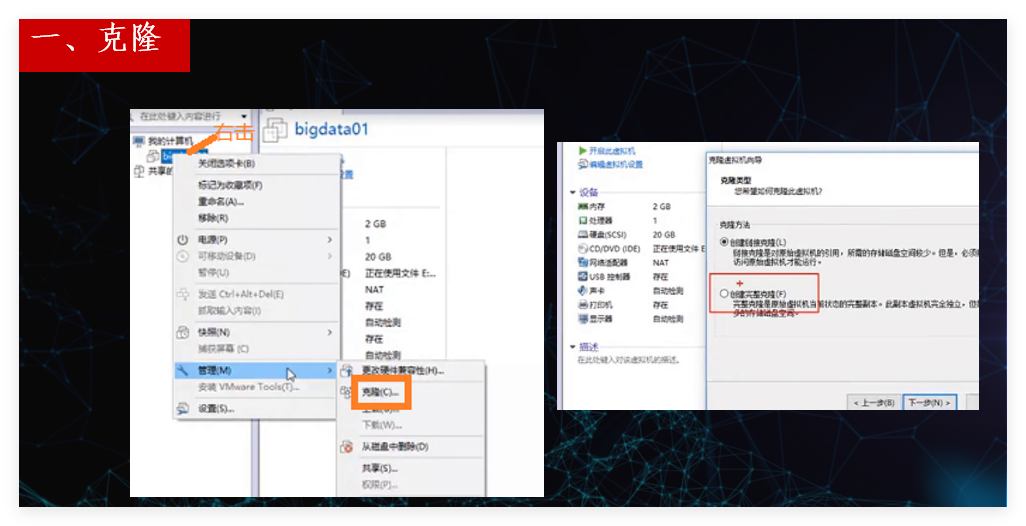
克隆后的“三步清洗” (非常重要!)
直接克隆的虚拟机可能会导致 IP 冲突或 MAC 地址重复,必须进行以下操作:
- 删除网卡规则文件 (CentOS 7 以前):
删除/etc/udev/rules.d/70-persistent-net.rules文件,防止 MAC 地址冲突。 - 修改主机名:
hostnamectl set-hostname bigdata02 - 重置网卡 MAC 地址:
在 VMware 设置中移除网卡并重新添加,或者删除配置文件中的HWADDR和UUID字段,让系统自动生成。
6. SSH 免密登录原理与切换用户 🔑
❓ 为什么要配置免密登录?
在分布式集群中,Master 节点需要通过 SSH 远程登录到各个 Slave 节点来启动或停止进程(如 start-dfs.sh)。如果每次都需要手动输入密码,自动化脚本将无法执行。
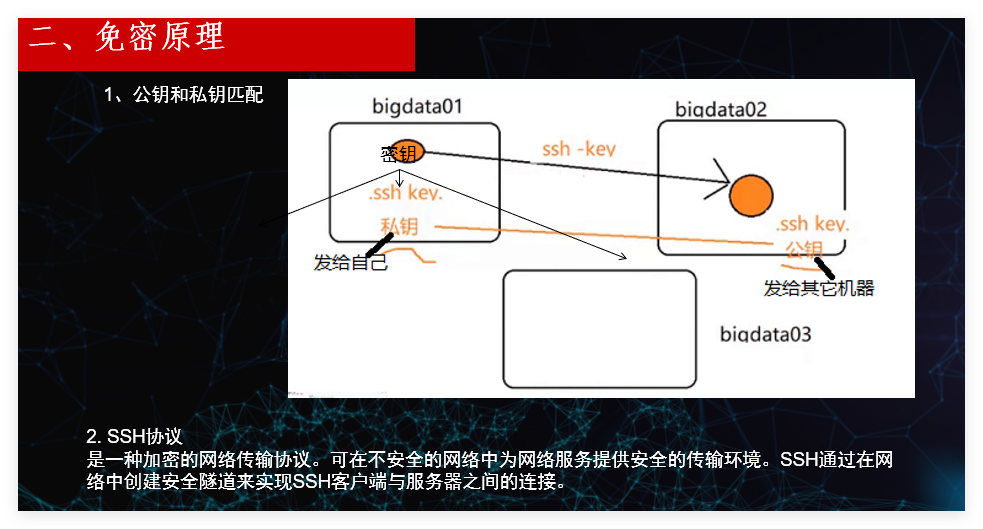
原理: 基于非对称加密(RSA)。将公钥(id_rsa.pub)放入目标服务器的 ~/.ssh/authorized_keys 中,私钥(id_rsa)保留在本地。
配置步骤:
- 生成密钥对:
ssh-keygen -t rsa # 一路回车(不设置密码) - 分发公钥:
# 发送给本机(如果需要伪分布式) ssh-copy-id localhost # 发送给集群其他节点 ssh-copy-id bigdata02 ssh-copy-id bigdata03 - 测试:
ssh bigdata02
# 如果无需输入密码直接登录,则配置成功
在Linux中,我们经常需要在不同用户之间切换,主要使用 su 命令。
切换到普通用户
当你需要以一个普通用户的身份执行某些操作时,可以使用:
su 用户名
例如,切换到名为 py 的普通用户:
su py
切换到超级用户(root)
当你需要执行管理员权限的操作时,可以切换到root用户:
su root
7. 大数据运维的核心思考 💡
环境配置只是运维的起点。根据大数据运维的实战经验,一个优秀的运维体系应包含以下核心要素:
- 自动化监控: 使用 Prometheus + Grafana 实时监控集群健康状态,设置阈值触发告警,将故障消灭在萌芽状态。
- 资源调度: 基于 YARN 或 Kubernetes 实现资源的动态分配,根据负载自动扩展计算节点,避免资源浪费。
- 安全合规: 实施 RBAC 权限控制,定期审计访问日志,确保数据安全。
- 性能优化: 采用列式存储(如 Parquet/ORC)降低 I/O 开销,合理配置 Spark 的内存与并行度,避免 GC 瓶颈。
结语: “工欲善其事,必先利其器”。通过以上步骤,你已经成功搭建了一个标准的分布式集群基础环境。接下来,就可以在这个稳定的基石上部署 Hadoop、Spark 等强大的大数据组件了!
📎 常见问题排查 (FAQ)
表格
| 问题现象 | 可能原因 | 解决方案 |
|---|---|---|
| ping: unknown host | DNS 解析失败 | 检查 /etc/resolv.conf 或网卡配置中的 DNS 设置 |
| Connection refused | SSH 服务未启动 | 检查 systemctl status sshd |
| 克隆机 IP 不变 | 网卡配置残留 | 删除 /etc/udev/rules.d/ 下的规则文件,重启系统 |
| 时间不同步 | NTP 未配置 | 手动执行 ntpdate -u pool.ntp.org |
最后
如果你觉得这篇文章对你有帮助,欢迎点赞、收藏并关注我的博客。在大数据的道路上,让我们一起成长!
版权声明: 本文为博主原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接和本声明。
更多推荐


 5
 0
- 0


 已为社区贡献4条内容

所有评论(0)