
企业为什么越来越重视大模型私有化?
很多企业在体验了公有云大模型的惊艳后,反而陷入了深深的焦虑:他们不敢把核心的财务报表、研发代码和客户名单传给网上的“黑盒”。于是,大模型“私有化部署”成为了数字化转型的绝对刚需。企业做 AI,真正关键的不是在公网上调用多么聪明的接口,而是如何在绝对安全的环境下,打造属于自己的“数字大脑”。对于绝大多数具有核心壁垒的企业来说,把数据交给别人炼丹,无异于交出自己的灵魂。逐米时代长期聚焦大模型的本地化、私有化 AI 落地,我们深知:私有化部署不是把模型装进服务器那么简单,而是为企业建立一套安全、可控、可持续的智能底座。
 图 1:在 AI 时代,企业的数据防火墙面临着前所未有的挑战
一、为什么公有云模型让老板们“夜不能寐”?
2023年春天,发生了一件震动全球科技圈的事件:韩国三星电子允许其半导体工程师使用 ChatGPT 协助工作。仅仅不到20天,就发生了三起严重的机密数据泄露事故。工程师们为了图方便,把半导体设备的测量数据、甚至极其机密的芯片良品率修复代码,直接粘贴到了公有云对话框中。
这些大模型公司真的是恶意的黑客吗?并不是。问题出在大模型的底层逻辑上:公有云大模型的养料,就是用户的输入。你今天为了查错而上传的绝密代码,很可能会变成明天大模型提供给竞争对手的“自动补全建议”。
这就好比一家米其林餐厅,为了图省事,把独家秘方交给了公共加工厂去熬制高汤。用不了多久,满大街都会是你的味道。因此,企业对大模型私有化的渴望,本质上是一场 “数字主权的觉醒” ——我们的核心数据,绝对不能离开企业的防火墙。
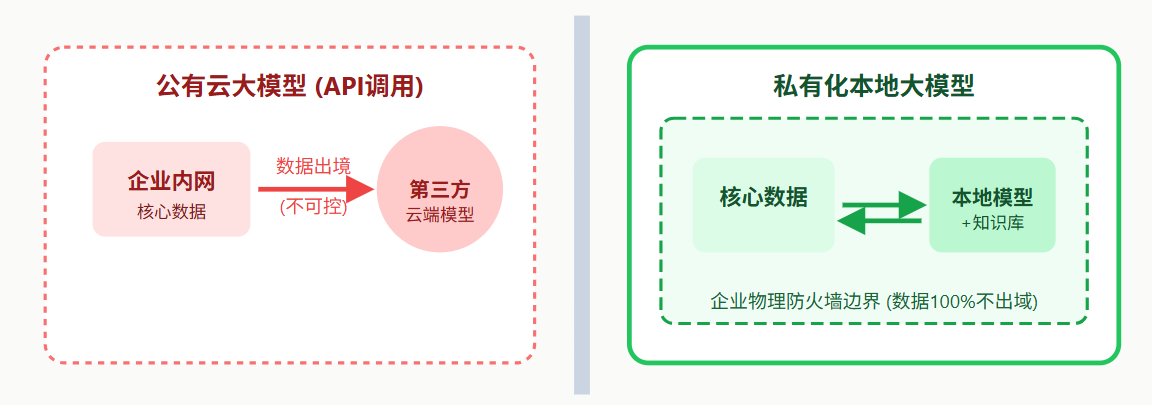 图 2:公有云与私有化部署在数据流向上的本质区别
二、 老板们在“私有化”上常踩的 3 个认知陷阱
然而,当企业下定决心要把大模型“搬回家”时,往往又会因为对技术边界的误解,踩进高昂的陷阱:
- 陷阱一:以为私有化 = 买几台昂贵的算力服务器。
硬件迷信是最大的毒药。很多企业一拍脑袋,花了上千万买了一堆顶级的 GPU 服务器放在机房。结果发现,机器是有了,但公司里根本没有懂大模型微调、懂 RAG(检索增强生成)工程的团队。最终,千万级的高端服务器,沦为了跑开源测试代码的测试机。私有化部署不是购买硬件的物理动作,而是构建一套包含算力、模型、知识库和工程流的 AI 基础设施。 - 陷阱二:参数崇拜,非千亿参数大模型不用。
很多技术主管在本地部署时,盲目追求类似 GPT-4 那样具有几千亿参数的庞然大物。实际上,对于绝大多数企业垂直场景(如阅读合同、查阅规章、代码审查),一个经过企业私域数据精心微调的 14B(140亿参数)或 32B 的中型模型,不仅足够聪明,而且推理速度极快,硬件成本只需前者的十分之一。 - 陷阱三:以为部署完就一劳永逸。
有些企业把开源模型下载到本地,装上就宣布“AI 上线”。其实没有结合企业知识库的模型,就像个失忆的巨婴。如果不搭建本地的数据处理管线,不进行业务系统的 API 集成,这个本地模型永远只能是个“玩具终端”。
三、大模型私有化的“三大硬核价值”
跳出误区,我们来看看一个真正落地的私有化大模型,能为企业带来怎样无可替代的价值?总结起来就是六个字:安全、可控、可持续。
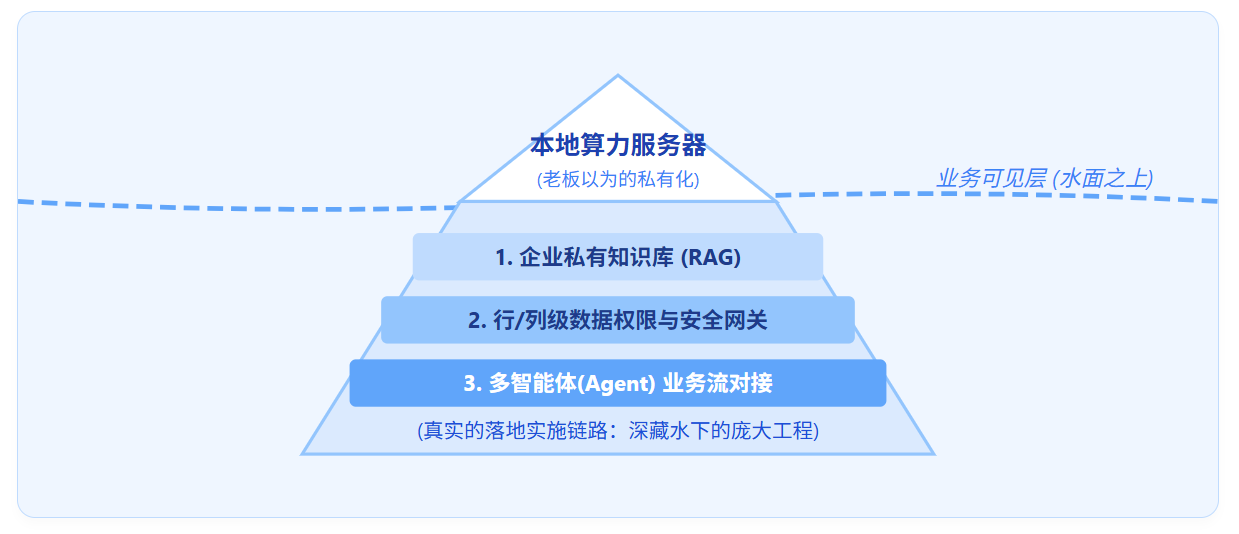 图 3:私有化部署是一个系统工程,绝非仅仅是购买硬件
1. 绝对的安全:斩断数据泄露的源头
私有化部署最大的底气,就是“物理隔离”。无论是研发部门几百万行的源代码、财务部门的季度敏感报表,还是招投标团队客户底价,全部在企业内部机房消化。切断外网连接,从物理和架构层面彻底杜绝了被“投毒”或泄露的可能。
2. 深度的可控:让 AI 严守企业的规矩
公有云模型是“不可控”的,它的回答具有随机性,你无法决定它的立场。但在私有化环境下,企业可以通过指令微调(SFT)和安全网关,为大模型设定严格的“护栏”。更重要的是,私有化部署能够和企业内部的 OA 权限体系无缝打通——高管问 AI 能看到全局利润,而基层销售问 AI 只能看到自己片区的政策,这是公有云 API 永远无法做到的。
3. 长期的可持续:资产的沉淀而非流失
租用公有云,一旦停止付费,你的智能系统瞬间瘫痪,过去积累的对话习惯全部归零。而私有化部署,是为企业添置了一笔“固定资产”。随着员工的不断使用、业务数据的不断灌入,这个本地模型的智商会越来越高,越来越懂你们公司的业务。它是一项能随着时间增值的长期投资。
在大模型时代,数据的处理能力就是企业新的“呼吸权”。如果你把呼吸机插在别人的插座上,就永远要面临被拔掉电源的风险。企业大模型的终局,必然是走向基于私有数据的本地化部署。
更多推荐


 0
 0
- 0


 已为社区贡献56条内容

所有评论(0)