
Ollama部署微调大模型
·
学习任务
1.LLama Factory自定义多轮对话数据集
2.LoRA与QLoRA
3.大模型转换为 GGUF 以及使用 ollama 运行
案例:Qwen模型转换为 GGUF 以及使用 ollama 部署
LoRA与QLoRA
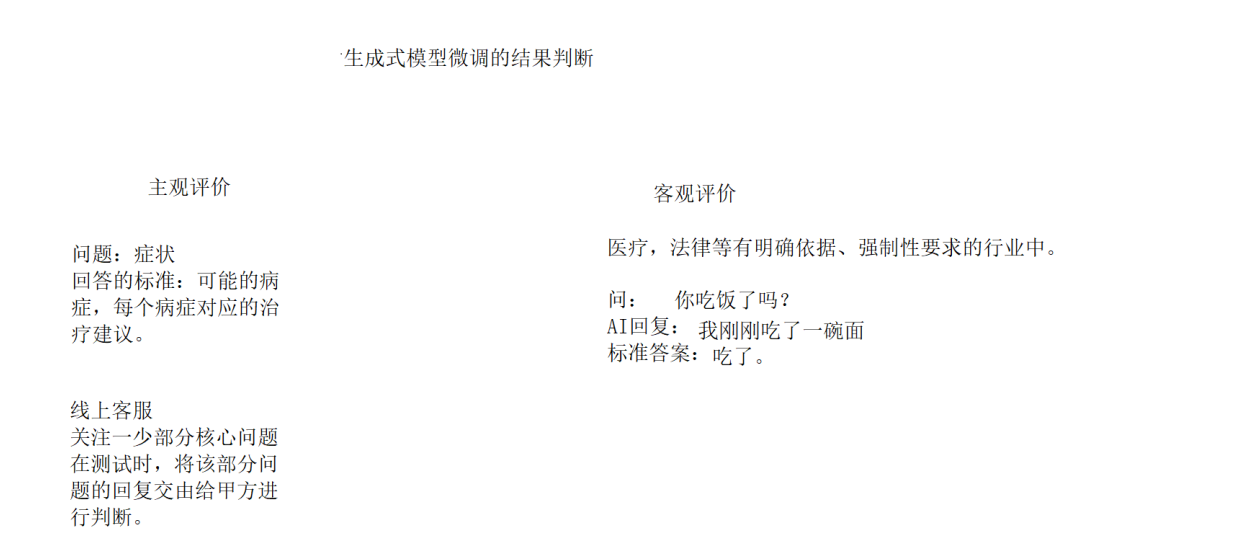
LoRA:LoRA 是一种用于微调大型语言模型的技术,通过低秩近
似方法降低适应数十亿参数模型(如 GPT-3)到特定任务或领域。
QLoRA:QLoRA 是一种高效的大型语言模型微调方法,它显著降
低了内存使用量,同时保持了全 16 位微调的性能。它通过在一个
固定的、4 位量化的预训练语言模型中反向传播梯度到低秩适配
器来实现这一目标。
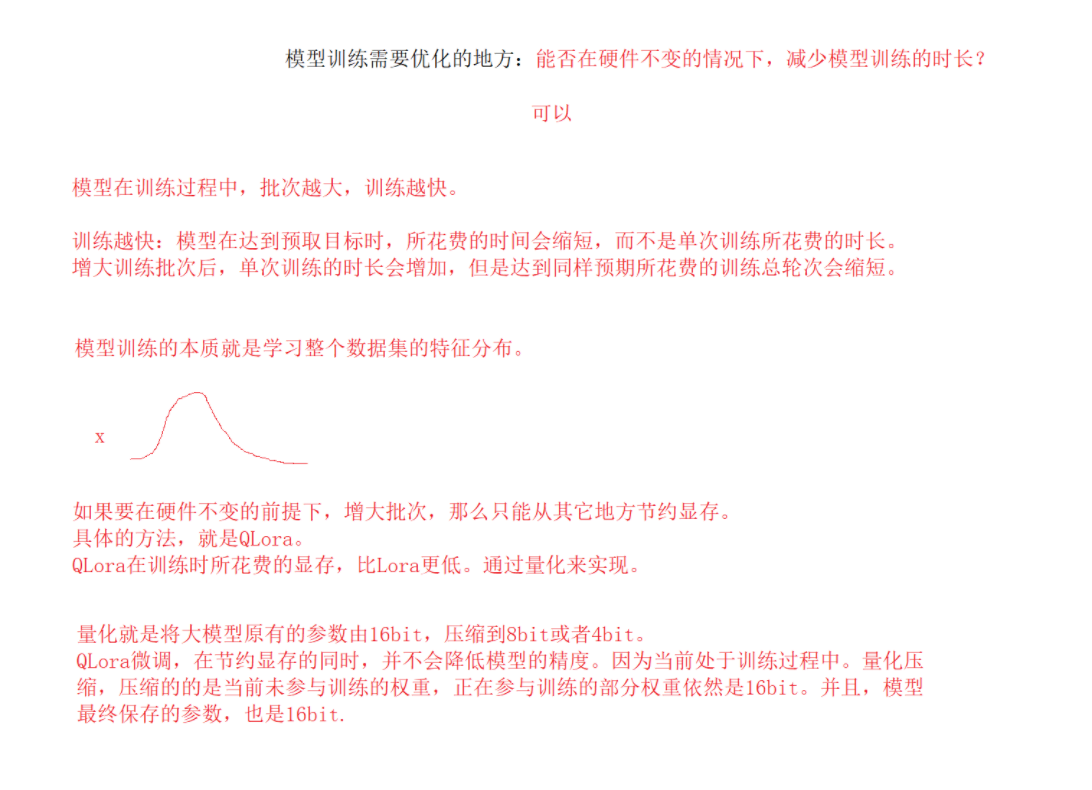
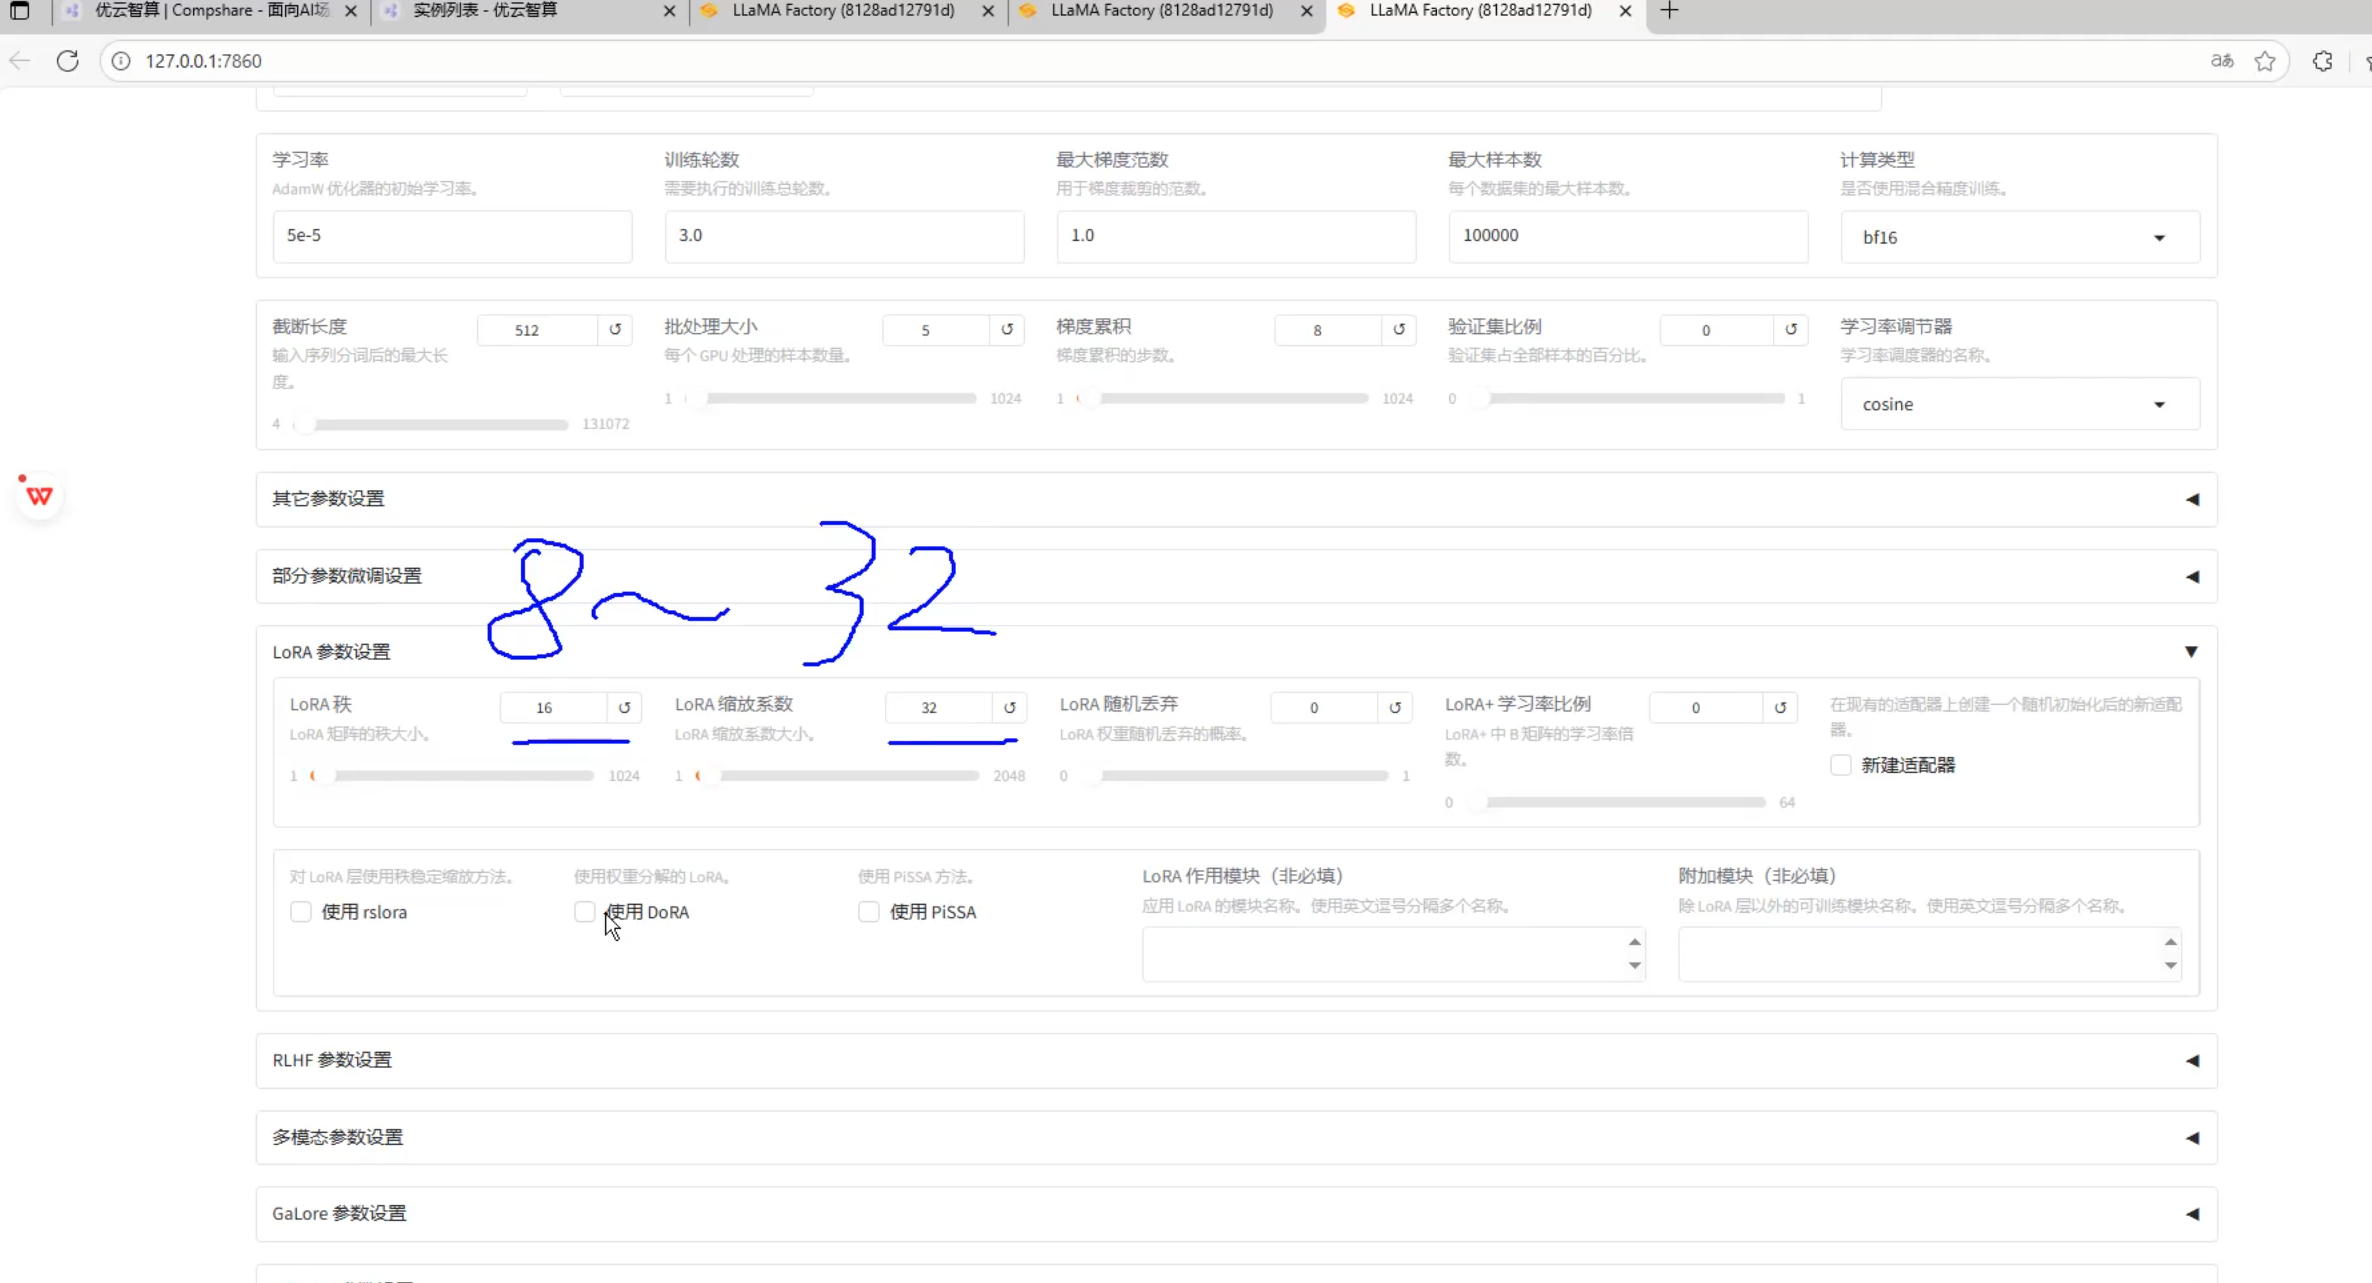
LoRA秩和LoRA缩放系数是1:2的关系
什么是 GGUF
GGUF 格式的全名为(GPT-Generated Unified Format),提到 GGUF 就不得不提到它的前身 GGML(GPT-Generated Model Language)。GGML 是专门为了机器学习设计的张量库,最早可以追溯到 2022/10。其目的是为了有一个单文件共享的格式,并且易于在不同架构的 GPU 和 CPU 上进行推理。但在后续的开发中,遇到了灵活性不足、相容性及难以维护的问题。
为什么要转换 GGUF 格式
在传统的 Deep Learning Model 开发中大多使用 PyTorch 来进行开发,但因为在部署时会面临相依 Li rbrary 太多、版本管理的问题于才有了 GGML、GGMF、GGJT 等格式,而在开源社群不停的迭代后 GGUF 就诞生了。
GGUF 实际上是基于 GGJT 的格式进行优化的,并解决了 GGML 当初面临的问题,包括:
1)可扩展性:轻松为 GGML 架构下的工具添加新功能,或者向 GGUF 模型添加新 Feature,不会破坏与现有模型的兼容性。
2)对 mmap(内存映射)的兼容性:该模型可以使用 mmap 进行加载(原理解析可见参考),实现快速载入和存储。(从 GGJT 开始导入,可参考 GitHub)
3)易于使用:模型可以使用少量代码轻松加载和存储,无需依赖的 Library,同时对于不同编程语言支持程度也高。
4)模型信息完整:加载模型所需的所有信息都包含在模型文件中,不需要额外编写设置文件。
5)有利于模型量化:GGUF 支持模型量化(4 位、8 位、F 16),在 GPU 变得越来越昂贵的情况下,节省 vRAM 成本也非常重要。
1. 将hf模型转换为GGUF
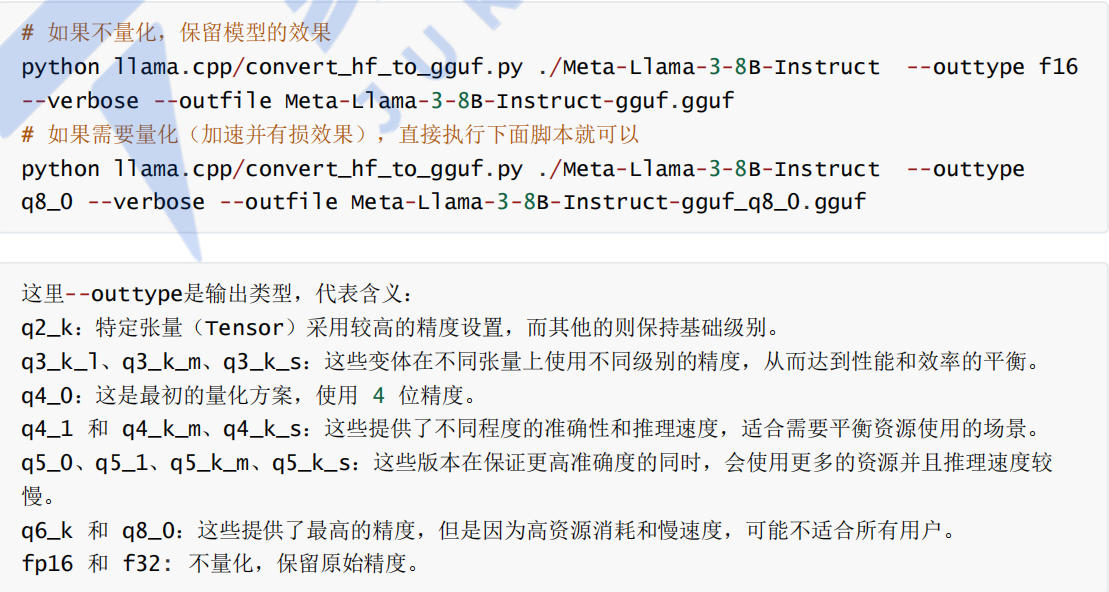
1.1 需要用llama.cpp仓库的convert_hf_to_gguf.py脚本来转换
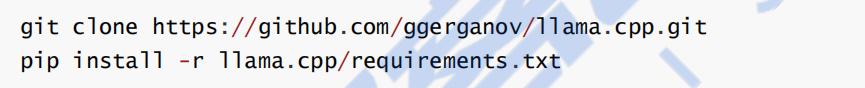
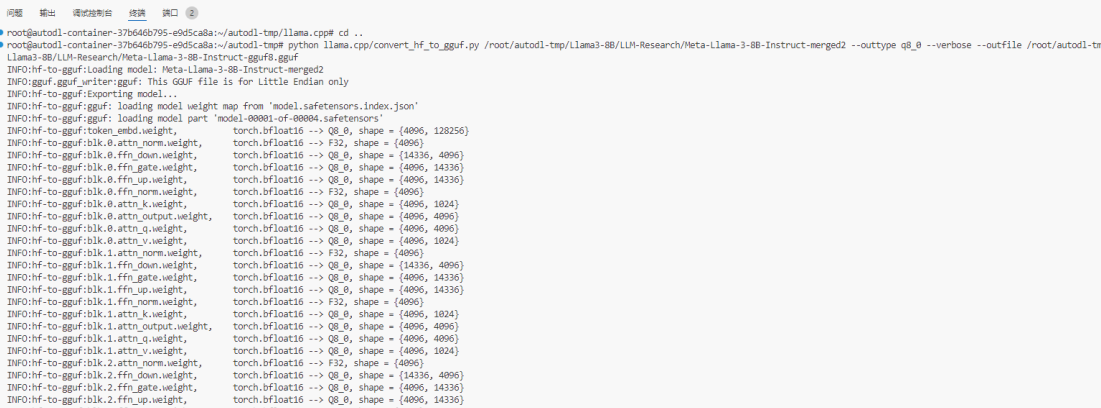
1.2 执行转换
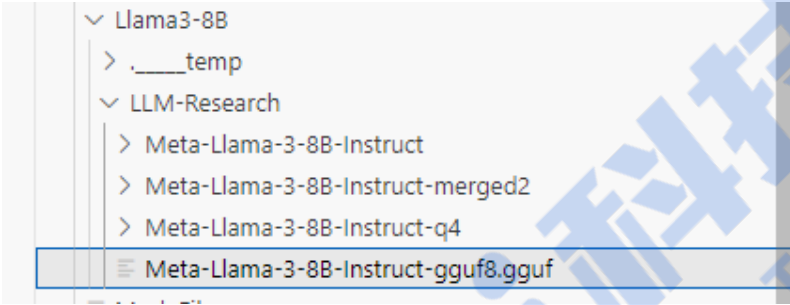
1.3 转换后的模型
2. 使用ollama运行gguf
2.1 安装ollama

2.2 启动ollama服务
2.3 创建ModelFile
复制模型路径,创建名为“ModelFile”的meta文件,内容如下

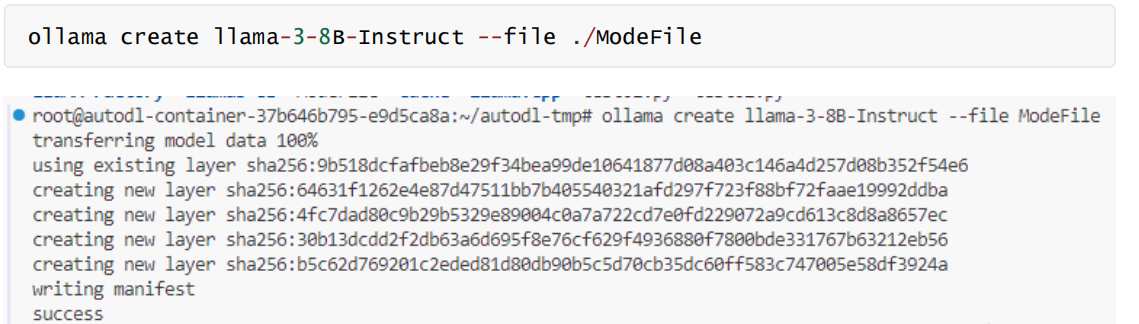
2.4 创建自定义模型
使用ollama create命令创建自定义模型
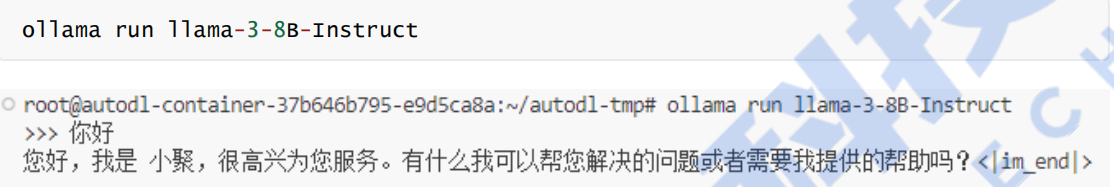
2.5 运行模型:
更多推荐


 8
 0
- 0


 已为社区贡献9条内容

所有评论(0)