
Telegraf 在工业物联网与边缘计算中的专业分析
适用场景:工业物联网、边缘网关、生产数据采集、时序数据平台、设备可观测性、预测性维护、能耗管理与质量分析。
前言
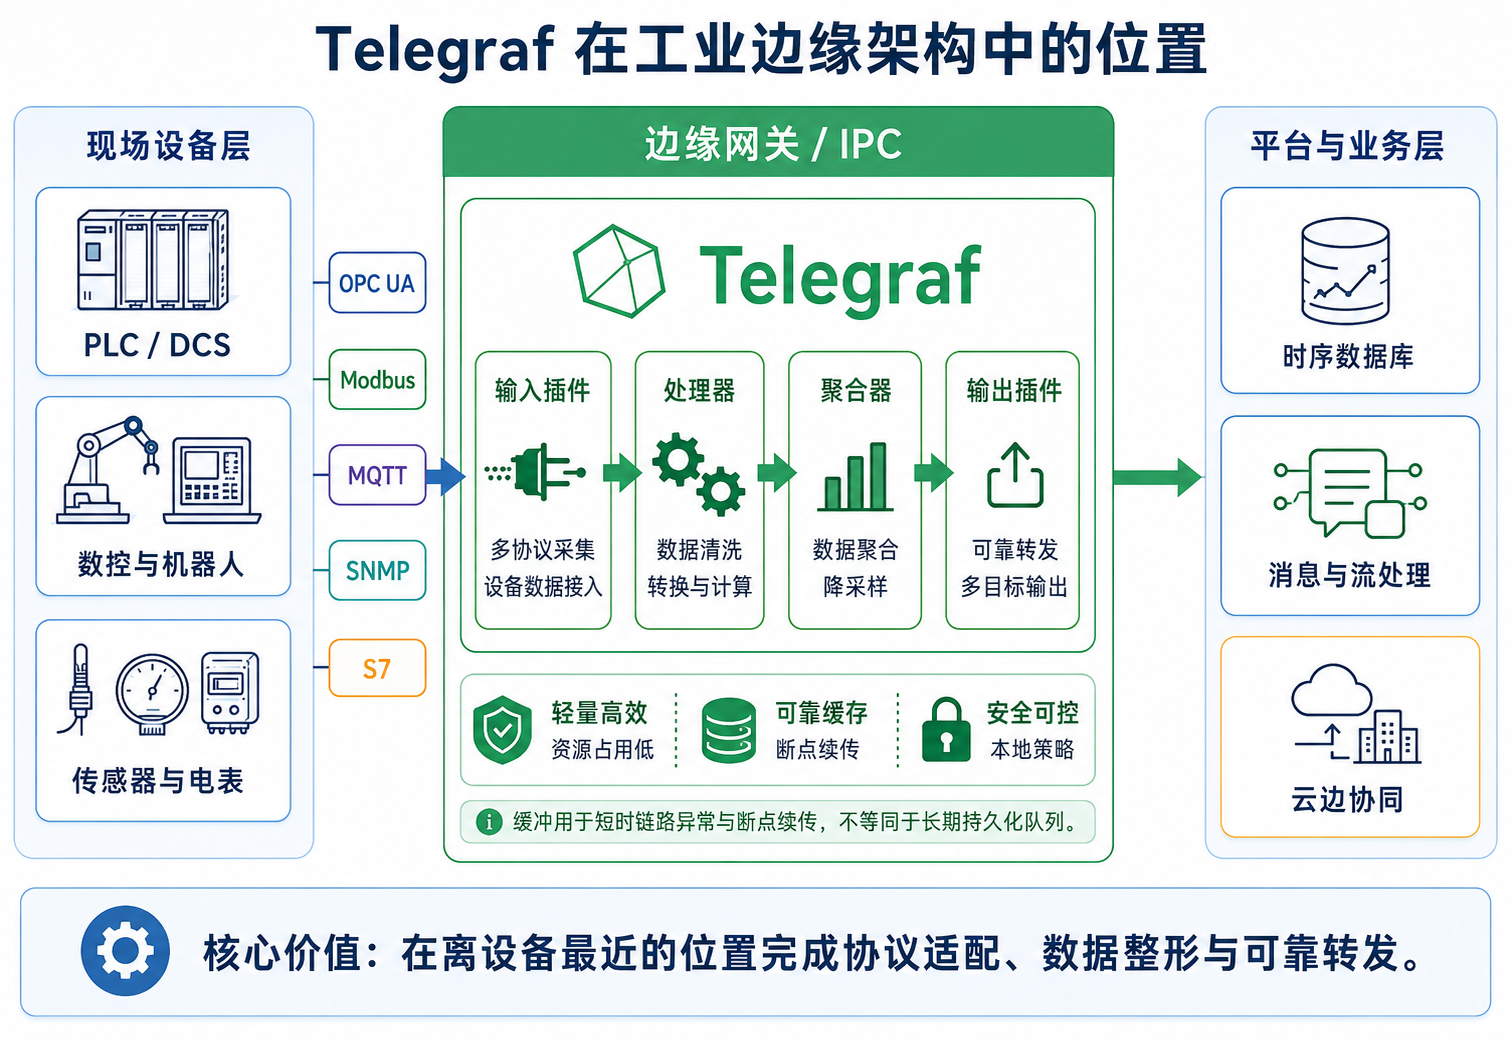
在工业物联网项目中,真正困难的往往不是“有没有数据”,而是设备协议异构、点位语义不统一、网络边界复杂、生产系统不能被采集逻辑扰动,以及上云链路在弱网下不稳定。Telegraf 的价值,正是在设备与平台之间提供一个轻量、插件化、可配置的边缘采集层:它可以靠输入插件连接 OPC UA、Modbus、MQTT、SNMP、Siemens S7 等数据源;靠处理器与聚合器在边缘完成类型转换、标签补齐、降采样、窗口统计;再通过输出插件写入时序数据库、消息总线或可观测平台。
如果把工业数据平台看成一条链路,Telegraf 不应该被理解为“普通采集脚本”,而应该被设计为“边缘数据平面”的基础组件。它离设备足够近,能降低协议适配和带宽压力;又离平台足够远,能把设备层的不稳定性隔离在边缘侧。对于需要快速接入产线数据、构建设备健康指标、做能耗分析或预测性维护的团队,Telegraf 是一个非常值得优先评估的工具。
一、为什么工业物联网需要边缘采集层
典型工业现场与互联网应用不同。互联网系统的数据源通常是应用、日志、数据库或云服务 API,而工业现场的数据源来自 PLC、DCS、SCADA、HMI、传感器、电表、机器人、数控机床、交换机、UPS 等设备。这些设备分布在不同产线、不同车间、不同网络区域,协议、点表、采样周期和安全策略都可能不同。
工业物联网的数据链路通常会遇到以下问题:
- 协议异构:OPC UA、Modbus TCP/RTU、MQTT、SNMP、S7、HTTP、文件、串口网关等并存。
- 点位语义缺失:寄存器地址或节点 ID 本身并不等于业务语义,需要补充产线、设备、工位、单位、缩放系数、质量码等上下文。
- 生产网络隔离:控制网络不应直接暴露给云端平台,采集代理需要在边缘网关或 DMZ 区域完成协议适配。
- 弱网与链路抖动:工厂网络可能跨厂区、跨运营商、跨 VPN,写出端不可用时必须有缓冲与降级策略。
- 采样频率差异:有些点位需要秒级采样,有些只需分钟级聚合,盲目全量上送会浪费带宽和存储。
- 运维变更敏感:一次点表改动、证书更新或输出目标变更,都可能影响生产数据链路,需要可审计、可回滚。
边缘采集层的目标不是替代 MES、SCADA、Historian 或云平台,而是在它们之间形成一个稳定的数据适配层。它负责“接入、清洗、标准化、缓冲、分发”,让上层平台看到的是统一、可分析、可治理的指标,而不是一堆散乱的设备点位。
二、Telegraf 是什么
Telegraf 是 InfluxData 维护的开源数据采集代理。官方文档将它定位为插件驱动的服务端代理,具备超过 300 个插件,支持收集、处理、聚合和写出指标。它的核心特点可以概括为:
- 插件化:输入、处理器、聚合器、输出、解析器、序列化器、密钥存储等能力都通过插件扩展。
- 轻量化:通常以单进程代理运行,适合部署在工业网关、边缘 IPC、虚拟机、容器或边缘 Kubernetes 节点。
- 配置驱动:主要通过 TOML 配置描述采集周期、插件参数、处理逻辑和输出目标。
- 时序友好:指标天然包含 measurement、tags、fields、timestamp,非常适合进入时序数据库和可观测平台。
- 边缘适配能力强:支持工业协议、消息队列、系统指标、网络设备、云服务、日志和文件等多类数据源。
从工业物联网视角看,Telegraf 的核心意义不是“多一个采集工具”,而是让数据团队用统一方式管理不同设备、不同协议和不同输出平台之间的映射关系。
三、Telegraf 的数据流水线
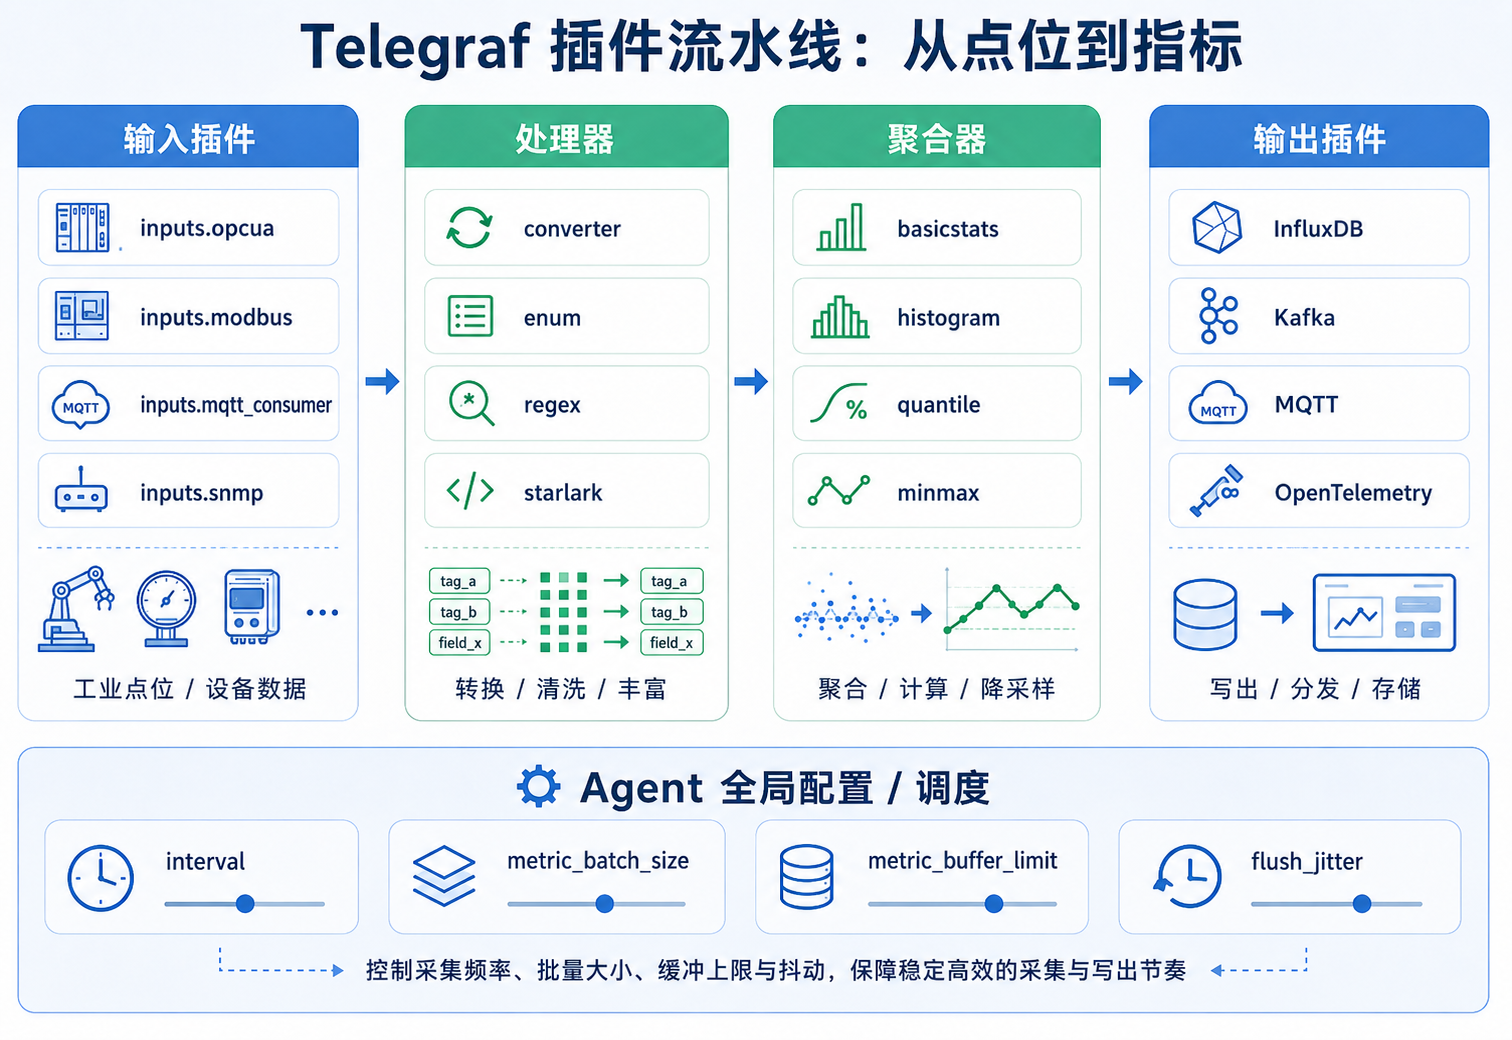
Telegraf 的典型链路可以理解为四段:输入插件采集数据,处理器插件修改或补充指标,聚合器插件按时间窗口生成统计值,输出插件把指标写到目标系统。
1. 输入插件:把设备数据接进来
输入插件负责连接数据源。工业现场常见输入包括:
- OPC UA:适合具备语义模型、节点浏览、质量码和证书机制的自动化系统。
- Modbus:适合电表、仪表、变频器、温控器等寄存器型设备。
- MQTT Consumer:适合边缘传感器、网关、设备 SDK 主动上报。
- SNMP:适合交换机、UPS、路由器、网管设备等 OT 网络基础设施。
- Siemens S7Comm:适合西门子 PLC 变量采集场景。
输入插件的关键设计点是:不要只把点位“读出来”,还要尽量在采集侧绑定设备资产、单位、质量码和协议来源,否则后续数据治理成本会快速升高。
2. 处理器插件:把原始数据变成可治理指标
处理器插件用于在指标写出前做转换。工业场景中常见处理包括:
- 字段类型转换:把字符串、整数、浮点数、布尔量标准化。
- 标签补齐:补充 site、workshop、line、cell、asset、protocol、unit 等标签。
- 点位命名标准化:把不同设备厂商的变量命名映射到统一指标名。
- 过滤与脱敏:丢弃低价值字段,避免把敏感信息写出到不该去的平台。
- 质量码处理:把坏点、超时、通信失败与真实测量值区分开。
处理器越靠近数据源,越能减少后续平台的混乱。尤其是多工厂、多产线项目,标签治理比采集本身更重要。
3. 聚合器插件:在边缘做降采样与窗口统计
并不是所有数据都需要原始频率上送。对振动、能耗、温度、压力等高频或中频数据,可以在边缘侧按窗口生成均值、最大值、最小值、分位数、直方图或基础统计值。
这样做有三点收益:
- 降低上云带宽和时序库写入压力。
- 让业务看板直接消费更稳定的统计指标。
- 在网络不稳定时优先保留关键摘要信息。
需要注意的是,边缘聚合不应盲目替代原始数据。对于事故追溯、质量根因分析、高频振动诊断等场景,仍然可能需要保留原始高频数据或进入专门的边缘 Historian。
4. 输出插件:把指标送到合适的位置
Telegraf 支持多类输出目标,包括时序数据库、消息总线、文件、可观测平台和云服务。工业场景常见输出策略包括:
- 写入 InfluxDB 或其他时序数据库,用于趋势分析、告警和仪表盘。
- 写入 Kafka、MQTT、NATS 等消息系统,用于解耦实时消费。
- 写入 OpenTelemetry 生态,用于统一可观测链路。
- 在边缘写文件或本地缓存,用于弱网、审计或补偿导入。
工程上建议不要让一个输出承担所有职责。关键指标可以写时序库,事件流可以进消息总线,审计数据可以落本地文件或对象存储。
四、工业协议与插件选型
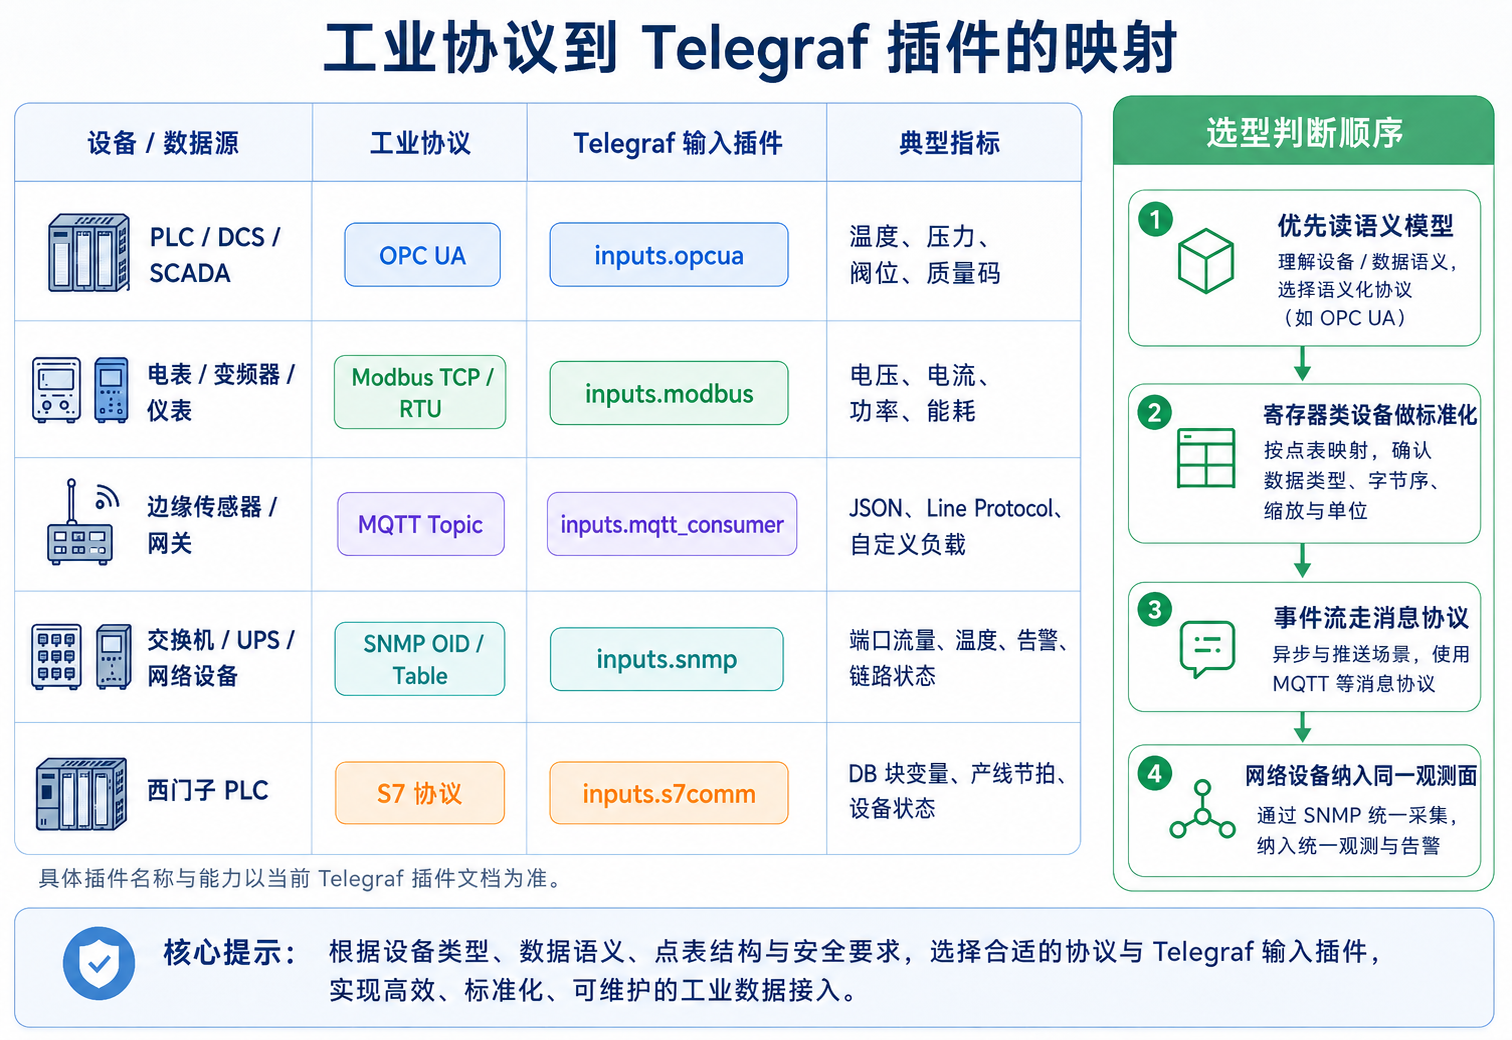
工业协议的选择不能只看“Telegraf 支持哪个插件”,还要看现场设备能力、网络拓扑、采样频率、数据语义和安全机制。
OPC UA:优先保留语义和质量码
OPC UA 通常适合较现代的自动化系统。它的优势在于节点模型、命名空间、数据类型、质量码和安全机制相对完整。对于 PLC、DCS、SCADA 或设备网关,如果已经提供 OPC UA Server,通常应优先使用 OPC UA 作为 Telegraf 的接入方式。
设计建议:
- 明确采集节点清单,不要无限制浏览和采集。
- 保留 quality、timestamp、namespace、node identifier 等上下文。
- 对安全策略、证书信任、只读账号做专项配置。
- 将 OPC UA 的语义映射到统一资产标签,而不是把 NodeId 原样当业务名。
Modbus:重点治理点表、单位和字节序
Modbus 简单、广泛、稳定,但语义能力弱。一个寄存器地址本身并不知道它代表温度、电压还是运行状态。因此,Modbus 项目的质量取决于点表治理。
设计建议:
- 点表必须包含地址、数据类型、字节序、缩放系数、单位、设备资产、异常值规则。
- 对轮询频率进行分级,不要用同一采样周期读取全部寄存器。
- 对串口或 RTU 网关注意总线负载,避免采集过密影响现场通信。
- 对同一设备的寄存器分组读取,减少通信往返。
MQTT:适合边缘设备主动上报
MQTT 更像事件和遥测消息通道,适合传感器、网关、设备 SDK 或产线边缘程序主动上报。它的优势是发布订阅解耦、弱网适应性好、主题层级可表达资产路径。
设计建议:
- 主题命名应体现工厂、产线、设备和数据类型。
- Payload 尽量使用明确 schema,避免随意 JSON。
- 对 QoS、保留消息、离线缓存、证书和 ACL 做统一规范。
- 在 Telegraf 内完成解析和标签补齐,不要让平台端再猜测语义。
SNMP:把 OT 网络状态纳入同一观测面
工业物联网项目容易只关注生产设备,却忽略交换机、UPS、无线 AP、网关等基础设施。一旦网络端口丢包、链路抖动或 UPS 温度异常,生产数据链路也会受影响。SNMP 输入可以把网络与电力基础设施纳入同一套时序观测体系。
五、边缘部署形态
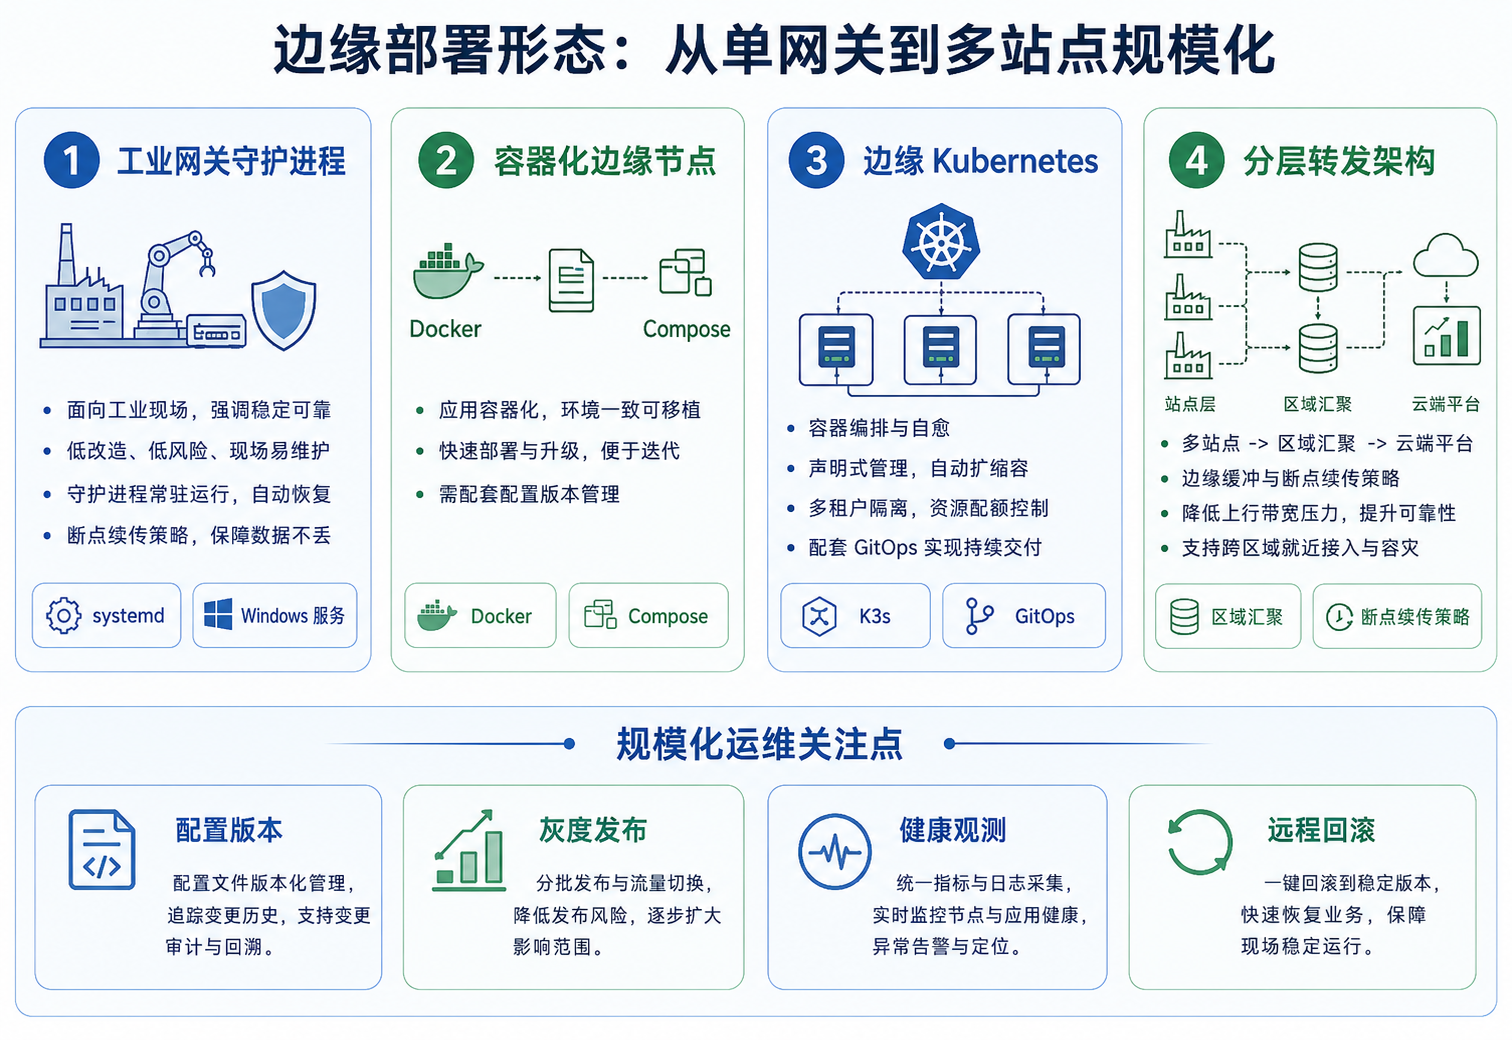
Telegraf 可以运行在很多位置,但工业现场的部署方案应服从生产稳定性,而不是单纯追求技术统一。
单网关守护进程
这是最常见的起步方式。Telegraf 作为系统服务运行在工业网关或 IPC 上,配置文件由运维或平台团队管理。优点是简单、可靠、可控;缺点是规模化配置分发和版本治理需要额外建设。
适用场景:
- 单产线试点。
- 设备数量有限。
- 网络环境封闭。
- 现场运维偏传统。
容器化边缘节点
当网关数量增加、版本变更频繁时,容器化可以让 Telegraf 的运行环境更可复制。镜像版本、配置模板和启动参数可以一起进入发布流程。
适用场景:
- 多条产线复制。
- 需要快速回滚。
- 网关资源允许运行容器。
- 团队已有容器运维能力。
边缘 Kubernetes
对于园区级或多站点边缘平台,Telegraf 可以作为 DaemonSet、Sidecar 或独立采集工作负载运行。它可以同时采集节点指标、容器指标、应用指标和工业协议数据。
适用场景:
- 边缘应用已经容器化。
- 需要统一调度、配置、密钥和健康检查。
- 多团队共享边缘平台。
分层转发架构
当工厂和站点数量很多时,可以采用“设备侧 Telegraf -> 区域消息总线或时序缓存 -> 中心平台”的分层结构。这样可以减少跨站点连接数量,并在区域侧做流量削峰和数据补偿。
六、可靠性与安全边界
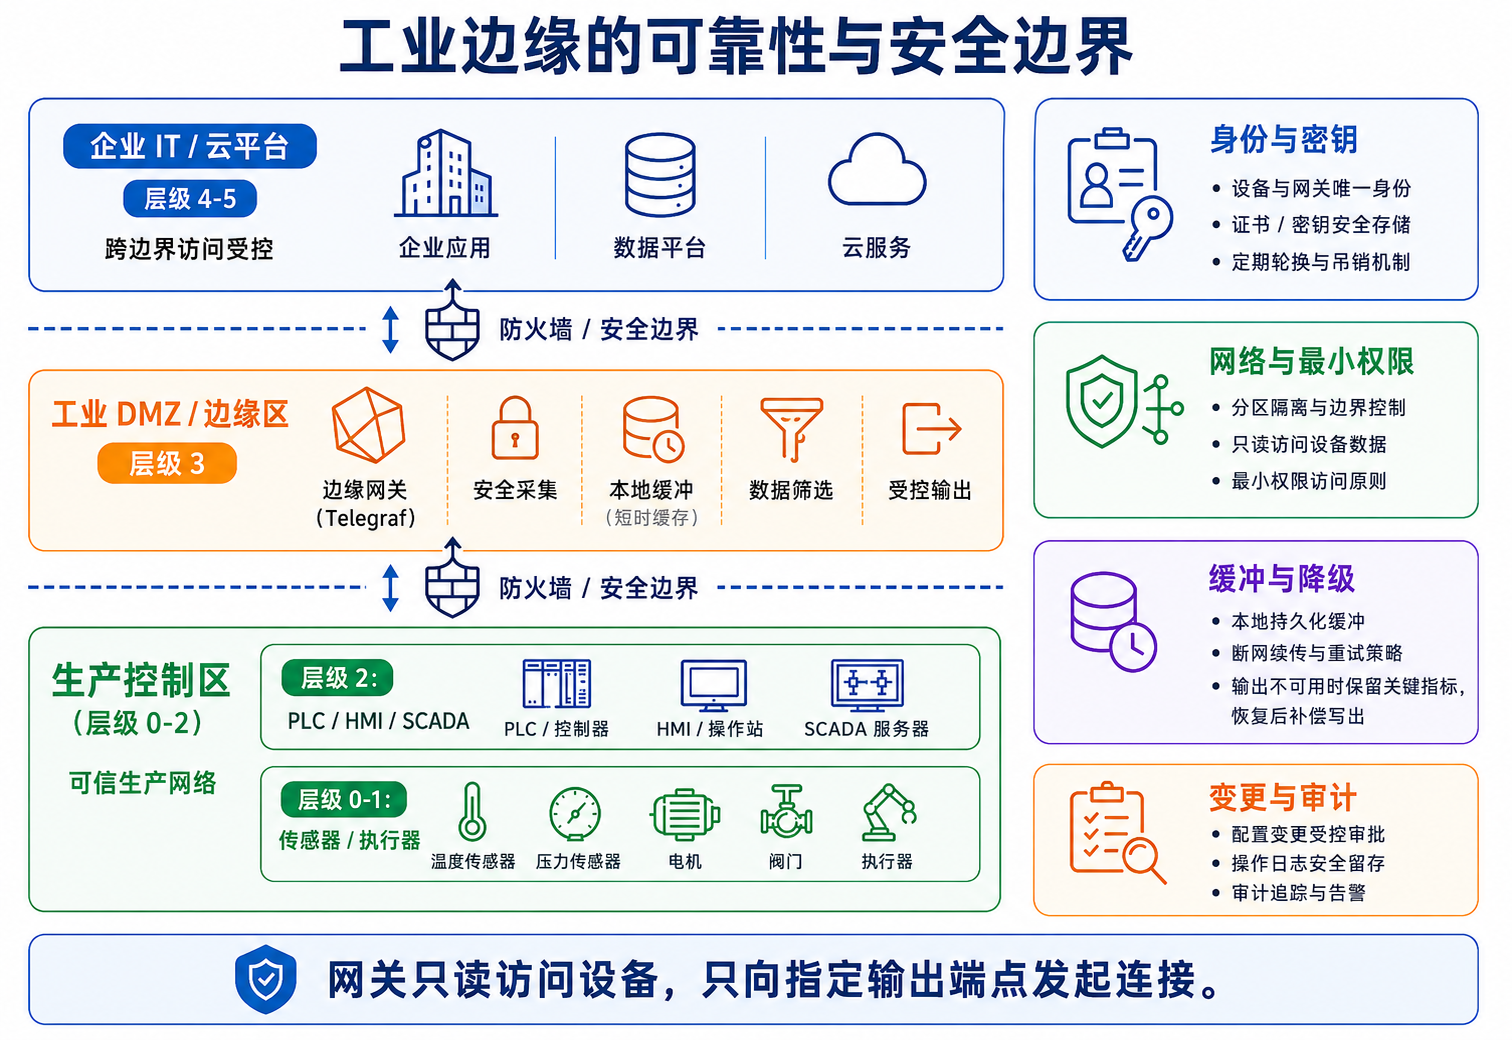
工业现场的安全原则是:采集代理不能影响控制回路,不能扩大生产网络暴露面,不能因为云端不可用而拖垮本地设备。
安全设计原则
- 最小权限:Telegraf 使用只读账号访问设备或协议服务,只打开必要端口。
- 网络分区:控制网络、边缘网关、DMZ、企业 IT 和云平台应分区管理。
- 证书与密钥管理:令牌、密码、证书路径不应硬编码到仓库。优先使用环境变量、密钥文件或 Telegraf 支持的密钥存储能力。
- 输出方向可控:尽量让边缘网关主动向指定平台发起连接,而不是让云端直接访问控制网络。
- 配置审计:点表、采样周期、输出目标和处理规则都应进入版本控制。
可靠性设计原则
Telegraf 提供全局 Agent 配置,例如采集周期、批量写出大小、缓冲上限、刷新间隔和抖动等。工程上需要重点关注:
interval:采集周期。过短会增加设备和网络压力,过长会损失实时性。metric_batch_size:每次写出的指标批量大小。过小会增加请求次数,过大可能增加延迟。metric_buffer_limit:输出不可用时保留的未写出指标数量。它是弱网保护,不是无限队列。flush_interval:写出周期。需要与业务延迟要求、输出平台吞吐能力匹配。flush_jitter:写出抖动。多网关同时刷新时可降低写入尖峰。
在高可靠场景中,Telegraf 的内存缓冲不能替代完整的边缘消息队列、本地 Historian 或断点续传系统。如果业务要求“网络断开数小时仍不丢关键数据”,建议在边缘侧增加持久化消息队列、文件落盘或本地时序库,再由 Telegraf 或其他组件补偿转发。
七、指标模型:项目成败的关键
工业物联网项目很容易陷入“采集很多点位,但没人敢用”的状态。根因通常不是采集失败,而是数据模型没有治理。
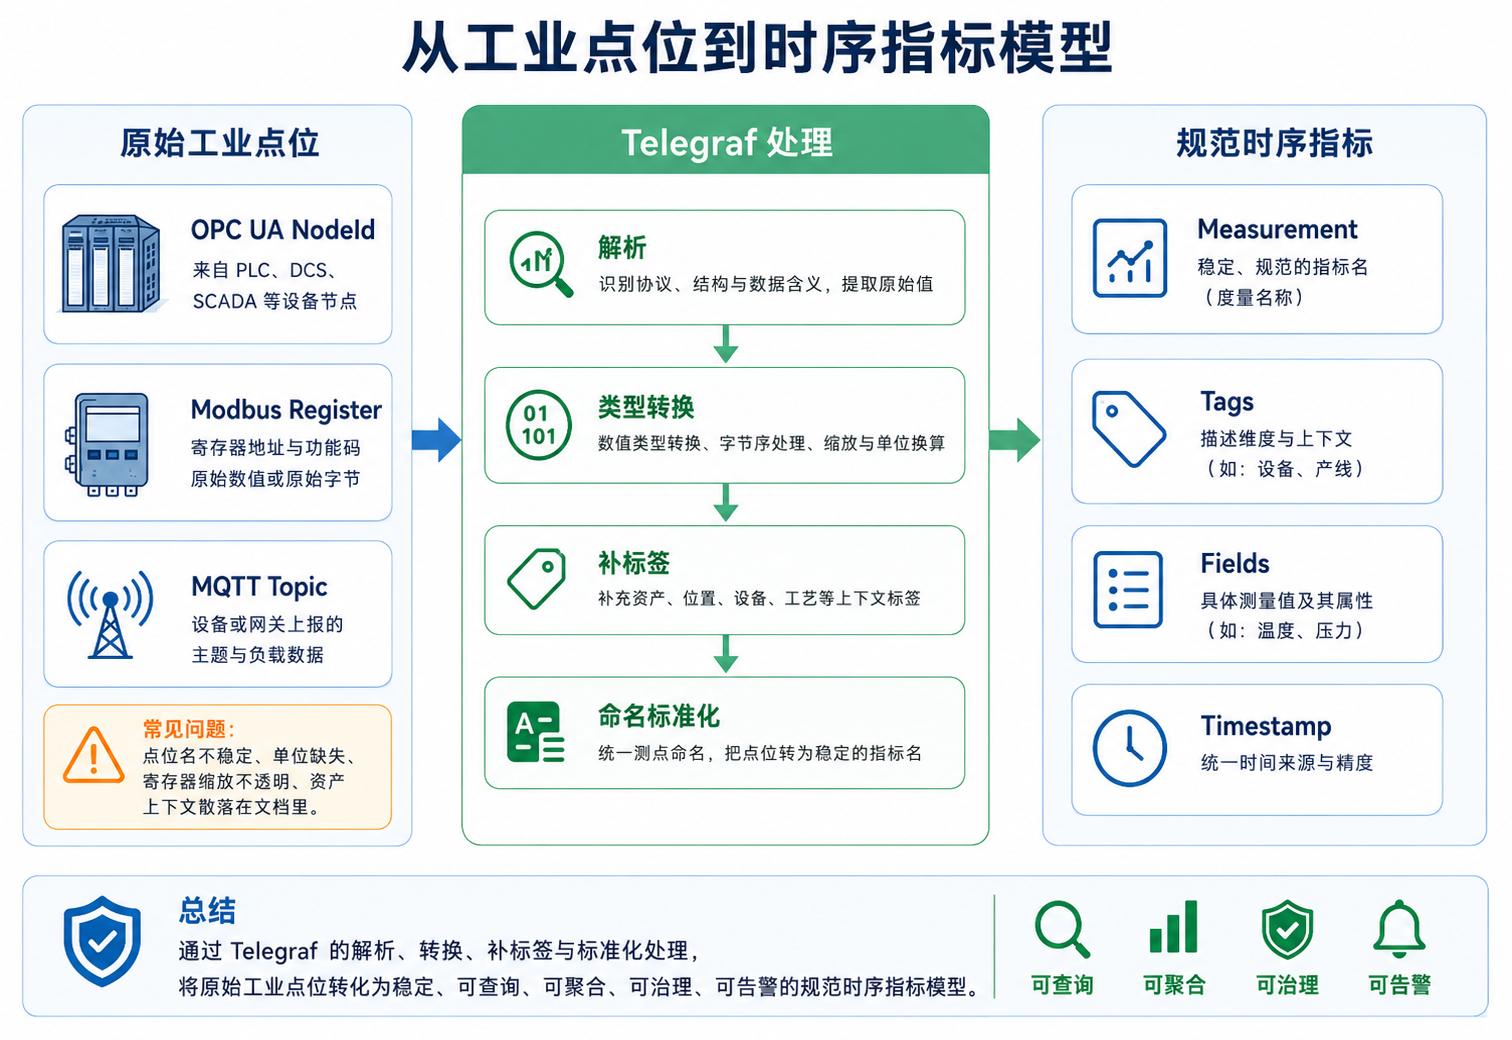
建议将每条指标拆成四层:
- Measurement:描述指标类型,例如
asset_temperature、motor_current、line_cycle_time。 - Tags:描述维度,例如
site、workshop、line、cell、asset、protocol、unit、vendor。 - Fields:描述数值或状态,例如
value、quality、status_code、setpoint。 - Timestamp:描述时间来源。可以是设备时间,也可以是边缘采集时间,但必须统一规则。
推荐标签模型
| 标签 | 含义 | 示例 |
|---|---|---|
site | 工厂或站点 | suzhou_plant_1 |
workshop | 车间 | assembly |
line | 产线 | line_01 |
cell | 工位或单元 | cell_07 |
asset | 设备资产 | pump_p7 |
protocol | 数据来源协议 | opcua |
source | 数据源或网关 | edge-gw-03 |
unit | 单位 | celsius |
quality | 数据质量 | good、bad、uncertain |
命名原则
- 指标名表达“是什么”,标签表达“属于谁、在哪里、来自哪里”。
- 不要把高基数字段放进标签,例如订单号、批次号、毫秒级唯一 ID。
- 同一指标跨设备应保持字段类型一致。
- 单位和缩放应在采集侧显式处理,避免平台端重复猜测。
- 质量码应保留,不要只保留数值。
八、示意配置
以下配置片段用于说明思路,不能直接作为投产配置。实际项目必须对照 Telegraf 当前版本的插件文档、设备点表、安全策略和网络环境逐项校验。
Agent 全局配置
[agent]
  interval = "10s"
  round_interval = true
  metric_batch_size = 1000
  metric_buffer_limit = 10000
  flush_interval = "10s"
  flush_jitter = "3s"
  omit_hostname = false
设计要点:
- 多网关部署时建议设置
flush_jitter,避免所有网关同时写入平台。 metric_buffer_limit要结合弱网时间、采样量和内存容量评估。- 对不同设备组可使用多个 Telegraf 实例或多个配置文件拆分采样周期。
OPC UA 输入示意
[[inputs.opcua]]
  endpoint = "opc.tcp://192.168.10.20:4840"
  security_policy = "Basic256Sha256"
  security_mode = "SignAndEncrypt"
  auth_method = "UserName"
  username = "${OPCUA_USER}"
  password = "${OPCUA_PASSWORD}"
  timestamp = "gather"

  [[inputs.opcua.nodes]]
    name = "pump_p7_temperature"
    namespace = "3"
    identifier_type = "s"
    identifier = "Line1.Pump7.Temp"
建议:
- 使用证书与只读账号。
- 明确节点清单,避免无边界采集。
- 将
name映射到统一指标名或后续处理器规则。
Modbus 输入示意
[[inputs.modbus]]
  name = "energy_meter_01"
  controller = "tcp://192.168.10.50:502"
  slave_id = 1
  timeout = "1s"

  holding_registers = [
    { name = "voltage_a", address = [0], data_type = "FLOAT32", byte_order = "ABCD", scale = 1.0 },
    { name = "current_a", address = [2], data_type = "FLOAT32", byte_order = "ABCD", scale = 1.0 },
    { name = "active_power", address = [4], data_type = "FLOAT32", byte_order = "ABCD", scale = 0.1 },
  ]
建议:
- 点表必须确认地址偏移、字节序和缩放。
- 对电表、变频器、温控器等设备分组采集,减少总线压力。
- 对异常值做处理,例如断线、超量程、非法码。
MQTT 输入示意
[[inputs.mqtt_consumer]]
  servers = ["ssl://mqtt-broker.local:8883"]
  topics = [
    "factory/+/line/+/asset/+/telemetry",
    "factory/+/line/+/asset/+/status"
  ]
  data_format = "json"
  client_id = "telegraf-edge-gw-03"
建议:
- Topic 层级应尽量与资产模型一致。
- Payload 需要约束 schema,避免不同设备随意上报字段。
- 对 Topic 中的工厂、产线、设备 ID 做标签提取。
处理器示意
[[processors.rename]]
  [[processors.rename.replace]]
    field = "pump_p7_temperature"
    dest = "value"

[[processors.converter]]
  [processors.converter.fields]
    float = ["value"]

[[processors.override]]
  [processors.override.tags]
    site = "suzhou_plant_1"
    line = "line_01"
    asset = "pump_p7"
    protocol = "opcua"
    unit = "celsius"
设计要点:
- 尽量把命名、单位和资产上下文沉淀在配置或模板中。
- 对多站点复制,应把 site、line、asset 等做成模板变量。
- 对复杂转换可以评估 Starlark 处理器,但不要把大量业务逻辑塞进采集层。
九、性能与容量规划
Telegraf 轻量,但工业现场的容量规划仍然需要认真计算。
估算公式
可以用一个粗略公式估算写入压力:
每秒指标数 = 设备数 × 每设备点位数 ÷ 采样周期秒数
每日样本数 = 每秒指标数 × 86400
例如:100 台设备,每台 50 个点位,采样周期 10 秒:
每秒指标数 = 100 × 50 ÷ 10 = 500
每日样本数 = 500 × 86400 = 4320 万
如果每条指标还带多个字段,真实写入量会更高。此时必须考虑:
- 是否需要所有点位都按 10 秒采样。
- 是否可以在边缘聚合低价值指标。
- 是否需要将高频诊断数据与普通运行数据分开链路。
- 输出平台是否能承受高峰写入。
- 弱网情况下缓冲会占用多少内存或磁盘。
调优建议
| 目标 | 建议 |
|---|---|
| 降低设备压力 | 按设备能力设置采样周期,寄存器类设备尽量批量读取 |
| 降低网络峰值 | 设置批量写出和写出抖动 |
| 降低存储成本 | 对趋势类指标做边缘聚合或降采样 |
| 提升可用性 | 监控 Telegraf 自身指标、输出失败率、缓冲占用 |
| 便于排障 | 为每个网关、配置版本、数据源添加标签 |
| 控制风险 | 点表变更灰度发布,保留回滚配置 |
十、Telegraf 与其他方案的关系
Telegraf 不是所有工业数据问题的唯一答案。更合理的定位是:
| 组件 | 更适合做什么 | 与 Telegraf 的关系 |
|---|---|---|
| SCADA / DCS | 生产监控与控制 | Telegraf 只读采集,不应替代控制系统 |
| Historian | 长周期工业历史数据归档 | Telegraf 可写入或旁路同步,但不能轻易替代成熟 Historian |
| MQTT Broker | 设备消息路由 | Telegraf 可作为消费者或生产者 |
| Kafka / NATS | 大规模事件流与解耦 | Telegraf 可把边缘指标写入消息总线 |
| 时序数据库 | 存储、查询、告警、看板 | Telegraf 是常见采集入口 |
| 自研采集服务 | 复杂协议、强业务逻辑 | Telegraf 可承担通用采集,自研服务处理特殊逻辑 |
| 边缘 AI 服务 | 实时推理与闭环优化 | Telegraf 可提供特征、状态和上下文指标 |
结论是:Telegraf 适合作为通用边缘采集与指标管道,不适合承担控制闭环、复杂业务编排、长期离线持久化和设备生命周期管理等职责。
十一、典型落地路径
工业物联网项目要从“小而稳”的链路开始,而不是第一天就追求全厂全量接入。
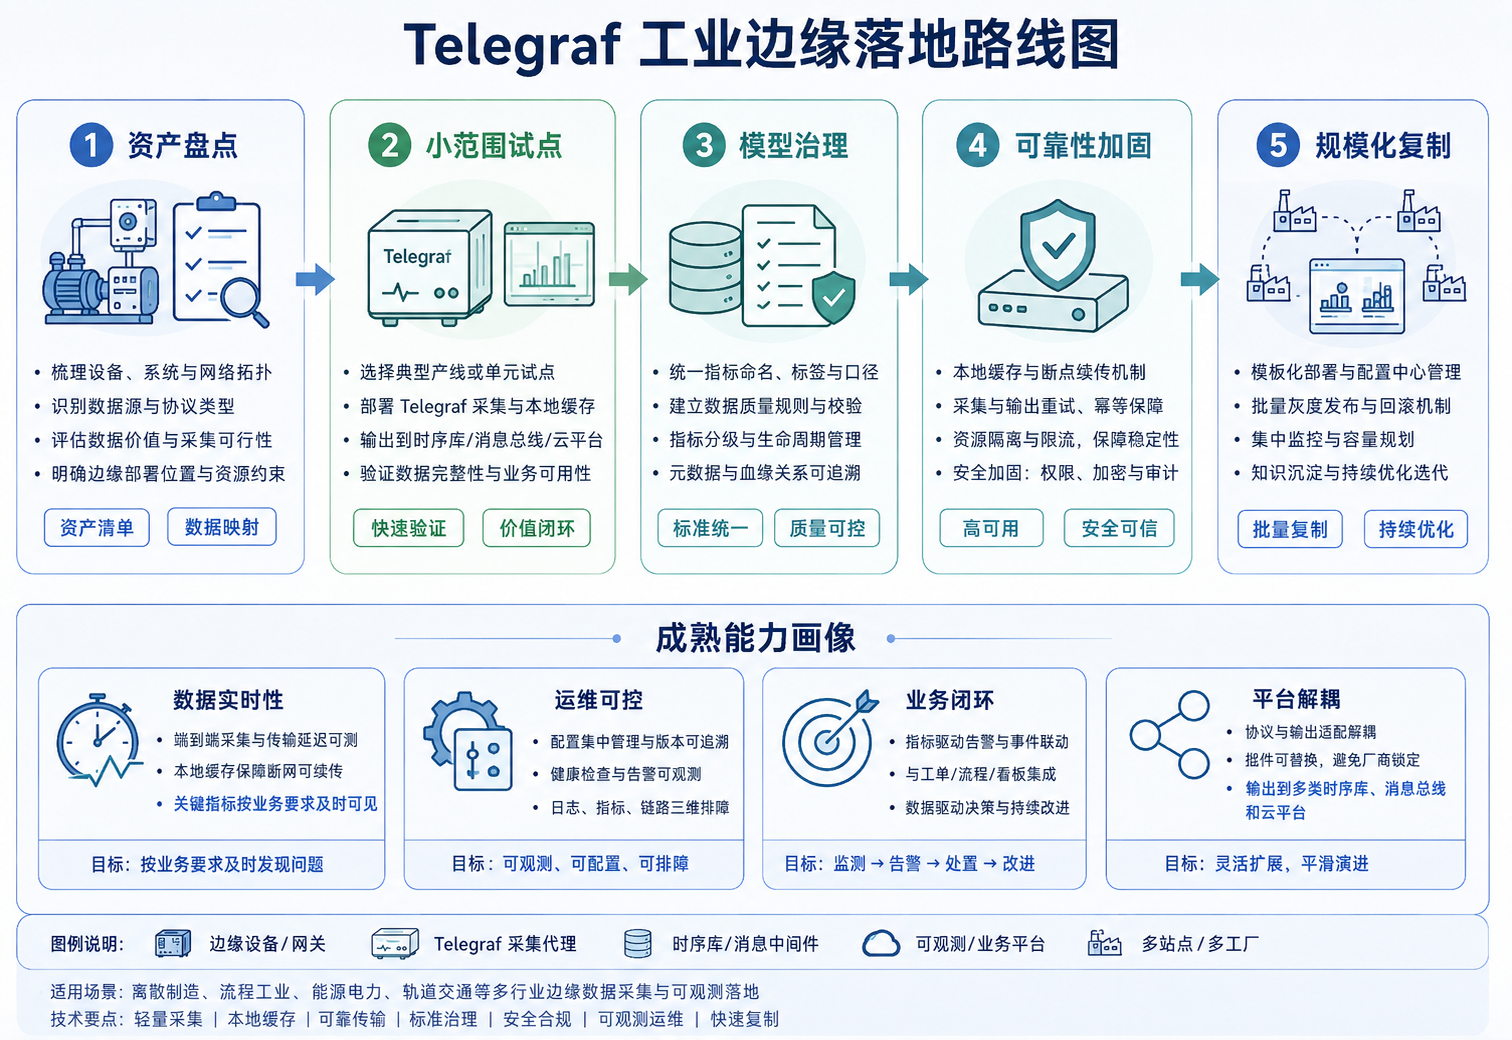
阶段 1:资产与协议盘点
输出物:
- 设备清单。
- 协议清单。
- 点表与单位。
- 网络区域图。
- 采样频率分级。
- 业务问题清单。
关键问题:
- 哪些点位真正支持业务决策?
- 哪些设备只能通过网关或 Historian 间接访问?
- 采集行为是否可能影响控制系统?
阶段 2:一条产线试点
选择一条数据价值高、风险可控的产线,接入少量设备,完成端到端链路:
设备 / 网关 -> Telegraf -> 处理与聚合 -> 时序库 / 消息总线 -> 看板与告警
试点阶段不要追求点位数量,而要验证:
- 采集是否稳定。
- 标签模型是否能支撑查询。
- 输出平台是否能承受写入。
- 现场网络是否允许长期运行。
- 运维团队是否能理解和接管配置。
阶段 3:模型治理
试点成功后,应把命名、标签、单位、质量码和资产层级固化为标准。此阶段要形成:
- 指标命名规范。
- 标签字典。
- 点表模板。
- 协议接入模板。
- 配置审查流程。
没有模型治理的规模化,最终只会得到更大规模的数据混乱。
阶段 4:可靠性与安全加固
在推广前必须补齐:
- 网关健康监控。
- Telegraf 自身指标采集。
- 输出失败告警。
- 缓冲与降级策略。
- 密钥与证书管理。
- 灰度发布与回滚机制。
阶段 5:多站点复制
当模板成熟后,再推广到多车间、多产线、多工厂。推广时应优先复制“配置模式和治理方法”,而不是简单复制某个点表文件。
十二、常见误区
误区 1:把 Telegraf 当成万能工业平台
Telegraf 是采集代理和指标管道,不是 SCADA、Historian、设备管理平台或实时控制系统。它擅长连接、处理和写出,不应承担闭环控制或复杂业务状态机。
误区 2:只采集,不建模
没有标签、单位和资产层级的数据,很快会变成不可维护的点位堆。工业物联网项目的长期价值来自模型治理。
误区 3:所有点位同频率采样
温度趋势、设备状态、报警事件、振动诊断、能耗统计对采样频率的要求不同。同频率采样会造成设备压力、网络压力和存储压力。
误区 4:忽视 Telegraf 自身观测
采集链路本身也要被观测。至少应关注采集耗时、写出失败、缓冲占用、指标数量、配置版本和网关健康状态。
误区 5:把内存缓冲当长期可靠队列
Telegraf 的缓冲能力可以应对短时输出失败,但不能替代持久化消息队列或本地 Historian。断网时间长、数据不能丢的场景,需要额外设计持久化链路。
十三、适合使用 Telegraf 的场景
Telegraf 非常适合:
- 快速接入多协议工业数据。
- 统一采集设备指标、系统指标和网络设备指标。
- 把边缘数据写入时序数据库或消息总线。
- 构建生产设备可观测体系。
- 对数据做轻量清洗、标签补齐、边缘聚合。
- 在多工厂项目中复制采集模板。
Telegraf 不太适合:
- 对控制回路做实时闭环控制。
- 替代 PLC、SCADA 或 DCS。
- 承担复杂业务流程编排。
- 在无持久化设计的情况下保证长时间断网零丢失。
- 处理极高频、强实时、强确定性的工业控制数据。
结语
在工业物联网与边缘计算场景中,Telegraf 的最佳定位是“边缘指标采集与转发层”。它不是生产控制系统,也不是完整工业数据平台,但它可以把不同协议、不同设备、不同站点的数据接入方式标准化,让上层平台获得统一、可分析、可治理的时序指标。
一个专业的 Telegraf 项目,应同时做好五件事:协议适配、指标建模、边缘可靠性、安全边界和配置治理。只要这五件事做扎实,Telegraf 就能成为工业数据平台中非常稳定的一层基础设施,帮助企业把设备状态、产线节拍、质量参数、能耗数据和网络健康真正纳入可观测、可分析、可运营的体系。
参考资料
更多推荐


 12
 0
- 0


 已为社区贡献4条内容

所有评论(0)