
一文详解AI大模型14个核心基础概念(第一篇)
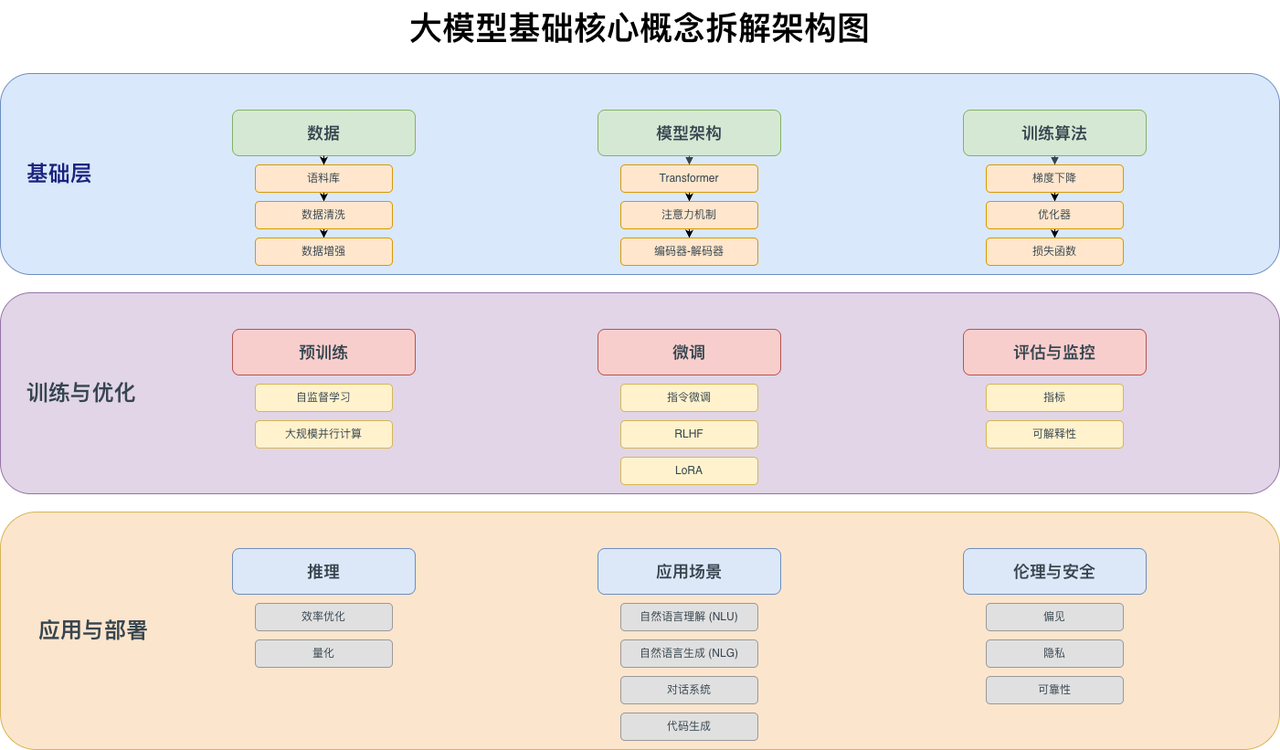
本文将系统梳理AI大模型领域的14个核心概念,从基础架构到训练优化,再到前沿应用模式,帮助读者建立对这一复杂技术的全面认知框架。通过深入浅出的解释,读者将理解大模型为何能实现"智能涌现",以及如何解决其幻觉、对齐等关键挑战。
一、大模型基础架构与核心组件
1、Transformer[1]架构
Transformer架构是现代几乎所有主流大模型的共同基础,它的出现是自然语言处理(NLP)领域的一次范式革命。
Transformer 由Google于2017年提出,彻底改变了自然语言处理的范式。它摒弃了传统RNN的序列处理方式,通过自注意力机制实现并行处理,大幅提升训练效率。
Transformer的核心创新在于位置编码和多头注意力机制:
位置编码:通过将词嵌入向量与位置向量相加,Transformer能同时捕获词义和词序信息。这种编码方式比早期的简单索引值更有效,避免了随着文本长度增加带来的数值不稳定问题。
多头注意力机制:通过多个并行的注意力头,Transformer能从不同角度理解文本关系。每个头关注文本的不同部分,最后将这些不同视角的信息整合起来,形成更全面的语义理解。
Transformer模型的自注意力机制的公式:
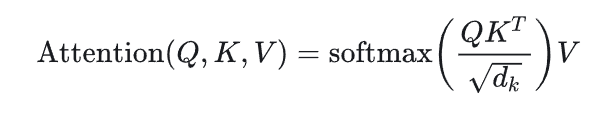
2、Token
Token是大模型处理语言的"最小单位",可以理解为AI眼中的"字或词"。大模型将自然语言拆解为Token序列进行处理,这直接影响模型的计算成本和功能设计。例如,GPT-4的上下文窗口为128k Token,决定了其能处理的文本长度上限。
Token的拆分规则因模型而异:有些模型将"人工智能"视为1个Token,而有些模型可能将其拆分为多个子词。在实际应用中,Token数量直接影响API调用成本,如GPT-4的输入和输出每Token收费不同。因此,产品经理需在功能设计时考虑Token限制,如是否支持超长文档处理。
分词方法:
词级(Word-level):以单词为单位。优点是语义完整,但会面临词汇表过大和未登录词(Out-of-Vocabulary, OOV)问题。
字符级(Character-level) :以单个字符为单位。优点是不会有OOV问题,但语义信息被切碎,导致序列过长,计算效率低。
子词级(Subword-level):这是当前主流的方法,它在词级和字符级之间取得了平衡。常见的高频词被视为一个Token,而罕见的词则被拆分为多个有意义的子词片段。这种方法既能有效处理OOV问题,又保留了大部分语义信息。
主流子词算法:包括 BPE(Byte Pair Encoding) 、WordPiece和SentencePiece等 。它们通过对大规模语料库进行统计分析,迭代地合并高频出现的字符对或子词,从而构建出一个大小适中的词汇表。
对中文分词的影响:由于中文没有天然的空格作为分隔符,Token化的效率尤为关键。早期模型常将一个汉字处理成一个Token,导致处理相同语义内容的中文文本比英文需要更多的Token,这直接影响了处理成本和上下文长度限制。许多国产大模型通过优化分词器,扩大了针对中文的词汇表,使得一个Token能表示更复杂的中文词语,从而提升了处理效率 。
3、嵌入模型(Embedding Model)
嵌入模型是将文本、图像、音频等非结构化数据转化为计算机可理解的"数值向量"的工具。向量的"距离"反映数据的语义相似度,这是大模型理解语言的核心能力。例如,"猫"和"狗"的向量距离会比"猫"和"汽车"更近。
在实际应用中,嵌入模型是许多功能的隐形支柱:
文档问答产品的内容检索:将用户问题和文档内容转化为向量,快速匹配最相关片段
电商平台的相似商品推荐:基于商品描述的向量相似度实现
RAG技术的检索环节:将用户查询和知识库内容转化为向量进行匹配
4、混合专家模型(MoE)
混合专家模型[2]****(Mixture of Experts, MoE)是一种通过门控网络动态选择"专家"子网络进行计算的神经网络架构。
MoE的核心优势在于实现 "高参数、低计算"的稀疏性 ,仅激活总参数的一小部分即可处理输入,显著提升模型容量与计算效率的平衡。
MoE的工作流程类似于项目团队协作:项目经理(门控网络)根据任务性质,挑选最合适的几位专家(子网络)来完成任务,最后整合他们的成果形成最终解决方案。这种分治策略使模型能处理更复杂的任务,同时避免全参数激活带来的计算负担。
更多推荐


 11
 0
- 0


 已为社区贡献6条内容

所有评论(0)