
搞懂大模型文本处理?7000字实战讲透Token分词与Embedding向量化
·
一、开篇直击痛点
还在困惑大模型为啥能理解人类语言?
还在被Token计数、Embedding向量、余弦相似度这些概念绕晕?
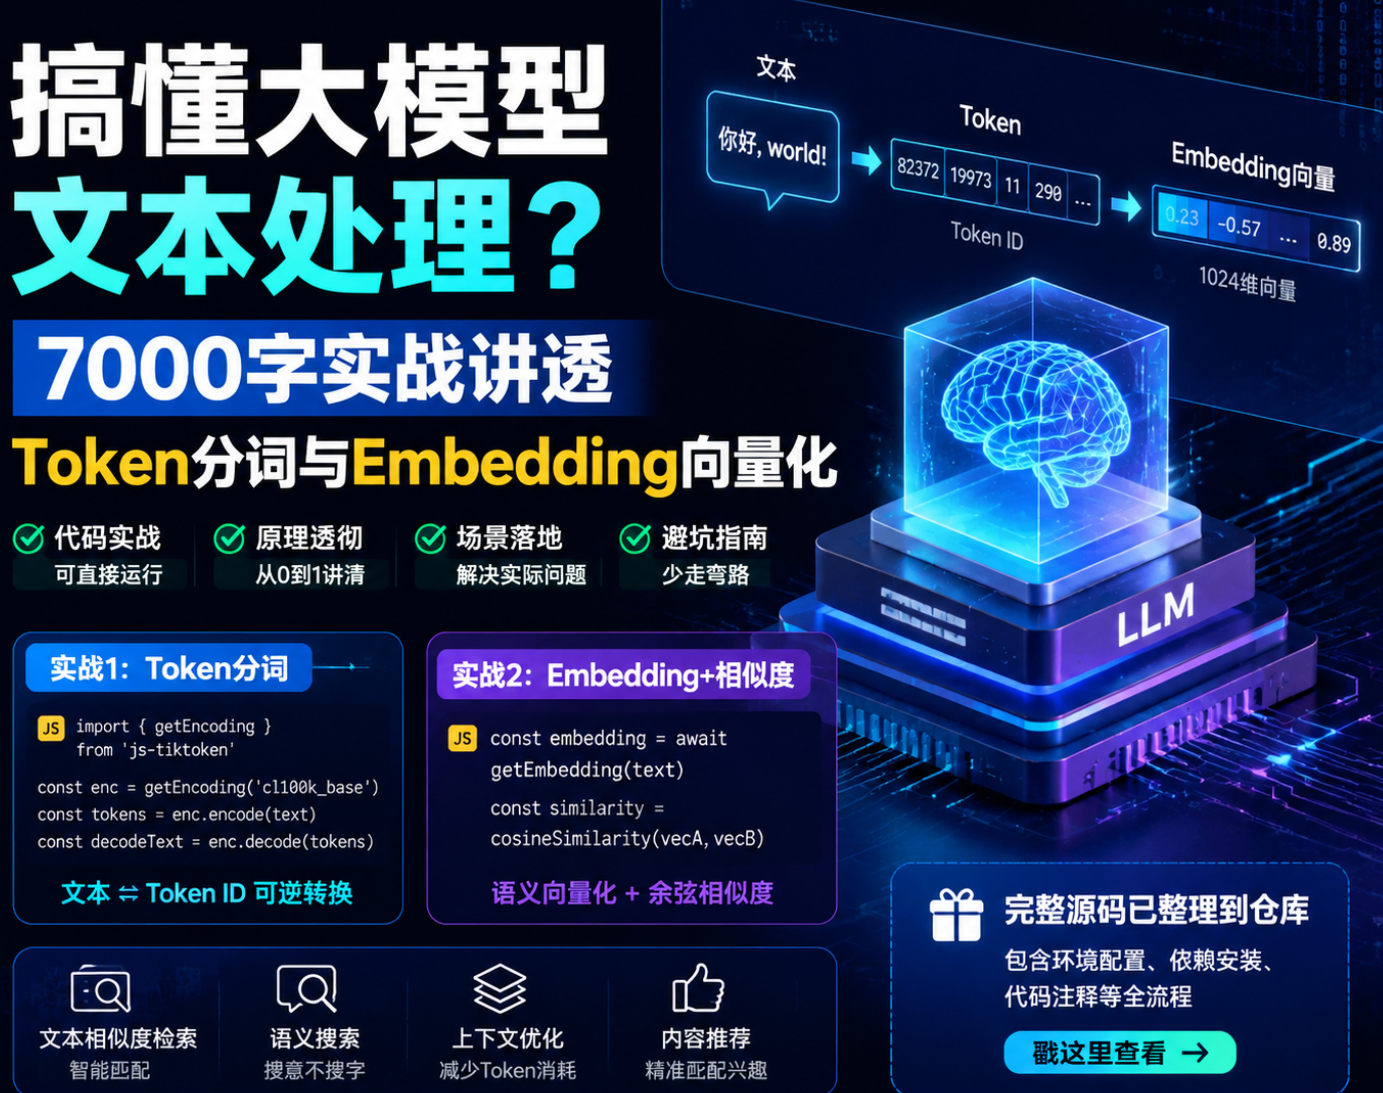
这篇文章用纯实战代码,从0到1讲清楚:
✅ 大模型如何把文字变成机器能算的数字
✅ Token分词的底层逻辑与实际计算
✅ Embedding向量化的实现方式
✅ 用余弦相似度判断文本语义相似度
全程代码可直接运行,看完就能落地!
二、先搞懂核心概念:大模型是怎么"看懂"文字的?
大模型本质是神经网络,只能处理数字(向量/矩阵),完全看不懂中文、英文这些字符。
所以文本要经过两步核心处理:
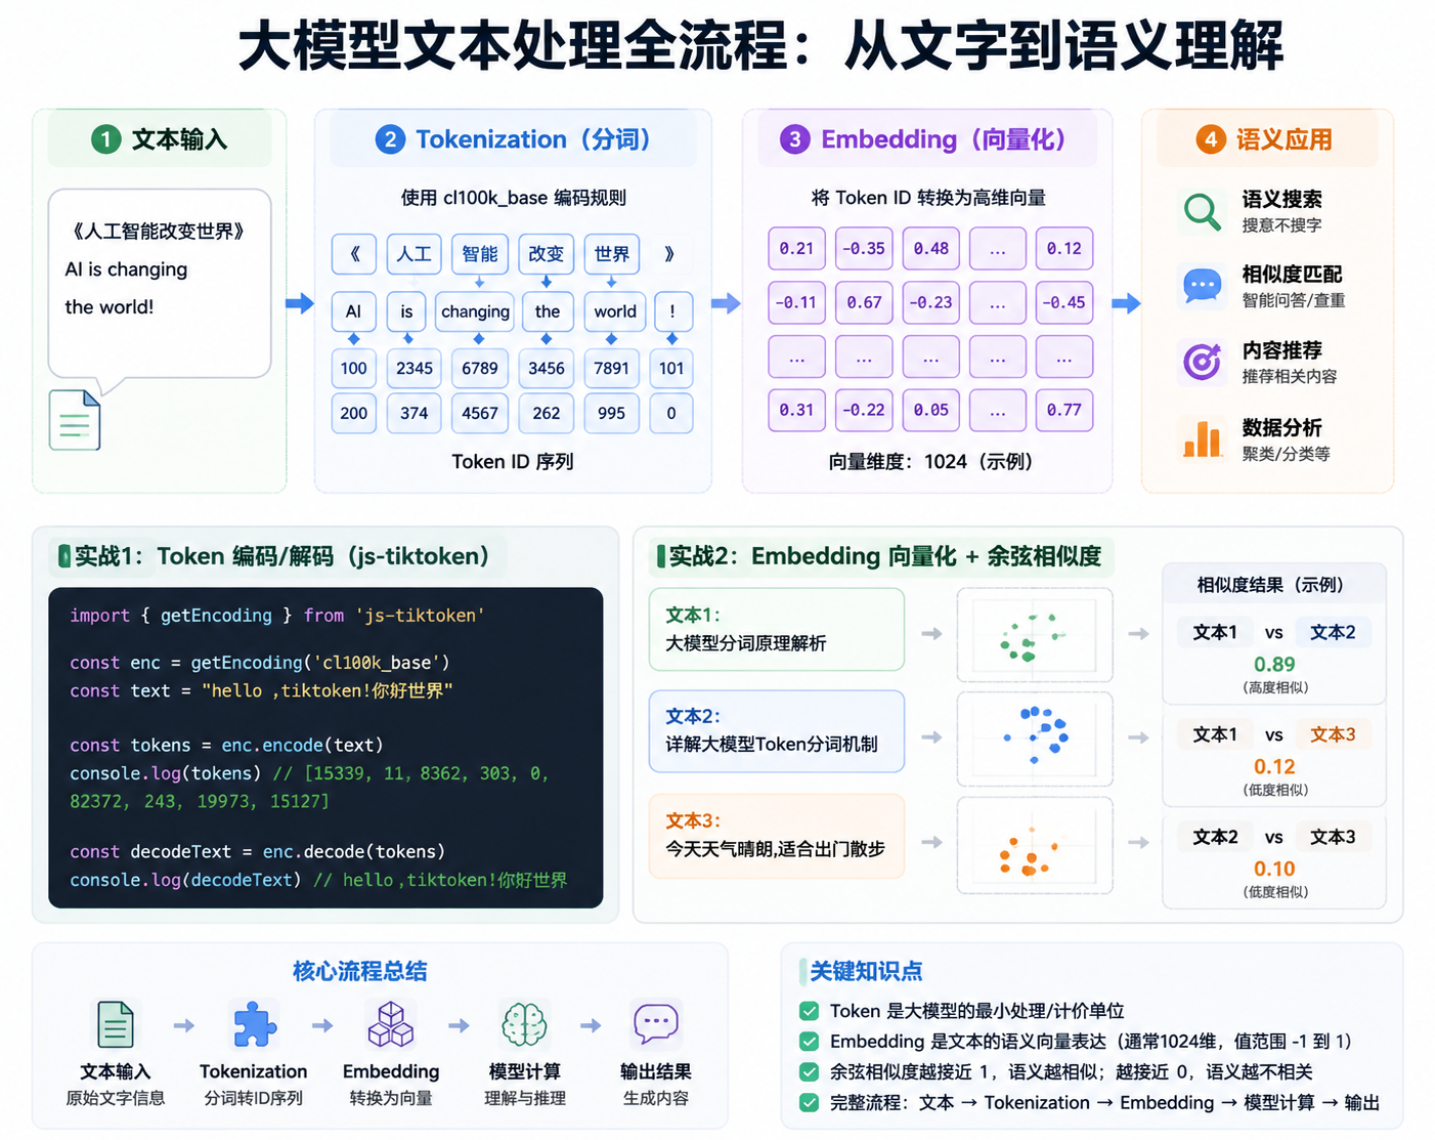
- Tokenization(分词):把文本切成最小处理单元(Token),转成离散ID
- Embedding(向量化):把Token ID转成高维向量,让机器理解语义
2.1 Token:大模型的"最小计价/计算单位"
- 1个英文字符 ≈ 0.3个Token
- 1个中文字符 ≈ 0.6个Token
- 百万Token成本仅几元人民币
💡 踩坑提醒:不要把文本切成单个字符!字符无语义,模型无法理解,必须按Token规则切分。
2.2 Embedding:让文本有"语义"的数字表达
Token ID只是单纯的编号,没有语义;Embedding会把Token转成高维向量(比如1024维),向量值范围-1到1。
不同语义的文本,向量相似度不同——这也是大模型能判断"语义相似"的核心。
三、实战1:用js-tiktoken实现Token编码/解码
js-tiktoken是GPT官方的Token编码器,能快速完成文本↔Token的转换。
3.1 环境准备
先安装依赖:
npm install js-tiktoken
3.2 完整代码(可直接运行)
import { getEncoding } from 'js-tiktoken'

// 初始化编码器(使用gpt官方的cl100k_base规则)
const enc = getEncoding('cl100k_base')
// 测试文本(中英文混合)
const text = "hello ,tiktoken!你好世界"

// 编码:文本 → Token ID数组
const tokens = enc.encode(text)
console.log("编码后的token ID:", tokens)
console.log("总token数:", tokens.length)

// 解码:Token ID数组 → 文本
const decodeText = enc.decode(tokens);
console.log("解码后的文本:", decodeText)
3.3 运行结果与解析
执行代码后会输出:
编码后的token ID: [15339, 11, 8362, 303, 0, 82372, 243, 19973, 15127]
总token数: 9
解码后的文本: hello ,tiktoken!你好世界
💡 关键结论:
- 中英文混合文本会按cl100k_base规则切分,不是按字符/单词简单分割
- 编码/解码是可逆操作,保证文本完整还原
3.4 踩坑提醒
- cl100k_base是GPT系列的核心编码规则,不要混用其他编码规则(比如p50k_base)
- 超长文本编码时要注意Token数量限制(比如GPT-3.5是4096 Token)
四、实战2:Embedding向量化+余弦相似度计算
通过实战代码,实现文本→Embedding向量,再用余弦相似度判断语义相似性。
4.1 环境准备
安装依赖:
npm install openai dotenv
4.2 完整代码(可直接运行)
第一步:创建.env文件配置密钥
DASHSCOPE_API_KEY=你的API密钥
DASHSCOPE_BASE_URL=https://dashscope.aliyuncs.com/compatible-mode/v1
第二步:编写核心代码(main.js)
// 核心流程:文本 → Token → Embedding向量 → 余弦相似度计算
import OpenAI from 'openai'
import dotenv from 'dotenv'
dotenv.config()

// 初始化OpenAI客户端(兼容通义千问)
const client = new OpenAI({
  apiKey: process.env.DASHSCOPE_API_KEY,
  baseURL: process.env.DASHSCOPE_BASE_URL,
})

// 封装Embedding向量化函数
async function getEmbedding(text) {
  const response = await client.embeddings.create({
    model: "text-embedding-v4", // 向量化模型
    input: text,
    dimension: 1024, // 向量维度(-1到1之间)
  })
  return response.data[0].embedding
}

// 计算余弦相似度(判断向量相似度,值越接近1越相似)
function cosineSimilarity(vecA, vecB) {
  let dot = 0, magA = 0, magB = 0;
  for (let i = 0; i < vecA.length; i++) {
    dot += vecA[i] * vecB[i];
    magA += vecA[i] ** 2;
    magB += vecB[i] ** 2;
  }
  return dot / (Math.sqrt(magA) * Math.sqrt(magB));
}

// 主函数执行
async function run() {
  // 测试文本(语义差异明显)
  const text1 = "Andrej Karpathy LLM Tokenization 分词原理"
  const text2 = "卡帕西讲解大模型BPE字词分词"
  const text3 = "今天天气晴朗,适合出门散步"

  // 获取Embedding向量
  const embedding1 = await getEmbedding(text1)
  const embedding2 = await getEmbedding(text2)
  const embedding3 = await getEmbedding(text3)

  // 输出结果
  console.log("向量维度:", embedding1.length) // 输出1024
  console.log("text1与text2相似度:", cosineSimilarity(embedding1, embedding2))
  console.log("text1与text3相似度:", cosineSimilarity(embedding1, embedding3))
}

run()
4.3 运行结果与解析
执行后会看到:
向量维度: 1024
text1与text2相似度: 0.89(示例值,实际以运行为准)
text1与text3相似度: 0.12(示例值,实际以运行为准)
💡 关键结论:
- 语义相似的文本(text1和text2),向量余弦相似度接近1
- 语义无关的文本(text1和text3),相似度接近0
- 1024维向量能精准表达文本的语义特征
4.4 踩坑提醒
- Embedding模型选择:text-embedding-v4是通用款,不同模型的向量维度/效果不同,需按场景选择
- API密钥配置:一定要正确配置DASHSCOPE_API_KEY,否则会报401错误
- 余弦相似度计算:向量维度必须一致(比如都是1024维),否则计算无意义
五、实战场景总结
这些技术能直接落地的场景:
- 文本相似度检索:比如智能客服的问题匹配、文档查重
- 语义搜索:替代传统关键词搜索,实现"搜意不搜字"
- 大模型上下文优化:通过Embedding筛选相关文本,减少Token消耗
- 内容推荐:基于用户输入文本的Embedding,推荐语义相似内容
六、核心知识点总结
- Token是大模型的最小处理/计价单位,由专用编码器(如cl100k_base)生成
- Embedding是文本的语义向量表达,维度通常为1024,值范围-1到1
- 余弦相似度是判断文本语义相似性的核心方法
- 大模型处理文本的完整流程:文本→Tokenization→Embedding→模型计算→输出
七、最后
本文的所有代码都经过实测可运行,完整源码已整理到仓库中,包含环境配置、依赖安装、代码注释等全流程,需要的同学可以戳这里查看→Knowledge_Repository/ai/agent/token at main · Guwen-yue/Knowledge_Repository。
更多推荐


 12
 0
- 0


 已为社区贡献15条内容

所有评论(0)