
宪法分类器(Constitutional Classifiers)–大模型安全领域的新魔法
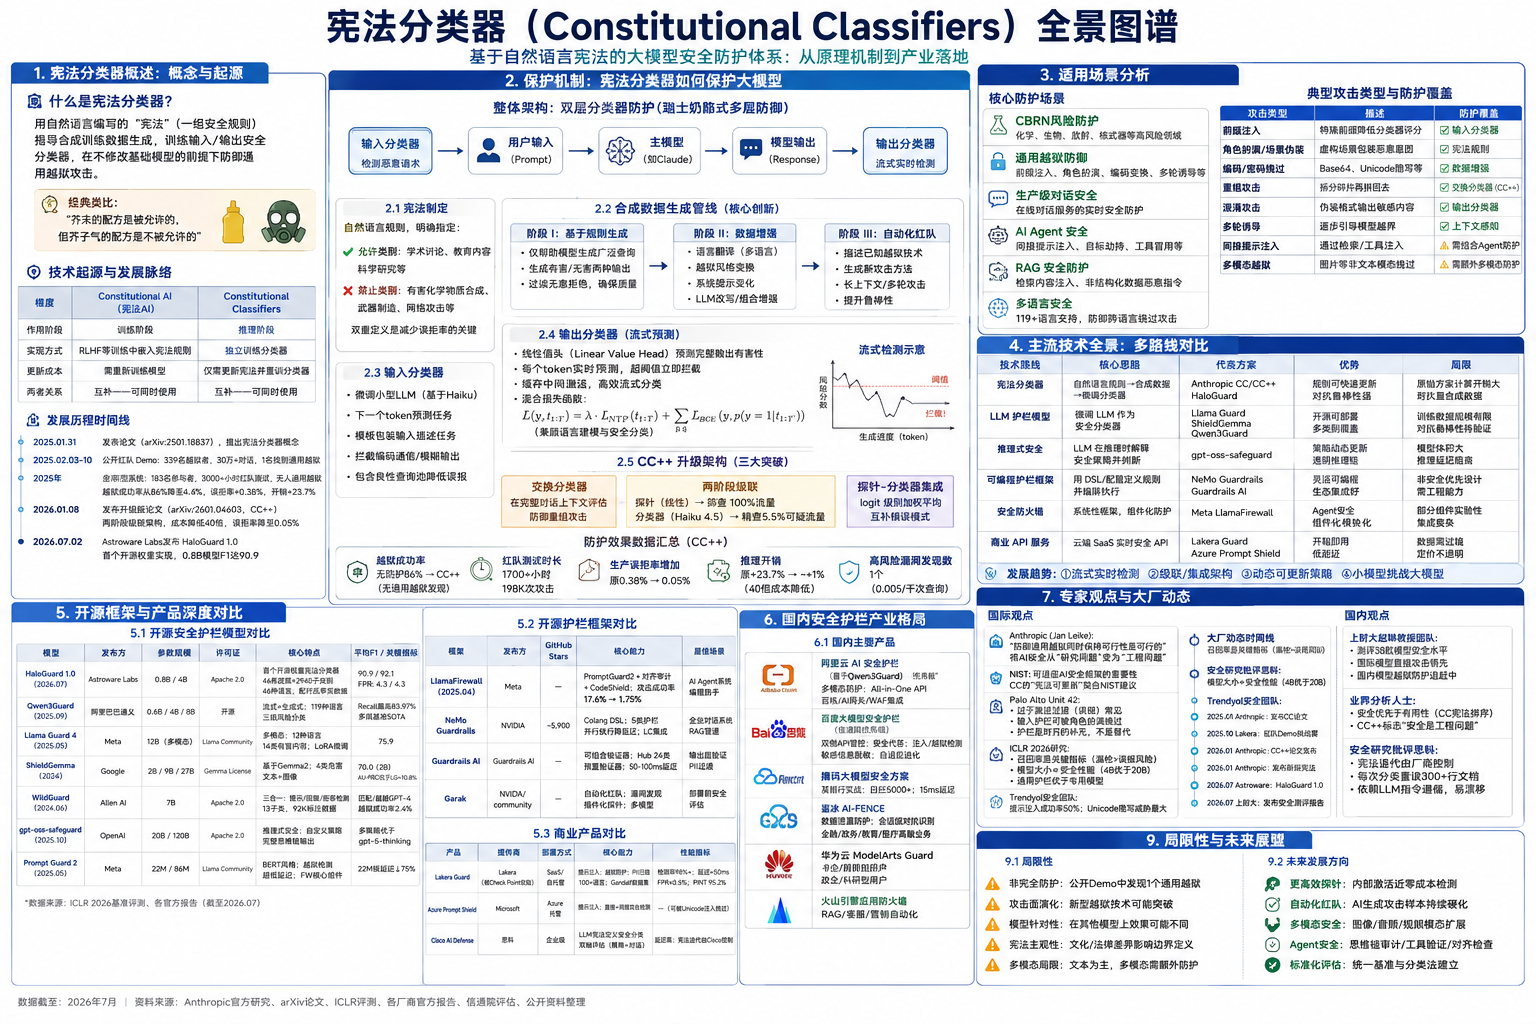
1. 宪法分类器概述:概念与起源
宪法分类器(Constitutional Classifiers)是 Anthropic 于 2025 年 2 月提出的一种大模型安全防护方法,其核心思路是:用自然语言编写的"宪法"(一组安全规则)来指导合成训练数据的生成,进而训练出输入/输出安全分类器,在不修改基础模型的前提下防御通用越狱攻击。
1.1 什么是宪法分类器?
宪法分类器是一种基于外部分类器的双层安全防护系统,由 Anthropic 安全研究团队(Safeguards Research Team)开发。其名称中的"宪法"(Constitution)指的是一组用自然语言编写的安全规则,明确界定了模型"允许"和"禁止"的内容类别。
核心理念: Anthropic 给出了一个经典类比——"芥末的配方是被允许的,但芥子气的配方是不被允许的"。这意味着宪法分类器不是简单的"一刀切"式过滤,而是能够对学术讨论与危险实操之间的细微边界做出精确判断。
1.2 技术起源与发展脉络
宪法分类器的思想继承自 Anthropic 此前提出的 Constitutional AI(宪法AI) 技术。两者的关键区别在于:
| 维度 | Constitutional AI | Constitutional Classifiers |
|---|---|---|
| 作用阶段 | 训练阶段——用宪法指导模型自身行为 | 推理阶段——用宪法生成分类器训练数据 |
| 实现方式 | RLHF 等训练过程中嵌入宪法规则 | 独立训练分类器,不改主模型 |
| 更新成本 | 需重新训练模型 | 仅需更新宪法并重新训练分类器 |
| 两者关系 | 互补——可同时使用 | 互补——可同时使用 |
1.3 发展历程
-
2025年1月31日 — Anthropic 在 arXiv 发表论文 Constitutional Classifiers: Defending against Universal Jailbreaks across Thousands of Hours of Red Teaming(arXiv:2501.18837),正式提出宪法分类器概念。
-
2025年2月3-10日 — Anthropic 举办公开红队 Demo 挑战赛,339 名越狱者进行了超 30 万次对话交互,约 3,700 小时集体测试。前 5 天无人通关全部 8 题,最终 1 名参与者找到了通用越狱方法。
-
2025年 — 原型系统在 Bug Bounty 程序中经 183 名活跃参与者、超 3,000 小时红队测试,无人找到通用越狱。越狱成功率从 86% 降至 4.4%。误拒率仅增加 0.38%,推理开销增加 23.7%。
-
2026年1月8日 — Anthropic 发布升级版论文 Constitutional Classifiers++: Efficient Production-Grade Defenses against Universal Jailbreaks(arXiv:2601.04603),引入两阶段级联架构,计算成本降低 40 倍,误拒率降至 0.05%。
-
2026年7月2日 — Astroware Labs 发布 HaloGuard 1.0——首个开源权重的宪法分类器实现,0.8B 模型在 7 个安全基准上平均 F1 达 90.9,超越 LlamaGuard4(12B)和 ShieldGemma(27B)。
2. 保护机制:宪法分类器如何保护大模型
宪法分类器的保护机制是一个完整的系统工程,从"宪法"制定到分类器训练、部署和实时拦截,形成了一套闭环安全防护体系。
2.1 整体架构
系统采用"瑞士奶酪"式多层防御模型——多层重叠防护,每层捕捉可能穿过其他层的威胁:
 ┌──────────────┐      ┌──────────┐      ┌────────────┐      ┌──────────┐      ┌──────────────┐
 │  输入分类器    │ ──→  │ 用户输入  │ ──→  │  主模型     │ ──→  │ 模型输出  │ ──→  │  输出分类器   │
 │ 检测恶意请求   │      │          │      │ (如Claude)  │      │         │      │ 流式实时检测  │
 └──────────────┘      └──────────┘      └────────────┘      └──────────┘      └──────────────┘
图:双层分类器架构——输入端和输出端同时防护
2.2 宪法制定
"宪法"是一组动态的自然语言规则,明确指定两类内容:
-
禁止类别:如有害化学物质合成、武器制造、网络攻击等
-
允许类别:如学术讨论、教育内容、科学研究等
这种双重定义是减少误拒率的关键——仅定义"禁止"会导致分类器过于激进地拦截合法请求。Anthropic 还在 2026 年 1 月以 CC 公共领域授权发布了 Claude 的新版宪法,优先级排序为:安全和人类监督 → 伦理行为 → Anthropic 准则 → 有用性。将"有用性"放在最末位,这一排序本身就是一种态度表达。
来源:CocoLoop (2026);Anthropic Research
2.3 合成数据生成管线
这是宪法分类器区别于传统方法的核心创新。训练数据不是人工标注的,而是通过 LLM 自动生成:
阶段 I:基于规则的合成数据生成
-
使用"仅帮助模型"(helpful-only model)根据宪法类别生成覆盖广泛场景的查询(queries)
-
为每个合成输入生成有害和无害两种输出
-
使用提示式语言模型过滤掉无意的拒绝,确保数据质量
阶段 II:数据增强
-
语言翻译:将数据翻译成多种语言
-
越狱风格变换:模仿已知越狱技术(如 uSiNg uNuSuAl cApItAlIzAtIoN)
-
系统提示变化:模拟不同的系统提示场景
-
LLM 改写:使用 LLM 生成语义相同但表达不同的变体
-
组合增强:将上述技术组合使用
阶段 III:自动化红队测试(ART)
通过描述已知越狱技术,提示语言模型生成新的攻击方法,包括长上下文和多轮攻击模板。论文指出,分类器鲁棒性随训练数据量和增强数量的增加而提升。
来源:新浪科技 (2025);NeuralTrust 技术分析
2.4 输入分类器
输入分类器是一个经过微调的小型 LLM(基于 Claude Haiku),负责在用户输入到达主模型之前进行安全检查:
-
将输入分类任务框架化为下一个 token 预测问题
-
使用模板包装整个输入,描述分类任务
-
训练分类器拦截试图建立编码通信或模糊输出的输入
-
训练数据中包含良性查询池,以最小化误报率
2.5 输出分类器(流式预测)
输出分类器是工程上最精密的组件,支持实时流式预测——在每个 token 生成时即时预测完整输出的有害性,无需等待完整响应:
-
在微调的 LLM 上附加线性值头(Linear Value Head),基于前缀 token 序列预测完整序列的有害性
-
如果某 token 位置的预测分数超过阈值,立即阻止输出并停止流式生成
-
在采样和 token 级预测过程中缓存中间激活,实现高效流式分类
训练损失函数: 输出分类器的训练采用混合损失函数:
ℒ(y,t₁:T) = λ·ℒ_NTP(t₁:T) + Σ ℒ_BCE(y, p(y=1|t₁:T'))其中 λ 控制下一个 token 预测任务的重要性,确保分类器不丧失语言建模能力。概率函数 p 可选择独立 token 预测(Option A)或累积最大值预测(Option B)。
2.6 Constitutional Classifiers++ 的升级架构
2026 年 1 月发布的升级版引入了三项关键技术突破:
(1)交换分类器(Exchange Classifiers)
在完整对话上下文中评估模型回复,而非孤立检查单条输出。这解决了上一代系统中攻击者通过上下文拆分和重组来规避检测的漏洞。
(2)两阶段分类器级联
采用轻量探针 + 重型分类器的两阶段架构:
-
第一阶段:线性探针(Linear Probe)检查 Claude 的内部激活状态,筛查所有流量
-
第二阶段:仅约 5.5% 的可疑流量升级到微调的 Haiku 4.5 分类器进行精细判断
-
探针使用平滑的 softmax 加权损失训练,强化对高置信度、时间局部有害性信号的感知
(3)探针-分类器集成
探针和外部分类器具有不同的错误模式(预测排名相关性低),在 logit 级别进行加权平均集成后,效果优于任一单独模型。
| 指标 | 数值 | 说明 |
|---|---|---|
| 40× | 计算成本降低 | 对比基线交换分类器 |
| 0.05% | 生产流量误拒率 | 原为 0.38% |
| ~1% | 额外推理开销 | 原为 23.7% |
| 0 | 通用越狱发现数 | 1700+ 小时红队 |
来源:arXiv:2601.04603, Constitutional Classifiers++ 论文;Zircon Tech 分析 (2026)
2.7 防护效果数据汇总
| 评估维度 | 无防护模型 | CC 原版 | CC++ 升级版 |
|---|---|---|---|
| 越狱成功率 | 86%(Claude 仅阻止 14%) | 4.4%(阻止 95.6%) | 无通用越狱成功 |
| 红队测试时长 | — | 3,000+ 小时 | 1,700+ 小时(198K 次攻击) |
| 生产误拒率增加 | — | +0.38% | +0.05% |
| 推理开销 | — | +23.7% | ~+1%(40 倍成本降低) |
| 高风险漏洞发现数 | — | 1 个(公开 Demo 中) | 1 个(0.005/千次查询检测率) |
| 通用越狱发现数 | — | 0(Bug Bounty)/ 1(公开 Demo) | 0 |
来源:Anthropic Research;arXiv:2601.04603;博客园深度分析 (2026)
3. 适用场景分析
宪法分类器及其衍生技术适用于多种大模型安全防护场景,从 CBRN 高风险领域到通用内容审核,覆盖了模型部署的主要安全需求。
3.1 核心防护场景
| 场景 | 说明 |
|---|---|
| 🧪 CBRN 风险防护 | 化学、生物、放射、核武器。Anthropic 在 Responsible Scaling Policy 中明确指出,宪法分类器旨在帮助达到 CBRN 能力阈值的模型安全部署。Demo 聚焦于化学武器相关查询的防护。 |
| 🔓 通用越狱防御 | 防御可系统性绕过模型安全防护的提示策略,包括前缀注入、角色扮演、编码变换、多轮诱导等攻击手法。 |
| 💬 生产级对话安全 | 在 Claude.ai 的生产流量上验证,误拒率仅增加 0.05%,适用于大规模在线对话服务的实时安全防护。 |
| 🤖 AI Agent 安全 | 扩展到智能体场景,检测间接提示注入、目标劫持等针对 Agent 的攻击。LlamaFirewall 等框架已在此方向布局。 |
| 🔍 RAG 安全防护 | 防止通过检索增强生成(RAG)管道注入恶意指令,识别隐藏在 PDF、网页等非结构化数据中的间接提示注入攻击。 |
| 🌐 多语言安全 | Qwen3Guard 支持 119 种语言,HaloGuard 覆盖 46 种语言,宪法分类器的数据增强包含多语言翻译,可防御跨语言绕过攻击。 |
3.2 典型攻击类型与防护覆盖
| 攻击类型 | 描述 | 防护覆盖 |
|---|---|---|
| 前缀注入 | 在提示前加入特殊前缀降低分类器危害评分 | ✅ 输入分类器检测 |
| 角色扮演/场景伪装 | 通过虚构场景包装恶意意图(如"安全演练""科研实验") | ✅ 宪法规则覆盖 |
| 编码/密码绕过 | 使用 Base64、Unicode 隐写、密码等编码隐藏有害内容 | ✅ 数据增强覆盖 |
| 重组攻击 | 将有害信息拆成无害碎片再拼回去 | ✅ 交换分类器(CC++) |
| 混淆攻击 | 让模型用伪装格式输出敏感内容 | ✅ 输出分类器流式检测 |
| 多轮诱导 | 通过多轮对话逐步引导模型越界 | ✅ 上下文感知分类 |
| 间接提示注入 | 通过检索内容/工具返回注入恶意指令 | ⚠️ 需结合 Agent 防护 |
| 多模态越狱 | 通过图片等非文本模态绕过安全防护 | ⚠️ 需额外多模态防护 |
来源:Anthropic Research;EmergentMind: Input/Output Moderation
4. 主流技术全景:从宪法分类器到护栏生态
大模型安全防护领域已形成了多条技术路线,宪法分类器是其中一条重要路径。以下对主流技术路线进行系统梳理。
4.1 技术路线分类
| 技术路线 | 核心思路 | 代表方案 | 优势 | 局限 |
|---|---|---|---|---|
| 宪法分类器 | 自然语言规则→合成数据→微调分类器 | Anthropic CC/CC++, HaloGuard | 规则可快速更新;对抗鲁棒性强 | 原始方案计算开销大;需大量合成数据 |
| LLM 护栏模型 | 微调 LLM 作为安全分类器 | Llama Guard, ShieldGemma, WildGuard, Qwen3Guard | 开源可部署;多类别覆盖 | 训练数据规模有限;对抗鲁棒性待验证 |
| 推理式安全 | LLM 在推理时解释安全策略并做出判断 | OpenAI gpt-oss-safeguard | 策略可动态更新;透明推理链 | 模型体积大;推理延迟高 |
| 可编程护栏框架 | 用 DSL/配置语言定义安全规则并编排执行 | NVIDIA NeMo Guardrails, Guardrails AI | 灵活可编程;生态集成好 | 非安全优先设计;需工程能力 |
| 安全防火墙 | 系统性安全框架,组件化防护 | Meta LlamaFirewall | Agent 安全;组件化模块化 | 部分组件实验性;集成复杂 |
| 商业 API 服务 | 云端 SaaS 实时安全 API | Lakera Guard, Azure Prompt Shield | 开箱即用;低延迟 | 数据需过境;定价不透明 |
| 模型内部探针 | 分析模型内部激活状态检测有害性 | CC++ 线性探针, 短路方法 | 计算开销极低;利用模型内部信号 | 需模型白盒访问;泛化性待验证 |
4.2 关键技术趋势
趋势 1:从静态分类到流式实时检测。 Qwen3Guard-Stream 和 CC++ 的输出分类器均实现了逐 token 流式安全检测,在模型生成过程中实时干预,而非等待完整响应后审核。这显著降低了安全延迟。
趋势 2:从单一分类器到级联/集成架构。 CC++ 的两阶段级联(探针→分类器)将计算成本降低 40 倍。OpenAI 的系统也采用"轻量主题过滤器→精细分类器"的两级架构。级联架构成为生产部署的标配。
趋势 3:从固定策略到可动态更新策略。 OpenAI gpt-oss-safeguard 支持推理时自定义策略,无需重新训练。宪法分类器的"宪法"也可快速更新。策略灵活性成为竞争焦点。
趋势 4:开源护栏模型趋于免费化和小型化。 HaloGuard 0.8B 超越 27B 模型,Qwen3Guard 提供 0.6B 版本,Prompt Guard 2 提供 22M 版本。"小而精"的安全模型正在挑战"大即好"的固有认知。
5. 开源框架与产品深度对比
以下对当前主流的开源安全护栏模型和框架进行系统对比,涵盖参数规模、性能指标、许可证和适用场景。
5.1 开源安全护栏模型对比
| 模型 | 发布方 | 参数规模 | 许可证 | 核心特点 | 基准表现 |
|---|---|---|---|---|---|
| HaloGuard 1.0 | Astroware Labs | 0.8B / 4B | Apache 2.0 | 首个开源权重宪法分类器;46 条政策+2940 子类别;46 种语言;配对反事实数据生成 | 平均 F1: 90.9(0.8B) / 92.1(4B);FPR: 4.3 / FNR: 9.5 |
| Qwen3Guard | 阿里巴巴通义 | 0.6B / 4B / 8B | 开源 | 流式检测版(Stream)+生成式版(Gen);119 种语言;三级风险分类(Safe/Unsafe/Controversial) | 多项主流基准 SOTA;recall 最高 83.97%(4B) |
| Llama Guard 4 | Meta | 12B (多模态) | Llama Community | 多模态(图文);12 种语言;14 类有害内容;支持 LoRA 微调 | 平均 F1: 75.9 |
| ShieldGemma | 2B / 9B / 27B | Gemma License | 基于 Gemma2;4 类危害(色情/危险/骚扰/仇恨);文本+图像 | 平均 F1: 70.0(2B);AU-PRC 优于 Llama Guard +10.8% | |
| WildGuard | Allen AI | 7B | Apache 2.0 | 三合一:提示有害+回复有害+拒答检测;13 个子类别;92K 标注数据 | 匹配/超越 GPT-4;越狱成功率从 79.8% 降至 2.4% |
| gpt-oss-safeguard | OpenAI | 20B / 120B | Apache 2.0 | 推理式安全模型;推理时自定义策略;完整思维链输出;低/中/高推理程度 | 多策略准确率优于 gpt-5-thinking |
| NemoGuard 8B | NVIDIA | 8B | NVIDIA License | 基于 Llama 3.1;Aegis 2.0 安全分类法(23 类);LoRA 微调 | 平均 F1: 82.9 |
| Prompt Guard 2 | Meta | 22M / 86M | Llama Community | BERT 风格;越狱+提示注入检测;超低延迟;LlamaFirewall 核心组件 | 22M 版延迟降低 75%(对比 86M) |
来源:HaloGuard arXiv:2607.02079;Qwen3Guard 官方博客;ICLR 2026 基准评测论文;CSDN: 开源方案对比;HaloGuard 性能报道
5.2 开源护栏框架对比
| 框架 | 发布方 | 类型 | GitHub Stars | 核心能力 | 最佳场景 |
|---|---|---|---|---|---|
| LlamaFirewall | Meta | 安全防护框架 | — | PromptGuard 2(越狱检测) + Agent Alignment Checks(目标对齐审计) + CodeShield(代码安全);AgentDojo 基准攻击成功率从 17.6% 降至 1.75% | AI Agent 系统、编程助手 |
| NeMo Guardrails | NVIDIA | 可编程护栏编排 | ~5,900 | Colang DSL 定义对话约束;5 类护栏(输入/对话/检索/执行/输出);并行执行降低延迟;LangChain 集成 | 企业对话系统、RAG 管道 |
| Guardrails AI | Guardrails AI | 输出验证框架 | — | Apache 2.0;可组合验证器(PII/毒性/事实性/Schema);Guardrails Hub 24 类预置验证器;~50-100ms 延迟 | 输出层验证、PII 过滤 |
| Garak | NVIDIA/community | 漏洞扫描器 | — | LLM 红队工具;自动化漏洞发现;插件化攻击探针;多模型兼容 | 部署前安全评估 |
来源:Meta LlamaFirewall 论文;BeyondScale 企业实施指南;NeMo Guardrails 概述
5.3 商业产品对比
| 产品 | 提供商 | 部署方式 | 核心能力 | 性能指标 | 注意事项 |
|---|---|---|---|---|---|
| Lakera Guard | Lakera (被 Check Point 收购) | SaaS / 自托管 | 提示注入检测;越狱防护;PII 扫描;100+ 语言;Gandalf 挑战赛数据集 | 检测率 98%+;延迟 <50ms;FPR <0.5%;PINT 基准 95.2% | SaaS 需数据过境;定价不透明 |
| Azure Prompt Shield | Microsoft | Azure 托管 | 提示注入检测;直接+间接攻击检测 | — | 2025 年研究显示可被 Unicode 注入绕过;仅作为一层防护 |
| Cisco AI Defense | 思科 | 企业级 | LLM 宪法定义安全分类;双轴评估(策略+对话) | — | 每次分类需重读 300+ 行策略文档,延迟较高;宪法迭代由 Cisco 控制 |
来源:Wiz: AI Security Tools;Rune vs Lakera 对比;Lakera PINT Benchmark;VendorDeep: 思科 AI Defense 分析
6. 国内安全护栏产业格局
中国大模型安全护栏市场快速发展,以阿里、百度、腾讯、华为等为代表的大厂纷纷布局,同时信通院等机构推动标准化评估。
6.1 国内主要安全护栏产品
阿里云 AI 安全护栏(基于 Qwen3Guard 驱动)
-
核心能力: 全链路防护(输入→输出);Qwen3-Guard+审核大模型双引擎;流式审核;长上下文感知;多模态防护(文本/图片/文件);All-in-One API
-
平台集成: 阿里云百炼、AI 网关、WAF 原生集成;Dify 插件市场上架
-
来源:阿里云产品文档
百度大模型安全护栏(信通院评估优秀级)
-
核心能力: 输入输出双侧 API 全链路管控;安全代答(信任域 RAG);提示词注入/越狱/逻辑陷阱检测;敏感信息脱敏;自适应进化(微调"裁判大模型")
-
特色: 从"一刀切"到"正向引导"的转变
-
来源:今日头条报道
腾讯大模型安全解决方案(云鼎实验室)
-
核心能力: LLM-WAF 防护网关(6 类核心风险);AI-SPM(80+ 组件识别, 200+ 漏洞检测);全生命周期防护(开发→训练→部署→应用)
-
实战验证: 某银行部署后日拦 5,000+ 恶意请求;15ms 响应延迟;99.95% 可用性
-
来源:腾讯云开发者社区
华为云 ModelArts Guard — 适合模型开发链条完整、追求平台内一致性的政企与科研型用户。来源:选型指南
火山引擎大模型应用防火墙 — 适合字节生态内快速构建 RAG/客服/营销自动化的团队,云内同域开箱。
鉴冰 AI-FENCE — 在数据泄露防护与会话级对抗识别上表现稳健,更适合金融、政务、教育、医疗等高敏业务。
6.2 国内安全测评体系
信通院大模型安全护栏能力评估: 百度大模型安全护栏荣获"优秀级"认证。信通院建立了大模型安全护栏的标准化能力评估体系,推动行业规范化发展。
来源:今日头条
全球大语言模型安全防范能力测评报告: 上海财经大学数字经济学院牵头编制,从显性攻击、越狱对抗、意图识别、风险管控、知识可靠性五大维度对 38 款海内外主流大模型进行量化排名。在直接攻击测试中,Anthropic Claude 三款模型实现 100% 拒答领跑行业,OpenAI gpt-5.4-mini、阿里通义千问 qwen3.5 紧随其后。在越狱综合防护中,MiniMax-M3 位列国内模型首位。
6.3 国内技术选型四维度
根据 2025 年 AI 应用安全围栏选型指南,国内护栏选型可从四个维度评估:
| 维度 | 关键指标 | 领先方案 |
|---|---|---|
| 敏感数据防泄露(DLP) | 输入端规避投放+输出端违规生成识别 | 鉴冰 AI-FENCE |
| 性能与体验 | 流式处理+会话级识别+低延迟 | 腾讯云(15ms 级响应) |
| 合规与审计 | 留痕可追溯+处置可复盘+等保 2.0 | 百度/腾讯 |
| 部署与集成 | 云侧一体化+一键开启+多平台适配 | 阿里云/火山引擎 |
7. 专家观点与大厂动态
汇集国际国内专家、研究机构和大厂对宪法分类器及大模型安全防护的观点与评价。
7.1 国际专家与机构观点
Anthropic(Jan Leike, 共同一作): Jan Leike 在加入 Anthropic 之前共同领导了 OpenAI 的 Superalignment 团队。他表示,宪法分类器证明了"防御通用越狱同时保持实际部署可行性是可行的"。这一工作将 AI 安全从"研究问题"转变为"工程问题"。
NIST(美国国家标准与技术研究院): NIST 强调了可适应 AI 安全框架的重要性,宪法分类器的"宪法可更新"特性直接契合了 NIST 的 AI 风险管理框架建议。
⚠️ Palo Alto Networks Unit 42: 对比研究三大云 LLM 平台内置护栏后发现:(1)过于激进的过滤(误报)在代码审查提示中尤为常见;(2)角色扮演和间接请求等策略成功绕过了输入护栏;(3)当模型内部对齐不足时,输出过滤器可能无法可靠地拦截有害内容。结论:护栏是对齐的补充,不是替代。
ICLR 2026 基准评测研究: 对 14 个开源安全护栏模型在 79,331 个样本上的系统评测发现:(1)召回率(Recall)是安全应用的关键指标——漏检有害内容比误报风险更大;(2)模型大小与安全检测性能不相关——Qwen Guard(4B) 召回率最高(83.97%),而 Llama Guard(12B) 和 GPT-OSS Safeguard(20B) 分别漏检高达 75% 和 80% 的有害内容;(3)通用护栏模型优于专用模型。
🚨 Trendyol 安全团队(2025年5月): 测试 Meta LlamaFirewall 发现提示注入成功率高达 50%,PROMPT_GUARD 模块对非英语输入识别能力有限,CODE_SHIELD 未能识别明显的 SQL 注入漏洞。Unicode 隐写技术是最具威胁的攻击向量。
来源:CN-Sec 安全报道
7.2 国内专家与机构观点
上海财经大学赵琳教授团队: 牵头编制全球大语言模型安全防范能力测评报告,从五大维度量化 38 款海内外模型安全水平。报告显示国际模型在直接攻击防御上领先,国内 MiniMax、通义千问在越狱防护上逐步缩小差距。
业界分析人士: Anthropic 将"有用性"放在宪法优先级最末位的排序本身就是一种态度表达——在安全与有用性的天平上,明确向安全倾斜。CC++ 将计算成本从 23.7% 降至约 1%,标志着"AI 安全是工程问题"而非纯粹研究问题的范式转变。
⚠️ 安全研究者对思科 AI Defense 的批评: (1)宪法迭代由 Cisco 控制,用户无法自主修改核心定义;(2)每次分类需重读 300+ 行文档,延迟和计算成本显著高于传统分类器;(3)宪法依赖 LLM 的指令遵循能力,模型更新可能导致行为漂移和分类一致性崩溃。建议企业避免将安全分类的"真理源"完全交予单一厂商。
7.3 大厂动态时间线
| 时间 | 厂商 | 动态 |
|---|---|---|
| 2025.01 | Anthropic | 发布 Constitutional Classifiers 论文(arXiv:2501.18837) |
| 2025.02 | Anthropic | 公开红队 Demo 挑战赛,总奖金支出 $55,000 |
| 2025.04 | Meta | 开源 LlamaFirewall,部署于 Meta 生产环境 |
| 2025.05 | Meta | 发布 Llama Guard 4(多模态,12 种语言)+ Prompt Guard 2 |
| 2025.06 | Allen AI | WildGuard 发表于 NeurIPS 2024 |
| 2025.09 | 阿里巴巴 | 发布 Qwen3Guard——Qwen 家族首款安全护栏模型 |
| 2025.10 | OpenAI | 发布 gpt-oss-safeguard(20B/120B)开源安全推理模型 |
| 2025.10 | Lakera | 被 Check Point 以约 $1.87 亿收购 |
| 2026.01 | Anthropic | 发布 Constitutional Classifiers++(arXiv:2601.04603) |
| 2026.01 | Anthropic | 以 CC 公共领域授权发布 Claude 新版宪法 |
| 2026.07 | Astroware Labs | 发布 HaloGuard 1.0——首个开源权重宪法分类器 |
| 2026.07 | 上海财经大学 | 发布全球大语言模型安全防范能力测评报告(38 款模型) |
8. 综合对比与选型建议
基于以上调研,从多个维度对宪法分类器及其竞品进行综合对比,并给出不同场景下的选型建议。
8.1 宪法分类器 vs 其他主流方案
| 对比维度 | 宪法分类器 (CC/CC++) | LLM 护栏模型 (Llama Guard 等) | 推理式安全 (gpt-oss-safeguard) | 可编程框架 (NeMo Guardrails) | 商业 API (Lakera Guard) |
|---|---|---|---|---|---|
| 技术路线 | 宪法→合成数据→微调分类器 | 大规模标注数据→微调 LLM | 推理时解释策略 | DSL 定义规则→编排执行 | ML 分类器+规则引擎 |
| 越狱防御 | ★★★★★ (95.6% 拦截率) | ★★★☆☆ (因模型而异) | ★★★☆☆ (待更多验证) | ★★☆☆☆ (规则可绕过) | ★★★★☆ (98%+ 检测率) |
| 策略灵活性 | ★★★★☆ (宪法可快速更新) | ★★☆☆☆ (需重新训练) | ★★★★★ (推理时自定义) | ★★★★★ (DSL 即时修改) | ★★★☆☆ (配置阈值/名单) |
| 计算开销 | ★★★★☆ (CC++ ~1%) | ★★★☆☆ (需独立推理) | ★☆☆☆☆ (20B-120B 大模型) | ★★★☆☆ (多轨并行 ~0.5s) | ★★★★★ (云端优化 <50ms) |
| 误拒率 | ★★★★★ (0.05%) | ★★★☆☆ (因模型而异) | ★★★☆☆ (待验证) | ★★★☆☆ (规则误杀) | ★★★★☆ (<0.5%) |
| 开源可用性 | ★★☆☆☆ (HaloGuard 开源实现) | ★★★★★ (多个开源模型) | ★★★★★ (Apache 2.0) | ★★★★★ (开源) | ★☆☆☆☆ (商业 SaaS) |
| 多语言支持 | ★★★★☆ (数据增强含翻译) | ★★★★☆ (Llama Guard 12 语) | ★★★☆☆ (多语言评估中) | ★★★☆☆ (取决于后端模型) | ★★★★★ (100+ 语言) |
| Agent 安全 | ★★☆☆☆ (需扩展) | ★★☆☆☆ (聊天场景为主) | ★★★☆☆ (可定制策略) | ★★★☆☆ (执行轨验证) | ★★★☆☆ (工具调用检测有限) |
| 验证规模 | ★★★★★ (3000+1700 小时红队) | ★★★☆☆ (基准评测) | ★★☆☆☆ (研究预览) | ★★★☆☆ (生产部署) | ★★★★☆ (PINT 基准 95.2%) |
8.2 场景化选型建议
| 应用场景 | 推荐方案 | 理由 |
|---|---|---|
| 高 CBRN 风险模型部署 | 宪法分类器 (CC++) | 唯一经过 3000+ 小时专业红队验证的方案;Anthropic Responsible Scaling Policy 指定 |
| 通用企业对话安全 | Qwen3Guard / Llama Guard 4 | 开源免费;多语言支持;可自托管保护数据隐私 |
| AI Agent 系统 | LlamaFirewall + NeMo Guardrails | Agent 对齐审计+代码安全+可编程护栏编排 |
| 快速商业部署 | Lakera Guard | 开箱即用;低延迟;100+ 语言;无需基础设施 |
| 策略频繁变更场景 | gpt-oss-safeguard / 宪法分类器 | 推理时自定义策略/宪法可快速更新,无需重训练 |
| 金融/政务高敏业务 | 鉴冰 AI-FENCE / 百度护栏 / 腾讯方案 | 信通院认证;等保 2.0 合规;DLP 能力强 |
| 研究/教育场景 | WildGuard + HaloGuard | 三合一检测(提示/回复/拒答);开源权重宪法分类器可复现 |
| 资源受限边缘部署 | HaloGuard 0.8B / Prompt Guard 2 22M / Qwen3Guard 0.6B | 超小模型;低延迟;适合边缘设备 |
9. 局限性与未来展望
9.1 宪法分类器的局限性
⚠️ 1. 非完全防护: 宪法分类器可能无法阻止每一次通用越狱。公开 Demo 中确实有 1 名参与者找到了通用越狱方法。Anthropic 自己也承认这一点,并建议使用互补的防御措施。
⚠️ 2. 攻击面演化: 未来可能开发出针对该系统有效的新型越狱技术。红队发现的两种主要攻击思路——重组攻击(碎片拼合)和混淆攻击(伪装格式输出)——仍需持续关注。
⚠️ 3. 模型针对性: 方法来自 Anthropic,在 Claude 模型上有针对性优化,在其他模型上效果可能不同。CC++ 的线性探针依赖模型白盒访问,不适用于闭源第三方模型。
⚠️ 4. 宪法主观性: 宪法规则的定义依赖人工判断,不同文化/法律背景下"有害"的边界可能不同。这在全球部署时是重大挑战。
⚠️ 5. 多模态局限: 方法主要针对文本模态,多模态越狱(如图片绕过)需要额外的防御机制。
9.2 行业共性挑战
-
安全-可用性权衡: ICLR 2026 评测显示,大模型(如 GPT-OSS Safeguard 20B)倾向保守策略,漏检高达 75-80% 的有害内容。召回率是关键指标,但高召回往往伴随高误报。
-
对抗鲁棒性验证不足: 多数开源护栏模型缺乏大规模红队测试验证。LlamaFirewall 被测试出 50% 提示注入成功率,暴露了非英语场景和多语言绕过的薄弱环节。
-
评估标准不统一: 各模型使用不同的安全分类法和评估基准,横向对比困难。ICLR 2026 论文尝试用 NIST AI 风险框架统一分类,但仍处于早期阶段。
-
Agent 安全是新前沿: 随着 AI Agent 普及,间接提示注入、目标劫持等新型攻击成为重点。LlamaFirewall 的 Agent Alignment Checks 是首个开源思维链审计工具,但仍标记为实验性。
9.3 未来发展方向
| 方向 | 描述 | 当前进展 |
|---|---|---|
| 更高效探针 | 利用模型内部激活实现近零成本安全检测 | CC++ 线性探针已实现 40 倍成本降低 |
| 自动化红队 | 使用 AI 自动生成攻击样本持续硬化分类器 | HaloGuard 的"always-on"对抗红队协议 |
| 多模态安全 | 扩展到图片、音频、视频等模态 | Llama Guard 4 多模态;ShieldGemma 2 图像 |
| Agent 安全 | 思维链审计、工具调用验证、目标对齐检查 | LlamaFirewall Agent Alignment Checks |
| 联邦/隐私保护 | 在不泄露用户数据的前提下进行安全检测 | Meta 预览 AI 请求隐私处理技术 |
| 标准化评估 | 建立统一的安全护栏评估基准和分类法 | NIST AI RMF;OWASP Top 10 for LLMs 2025 |
10. 参考来源汇总
本报告所有数据、观点和结论均来自以下公开来源,按类别整理。
学术论文
-
Sharma, M. et al. "Constitutional Classifiers: Defending against Universal Jailbreaks across Thousands of Hours of Red Teaming." arXiv:2501.18837, 2025. 链接
-
Cunningham, H. et al. "Constitutional Classifiers++: Efficient Production-Grade Defenses against Universal Jailbreaks." arXiv:2601.04603, 2026. 链接
-
Sangameswaran, N. et al. "HaloGuard 1.0: An Open Weights Constitutional Classifier for Multilingual AI Safety." arXiv:2607.02079, 2026. 链接
-
Han, S. et al. "WildGuard: Open One-stop Moderation Tools for Safety Risks, Jailbreaks, and Refusals of LLMs." NeurIPS 2024, arXiv:2406.18495. 链接
-
Raj, R. et al. "Benchmarking Open-Source Safety Guard Models: A Comprehensive Evaluation." ICLR 2026 Workshop, arXiv:2605.28830. 链接
-
Meta. "LlamaFirewall: An open source guardrail system for building secure AI agents." 2025. 链接
大厂官方发布
-
Anthropic. "Constitutional Classifiers: Defending against universal jailbreaks." 官方研究博客
-
阿里巴巴通义. "Qwen3Guard: 实时安全,逐词响应." 官方博客
-
OpenAI. "Introducing gpt-oss-safeguard." 社区公告
-
Meta. "Sharing new open source protection tools and advancements in AI privacy and security." 官方博客
-
NVIDIA. "NeMo Guardrails." 开发者页面
-
阿里云. "安全护栏产品优势." 产品文档
-
百度智能云. "AI 安全护栏." 产品页面
-
腾讯云. "大模型安全解决方案." 开发者社区
专家分析与媒体报道
-
Zircon Tech. "AI Safety Engineering: From Constitutional Classifiers to Circuit Tracing." 2026. 链接
-
Palo Alto Networks Unit 42. "How Good Are the LLM Guardrails on the Market?" 链接
-
BeyondScale. "LLM Guardrails: Enterprise Implementation Guide." 链接
-
腾讯新闻. "攻破 AI 最强守卫,赏金 2 万刀!" 2025. 链接
-
腾讯新闻. "安全与普惠如何平衡?全球大语言模型安全防范能力测评报告发布." 2026. 链接
-
新浪科技. "Anthropic 新方法可阻止 95% Claude「越狱」行为." 2025. 链接
-
CocoLoop. "Anthropic 的 Constitutional Classifiers: 用 AI 的方式防 AI 越狱." 2026. 链接
-
博客园. "1% 成本,把'越狱'按在地上摩擦?Anthropic 新一代安全保护." 2026. 链接
-
CSDN. "LLM 安全评估(guard)模型全景:主流开源方案对比与选型指南." 链接
-
CSDN. "探讨大模型应用安全建设系列 3——护栏选型与输入输出防护." 链接
-
博客园. "2025 年 AI 应用安全围栏产品选型指南." 链接
-
VendorDeep. "思科用 LLM 宪法定义取代人工标注." 链接
-
InfoQ. "Meta 推出开源框架 LlamaFirewall." 链接
-
NeuralTrust. "Constitutional Classifiers: The New Frontier of AI Security." 链接
-
Wiz. "Top AI Security Tools for the Cloud." 链接
-
Lakera. "PINT Benchmark." GitHub
免责声明: 本报告基于公开可获取的学术论文、大厂官方发布、技术媒体报道和专家分析编制。所有数据、观点和结论均注明来源。报告中的性能数据来自各方案自报告或第三方评测,实际效果可能因部署环境、模型版本和攻击场景不同而有所差异。选型建议仅供参考,实际决策应结合具体业务需求进行独立评估和测试。
更多推荐


 8
 0
- 0


 已为社区贡献8条内容

所有评论(0)