
第3篇:意图识别 —— 90% 的请求不该碰大模型
用户输入往往是模糊的、口语化的。意图识别的任务:从用户输入中提取核心意图,匹配到最合适的处理流程。如果意图识别错了,后续所有流程都走不对——就像在机场走错了登机口。
但很多团队犯的第一个错误是:丢给大模型让它判断。这句话暴露的问题是,技术可行不等于工程合理。QPS 升上去后延迟、成本、稳定性全崩。
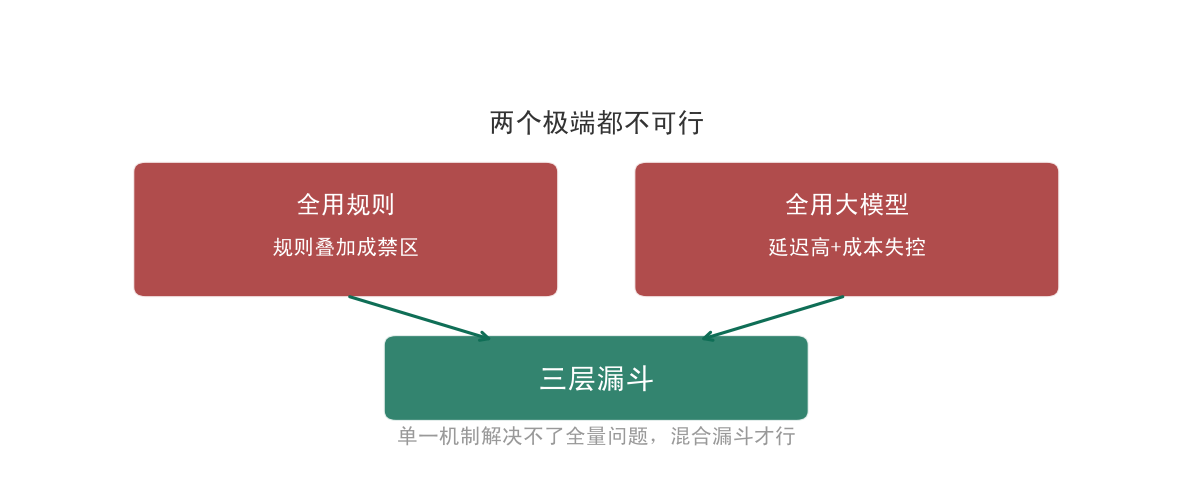
一、两个极端都不可行
| 极端 | 问题 |
|---|---|
| 全用规则(关键词映射表) | 初期简洁→用户表达稍有变化就适配不了→规则叠加成无人敢动的禁区 |
| 全用大模型 | 延迟陡增、账单失控、输出不确定性导致路由出错 |
共同问题:试图用单一机制解决全量问题。解法是三层漏斗。
二、三层漏斗:规则 → 上下文 → 大模型
流量从上往下走,越往下代价越大。目标:绝大多数请求在上层快速处理,不到 10% 才走大模型。
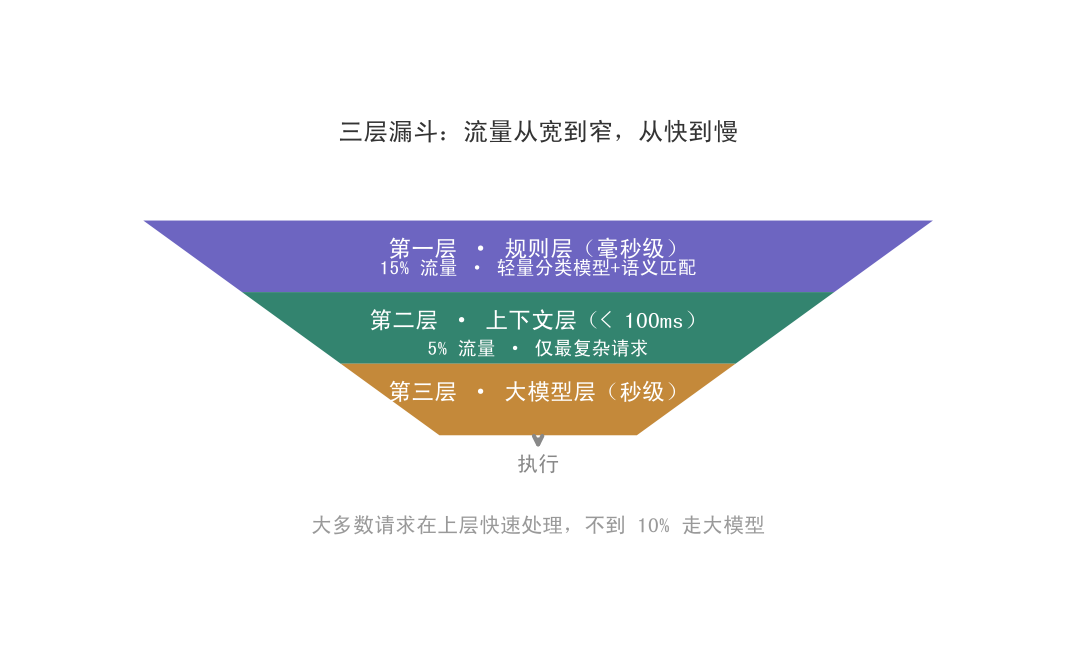
第一层:规则层(毫秒级)
关键词匹配、正则表达式、有限状态机。拦截意图明确、表达固定的请求——“打开设置”“查看余额”“转人工客服”。
设计原则:规则要做减法。只有高频、稳定、表达模式收敛的意图才进规则层,其余交给下层。
第二层:上下文层(< 100ms)
理解对话中的省略和指代。“那个退款到哪了”——"那个"指什么?需要从对话历史获取。
用轻量分类模型(DistilBERT / BERT)+ 语义向量相似度匹配,不直接上大模型。能覆盖 90% 以上的常规意图,延迟控制在 100ms 以内。
工程要点:维护对话状态对象——当前任务类型、已填充槽位、历史动作记录。状态膨胀和过期都会导致意图跑偏,需要有生命周期管理。
第三层:工具调用层(大模型,秒级)
只有走到这里才用大模型。意图跨多领域、表达高度模糊、需外部数据判断的请求。
大模型的任务不是返回标签,而是拆解成可执行步骤,输出结构化的工具调用序列(Function Calling / MCP),系统直接执行。
急诊分诊类比
| 层级 | 医院类比 | Agent 类比 |
|---|---|---|
| 规则层 | 分诊台护士 | 关键词/正则匹配,毫秒级 |
| 上下文层 | 门诊区医生 | 轻量分类模型,< 100ms |
| 工具调用层 | 多科室会诊 | 大模型 + Function Calling,秒级 |
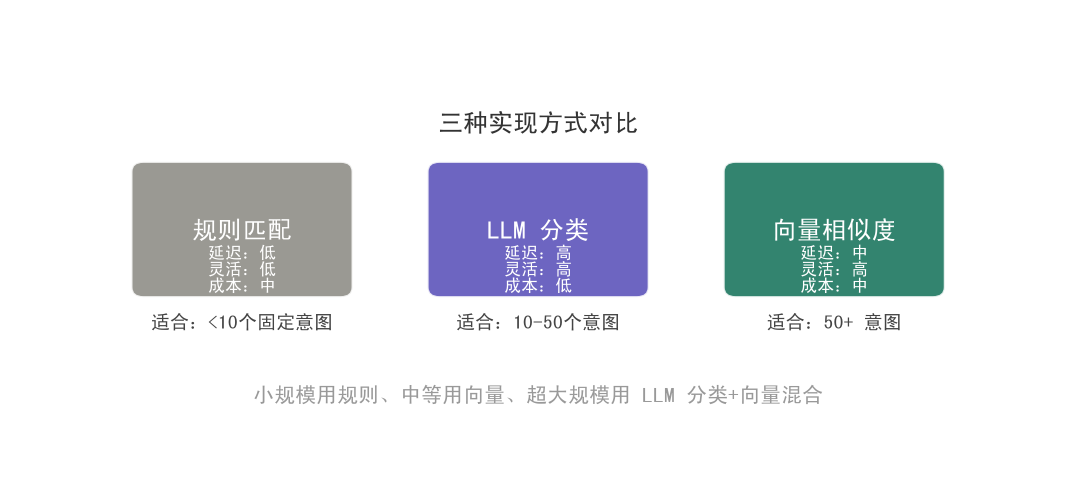
三、三种实现方式
除了漏斗架构,具体实现意图识别有几种方式:
规则匹配:关键词/正则。延迟低但覆盖有限,无法处理同义表达("外面冷不冷"不会触发"天气"关键词)。
LLM 分类:给 LLM 列出所有意图类别和描述,让它判断。灵活度最高但消耗 token。可先做"属于/不属于"二分类过滤再细分。
向量相似度:预定义意图描述→Embedding 入库→用户查询转向量→语义匹配。兼顾灵活度和效率,适合大规模意图库。
| 方式 | 延迟 | 灵活度 | 维护成本 |
|---|---|---|---|
| 规则匹配 | 低 | 低 | 中 |
| LLM 分类 | 高 | 高 | 低 |
| 向量相似度 | 中 | 高 | 中 |
四、多意图与模糊意图
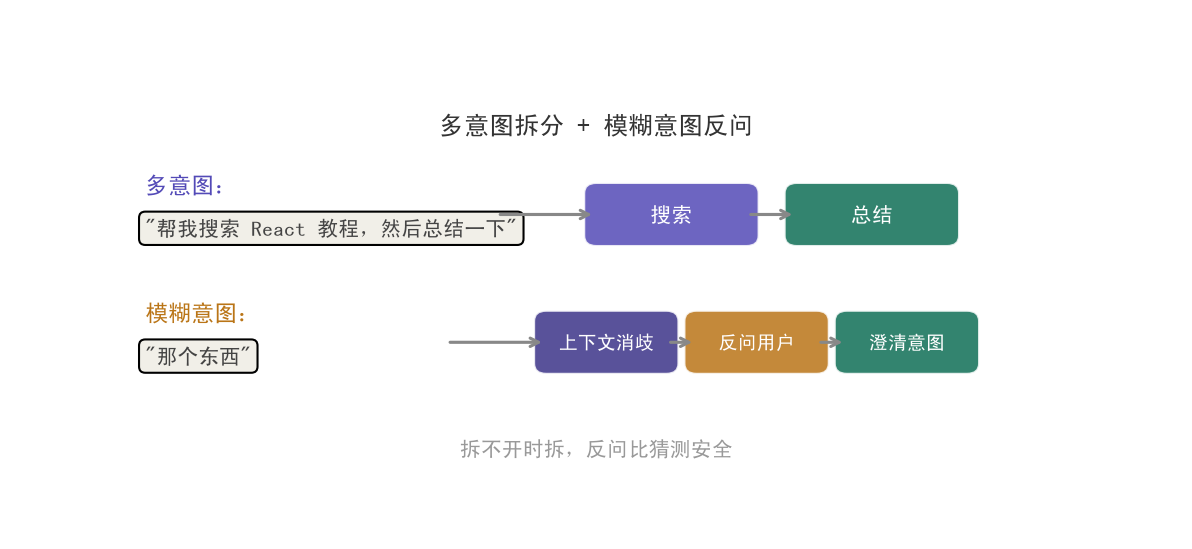
多意图:“帮我搜索 React 教程,然后总结一下”——包含搜索和总结两个意图。方案:意图拆分,按优先级依次或并行执行。
模糊意图:“那个东西”——需要上下文消歧。方案:反问澄清,当置信度低于阈值时不猜测,反问用户确认。
五、意图识别 vs RAG
两个容易搞混的概念:
| 环节 | 决定什么 | 类比 |
|---|---|---|
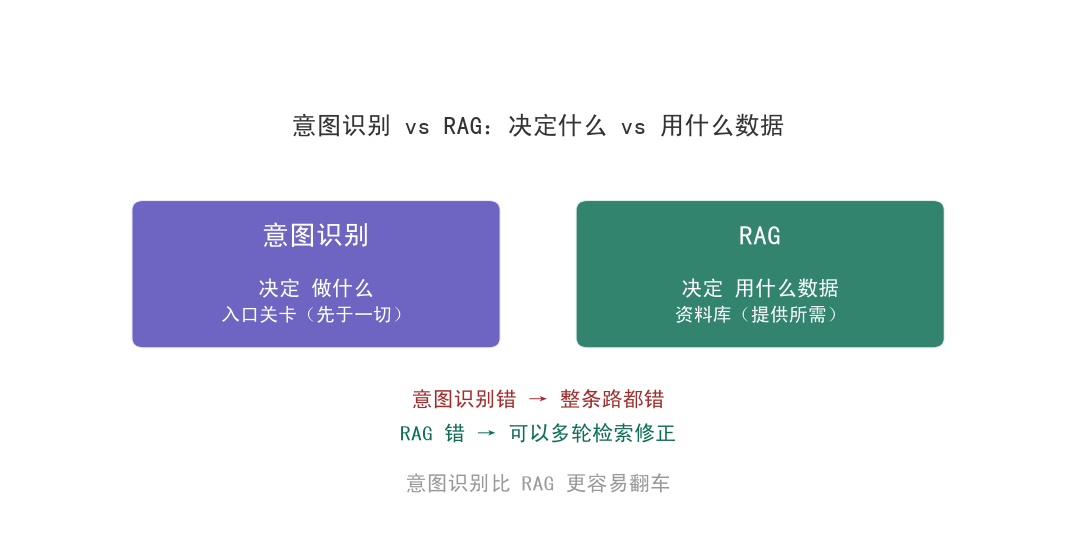
| 意图识别 | “做什么”(匹配 Skill/Tool) | 入口关卡 |
| RAG | “用什么数据”(检索文档) | 资料库 |
两者互补。但意图识别的错误比 RAG 的错误更致命——RAG 错了可以多轮检索修正,意图识别错了整个流程都偏了。
更多推荐


 30
 0
- 0


 已为社区贡献1条内容

所有评论(0)