
ICML 2025|图宾根大学—博世AI中心团队:数据污染会被大模型训练遗忘吗
导读
12025 年 ICML 文献,核心机构为 University of Tübingen / Tübingen AI Center 与 Bosch Research North America / Bosch Center for Artificial Intelligence。研究问题聚焦大模型评测中的 benchmark data contamination。
2文献没有把污染简单处理成“有或没有”的二元标签,而是拆成模型参数量、污染重复次数和训练 token 数三个尺度变量,观察污染是否真的会改变最终评测。
3实验覆盖最高 1.6B 参数、最高 144 次重复污染、最高 40B training tokens,并把 Chinchilla scaling、OLMo-1B / OLMo-7B checkpoint 和 weight decay 动态放在同一条证据链里。
4核心结果是:小规模污染可以造成明显 benchmark overfitting,但继续训练会产生遗忘;在超过 five-times Chinchilla 的训练数据规模下,即便 144 次污染也可能被遗忘。OLMo-7B 中四次污染带来平均 17 个百分点准确率提升,继续预训练剩余训练时间的 13% 后,该提升下降 87%。
5结论边界在于,污染影响不能只靠字符串重叠或样本是否出现判断,还要看污染出现位置、重复强度、模型规模、后续训练长度和优化正则化。
研究背景与目的
大模型评测长期依赖公开 benchmark,但互联网规模训练语料几乎不可避免地与部分测试题、答案解析或近似文本发生重叠。过去对数据污染的讨论往往很绝对:一旦测试集进入训练集,评测就被认为失效。这个判断在小模型和小数据场景中合理,但在现代 LLM 的长周期预训练中并不充分。模型可能看过某个样本,也可能在之后数十万步训练中逐渐淡化这个样本的影响。
这篇文献的目标,是把“污染是否影响评测”从静态检测问题改写成训练动力学问题。真正需要回答的不是样本有没有出现,而是出现了多少次、出现在训练什么阶段、后续还训练了多少数据、模型容量是否足以记住它,以及优化过程会不会把早期样本的影响冲淡。这个视角把 benchmark contamination 与 forgetting dynamics 连接起来,讨论对象从数据审计扩展到模型训练过程。
研究问题因此非常具体:同一批 benchmark questions 被显式插入训练语料后,最终模型在这些题上的表现会提升多少;这种提升会不会随模型变大而增强;会不会随训练 token 数增加而下降;如果污染只发生在训练中段,继续预训练是否能够抹掉污染带来的准确率优势。
研究方法
方法上,文献采用受控污染实验。研究把 benchmark examples 插入预训练数据,并设置 holdout 对照,从而直接比较污染样本与未污染样本在最终评测中的 accuracy difference 和 cross-entropy loss difference。相比只做网页重合搜索,这种设计能直接量化污染对模型行为的影响。
实验沿三个维度扩展。第一是模型规模,覆盖 124M、350M、774M 和 1.6B 参数;第二是污染重复次数,覆盖 4、12、32 和 144 次;第三是训练 token 数,从 Chinchilla token 尺度逐步向更大数据量推进。三个维度同时改变后,污染效应不再是单一方向:模型更大时更容易过拟合污染样本,但训练数据继续扩张时,污染带来的优势又会被稀释。
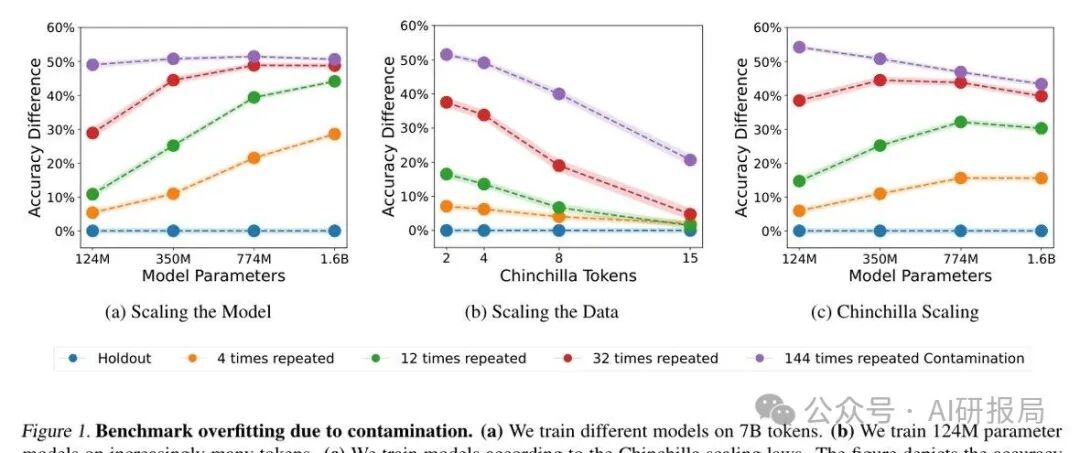
Figure 1:数据污染导致的 benchmark overfitting 随模型规模、训练 token 数和污染重复次数共同变化。
文献还把受控实验放入真实开源模型轨迹中检验。它在 OLMo-1B 与 OLMo-7B 的 intermediate checkpoints 中插入污染 benchmark,再继续预训练,观察污染造成的准确率提升是否会衰减。最后,研究用 weight decay 的累积效应解释 forgetting,但结果显示 empirical forgetting 比单纯权重衰减更快,说明遗忘不只是参数缩小,而是后续训练样本持续重塑了模型行为。
主要发现
第一,污染影响随模型参数量上升而增强。在固定 7B tokens 训练条件下,模型越大,污染样本与 holdout 样本之间的 accuracy difference 越明显。这说明容量更高的模型更容易从重复出现的 benchmark examples 中获得评测优势,也解释了为什么大模型时代对 contamination 的敏感度更高。
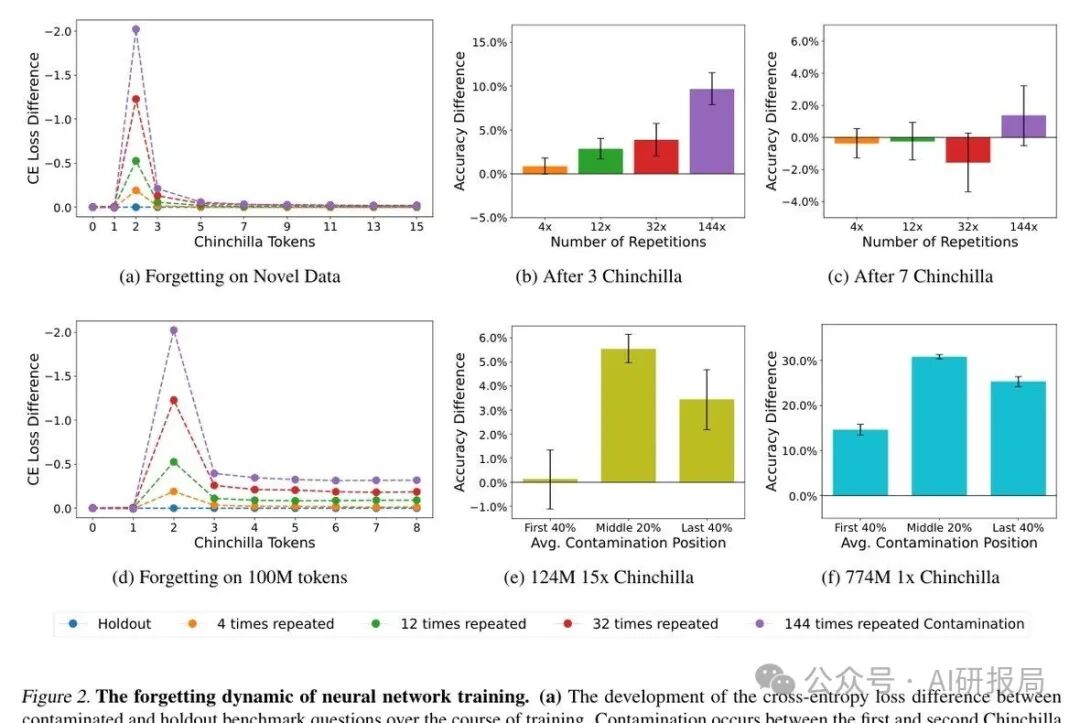
Figure 2:训练继续推进后,污染样本造成的交叉熵差异和准确率差异出现遗忘动态。
第二,训练数据规模增加会削弱污染影响。124M 参数模型在更多 Chinchilla tokens 上训练时,早期污染造成的差异逐步下降。更关键的是,在 model and data follow Chinchilla scaling 的设置下,minor contamination 会造成过拟合,但当训练数据扩展到超过 five-times Chinchilla 时,即便 144 次污染也可能被后续训练遗忘。这个结果打破了“出现过就永久污染”的简单叙事。
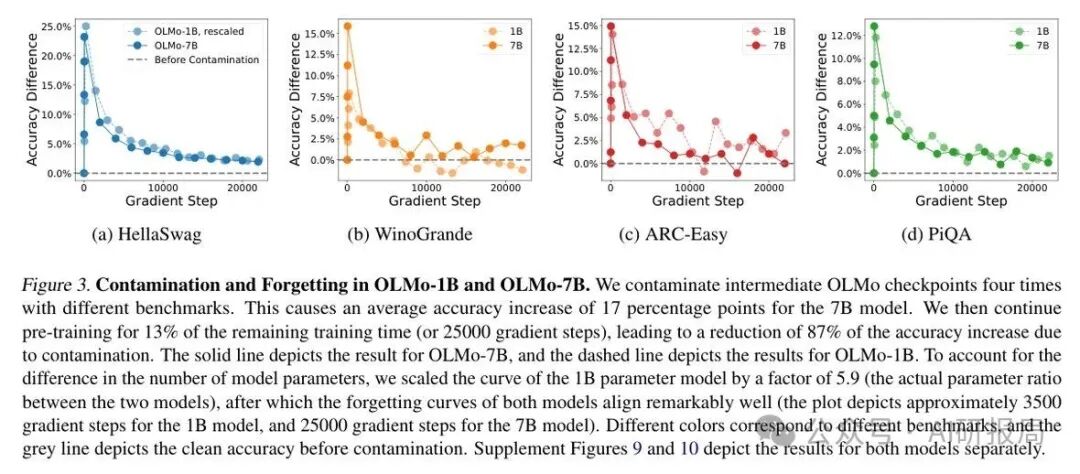
Figure 3:在 OLMo-1B 与 OLMo-7B checkpoint 上插入污染样本后继续预训练,污染增益随训练推进显著衰减。
第三,真实 checkpoint 实验给出更接近大模型训练的证据。OLMo-7B 被四次污染后,平均 accuracy increase 达到 17 percentage points;继续预训练剩余训练时间的 13%,也就是约 25000 gradient steps 后,污染带来的提升下降 87%。这说明污染样本确实能短期改变评测,但继续训练会显著削弱它的可见影响。
第四,污染出现位置也重要。集中出现在训练末期的样本更容易留下痕迹,分布在训练早期的样本更可能被后续数据覆盖。模型最终权重不是训练数据的简单累计,而是不同阶段梯度更新、weight decay、学习率调度和样本重复共同作用的结果。
结论与意义
这篇文献对 AI 评测的意义在于,它把污染问题从“文本是否重合”推进到“重合是否仍然影响模型行为”。公开 benchmark 与训练语料有重叠并不自动等于评测失效,低频、早期、被大量后续训练覆盖的污染,可能在最终模型中留下很弱甚至不可观测的影响;高频、靠近训练末期或与模型容量匹配的污染,则可能显著抬高分数。
对模型发布和第三方测评来说,这个结论会改变审计方式。只报告 benchmark overlap 远远不够,还需要尽可能估计污染样本出现频率、出现阶段、训练后续 token 规模和训练策略。如果训练数据不可见,评测机构也需要更重视动态、私有、可更新的 benchmark,而不是只依赖固定公开题库。
更深一层的意义,是大模型记忆并不是“看过即记住”。模型在预训练中的记忆、遗忘和泛化处在同一条连续谱上。理解这条谱,才能更准确地区分真正能力提升、短期污染收益和 benchmark 设计偏差。
局限性与未来方向
局限在于,受控污染实验仍然简化了真实互联网语料。真实污染可能不是完整题目重复,而是答案解析、网页讨论、同义改写、代码实现或多模态内容重叠。不同类型污染对模型的影响强度可能不同,不能完全由重复次数一个变量概括。
模型规模也仍有限。实验覆盖到 1.6B 参数,并用 OLMo-7B 做 checkpoint 验证,但前沿闭源模型的参数规模、数据规模和训练配方更复杂。Llama 3 405B 等超大规模模型的遗忘推断需要更多外部证据支撑,尤其在训练数据不可审计时,结论只能作为机制解释而非直接测量。
未来方向包括建立更细粒度的污染分类,把 exact match、near-duplicate、semantic overlap 和 answer leakage 分开;同时把污染检测与训练时间轴结合,形成能够估计“污染是否仍然有效”的动态评测审计框架。
参考文献
Proceedings of the 42nd International Conference on Machine Learning,PMLR 267,2025。arXiv:2410.03249。原文题名:How Much Can We Forget about Data Contamination?。
更多推荐



 10
 0
- 0


 已为社区贡献3条内容

所有评论(0)