
别再被厂商分数忽悠!6大主流大模型Benchmark全拆解,选AI不踩营销坑
·
别再被厂商PPT忽悠!6大主流大模型Benchmark通俗拆解,看懂分数不踩营销陷阱
开头
刷到各家大模型发布会,满屏MMLU、GPQA高分,是不是越看越懵?
厂商只挑好看的指标宣传,普通开发者、产品很容易被纸面数字误导。
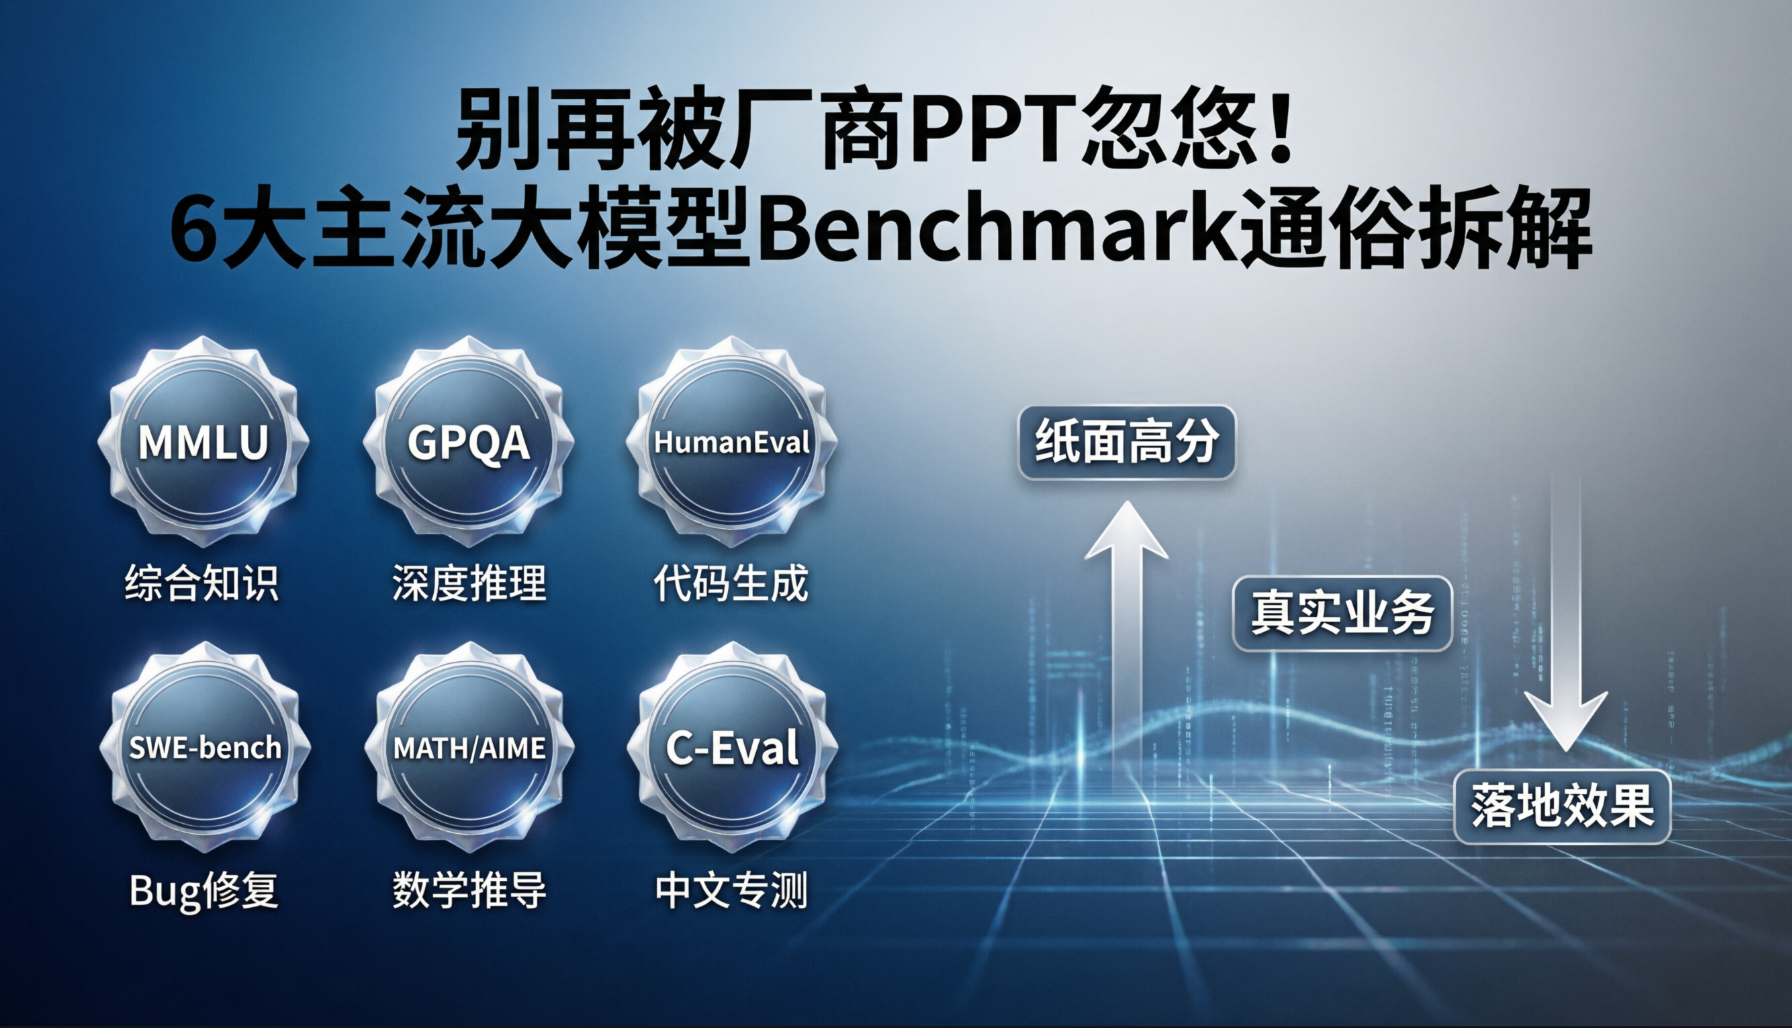
读完这篇你能搞懂:
- Benchmark到底是什么,为什么所有AI都要考这套“统一试卷”
- MMLU/GPQA/HumanEval/C-Eval等6类评测分别测什么能力
- 厂商宣传分数的常见套路,怎么避开营销陷阱
- 真正选型时,该怎么结合Benchmark+真实业务判断模型好坏
全文无晦涩学术术语,全是大白话,手机分段阅读无压力。
一、Benchmark是什么?AI界统一高考卷
1. 通俗定义
Benchmark = 大模型标准化打分评测体系,相当于AI的统一高考。
固定一套标准化试题,给不同模型统一打分,用来横向对比能力。
现在市面上大模型泛滥:GPT-4、GPT-4o、各类国产大模型、各种微调小模型。
没有统一试卷,根本没法客观对比谁强谁弱,Benchmark就是公平评判标准。
2. 核心特点
- 多维测试:知识、推理、代码、中文、数学分开考核
- 可量化:全部输出百分比分数,直观对比高低
- 标准化:所有模型做同一套题目,避免主观评判
二、6个行业主流Benchmark,分别测什么能力
1. MMLU — 综合文理知识卷
全称:Massive Multitask Language Understanding
- 题库规模:覆盖57个学科
- 题目类型:客观选择题
- 考察范围:初中基础→大学专业,包含历史、医学、法律、计算机、数理等全学科
- 作用:衡量模型通用基础知识储备
- 打分参考:85分以上才算综合知识优秀
2. GPQA Diamond — 顶级深度推理难题
全称:Graduate-Level Google-Proof Q&A
- 题目特点:研究生级别理化生硬核大题
- 名字由来:Google-Proof=就算上网搜资料,也很难找到标准答案
- 核心考察:模型原生逻辑推理能力,不是背诵网络现成答案
- 避坑点:很多模型MMLU分高,但GPQA分数极低,只会背题库不会推导
3. HumanEval / SWE-bench — 两大代码专项试卷
专门评判AI写代码、修Bug能力,程序员选型重点看
- HumanEval
- 164道标准编程题
- 考核:根据文字描述,写出可直接运行、通过单元测试的完整函数
- SWE-bench
- 真实开源Github项目历史Bug
- 考核:看懂工程代码、定位问题、提交修复代码
- 适用人群:前端/后端算法工程师、日常写代码场景选型必看
4. MATH / AIME — 竞赛级数学推理
- AIME:美国数学邀请赛原题
- MATH:初高中到大学竞赛数学大题
- 考察重点:分步推导逻辑,不是凑答案、套公式
- 区分点:只会简单算术的模型,这套题会直接拉开差距
5. C-Eval — 中文专属综合试卷
唯一面向中文语境的标准评测集
- 覆盖52个国内学科,分4个难度梯度(小学到专业职称考试)
- 包含大量国内特有知识:公考、文史、传统文化、国内法规
- 国产模型核心考核指标,海外大模型普遍这项短板严重
三、厂商宣传Benchmark的套路,90%的人都踩过
每次大模型发布会,厂商会放出一堆亮眼分数,但藏着3个小心机:
- 只展示优势赛道,隐藏短板
模型代码强就只放HumanEval,中文好只放C-Eval,回避推理、数学低分指标。 - 不区分测试条件
同样MMLU,5-shot和0-shot测试分数差距能到10分,宣传只会放最优条件结果。 - 混淆“门槛分”和“实用分”
Benchmark只是最低门槛,分数高≠业务好用。
举个真实例子:某模型MMLU达到88分,但GPQA只有42分。
纸面综合知识好看,复杂科研推理完全没法用。
四、Benchmark的真实定位:只是门槛,不是最终标准
1. 下限筛选工具
一个模型所有Benchmark全线低分,代表基础能力严重不足,直接排除不用测试业务。
2. 高分不代表落地好用
三大硬限制:
- 题库题目会流入训练数据,高分可能只是背题,不是真懂;
- 评测都是标准化客观题,真实业务是开放式复杂需求;
- 无法评测长文本、多轮对话、业务定制、响应速度、成本。
3. 正确选型判断逻辑
- 先用Benchmark筛掉基础太差的模型;
- 拿自己真实业务场景做实测对比;
- 综合推理、代码、中文、速度、成本多个维度,不单一分数定好坏。
五、完整总结
- Benchmark是标准化AI评测题库,用来横向对比各大模型基础能力;
- 不同指标对应不同能力:MMLU通用知识、GPQA深度推理、HumanEval代码、C-Eval中文;
- 厂商会选择性展示高分指标,不能单看发布会PPT判断模型;
- Benchmark仅作基础门槛,业务落地必须结合真实场景实测。
更多推荐


 8
 0
- 0


 已为社区贡献15条内容

所有评论(0)