
初识机器学习(线性回归)
一、十种常用的机器学习算法
本篇主要分享线性回归算法(Linear Regression),本篇数学知识占比较多,数学基础不牢固的同志们也不要担心,主要理解其基本原理和用法即可,不用太深究某个数学公式或者知识点。
二、线性回归
2.1 什么是线性回归
线性回归 (Linear Regression) 是一种用于预测连续值的最基本的机器学习算法,它假设目标变量 y 和特征变量 x 之间存在线性关系,并试图找到一条最佳拟合直线来描述这种关系。线性回归也是机器学习中最基础且广泛应用的算法之一。
一般的一元线性回归模型如下:
其中 y 是目标变量(预测值),x 是特征变量,w 为权重(斜率),b 为偏置(截距), 为误差项(误差项是指除线性因素外的随机因素产生的误差)。
多元线性回归模型如下:
其中 y 是目标变量(预测值), 是特征变量,
为权重,
为偏置,
为误差项。
线性回归的目标是找到最佳的权重和偏置,使得预测值与真实值之间的误差最小。一般使用损失函数来衡量模型的好坏,常用的损失函数是均方误差 (MSE):
其中 为真实值,
为预测值,m 为数据点的数量。我们的目标是调整权重和偏置的值(调参),使均方误差最小,让预测值更加接近真实值,从而找到最佳的权重和偏置。
2.2 求解线性回归(优化方法)
(1)最小二乘法
最小二乘法是一种常用的求解线性回归的方法,通过对损失函数求导,得到参数的解。最小二乘法的目标是最小化残差平方和(RSS),其公式为:
将模型中的预测值代入到RSS中,再对其权重和偏置分别求偏导,这里以一元线性回归模型为例。
对权重求偏导(令导数等于0求极值):
对偏置求偏导(令导数等于0求极值):
整理后可得到以下方程组:
将方程组写成矩阵形式:
求解矩阵方程即可得到最佳的权重和偏置,这种方法适用于数据量较小且特征数较少的情况。
(2)梯度下降法
梯度下降法简单来说就是通过不断更新参数,使损失函数逐渐减小,梯度下降法适用于大规模数据集。其中梯度下降法的步骤如下:
a. 初始化参数:初始化权重和偏置的值(通常设为 0 或随机值)。
b. 计算损失函数:计算当前参数下的损失函数值
c. 计算梯度:计算损失函数对权重和偏置的偏导数。
d. 更新参数:根据梯度更新权重和偏置。
e. 重复迭代:重复步骤 b 到 d,直到损失函数收敛或达到最大迭代次数。
对于线性回归问题通常使用均方误差作为损失函数:
其中 m 为样本数量(公式中除以2m而不是m,只是为了求导时消去平方产生的系数 2,让梯度公式更简洁,不影响最终拟合结果。因为梯度下降只看下降的方向和相对大小,乘上二分之一相当于把整个损失函数缩小一半,但最小值对应的权重和偏置位置没有发生改变。唯一受影响的是梯度的绝对值大小,但是这个差别会被学习率自动吸收,如果去掉 “2”,将学习率调整为原来的一半,效果相同。), 为真实值,
为预测值,由
计算可得。
梯度是损失函数对参数的偏导数,表示损失函数在参数空间中的变化方向。对于线性回归,梯度计算如下:
梯度下降法通过以下规则更新参数:
其中 是学习率(learning rate),控制每次更新的步长。学习率过低,会导致模型训练时间变长,训练次数变多;学习率过高,会导致参数更新可能会找不到最优参数,也就使损失函数无法收敛。
三、线性回归算法实现
3.1 判断病人血压收缩情况的简单模型
第一步,收集并处理数据,数据如下图所示:
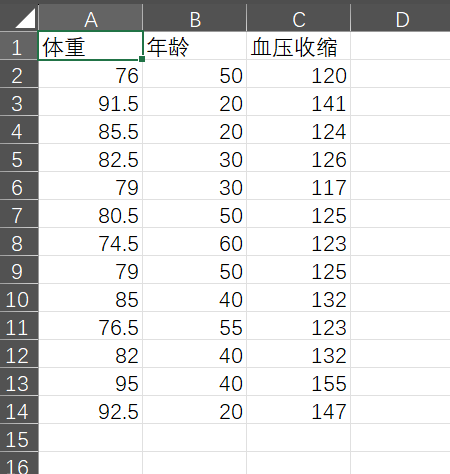
data = pd.read_csv('多元线性回归.csv',encoding='gbk',engine='python')

x = data[['体重','年龄']]
y = data['血压收缩']
第二步,建立并优化模型
model = LinearRegression()
model.fit(x,y)
自测查看模型拟合优度
# data_pred = model.predict()
score = model.score(x,y)    # 拟合优度
print(score)
第三步,解决问题与需求
完整代码如下:
import pandas as pd
from sklearn.linear_model import LinearRegression

data = pd.read_csv('多元线性回归.csv',encoding='gbk',engine='python')

x = data[['体重','年龄']]
y = data['血压收缩']

model = LinearRegression()
model.fit(x,y)

# data_pred = model.predict()
score = model.score(x,y)    # 拟合优度
print(score)
该模型只是一个简单线性回归模型的实现,实际问题需要按部就班划分训练集和测试集,清洗数据,建立模型设置参数,根据实际情况来进行相应的调参,找到最优参数使损失函数收敛,模型拟合,然后再进行自测和使用测试集测试,查看模型拟合优度。到此为止,模型的训练和优化就已经结束,但实际问题的评判标准不能以模型的拟合优度为准,所以要根据实际问题来计算准确率,精确率和召回率甚至F1分数。
准确率(Accuracy)
准确率是最直观的性能指标,它是模型正确预测的样本数占总样本数的比例。用公式表示就是:
其中,TP(True Positives)表示真正例,即模型正确预测为正类的数量;TN(True Negatives)表示真负例,即模型正确预测为负类的数量;FP(False Positives)表示假正例,即模型错误地预测为正类的数量;FN(False Negatives)表示假负例,即模型错误地预测为负类的数量。
精确率(Precision)
精确率,也称为查准率,是预测为正类的样本中实际为正类的比例。它的公式是:
精确率关注的是模型预测为正类的样本中,真正为正类的样本所占的比例。
召回率(Recall)
召回率,也称为查全率,是实际为正类的样本中被模型正确预测为正类的比例。它的公式是:
召回率衡量的是模型对实际正类样本的覆盖能力。
在实际应用中,我们通常需要在精确率和召回率之间找到一个平衡点。例如,在医疗诊断中,我们可能更倾向于高召回率以确保所有病例都被诊断出来,即使这意味着会有一些误诊。而在垃圾邮件过滤中,我们可能更倾向于高精确率以避免重要邮件被错误地标记为垃圾邮件。
为了综合考虑精确率和召回率,我们还可以使用F1分数,它是精确率和召回率的调和平均数:
F1分数越高,模型的性能越好,因为它同时考虑了精确率和召回率。
更多推荐


 11
 0
- 0


 已为社区贡献15条内容

所有评论(0)