
从小米大模型面试题,看 AI 岗位到底在考什么?
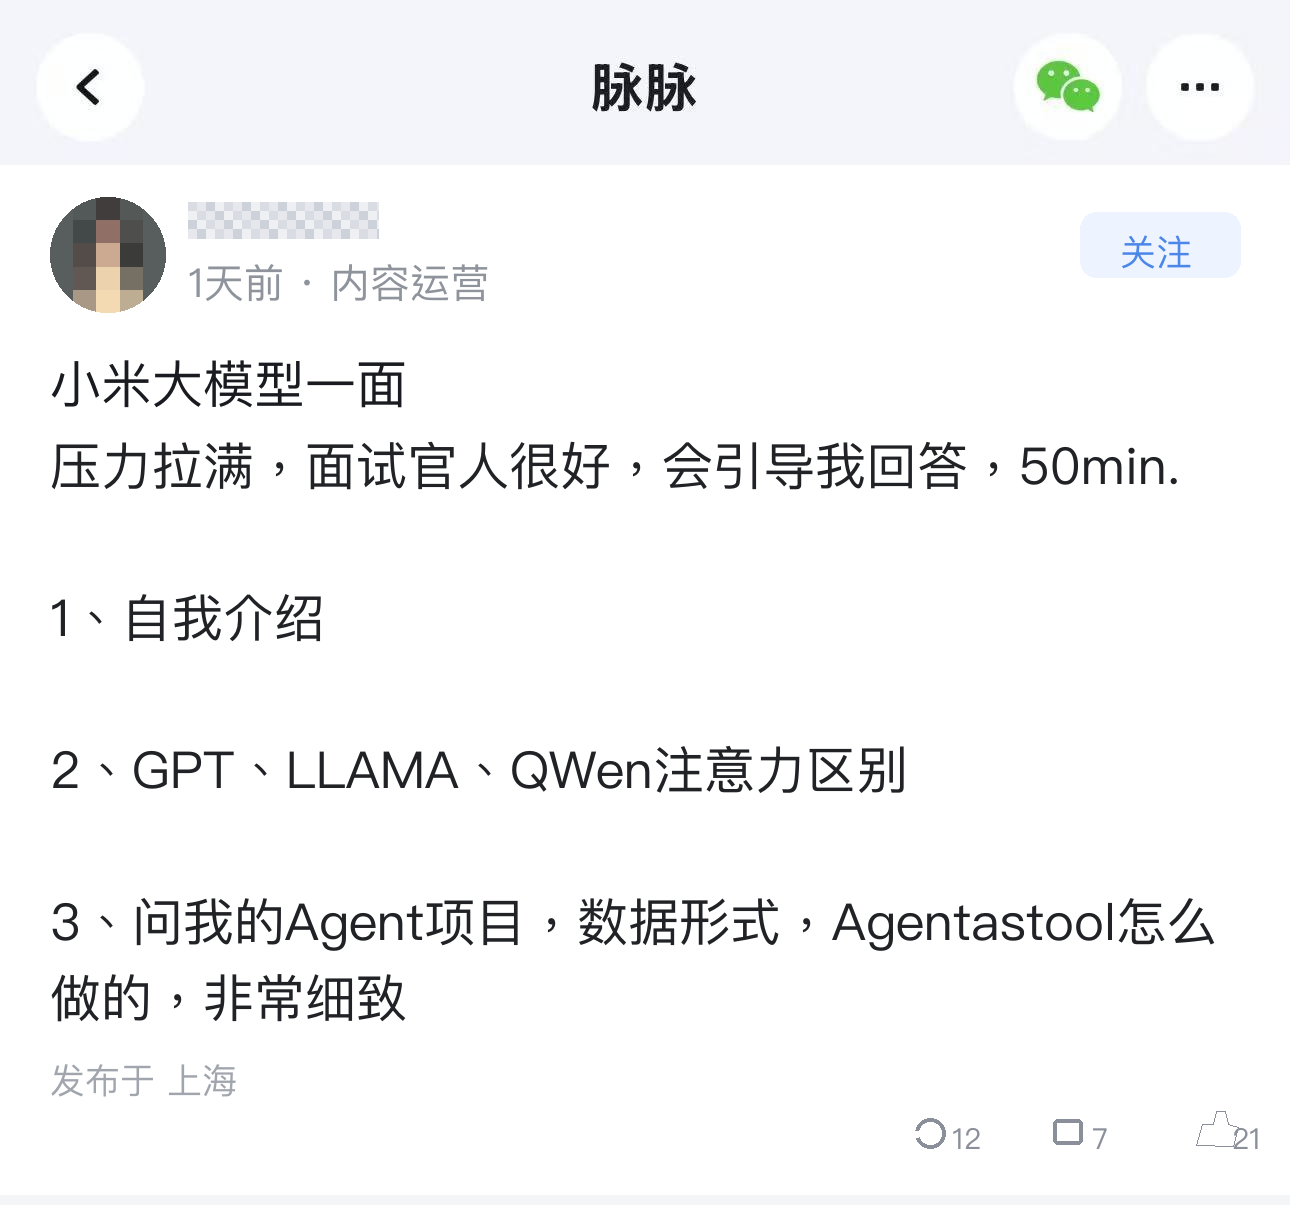
刷脉脉看到一个讨论,一位网友复盘了自己参加“小米大模型一面”的经历。按发帖者的个人回忆,这场约 50 分钟的面试,从 GPT、LLaMA、Qwen 的注意力差异,一路问到 Agent 项目、SFT 数据、LoRA、QLoRA、模型量化和意图识别。需要说明的是,这只是个人面试复盘,属于非官方口径,不能代表公司固定题库,但很适合拿来观察当下 AI 岗位到底在筛选什么能力。
一、基础概念必须能讲出“为什么”
“GPT、LLaMA、Qwen 注意力有什么区别”看似是背书题,真正想判断的往往不是候选人能不能报出名词,而是能否把结构选择、推理成本和业务影响连起来。准备时不要只记 MHA、MQA、GQA 的定义,还要能解释 KV Cache 为什么占显存、分组查询注意力如何兼顾效果和吞吐,以及上下文变长后延迟会怎样变化。
更有效的回答方式是:先讲机制,再讲收益与代价,最后落到场景。例如在线客服强调并发和首字延迟,离线知识抽取更关心吞吐与准确率。这样呈现的是工程判断,而不是术语清单。
二、Agent 项目已经进入“追实现”阶段
原帖提到,面试官会追问 Agent 项目的数据形式,以及 Agent as Tool 如何实现。这意味着简历上写“做过 Agent”已经不够。候选人至少要讲清任务如何拆分、工具怎样注册、参数如何校验、状态如何保存、失败怎样重试,以及怎样避免无限循环和错误调用。
如果项目只是组合开源组件,也不必硬包装。重点是说明自己解决过什么问题:减少幻觉、提升工具命中率、加入权限隔离,还是建立可观测链路。最好准备一张调用流程图,再带上任务成功率、平均调用次数、P95 延迟或人工接管率等指标。
三、微调题考完整实验闭环
网传面试复盘里还出现了 SFT 数据组织、训练轮次、超参数选择、LoRA 与 QLoRA、量化等问题。这些题没有唯一参数,却要求你解释选择依据。
回答时可以按“目标—数据—训练—评估—迭代”展开:先定义任务和基线,再说明数据清洗、去重、模板统一与数据集划分;然后解释学习率、batch size、epoch、LoRA rank 如何确定;最后用离线指标、人工评测和线上反馈证明效果。参数不是越大越好,关键是有实验记录、有对照组,也知道过拟合的信号。
LoRA 与 QLoRA 也不要停在“一个量化、一个不量化”。应进一步说明:量化主要作用于基础模型权重,适配器仍以较高精度训练;这样能降低显存门槛,但也有精度、速度和算子支持方面的取舍。
四、手写代码仍是验真关
评论区有人说,这类面试越来越偏工程实践。原帖的个人复盘提到“手撕 LoRA”,随后换成把 SFT 数据整理为 ChatML 格式。无论该流程是否具有普遍性,信号都很明确:会调用训练框架,不等于真正理解数据和参数怎样流动。
准备时可以实现一个最小 LoRA Linear:冻结原权重,新增低秩矩阵 A、B,正确处理初始化、缩放和前向计算;再写一个数据转换脚本,把多轮对话处理成统一模板,并覆盖空消息、异常字段和长度截断。代码不必长,但必须可测试、可解释。
程序员该怎么准备
第一,选一个最熟的项目,准备一分钟概述、五分钟架构和十五分钟追问。第二,把每个技术选择改写成“为什么不用另一个方案”。第三,为项目补齐数据、评估、监控、成本和失败案例。第四,每周手写两个最小实现,减少对框架魔法的依赖。
大模型岗位正在从“知道概念”转向“能把模型做成系统”。真正拉开差距的,不是记住多少缩写,而是能否把原理、数据、代码和业务指标连成闭环。
原帖链接:查看脉脉原帖
备用搜索关键词:小米大模型一面、GPT LLaMA Qwen 注意力区别、Agentastool。
评论区聊聊:如果你参加大模型岗位面试,最担心被追问的是注意力机制、Agent 工程,还是微调与量化?
更多推荐


 7
 0
- 0


 已为社区贡献3条内容

所有评论(0)