
机器学习入门:逻辑回归——从概率到分类
机器学习入门:逻辑回归——从概率到分类
前言:本文是"机器学习入门"系列的第三站。前两篇我们分别学习了KNN和线性回归,本篇进入一个既熟悉又陌生的算法——逻辑回归。说熟悉,是因为它名字里带着"回归";说陌生,是因为它实际上是一个分类算法。本篇将从线性回归的预测结果出发,引入Sigmoid函数将连续值映射为概率,推导交叉熵损失函数,系统讲解混淆矩阵、准确率、精确率、召回率等评估指标,以及过拟合、欠拟合、正则化和交叉验证等模型优化方法。
一、内容概述
本篇分为五大核心模块:
| 模块 | 内容 |
|---|---|
| 逻辑回归概念 | 从线性回归到分类、Sigmoid函数、概率解释、常用参数与方法 |
| 损失函数与求解 | 极大似然估计、交叉熵损失、梯度下降 |
| 评估指标 | 混淆矩阵、准确率、精确率、召回率、F1-score |
| 模型优化 | 过拟合与欠拟合、正则化(L1/L2)、交叉验证 |
| 实战案例 | 银行信贷风控:预测并拒绝老赖客户 |
二、逻辑回归:从回归到分类
2.1 为什么叫"逻辑回归"?
线性回归输出的是连续数值(如房价预测结果120万),而逻辑回归输出的是概率值(如某笔交易是欺诈的概率为0.87),再根据概率阈值(通常为0.5)做出分类决策。
核心思路:在线性回归的输出基础上,套一层Sigmoid函数,将任意实数压缩到 ( 0 , 1 ) (0, 1) (0,1) 区间,转化为概率。
2.2 Sigmoid函数
Sigmoid函数的数学形式为:
σ
(
z
)
=
1
1
+
e
−
z
\sigma(z) = \frac{1}{1 + e^{-z}}
σ(z)=1+e−z1
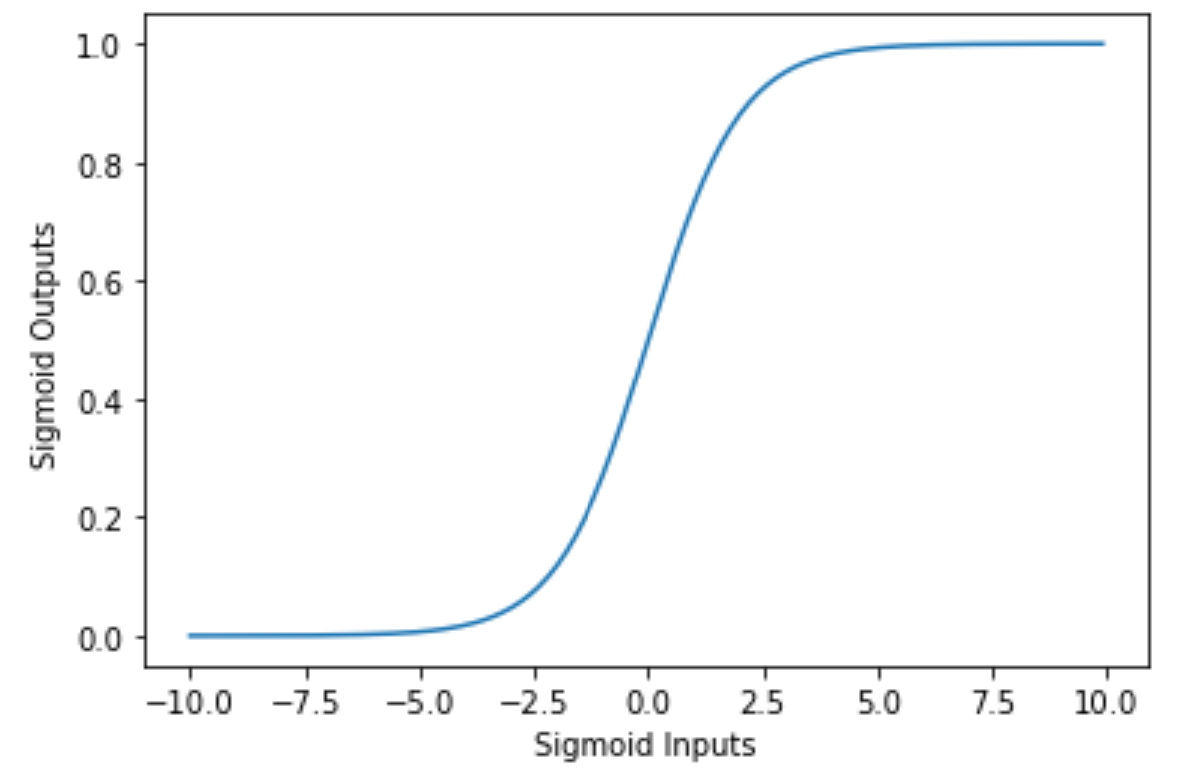
函数特性:
- 当 z → + ∞ z \to +\infty z→+∞ 时, σ ( z ) → 1 \sigma(z) \to 1 σ(z)→1
- 当 z → − ∞ z \to -\infty z→−∞ 时, σ ( z ) → 0 \sigma(z) \to 0 σ(z)→0
- 当 z = 0 z = 0 z=0 时, σ ( 0 ) = 0.5 \sigma(0) = 0.5 σ(0)=0.5
几何意义:Sigmoid函数将任意实数映射到 ( 0 , 1 ) (0, 1) (0,1) 区间,完美契合概率的含义。
2.3 逻辑回归的完整模型
第一步:线性回归输出
z = θ T x = θ 0 + θ 1 x 1 + θ 2 x 2 + ⋯ + θ n x n z = \theta^T x = \theta_0 + \theta_1 x_1 + \theta_2 x_2 + \cdots + \theta_n x_n z=θTx=θ0+θ1x1+θ2x2+⋯+θnxn
第二步:带入Sigmoid函数
h θ ( x ) = g ( θ T x ) = 1 1 + e − θ T x h_\theta(x) = g(\theta^T x) = \frac{1}{1 + e^{-\theta^T x}} hθ(x)=g(θTx)=1+e−θTx1
第三步:概率解释
P ( y = 1 ∣ x ; θ ) = h θ ( x ) P(y = 1 \mid x; \theta) = h_\theta(x) P(y=1∣x;θ)=hθ(x)
P ( y = 0 ∣ x ; θ ) = 1 − h θ ( x ) P(y = 0 \mid x; \theta) = 1 - h_\theta(x) P(y=0∣x;θ)=1−hθ(x)
整合为一个公式:
P ( y ∣ x ; θ ) = ( h θ ( x ) ) y ⋅ ( 1 − h θ ( x ) ) 1 − y P(y \mid x; \theta) = (h_\theta(x))^y \cdot (1 - h_\theta(x))^{1-y} P(y∣x;θ)=(hθ(x))y⋅(1−hθ(x))1−y
当 y = 1 y=1 y=1 时, P = h θ ( x ) P = h_\theta(x) P=hθ(x);当 y = 0 y=0 y=0 时, P = 1 − h θ ( x ) P = 1 - h_\theta(x) P=1−hθ(x)。这个统一写法为后续推导极大似然估计提供了便利。
2.4 逻辑回归 vs 线性回归
| 对比维度 | 线性回归 | 逻辑回归 |
|---|---|---|
| 输出 | 连续数值 | 概率(0~1之间) |
| 任务类型 | 回归 | 分类(二分类为主) |
| 激活函数 | 无(直接输出) | Sigmoid函数 |
| 损失函数 | 均方误差(MSE) | 交叉熵损失(Cross-Entropy) |
| 求解方法 | 正规方程 / 梯度下降 | 梯度下降 |
核心区别:逻辑回归虽然名字带"回归",但它解决的是分类问题,输出的是概率。
2.5 常用参数与方法
核心参数
| 参数 | 类型 | 说明 |
|---|---|---|
penalty | str, 默认l2 | 在高版本中,逐渐弃用。 |
l1_ratio | float, 默认 0.0 | 关键参数:控制弹性网络混合比例。 • 设为 0:等价于 L2正则化。• 设为 1:等价于 L1正则化。• 介于 0~1 之间:为 L1 与 L2 的混合。 |
C | float,默认1.0 | 重中之重:正则化强度的倒数。值越小,正则化越强(过拟合风险越低)。实际调参必调项。 |
solver | str,默认lbfgs | 优化算法:小数据集推荐 lbfgs,大数据集推荐 saga。注意,旧版 liblinear 仅支持 L1 且已过时。 |
max_iter | int,默认100 | 常见报错点:最大迭代次数。如果模型未收敛报警,需将此值调大(如 1000)。 |
fit_intercept | bool,默认True | 是否计算截距项(偏置项),通常保持默认即可。 |
class_weight | dict 或 balanced,默认None | 类别权重。balanced 会自动调整权重,适用于严重类别不平衡场景。 |
random_state | int,默认None | 随机种子,固定该值(如 42)保证结果可复现。 |
multi_class | str,默认auto | 多分类策略:ovr(一对多)/ multinomial(多项逻辑回归)。 |
常用方法
| 方法 | 作用 |
|---|---|
fit(X, y) | 必用:模型训练,学习 θ \theta θ。 |
predict(X) | 核心:预测离散类别(0或1),用于得出最终分类结果。 |
predict_proba(X) | 进阶:预测概率,返回 [ P ( y = 0 ) , P ( y = 1 ) ] [P(y=0), P(y=1)] [P(y=0),P(y=1)]。能让你知道模型有多“自信”。 |
predict_log_proba(X) | 预测对数概率(通常用于需要数学稳定性的底层场景)。 |
score(X, y) | 快捷评估:直接计算模型在当前数据上的准确率(Accuracy)。 |
decision_function(X) | 返回决策函数值 θ T x \theta^T x θTx,即Sigmoid之前的原始值。 |
常用属性
| 属性 | 说明 |
|---|---|
coef_ | 核心:权重系数 θ \theta θ。查看这个可以知道哪个特征对分类结果影响最大。 |
intercept_ | 核心:截距项 θ 0 \theta_0 θ0(偏置项)。 |
n_iter_ | 实际迭代次数(检查是否达到 max_iter)。 |
classes_ | 所有类别标签(例如 [0, 1] 或 [1, 2, 3])。 |
与线性回归的
predict()不同,逻辑回归的predict()输出的是离散类别(0或1),而不是连续数值。这与它的分类任务本质一致。
2.6 逻辑回归的典型应用场景
虽然逻辑回归的数学推导和概念相对基础,但由于其训练速度快、输出结果具有概率可解释性(直接输出 0~1 的概率),它在工业界尤其是与“决策”相关的业务中依然占据着不可替代的地位:
| 应用领域 | 具体场景 | 原因 |
|---|---|---|
| 金融风控 | 银行信贷审批(预测是否坏账/老赖)、信用卡欺诈检测 | 逻辑回归能输出明确的违约概率,业务方可以据此设定拦截阈值(如风险>0.3直接拒贷),风险控制十分清晰。 |
| 医疗诊断 | 根据病人的体检指标(血糖、血压等)预测是否患有某种疾病(如糖尿病) | 医学领域非常看重可解释性。通过逻辑回归的系数 coef_,医生可以直接知道“血糖升高”对患病风险贡献了多少。 |
| 广告点击率预测(CTR) | 在搜索引擎或推荐流中,预测用户是否会点击某条广告 | 互联网广告业务数据量极大,逻辑回归训练速度极快,且能顺滑地处理经过离散化或One-Hot编码的海量用户特征。 |
| 客户流失预警 | 电商或电信公司预测客户下个月是否会注销账号/停止消费 | 企业的挽回成本很高,通过逻辑回归锁定“高流失概率”的客户,可以针对性地发放优惠券进行定向挽留。 |
优点:逻辑回归在这些场景中的绝对优势是极强的模型可解释性。在大数据风控和医疗等强监管行业,模型“为什么做出这个判断”比“判断的准不准”往往更重要。此外,由于损失函数是凸函数,逻辑回归的训练极其稳定,容易收敛。
三、损失函数与求解
3.1 极大似然估计视角
对于二分类问题,每个样本的概率为:
P ( y i ∣ x i ; θ ) = ( h θ ( x i ) ) y i ⋅ ( 1 − h θ ( x i ) ) 1 − y i P(y_i \mid x_i; \theta) = (h_\theta(x_i))^{y_i} \cdot (1 - h_\theta(x_i))^{1-y_i} P(yi∣xi;θ)=(hθ(xi))yi⋅(1−hθ(xi))1−yi
似然函数(所有样本的联合概率):
L ( θ ) = ∏ i = 1 m P ( y i ∣ x i ; θ ) = ∏ i = 1 m ( h θ ( x i ) ) y i ⋅ ( 1 − h θ ( x i ) ) 1 − y i L(\theta) = \prod_{i=1}^{m} P(y_i \mid x_i; \theta) = \prod_{i=1}^{m} (h_\theta(x_i))^{y_i} \cdot (1 - h_\theta(x_i))^{1-y_i} L(θ)=i=1∏mP(yi∣xi;θ)=i=1∏m(hθ(xi))yi⋅(1−hθ(xi))1−yi
对数似然(连乘变连加):
ℓ ( θ ) = log L ( θ ) = ∑ i = 1 m [ y i log h θ ( x i ) + ( 1 − y i ) log ( 1 − h θ ( x i ) ) ] \ell(\theta) = \log L(\theta) = \sum_{i=1}^{m} \left[ y_i \log h_\theta(x_i) + (1 - y_i) \log (1 - h_\theta(x_i)) \right] ℓ(θ)=logL(θ)=i=1∑m[yiloghθ(xi)+(1−yi)log(1−hθ(xi))]
3.2 交叉熵损失函数
在机器学习中,我们通常最小化损失函数,因此将最大化对数似然转化为最小化负对数似然:
J ( θ ) = − 1 m ∑ i = 1 m [ y i log h θ ( x i ) + ( 1 − y i ) log ( 1 − h θ ( x i ) ) ] J(\theta) = -\frac{1}{m} \sum_{i=1}^{m} \left[ y_i \log h_\theta(x_i) + (1 - y_i) \log (1 - h_\theta(x_i)) \right] J(θ)=−m1i=1∑m[yiloghθ(xi)+(1−yi)log(1−hθ(xi))]
这就是交叉熵损失函数(Cross-Entropy Loss),是逻辑回归最核心的损失函数。
3.3 梯度下降求解
通过梯度下降法迭代更新参数 θ \theta θ,使 J ( θ ) J(\theta) J(θ) 逐步减小:
θ j : = θ j − α ⋅ ∂ J ( θ ) ∂ θ j \theta_j := \theta_j - \alpha \cdot \frac{\partial J(\theta)}{\partial \theta_j} θj:=θj−α⋅∂θj∂J(θ)
其中 α \alpha α 是学习率(learning rate),控制每次更新的步长。
四、评估指标
4.1 混淆矩阵
混淆矩阵是评估分类模型最基础的工具,它展示了预测结果与真实标签的对比情况:
| 混淆矩阵 | 预测值=1(老赖) | 预测值=0(好人) |
|---|---|---|
| 真实值=1(老赖) | TP(真正例) | FN(假负例) |
| 真实值=0(好人) | FP(假正例) | TN(真负例) |
四个基本指标:
| 指标 | 含义 | 说明 |
|---|---|---|
| TP(True Positive) | 预测为老赖,真实是老赖 | 正确拒绝坏客户 |
| TN(True Negative) | 预测为好人,真实是好人 | 正确放款给好客户 |
| FP(False Positive) | 预测为老赖,真实是好人 | 误拒好客户(误报) |
| FN(False Negative) | 预测为好人,真实是老赖 | 把老赖当成好人放款了(漏报,最需要避免的错误) |
4.2 衍生评估指标
| 指标 | 公式 | 含义 |
|---|---|---|
| 准确率(Accuracy) | T P + T N T P + T N + F P + F N \frac{TP + TN}{TP + TN + FP + FN} TP+TN+FP+FNTP+TN | 所有样本中预测正确的比例 |
| 精确率(Precision) | T P T P + F P \frac{TP}{TP + FP} TP+FPTP | 被拒绝贷款的人中,真正是老赖的比例 |
| 召回率(Recall) | T P T P + F N \frac{TP}{TP + FN} TP+FNTP | 真实的老赖中,被成功拦截拒绝的比例 |
| F1-score | 2 × P r e c i s i o n × R e c a l l P r e c i s i o n + R e c a l l 2 \times \frac{Precision \times Recall}{Precision + Recall} 2×Precision+RecallPrecision×Recall | 精确率与召回率的调和平均 |
信贷风控业务场景深度解读:
- 在这个预测“老赖”的任务中,“召回率(Recall)” 是最核心的指标。因为一个FN(漏报)意味着银行直接把钱借给了老赖,这笔钱大概率变成坏账。相比于误拒(FP:把好客户拒绝了,损失潜在利息),资金坏账的风险是银行更难以承受的。
- 因此,在模型调优时,我们往往会在保证一定精确率的前提下,尽量最大化召回率。
五、过拟合、欠拟合与交叉验证
5.1 过拟合与欠拟合
| 现象 | 定义 | 表现 | 原因 |
|---|---|---|---|
| 欠拟合 | 模型未能捕捉数据的规律 | 训练集和测试集准确率都低 | 模型过于简单(特征太少、迭代不足) |
| 过拟合 | 模型过度记忆训练数据 | 训练集准确率极高,测试集准确率低 | 模型过于复杂(特征太多、样本太少、正则化过弱) |
直观理解:
- 欠拟合:考试时题目都没看懂,直接乱答
- 过拟合:把练习题的答案背下来了,但考试换了新题目就全错
5.2 正则化(L1 / L2)
正则化通过在损失函数中加入惩罚项,限制模型复杂度,从而缓解过拟合。
| 类型 | 公式 | 特点 |
|---|---|---|
| L1正则化(Lasso) | J ( θ ) + λ ∑ ∣ θ j ∣ J(\theta) + \lambda \sum | \theta_j | J(θ)+λ∑∣θj∣ | 使部分权重变为0,具有特征选择能力 |
| L2正则化(Ridge) | J ( θ ) + λ ∑ θ j 2 J(\theta) + \lambda \sum \theta_j^2 J(θ)+λ∑θj2 | 使权重整体缩小但不为0,稳定性更好 |
在 sklearn.linear_model.LogisticRegression 中,penalty 参数用于选择正则化类型,C 参数控制正则化强度。
5.3 交叉验证
交叉验证是一种评估模型泛化能力的方法,避免因数据划分方式不同而产生误差。
K折交叉验证(K-Fold Cross-Validation):
- 将训练集随机分为 K K K 份(通常 K = 5 K=5 K=5 或 K = 10 K=10 K=10)
- 每次取 K − 1 K-1 K−1 份作为训练集,剩余 1 1 1 份作为验证集
- 重复 K K K 次,每次用不同的验证集
- 取 K K K 次评估结果的平均值作为最终性能指标
为什么需要交叉验证:
- 单次划分可能运气好或运气差(验证集恰好特别简单/特别难)
- 交叉验证能更客观地评估模型的泛化能力
- 常用于超参数调优(如选择最优的 C C C 值/正则化强度)
六、实战案例一:银行信贷风控(预测“老赖”)
6.1 业务场景分析
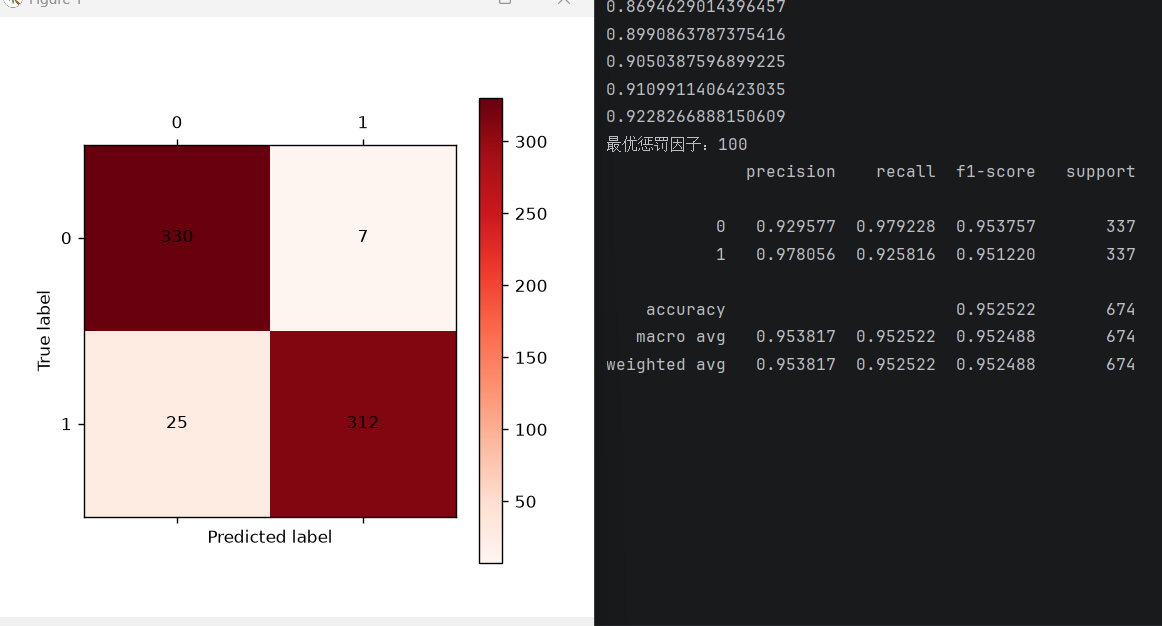
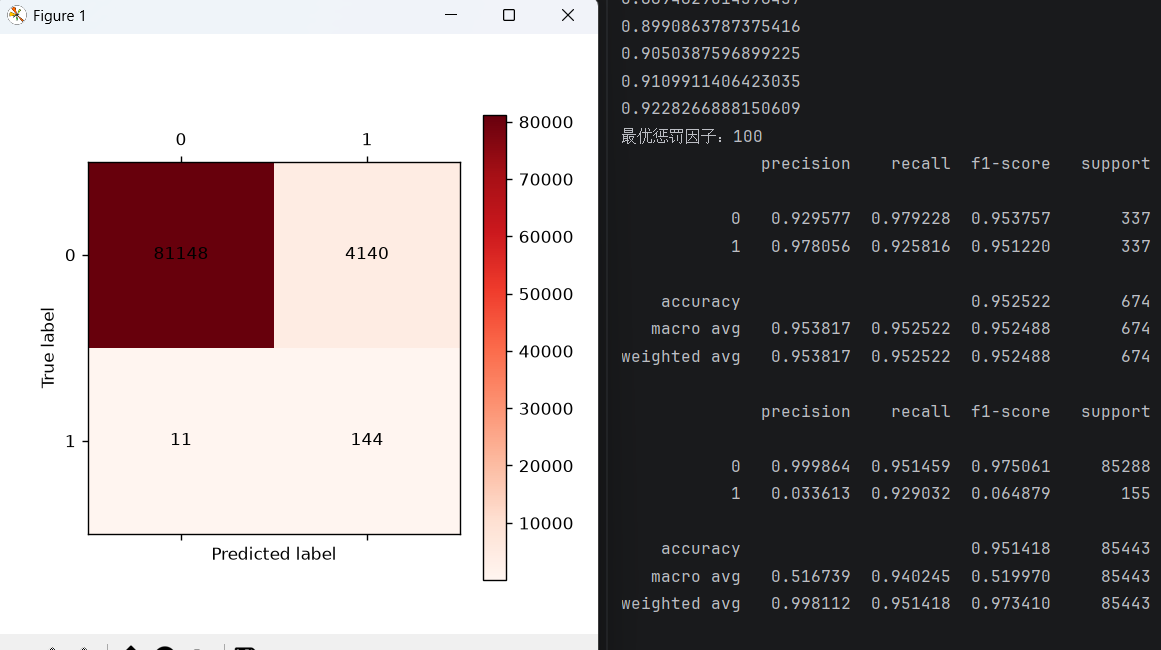
银行信贷审核中,我们将优质还款客户(好人)标签设为 0,将违约老赖客户(坏人)标签设为 1。这是一个典型的类别严重不平衡问题(老赖数量远少于正常客户)。
6.2 核心诉求
尽最大可能避免贷款给老赖。因此我们需要重点关注召回率(Recall),尽量减少将老赖误判为好人的漏报情况。在实际工程中,我们可以通过下采样或调整分类阈值(如将判别阈值从0.5降至0.3,宁可误拒,不可漏放)来实现。
6.3 数据集说明
数据集记录了银行历史信贷业务中的客户申请信息与还款记录,用于构建风控模型预测客户是否会成为“老赖”:
| 列 | 特征 | 说明 |
|---|---|---|
| 第1列 | Time (时间编号) | 数值,作为编号区分数据,可能来自不同的子银行 |
| 第2~29列 | V1 ~ V28 (匿名特征) | 经过 PCA(主成分分析)降维后的加密金融特征 |
| 第30列 | Amount (贷款/交易金额) | 数值量级波动大,多为几十至几千元不等 |
| 第31列 | Class (信用标签) | 0:正常还款客户(好人);1:违约未还款客户(老赖) |
数据节选:
0.0	-1.359807	-0.072781	2.536347	...	-0.021053	149.62	0
0.0	1.191857	0.266151	0.166480	...	0.014724	2.69	0
1.0	-1.358354	-1.340163	1.773209	...	-0.059752	378.66	0
1.0	-0.966272	-0.185226	1.792993	...	0.061458	123.50	0
2.0	-1.158233	0.877737	1.548718	...	0.215153	69.99	0
###  6.4 Python代码实现

```python
import numpy as np
import pandas as pd
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import cross_val_score
from sklearn import metrics


# 绘制可视化混淆矩阵
def cm_plot(y, yp):
    from sklearn.metrics import confusion_matrix
    import matplotlib.pyplot as plt

    cm = confusion_matrix(y, yp)
    plt.matshow(cm, cmap=plt.cm.Reds)
    plt.colorbar()
    for x in range(len(cm)):
        for y in range(len(cm)):
            plt.annotate(cm[x, y], xy=(y, x), va='center', ha='center')
            plt.ylabel('True label')
            plt.xlabel('Predicted label')
    return plt


# 数据预处理:加载银行历史信贷数据集
# 标签 Class: 0代表正常还款的“好人”,1代表违约的“老赖”
data = pd.read_csv('creditcard.csv')

# 数据标准化:对金额等大数值特征进行Z-score标准化
scaler = StandardScaler()
data['Amount'] = scaler.fit_transform(data[['Amount']])
data = data.drop(['Time'], axis=1)

# 划分数据集:分为训练集和独立测试集
X_w = data.drop(['Class'], axis=1)
y_w = data['Class']
X_train_w, X_test_w, y_train_w, y_test_w = train_test_split(X_w, y_w, test_size=0.3, random_state=7)
X_train_w['Class'] = y_train_w
data_train = X_train_w

# 下采样处理类别严重不平衡:让“好人”和“老赖”数量相等
positive_eg = data_train[data_train['Class'] == 0]  # 提取所有正常客户(好人)
negative_eg = data_train[data_train['Class'] == 1]  # 提取所有违约客户(老赖)
positive_eg = positive_eg.sample(len(negative_eg))  # 随机抽取和“老赖”数量一样多的“好人”
data_c = pd.concat([positive_eg, negative_eg])       # 将两者合并成均衡数据集
X_train = data_c.drop(['Class'], axis=1)
y_train = data_c['Class']

# 交叉验证:寻找能最大限度抓住“老赖”的最优惩罚因子 C
scores = []
c_param_range = [0.01, 0.1, 1, 10, 100]
for c in c_param_range:
    clf = LogisticRegression(C=c, l1_ratio=0, solver='lbfgs', max_iter=1000)
    # 核心设置:scoring='recall',因为风控场景下最怕漏抓“老赖”
    score = cross_val_score(clf, X_train, y_train, cv=8, scoring='recall')
    score_mean = sum(score) / len(score)
    scores.append(score_mean)
    print(score_mean)
best_c = c_param_range[np.argmax(scores)]
print(f"最优惩罚因子:{best_c}")

# 建立模型:用找到的最优参数进行训练
clr = LogisticRegression(C=best_c, l1_ratio=0, solver='lbfgs', max_iter=1000)
clr.fit(X_train, y_train)
train_pred = clr.predict(X_train)
print(metrics.classification_report(y_train, train_pred, digits=6))
cm_plot(y_train, train_pred).show()

# 测试:在真实的原始不平衡测试集上评估“抓老赖”的效果
test_pred = clr.predict(X_test_w)
print(metrics.classification_report(y_test_w, test_pred, digits=6))
cm_plot(y_test_w, test_pred).show()
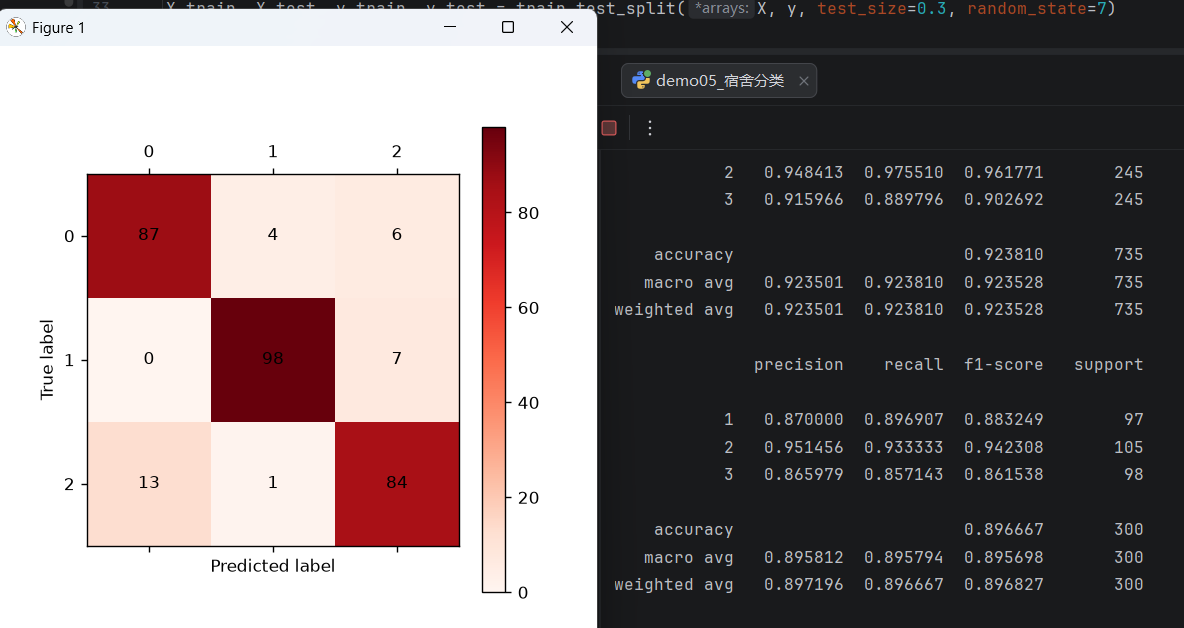
七、实战案例二:高校学生寝室分配(多分类预测)
7.1 业务场景分析
在高校日常管理中,如何合理分配寝室、减少寝室矛盾是一个常见痛点。本案例通过采集新生的日常行为数据,利用逻辑回归模型对学生进行画像分类。
- 特征指标(3个):每年旅行里程、每周游戏占比、每周吃零食重量。
- 分类标签:
1:爱学习型2:一般型3:不爱学习型(偏娱乐)
7.2 核心诉求
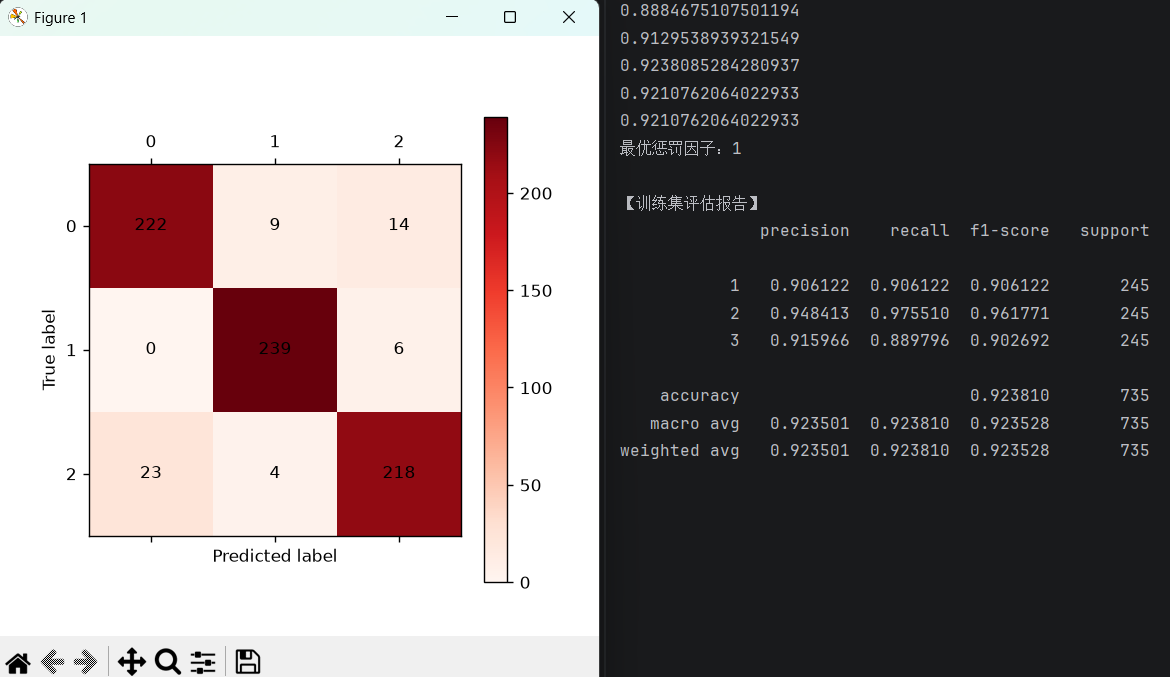
由于三类学生分布不均,部分类型的学生数量可能严重偏少。为了给三类学生提供平等的寝室分配权重,我们采用 SMOTE 过采样 技术,合成少数类样本,避免模型只猜中大多数,从而提升对各类学生的分寝预测准确率。最终模型可辅助辅导员或宿舍管理系统,将生活习惯相近的学生安排在同一寝室。
7.3数据集说明
数据集记录了高年级学生统计的大一新生日常行为数据,用于预测其学习态度:
| 列 | 特征 | 说明 |
|---|---|---|
| 第1列 | 每年外出旅行总里程 | 数值量级为几万 |
| 第2列 | 每日玩游戏时间占比 | 数值范围 0~10 |
| 第3列 | 每周零食食用重量(磅) | 数值范围 0~10 |
| 第4列 | 学习程度标签 | 1:热爱学习;2:程度中等;3:不爱学习 |
数据节选:
40920	8.326976	0.953952	3
14488	7.153469	1.673904	2
26052	1.441871	0.805124	1
75136	13.147394	0.428964	1
38344	1.669788	0.134296	1
7.4 Python代码实现
import pandas as pd
import numpy as np
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import cross_val_score
from sklearn import metrics
from imblearn.over_sampling import SMOTE


# 绘制可视化混淆矩阵(辅助观察分类效果)
def cm_plot(y, yp):
    from sklearn.metrics import confusion_matrix
    import matplotlib.pyplot as plt

    cm = confusion_matrix(y, yp)
    plt.matshow(cm, cmap=plt.cm.Reds)
    plt.colorbar()
    for x in range(len(cm)):
        for y in range(len(cm)):
            plt.annotate(cm[x, y], xy=(y, x), va='center', ha='center')
            plt.ylabel('True label')
            plt.xlabel('Predicted label')
    return plt


# 数据读取:包含三个特征(每年旅行里程、每周游戏占比、每周吃零食重量)
# 标签含义:1代表爱学习,2代表一般般,3代表不爱学习
data = pd.read_csv(
    "datingTestSet2.txt", sep="\t",
    header=None)

# 划分特征与标签
X = data.iloc[:, 0:3]
y = data.iloc[:, -1]

# 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=7)

# 数据标准化
scaler = StandardScaler()
X_train_w = scaler.fit_transform(X_train)
X_test = scaler.transform(X_test)

# 过采样处理:用SMOTE合成少数类样本,解决多分类(3类)样本不平衡问题
oversampler = SMOTE(random_state=7)
X_train, y_train = oversampler.fit_resample(X_train_w, y_train)

# 交叉验证:寻找最优惩罚因子 C
scores = []
c_param_range = [0.01, 0.1, 1, 10, 100]
for c in c_param_range:
    clf = LogisticRegression(C=c, l1_ratio=0, solver='lbfgs', max_iter=1000)
    # 多分类均衡场景,用准确率(accuracy)作为评分标准
    score = cross_val_score(clf, X_train, y_train, cv=8, scoring='accuracy')
    score_mean = sum(score) / len(score)
    scores.append(score_mean)
    print(score_mean)

# 找到最优 C 值
best_c = c_param_range[np.argmax(scores)]
print(f"最优惩罚因子:{best_c}")

# 使用最优参数建立并训练模型
clr = LogisticRegression(C=best_c, l1_ratio=0, solver='lbfgs', max_iter=1000)
clr.fit(X_train, y_train)

train_pred = clr.predict(X_train)
print("\n【训练集评估报告】")
print(metrics.classification_report(y_train, train_pred, digits=6))
cm_plot(y_train, train_pred).show()

# 在真实测试集上评估分寝室模型效果
test_pred = clr.predict(X_test)
print("\n【测试集评估报告】")
print(metrics.classification_report(y_test, test_pred, digits=6))
cm_plot(y_test, test_pred).show()
八、总结
核心脉络
线性回归基础(连续数值输出)
			↓
引入Sigmoid函数(实数映射为0~1概率)
			↓
交叉熵损失函数(极大似然估计推导)
			↓
梯度下降迭代求解(凸函数保证全局最优)
			↓
混淆矩阵与综合评估(精准率、召回率、F1)
			↓
正则化与交叉验证(解决过拟合与参数调优)
三个关键要点:
- 逻辑回归是“披着回归外衣的分类器”,输出的是概率(0~1区间),通过设定阈值完成类别划分。
- 模型评估必须结合业务场景。在风控等“漏报代价极高”的任务中,召回率(Recall)优先于准确率;在类别严重不平衡时,准确率极易产生误导。
- 代码实现重点关注版本适配:在高版本
scikit-learn中,正则化需通过l1_ratio控制(0代表L2,1代表L1),不能仅依赖penalty参数,否则容易无法收敛。
系列直达:
- 上一篇:机器学习入门:线性回归——从极大似然估计到最小二乘法
- 本篇:机器学习入门:逻辑回归——从概率到分类(本文)
- 下一篇:[机器学习入门:决策树——从信息熵到实战分类]
更多推荐



 7
 0
- 0


 已为社区贡献15条内容

所有评论(0)