
速通机器学习 03 | 逻辑回归:信用卡欺诈识别实战
专栏前言
上一节我们学习线性回归,专门用来预测连续数字(回归任务);
本节学习逻辑回归,虽然名字带 “回归”,实际是工业风控最常用的二分类算法,用来区分两类数据:正常交易 / 欺诈盗刷。
案例采用银行信用卡交易数据集,完整复现风控建模全流程。
1. 什么是逻辑回归
1.1 核心原理
线性回归输出是无边界的实数,不能代表概率。逻辑回归在线性公式外套一层 Sigmoid 函数,把数值压缩到 (0,1) 区间,输出结果代表 “属于欺诈交易的概率”。
线性组合公式:
Sigmoid 激活函数:
1.2 分类判定规则
默认判断阈值 0.5:
→ 正类,欺诈交易(Class=1)
→ 负类,正常交易(Class=0)
风控场景可手动下调阈值,优先拦截可疑盗刷。
1.3 模型参数、损失函数与参数优化
- 初始化参数
模型刚创建时,会自动随机初始化一组权重和截距
,此时参数是随机值,预测结果完全不准。
- 损失函数
- 逻辑回归使用交叉熵损失函数,专门用于二分类任务,用来衡量预测概率和真实标签之间的差距,损失值越大,代表模型预测越离谱。
- 二分类交叉熵核心公式:
- 其中:
为真实标签(0/1),
为模型预测的正类概率,n 为样本总数。
- 梯度下降优化参数
模型训练本质就是循环执行梯度下降:不断微调权重参数,持续缩小整体损失值,直到损失收敛、预测效果稳定,这一步由fit()方法自动完成,不需要手动计算。
1.4 正则参数 C 与正则化作用
sklearn 逻辑回归默认开启 L2 正则,
C是正则强度的倒数,完整带正则项的损失公式如下:
公式解析:前半部分为交叉熵损失,负责拟合数据;后半部分为 L2 正则惩罚项,专门约束权重参数:
- C 越小:正则惩罚系数
越大,正则约束越强,大幅限制权重参数的大小,压缩参数区间,减少模型对训练集噪声的记忆,缓解过拟合;
- C 越大:正则惩罚系数
本次实战设置 C=0.01,加大正则力度,避免模型在不平衡的信用卡数据集上过拟合。超参数 C 的最优取值无法凭经验直接确定,后面我们专门,系统学习如何自动筛选最优超参数 C。
2. 数据集业务介绍
数据集文件:creditcard.csv,模拟银行贷款 / 信用卡风控数据,该数据可以在本文开头下载。
数据样例:
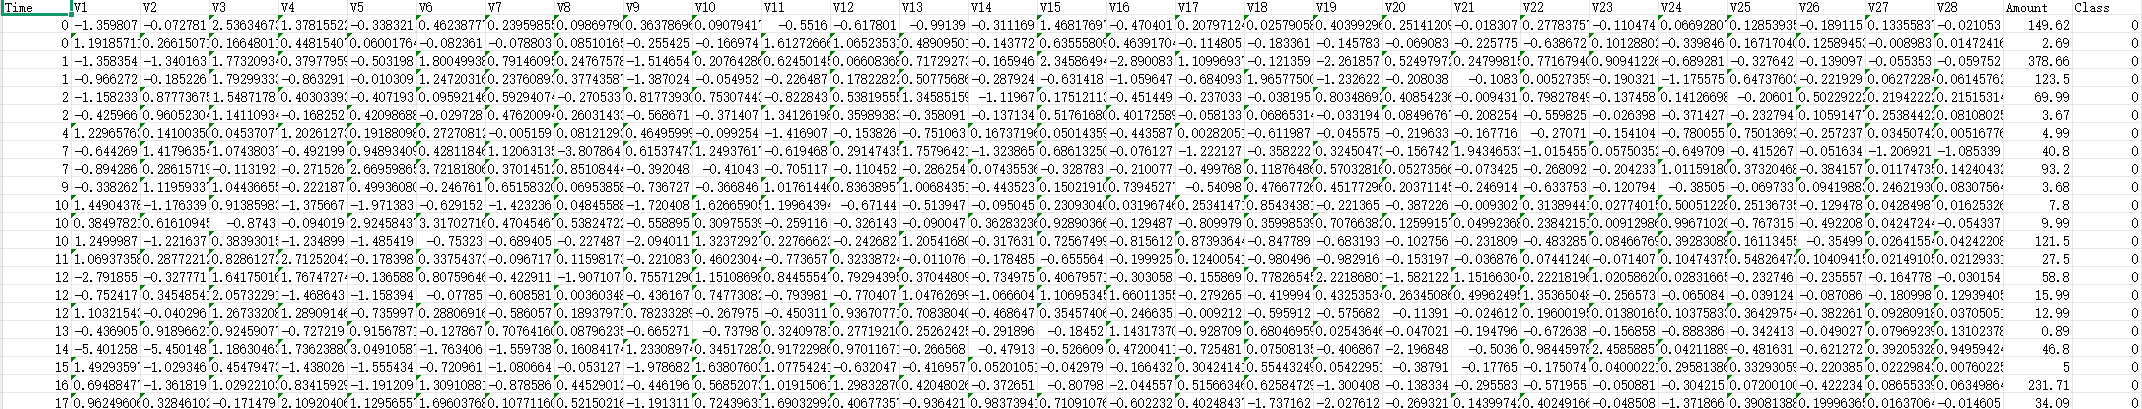
字段说明:
- Time:交易时间戳,和欺诈无明显关联,建模直接删除
- V1~V28:脱敏加密特征(银行隐私数据 PCA 处理后结果)
- Amount:交易金额,数值跨度极大,必须标准化
- Class:分类标签,0 = 正常交易,1 = 欺诈交易
数据集特点:样本极度不平衡,绝大多数为正常交易。
3. 完整建模流程 + 代码分步讲解
整套流程分为 5 步:读取数据→标准化预处理→划分特征标签→拆分训练测试集→训练模型并评估,逐段拆解代码含义。
3.1 第一步:导入 pandas,读取本地 CSV 数据
import pandas as pd
# 读取信用卡交易数据集
data = pd.read_csv(r'D:\pythoncode2\bigdata_ai40\机械学习\data\creditcard.csv')
# 打印前5行数据,查看数据结构
print(data.head())
讲解:
- import pandas as pd:导入表格处理工具,机器学习读取 csv 必用;
- pd.read_csv():读取本地 csv 文件,填写完整文件路径;
- data.head():输出前 5 行,快速核对字段、数据是否读取正常。
3.2 第二步:数据标准化 + 删除无用特征
# 导入标准化工具
from sklearn.preprocessing import StandardScaler
# 创建标准化器对象
scaler = StandardScaler()
仅对交易金额Amount做Z-Score标准化
data['Amount'] = scaler.fit_transform(data[['Amount']])
删除无关时间特征Time
data = data.drop(['Time'],axis=1)
标准化公式:
讲解:
- StandardScaler:Z-Score 标准化工具,把数据缩放为均值 0、方差 1;
- 只处理 Amount 字段:V1-V28 本身已经脱敏标准化,无需重复处理;
- fit_transform():一边计算均值方差,一边完成数值缩放;
- drop(['Time'],axis=1):删除 Time 整列,axis=1 代表按列删除。
3.3 第三步:分离特征 X 与标签 y
# 导入数据集划分工具
from sklearn.model_selection import train_test_split
所有特征:去掉分类标签Class
x_whole = data.drop('Class',axis=1)
预测标签:是否欺诈
y_whole = data.Class
讲解:
- 机器学习固定格式:X 是所有输入特征,y 是需要预测的结果标签;
- drop('Class',axis=1):把标签列从数据表剔除,剩余全部作为特征。
3.4 第四步:拆分训练集、测试集
# 70%训练集,30%测试集,固定随机种子保证结果可复现
x_train_w,x_test_w,y_train_w,y_test_w = train_test_split(x_whole,y_whole,test_size =0.3,random_state=1000)
讲解:
- test_size=0.3:30% 数据作为测试集,70% 用于训练;
- random_state=1000:固定随机划分规则,每次运行拆分结果一模一样,方便复现实验;
- 训练集:用来完成参数初始化、梯度下降优化;测试集:模拟陌生新数据,检验模型真实泛化效果。
3.5 第五步:创建逻辑回归模型、训练、预测评估
# 导入逻辑回归算法
from sklearn.linear_model import LogisticRegression
# 初始化模型,设置正则系数C=0.01
lr = LogisticRegression(C=0.01)
# 使用训练集完成模型训练
lr.fit(x_train_w,y_train_w)
在测试集上预测类别(0正常/1欺诈)
print(lr.predict(x_test_w))
输出训练集整体准确率
print(lr.score(x_train_w,y_train_w))
计算测试集准确率
test_score = lr.score(x_test_w,y_test_w)
print(test_score)
讲解:
- LogisticRegression(C=0.01):实例化逻辑回归,内部自动完成参数初始化,同时通过 C 控制正则化强度;
- .fit(x_train_w,y_train_w):训练核心代码,执行梯度下降算法,持续优化权重参数,最小化交叉熵损失;
- .predict():输入特征,输出每条样本预测类别;
- .score():自动计算准确率 = 预测正确样本数 / 总样本数。
|
重要提醒:本数据集正负样本失衡,单纯准确率无法客观评价欺诈识别能力,后续章节会讲解混淆矩阵、召回率等专业指标。 |
4. 逻辑回归优缺点
优点
- 训练速度快,适配银行海量交易流水;
- 模型可解释,每个特征有权重,是风控行业标准算法;
- 支持正则化,能通过 C 灵活控制拟合程度;
- 输出概率分值,业务可自定义风险阈值。
缺点
- 只能学习线性关系,复杂非线性数据拟合差;
- 对特征尺度敏感,金额类特征必须提前标准化;
- 原生仅支持二分类,多分类任务需要改造。
5. 本章小结
- 逻辑回归是二分类模型,Sigmoid 函数将线性计算转为 0~1 概率;
- 模型流程:随机初始化参数→交叉熵损失衡量误差→梯度下降优化参数;
- L2 正则通过超参数 C 控制强弱,抑制过拟合,下一节讲解最优 C 的筛选方法;
- 银行风控建模标准流程:读取数据→标准化清洗→拆分数据集→模型训练评估;
- 特征标准化是逻辑回归必要步骤,解决量纲差距带来的收敛问题;
- 不平衡分类场景不能只依靠准确率评估模型效果。
更多推荐


 21
 0
- 0


 已为社区贡献19条内容

所有评论(0)