
大模型手搓文件对比工具(4):别再扫描无效文件
前三篇文章里,我用 Java Swing 和大模型手搓了一个文件对比工具。
第一版先实现文件和目录对比、SHA-256 内容校验、左右同步和内容编辑;第二版连续改了 6 轮 UI;第三版又把平铺列表升级成可折叠目录树,并增加了重新加载和 F5 刷新。
目录层级终于看清楚了,但拿真实项目继续测试时,又发现了一个更实际的问题:很多文件根本不需要比较,程序却还是会扫描并计算 Hash。
比如 .git、node_modules、target、日志、缓存、编译产物和临时备份文件。它们可能占据目录中绝大部分文件数量,却不是我真正想检查的内容。
所以第 4 期继续解决一个明确问题:给文件对比工具增加过滤和排除规则,从扫描阶段跳过无效内容。
为什么目录折叠还不够
上一期增加目录折叠后,界面不会一次铺开所有子文件。用户可以先看到目录状态,再逐级展开。
但折叠解决的只是“显示太多”,没有减少后台工作量。
即使 .git 或 node_modules 在界面上保持折叠,程序仍然会递归进入目录、读取每个文件,并计算 SHA-256。对于几万个小文件来说,真正耗时的不是画出几行表格,而是磁盘读取和 Hash 计算。
举几个常见场景:
- 一个前端项目可能有几万个
node_modules文件。 - 一个 Java 项目的
target目录包含大量可重新生成的编译产物。 .git/objects里有大量内部对象,不适合参与业务文件对比。- 日志和缓存文件一直变化,会制造大量无意义的红色差异。
.bak、.tmp、*_old.*等临时文件通常不需要同步。
如果只是把这些文件从结果表格中隐藏,Hash 计算已经发生,性能并不会改善;如果同步时仍然处理这些文件,过滤又失去了安全边界。
因此这次给功能定下的原则是:被排除的内容不进入扫描结果,不计算 Hash,不显示,也不参与同步。
今天的第一条提示词
这次需求来自上一篇文章的“下一步计划”:
增加过滤和排除规则。
实际项目中经常包含
.git、node_modules、target、日志和临时文件。后续会支持按目录名、扩展名和通配符排除内容,减少无效扫描和 Hash 计算。这次做这个吧。
大模型收到需求后,很容易立刻进入代码分析和实现。但这次仍然需要先确定过滤入口放在哪里、主页面要不要长期显示规则、规则应该怎样分组。
于是我补充了一条约束:
先出 UI 以及计划方案,再给我修改吧。
这句话再次把开发过程拉回到“先确认交互,再修改代码”。
过滤功能本身并不复杂,但如果直接在左右路径下方增加三行输入框,刚刚压缩好的主界面又会被占掉一大块空间。上一期才把工作区腾出来,这一期不能因为新增功能重新堆满控件。
UI 方案:主页面只放一个漏斗
最终方案是在右上角刷新按钮旁边增加一个漏斗图标,同时在“工具”菜单中增加“过滤和排除规则”。
点击漏斗后再打开独立弹窗,编辑三类规则:
- 排除目录名。
- 排除文件扩展名。
- 排除通配符。
效果图如下:
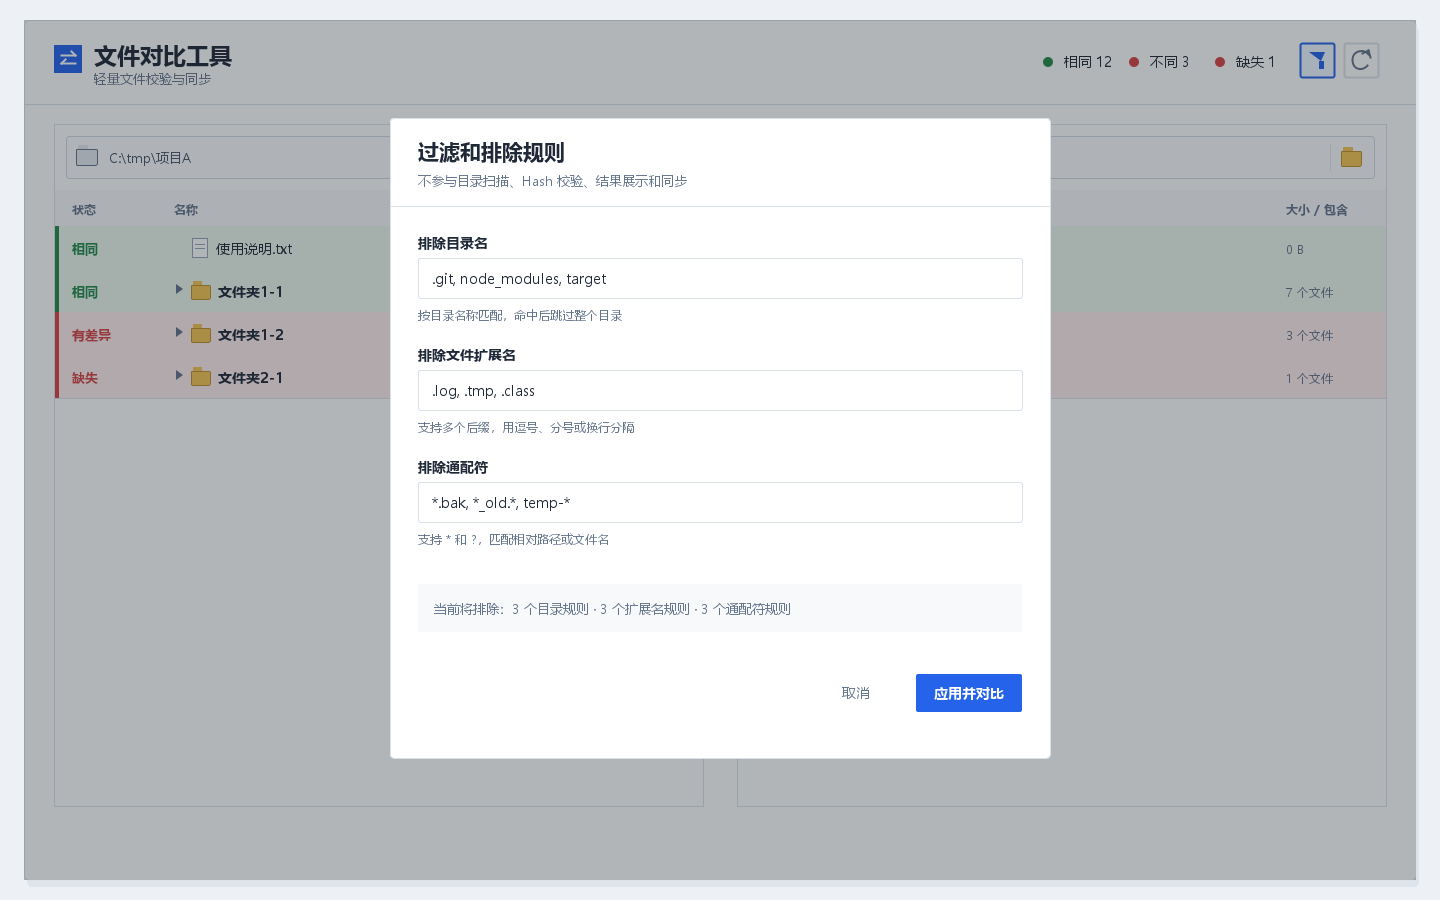
这版方案延续了前几期的扁平风格,也尽量减少常驻信息:
- 主页面只增加一个 34 像素的漏斗按钮。
- 三组规则集中放在弹窗中,不挤压文件列表。
- 每个输入框下面提供简短的匹配说明。
- 支持逗号、分号或换行分隔多个规则。
- 底部显示当前三类规则数量。
- 主按钮使用“应用并对比”,明确说明保存后会立即重新扫描。
计划和效果图确认后,我回复:
可以的。开始吧。
到这一步才正式修改 Java 代码。
三类规则分别解决什么问题
1. 按目录名排除
目录名规则适合排除结构明确、整棵子树都不需要处理的目录,例如:
.git, node_modules, target
扫描进入目录前,会先读取当前目录名称。如果命中规则,直接返回 SKIP_SUBTREE,这个目录下面的内容不会继续遍历。
这是性能收益最大的一类过滤。排除一个 node_modules,可能意味着跳过几万个文件和几万个 SHA-256 计算。
2. 按文件扩展名排除
扩展名规则适合日志、缓存、编译产物和临时文件,例如:
.log, .tmp, .class
输入时可以带点,也可以直接写 log、tmp。程序会统一规范成小写后缀,并进行大小写不敏感比较,所以 APP.LOG 同样能够被 .log 排除。
命中文件扩展名后,程序不会调用文件读取和 Hash 方法。
3. 按通配符排除
只靠目录名和扩展名无法覆盖所有情况。有些临时文件具有固定命名模式,却没有统一扩展名。
因此增加了 * 和 ? 通配符:
*.bak, *_old.*, temp-*
*表示任意长度字符。?表示任意一个字符。- 规则同时匹配文件名和相对路径。
- 通配符也可以命中目录,命中后跳过整个目录子树。
例如 *_old.* 可以排除 config_old.json,temp-* 可以排除以 temp- 开头的文件或目录。
过滤必须发生在 Hash 之前
这次实现里最重要的技术位置,不是过滤弹窗,而是过滤判断放在哪里。
目录扫描原来使用 Files.walkFileTree:
- 进入目录。
- 递归访问文件。
- 读取文件大小。
- 读取文件内容并计算 SHA-256。
- 把结果加入左右快照。
过滤规则必须插入第 1 步和第 3 步之前。
目录规则在 preVisitDirectory 中判断,命中后直接跳过子树;文件规则在 visitFile 中判断,命中后直接继续访问下一个文件。只有未被排除的文件才会继续读取大小和计算 Hash。
这样过滤才真正减少磁盘 IO 和 CPU 计算,而不是做一个“眼不见为净”的结果隐藏功能。
为什么同步也会自动遵守过滤规则
同步功能使用最后一次对比结果作为数据源。
被过滤的文件从一开始就没有进入目录快照,也不会生成对比记录,因此同步阶段自然看不到这些文件。无论从左侧同步到右侧,还是从右侧同步到左侧,都不会复制被排除的内容。
这比同步时再单独判断一次规则更稳妥,因为扫描、展示和同步使用的是同一份过滤后的数据,不会出现界面里看不到、同步时却突然复制的情况。
需要说明的是:过滤不会删除目标目录中的已有文件。当前同步逻辑仍然只复制缺失或内容不同的文件,不执行删除操作。
规则如何保存和应用
三类输入内容会被解析成一个不可变的过滤配置快照。点击“应用并对比”后:
- 保存当前规则。
- 清空旧的目录展开状态。
- 重新扫描左右目录。
- 更新文件数量和差异统计。
- 在底部显示本次排除数量。
F5和右上角刷新继续沿用当前规则。
过滤规则启用后,右上角漏斗会显示蓝色边框和浅蓝背景;清空所有规则后恢复灰色。这样不用打开弹窗,也能知道当前结果是否经过过滤。
文件对比模式不需要目录过滤,因此漏斗按钮会保持禁用,单文件 SHA-256 对比逻辑不受影响。
最终界面效果
过滤规则生效后的主界面如下:
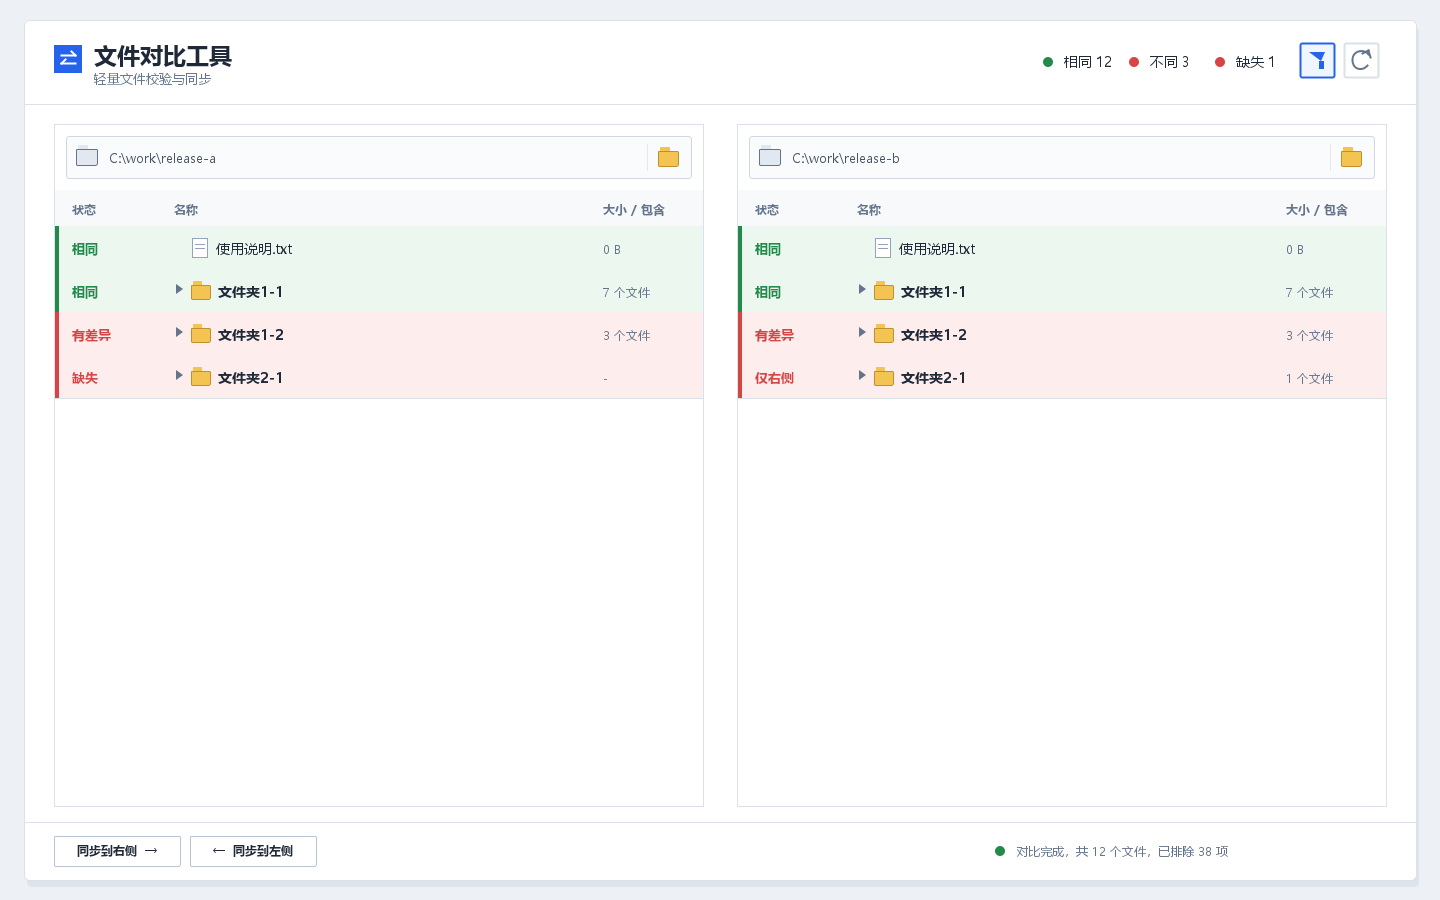
主界面没有新增常驻表单,只增加了一个激活状态的漏斗图标。底部状态显示:
对比完成,共 12 个文件,已排除 38 项
运行日志中会进一步区分被排除的目录数量和文件数量,方便检查规则是否符合预期。
今天实际修改了哪些内容
1. 过滤入口
- 右上角增加漏斗图标。
- “工具”菜单增加“过滤和排除规则”。
- 文件对比模式禁用过滤入口。
- 规则启用后漏斗显示蓝色激活状态。
2. 规则弹窗
- 支持目录名、扩展名和通配符三类规则。
- 支持逗号、分号和换行分隔。
- 显示规则示例、匹配说明和规则数量。
- 使用“应用并对比”立即重新扫描当前目录。
3. 扫描逻辑
- 目录命中后使用
SKIP_SUBTREE跳过整个子树。 - 文件命中后不读取文件内容,不计算 SHA-256。
- 扩展名和通配符使用大小写不敏感匹配。
- 通配符支持相对路径和文件名。
4. 结果与同步
- 被过滤内容不进入目录树。
- 被过滤内容不参与左右状态统计。
- 被过滤内容不参与双向同步。
- 底部状态和运行日志显示排除数量。
- 刷新和
F5继续使用当前规则。
5. 验证
- 使用 Java 8 重新编译主程序。
- 增加独立的过滤规则回归测试。
- 验证
.git、node_modules和普通目录匹配。 - 验证
.log、.tmp和大小写扩展名匹配。 - 验证
*.bak、*_old.*、temp-*通配符。 - 启动程序并确认 Java 进程正常响应。
今天的提示词复盘
这次提示词很短,但工作流控制很重要。
第一条提示词决定做什么:
增加过滤和排除规则,支持按目录名、扩展名和通配符排除内容,减少无效扫描和 Hash 计算。这次做这个吧。
第二条提示词决定怎么做:
先出 UI 以及计划方案,再给我修改吧。
第三条提示词才正式授权开发:
可以的。开始吧。
这三句话分别承担需求、方案确认和执行许可。对大模型协作开发来说,这种分阶段方式比一开始给一大段要求更容易控制:方向不对时只需要改效果图,不需要在已经修改的代码上返工。
如果想让大模型一次完成同类功能,可以直接使用下面这份最终版提示词:
请继续优化一个现有的 Java 8 Swing 文件对比工具。工具已经支持文件和目录
SHA-256 对比、可折叠目录树、左右联动、F5 刷新、双向同步和双击编辑。
保持现有扁平化 UI 风格,不引入第三方依赖。

本次增加“过滤和排除规则”,解决 .git、node_modules、target、日志、缓存、
编译产物和临时文件参与无效扫描与 Hash 计算的问题。

功能要求:

1. 过滤功能只作用于目录对比,文件对比模式保持原行为。
2. 在主界面右上角刷新按钮旁增加漏斗图标,同时在“工具”菜单增加
   “过滤和排除规则”。不要在主页面长期展示三组输入框。
3. 点击入口打开扁平化模态弹窗,包含“排除目录名”“排除文件扩展名”
   “排除通配符”三个输入区域。
4. 多个规则支持逗号、分号和换行分隔,自动去除首尾空格并忽略空规则。
5. 目录名规则按每一级目录名称匹配,例如 .git、node_modules、target。
6. 扩展名规则支持 .log 和 log 两种写法,使用大小写不敏感比较。
7. 通配符支持 * 和 ?,同时匹配相对路径和文件名,并正确转义其他正则字符。
8. 在 Files.walkFileTree 的 preVisitDirectory 阶段判断目录规则;命中后返回
   SKIP_SUBTREE,不能继续扫描子目录。
9. 在 visitFile 阶段、读取文件和计算 SHA-256 之前判断扩展名和通配符;
   命中后跳过文件。
10. 被排除的内容不能进入对比结果树,不能参与 Hash、状态统计和双向同步。
11. 点击“应用并对比”后保存规则并立即重新扫描当前左右目录。
12. F5 和重新加载继续使用当前过滤规则。
13. 规则启用后漏斗显示蓝色激活状态,清空规则后恢复普通状态。
14. 对比完成后在底部显示排除总数,在运行日志中分别显示排除目录数和文件数。
15. 保持目录折叠、缺失占位、空目录同步、双击编辑和左右滚动联动不变。
16. 增加过滤规则回归测试,覆盖目录、扩展名、大小写和通配符边界。
17. 使用 Java 8 编译并启动验证。

修改前先分析现有代码,给出执行计划和 UI 效果图。我确认后再修改正式代码。
完成后说明修改内容、规则语义、测试结果和仍存在的不足。
下一步计划
过滤规则已经能减少无效文件,但距离真正适合大型项目仍然有几项工作。
1. 保存规则和常用预设
当前规则只在本次程序运行期间保留,关闭软件后不会自动恢复。后续准备保存最近使用的规则,并提供 Java、前端、通用项目等常用预设,同时允许一键恢复空规则。
2. 增加扫描进度和取消操作
即使排除了常见目录,大项目仍可能包含大量业务文件。后续需要显示当前扫描路径、已处理文件数和进度,并允许用户取消长时间任务。
3. 并行计算 Hash
当前文件仍然按顺序读取和计算 SHA-256。后续可以使用受控线程池并行处理,但需要限制并发数量,避免机械硬盘随机读取或大量任务反而降低速度。
4. 改进文本差异算法和编码识别
内容编辑器仍需更准确的行对齐算法,也需要识别 UTF-8、GBK、GB2312 等常见编码,避免中文文件打开后乱码。
5. 提高同步安全性
同步前增加变更预览,明确展示将新增和覆盖的文件,并考虑备份和撤销能力,降低误覆盖风险。
最后
这次功能看起来只是多了三个输入框,但真正有价值的不是“能写过滤规则”,而是让无效内容在最早阶段停止:目录不再递归,文件不再读取,Hash 不再计算,同步也不会处理。
这也是自己手搓工具的优势。商业工具通常已经把这些能力做得很完整,但真正好用的版本往往需要付费;现在有了大模型,可以从自己的实际问题出发,一次只补一个最需要的功能。
不过目前的使用体验仍然算不上专业。规则还没有持久化,也没有预设管理;大目录扫描没有精确进度和取消按钮;文本差异、编码识别和同步安全仍然有明显提升空间。
后面我会继续优化,也会继续记录每一次真实需求、提示词、UI 方案和最终实现。
更多推荐


 9
 0
- 0


 已为社区贡献15条内容

所有评论(0)