
**Skill 机制如何让大模型“用得上“企业数据**
大模型进企业,第一道坎是数据。不是数据不够,是数据"用不上"。
企业数据有几个特点:分散在多个系统里、格式各异、权限复杂、更新频繁。一份技术文档可能同时存在于项目管理系统、文档库、邮件附件和即时通讯记录中,版本不一,权限各异。大模型直接读取这些数据,既容易越权,也容易拿到过期信息。
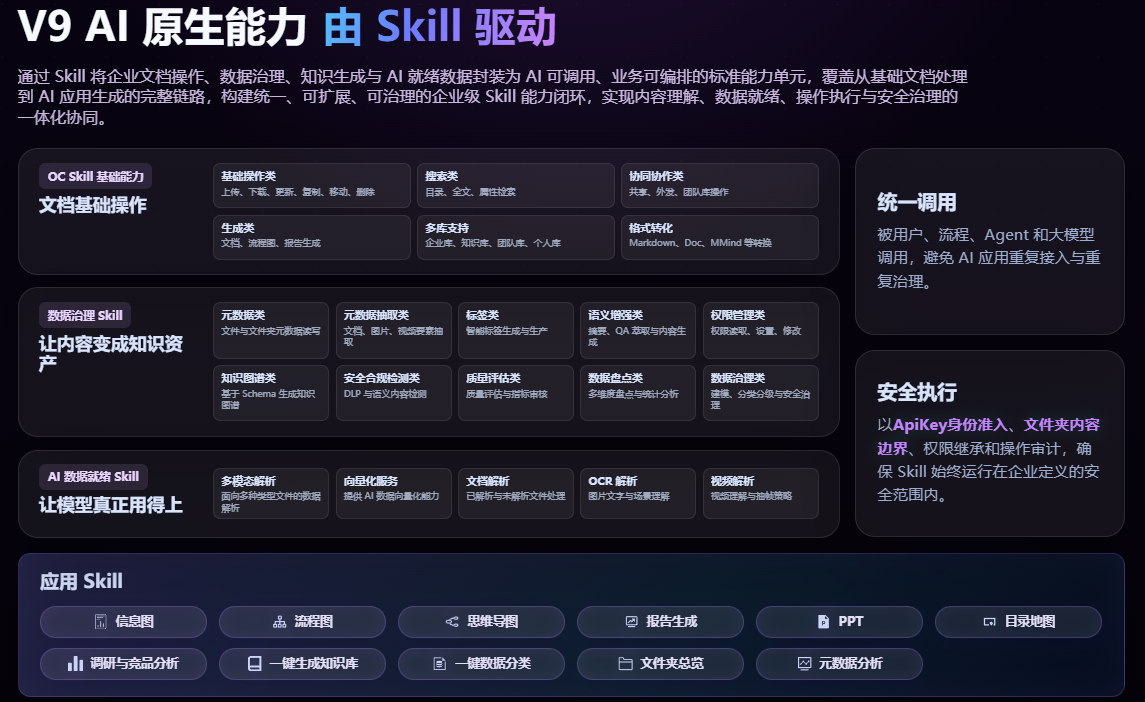
Skill 机制的思路是:不让大模型直接接触原始数据,而是让它调用封装好的能力单元。每个 Skill 负责一个具体动作——检索文档、提取元数据、比对版本、生成摘要、执行审批。Skill 内部处理权限校验、数据格式转换、版本一致性,对外暴露简洁的调用接口。
这样设计的优势有三点。
第一,安全可控。Skill 运行在预定义的安全边界内。一个"合同检索"Skill 只能访问合同库,且遵守用户的文件夹权限。即使大模型被注入恶意指令,也只能调用已授权的 Skill,无法突破边界。
第二,数据就绪。企业数据不是为 AI 准备的。PDF 扫描件需要 OCR,视频需要抽帧,表格需要结构化,这些预处理由 Skill 完成。大模型拿到的是干净、结构化、有上下文的输入,输出质量自然更高。
第三,行为可审计。每次 Skill 调用都留下日志——谁调了什么、访问了哪些数据、做了什么操作。这对企业的合规要求至关重要。大模型的"黑箱"特性让人担忧,但 Skill 的调用链是透明的。
技术实现上,Skill 需要统一的注册发现机制、参数校验、错误处理、并发控制。更复杂的场景需要 Skill 编排——多个 Skill 按序执行,前一个的输出作为后一个的输入。一次"生成竞品分析报告"的调用,背后可能是"检索资料→提取要点→数据可视化→排版输出"的完整流水线。鸿翼 OpenContent V9 在这个方面提供了完整的基础设施:ApiKey 身份准入确保只有合法调用方接入,文件夹内容边界限制了 Skill 的数据访问范围,操作审计让每一步调用可追溯。
大模型是企业 AI 的大脑,Skill 是手和眼。没有后者,前者再聪明也摸不到企业的真实数据。
更多推荐


 6
 0
- 0


 已为社区贡献5条内容

所有评论(0)