
初识机器学习(逻辑回归)
一、十种常用的机器学习算法
本篇主要分享逻辑回归算法(Logistic Regression)。
逻辑回归虽然名字里带“回归”二字,但它实际上是一种分类算法,主要用于解决二分类问题。逻辑回归也是机器学习中最基础且应用最广泛的算法之一。
二、逻辑回归
2.1 什么是逻辑回归
逻辑回归(Logistic Regression)是一种用于解决分类问题的经典算法。简单来说,它是在线性回归的基础上,增加了一个Sigmoid函数(也叫逻辑函数),将线性回归的输出结果压缩到 0 到 1 之间,从而表示某个事件发生的概率。
核心思想:逻辑回归通过现有数据找到一条分类边界(决策边界),然后利用这条边界对新样本进行分类。同时,它还能给出样本属于某个类别的概率值,而不仅仅是类别标签。
2.2 逻辑回归的基本原理
2.2.1 sigmoid函数
逻辑回归的核心就是Sigmoid函数(也称逻辑函数),它的公式如下:
其中,,也就是线性回归的输出。
Sigmoid函数的图像呈S形曲线,它将任意实数输入映射到 (0, 1) 区间内。当 z 趋近于正无穷时,g(z) 趋近于1;当 z 趋近于负无穷时,g(z) 趋近于0;当 z=0z=0 时,g(z)=0.5g(z)=0.5。
将线性回归的结果 z 代入Sigmoid函数后,得到:
这里的 表示样本属于类别1的概率。如果
,我们预测样本属于类别1;如果
,则预测属于类别0。
2.2.2 决策边界
决策边界是逻辑回归用来区分不同类别的分界线。对于二维数据来说,决策边界通常是一条直线(或曲线);对于高维数据,则是一个超平面。
逻辑回归的决策边界由参数 决定,公式为
。当
时,预测为正类;当
时,预测为负类。
2.3 损失函数与优化方法
2.3.1 损失函数(代价函数)
线性回归常用的损失函数是均方误差(MSE),但逻辑回归如果使用均方误差,会导致损失函数非凸,容易陷入局部最优解。因此,逻辑回归使用的是对数损失函数(Log Loss),也叫交叉熵损失(Cross-Entropy Loss),它是一个凸函数,存在全局最优解。
对于二分类问题,损失函数定义如下:
其中:m 是样本数量,y(i) 是第 i 个样本的真实标签(0或1), 是第 i 个样本的预测概率。当真实标签 y=1 时,损失函数为
,预测概率越接近1,损失越小;当真实标签 y=0 时,损失函数为
,预测概率越接近0,损失越小。
2.3.2 梯度下降法
为了最小化损失函数 ,我们通常使用梯度下降法(Gradient Descent) 来更新模型参数。
梯度下降的更新公式为:
其中 是学习率(Learning Rate),控制每次更新的步长。
梯度下降的步骤:
-
初始化参数:将权重
初始化为0或随机值
-
计算预测值:计算当前参数下的预测概率
-
计算损失:计算当前参数下的损失函数值
-
计算梯度:计算损失函数对每个参数的偏导数
-
更新参数:根据梯度方向更新参数
-
重复迭代:重复步骤2到5,直到损失函数收敛或达到最大迭代次数
2.4 逻辑回归的优缺点
2.4.1 优点
-
实现简单:模型结构简单,易于理解和实现
-
计算效率高:计算代价不高,训练速度快,存储资源消耗低
-
可解释性强:可以从特征的权重直接看出不同特征对结果的影响程度
-
输出概率:不仅能给出分类结果,还能给出属于某个类别的概率
2.4.2 缺点
-
容易欠拟合:模型形式简单,分类精度可能不高
-
对非线性问题处理能力有限:当特征与目标之间存在复杂非线性关系时,效果可能不佳
-
对特征独立性有一定要求:特征之间相关性较强时可能影响效果
2.5 逻辑回归算法实现
2.5.1 数据的准备与处理
数据片段如下图所示(其中标签包含Time,V1-V28,Amount):
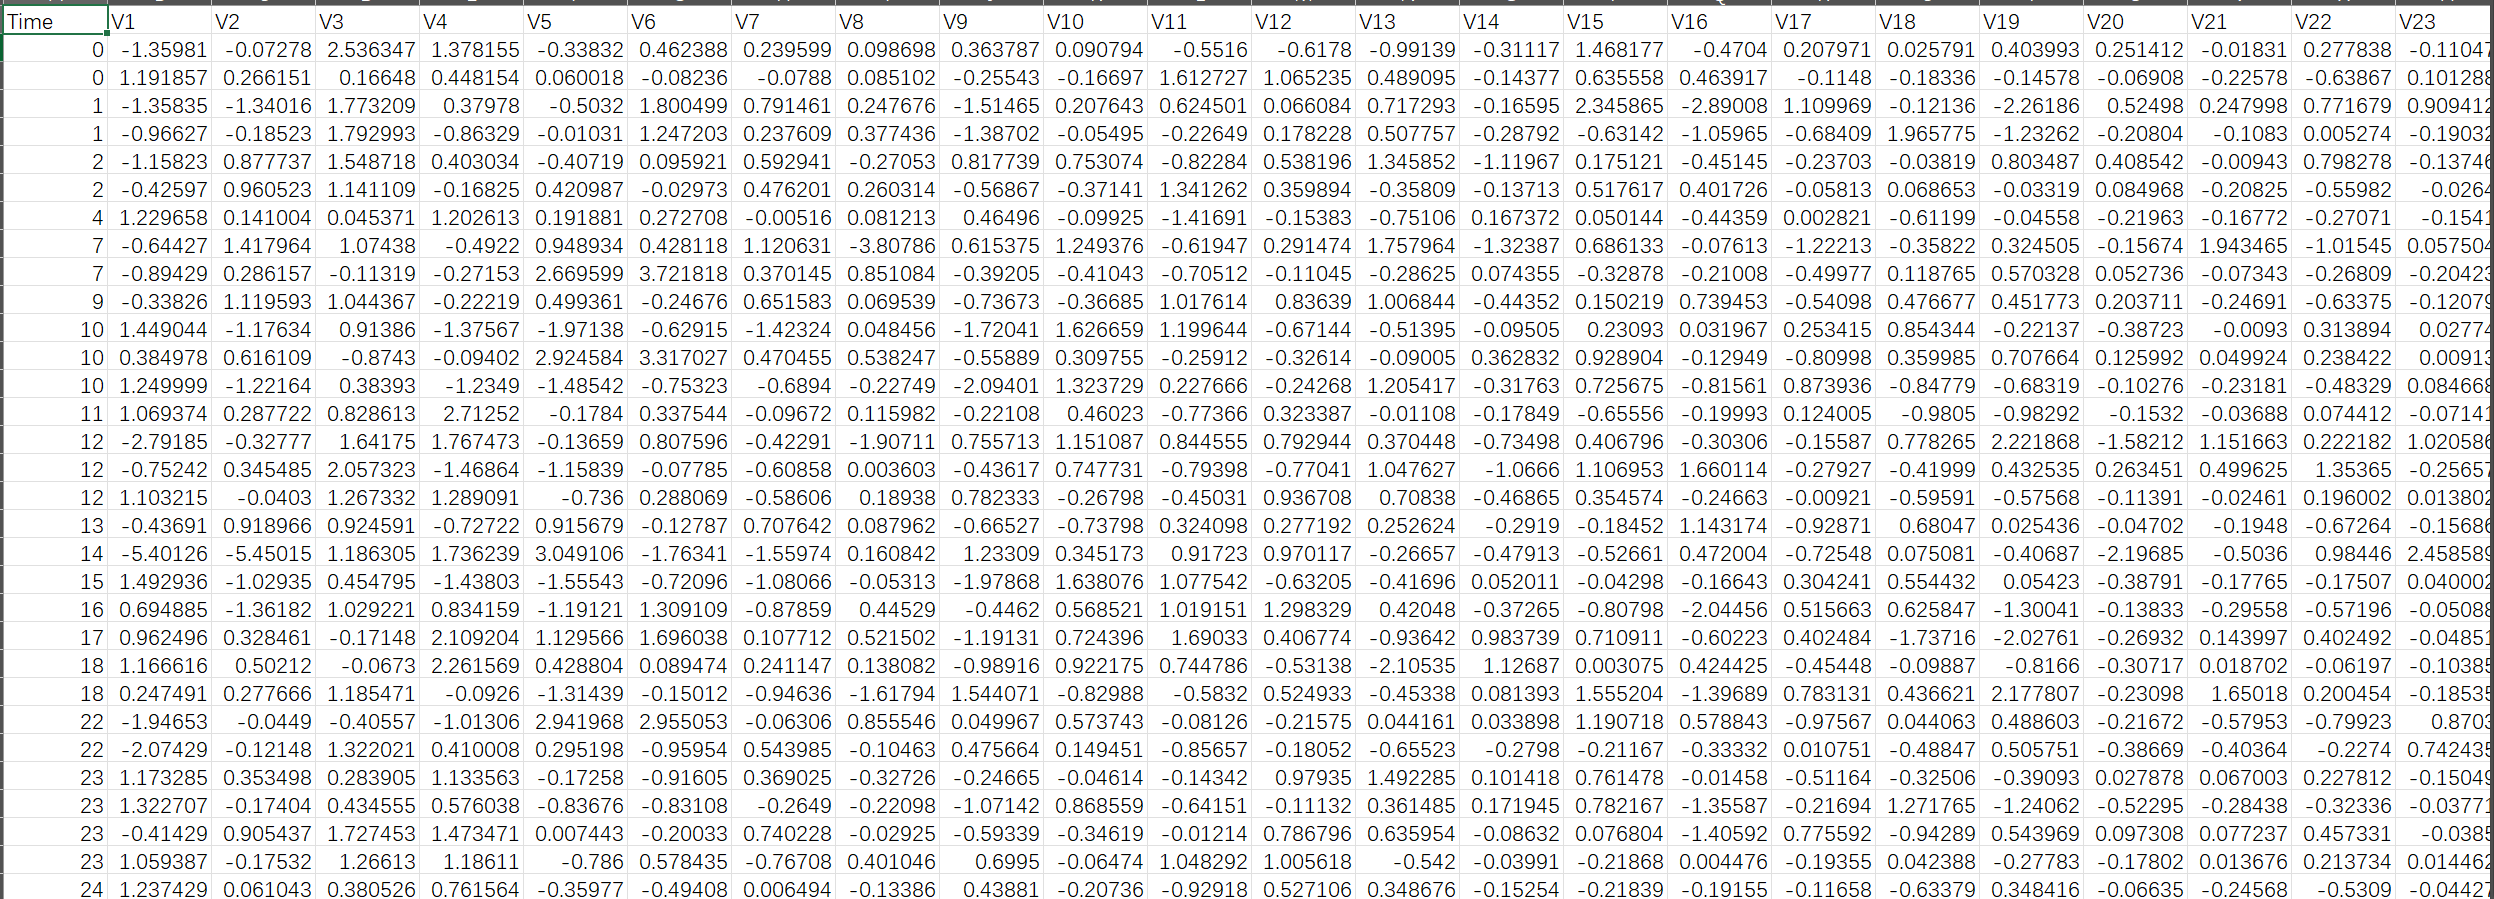
可以看到数据相当多且混乱,我们可以对数据进行可视化,观察数据的特点。
#  数据可视化模板
def cm_plot(y,yp):
    cm = confusion_matrix(y,yp)
    plt.matshow(cm,cmap=plt.cm.Blues)
    plt.colorbar()
    for x in range(len(cm)):
        for y in range(len(cm)):
            plt.annotate(cm[x,y],xy=(y,x),horizontalalignment="center",verticalalignment="center")
            plt.ylabel('True label')
            plt.xlabel('Predicted label')
    return plt
然后我们对数据进行Z-标准化处理,并且划分出训练集与测试集,以便后面使用。
# 读取数据
data = pd.read_csv(r'E:\new_learning\machine_learning\code\day11\creditcard.csv')

# Z-标准化
scaler = StandardScaler()
data['Amount'] = scaler.fit_transform(data[['Amount']])
data = data.drop(['Time'],axis=1)

# 对数据进行切分,划分出训练集与测试集
x = data.drop('Class',axis=1)
y = data.Class
x_train,x_test,y_train,y_test = train_test_split(x,y,test_size=0.3,random_state=0)
2.5.2 建立模型
数据处理好,就可以开始建立模型,前面我们都是直接建立模型,然后得到结果,没有考虑其他因素会不会对模型优劣产生影响,如下所示:
model = LogisticRegression(C=5,l1_ratio=0,max_iter=1000)
model.fit(x_train,y_train)
通过观察可以看到,在模型中还含有许多参数可以调节,所以在正式建立模型之前,我们需要调参。那如何进行调参呢?那不得不提到交叉验证了。
交叉验证(Cross-Validation)是一种用于评估机器学习模型泛化能力的统计学方法,其核心目的是解决单次划分训练集和测试集所带来的评估结果不稳定的问题。
在之前的实践中,我们通常将数据集划分为训练集和测试集(比如 80% 训练 + 20% 测试)。这种做法虽然简单,但存在一个致命的隐患:测试集划分的随机性。
假如我们运气不好,那 20% 的测试集中恰好包含了极难预测的离群点或样本,或者恰好全是特别简单的样本,那么计算出的准确率就会有巨大的波动。我们无法确定这个准确率是模型本身优秀,还是只是运气好碰到了简单的测试集。
交叉验证的核心思想:不把希望寄托在一次随机的数据划分上,而是多次划分、多次训练、多次评估,最后取平均成绩。这样得出的评估结果更加稳定、可信。
# 优化模型,进行交叉验证
scores = []
c_param_range = [0.001,0.01,0.1,1,10,100]
for i in c_param_range:
    model = LogisticRegression(C=i,l1_ratio=0,solver='lbfgs',max_iter=1000)
    score = cross_val_score(model,x_train,y_train,cv=8,scoring='recall')
    score_mean = sum(score)/len(score)
    scores.append(score_mean)
    print(score_mean)
经过交叉验证后,我们得到了最优的参数C(best_c),将它代入模型之中:
model = LogisticRegression(C=best_c,l1_ratio=0,max_iter=1000)
model.fit(x_train,y_train)
2.5.3 检验模型
# 自测&绘制混淆矩阵
train_pred = model.predict(x_train)
print(metrics.classification_report(y_train,train_pred))  # 自测
cm_plot(y_train,train_pred).show()

# 使用测试集进行测试
test_pred = model.predict(x_test)
print(metrics.classification_report(y_test,test_pred,digits=6))
cm_plot(y_test,test_pred).show()
完整代码如下:
import pandas as pd
import matplotlib.pyplot as plt
import numpy as np
from sklearn.metrics import confusion_matrix
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import cross_val_score
from sklearn import metrics

#  数据可视化模板
def cm_plot(y,yp):
    cm = confusion_matrix(y,yp)
    plt.matshow(cm,cmap=plt.cm.Blues)
    plt.colorbar()
    for x in range(len(cm)):
        for y in range(len(cm)):
            plt.annotate(cm[x,y],xy=(y,x),horizontalalignment="center",verticalalignment="center")
            plt.ylabel('True label')
            plt.xlabel('Predicted label')
    return plt

# 读取数据
data = pd.read_csv(r'E:\new_learning\machine_learning\code\day11\creditcard.csv')

# Z-标准化
scaler = StandardScaler()
data['Amount'] = scaler.fit_transform(data[['Amount']])
data = data.drop(['Time'],axis=1)

# 对数据进行切分,划分出训练集与测试集
x = data.drop('Class',axis=1)
y = data.Class
x_train,x_test,y_train,y_test = train_test_split(x,y,test_size=0.3,random_state=0)

# 优化模型,进行交叉验证
scores = []
c_param_range = [0.001,0.01,0.1,1,10,100]
for i in c_param_range:
    model = LogisticRegression(C=i,l1_ratio=0,solver='lbfgs',max_iter=1000)
    score = cross_val_score(model,x_train,y_train,cv=8,scoring='recall')
    score_mean = sum(score)/len(score)
    scores.append(score_mean)
    print(score_mean)

best_c = c_param_range[np.argmax(scores)]
print("*****************最优惩罚因子为:{}****************".format(best_c))

# 建立最优模型
model = LogisticRegression(C=best_c,l1_ratio=0,max_iter=1000)
model.fit(x_train,y_train)

# 自测&绘制混淆矩阵
train_pred = model.predict(x_train)
print(metrics.classification_report(y_train,train_pred))  # 自测
cm_plot(y_train,train_pred).show()

# 使用测试集进行测试
test_pred = model.predict(x_test)
print(metrics.classification_report(y_test,test_pred,digits=6))
cm_plot(y_test,test_pred).show()
更多推荐


 21
 0
- 0


 已为社区贡献15条内容

所有评论(0)