
机器学习---决策树
摘要:本文系统介绍了决策树的基本概念、构成要素(根节点、非叶子节点、叶子节点)及其作为有监督学习算法的原理。重点讲解了三种经典决策树分类标准:ID3算法(基于熵值)、C4.5算法(基于信息增益比)和CART算法(基于基尼指数)。最后通过一个完整的电信客户流失预测案例,详细演示了从数据读取、预处理、模型训练(包括交叉验证调参)到评估可视化的Python实战流程,提供了可直接运行的代码示例。
一、什么是决策树以及构成
决策树通过对训练样本的学习,并建立分类规则,然后根据分类规则,对新样本数据进行分类预测,属于有监督学习。(有监督学习是机器学习的一种核心范式,其基本思想是通过已知的输入-输出样本(即带标签的数据集)来学习一个映射函数,使得该函数能够对新的、未知的输入数据做出准确的预测。)
决策树包含
根节点:第一个节点
非叶子节点:中间节点
叶子节点:最终结果节点
二、决策树的分类标准
2.1 ID3算法
衡量标准:熵值,表示随机变量不确定性的度量,或者说是物体内部的混乱程度。熵:熵值越小,该节点越“纯”。熵值的计算公式:
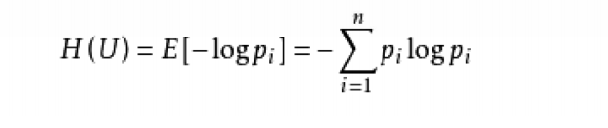
2.2 C4.5算法
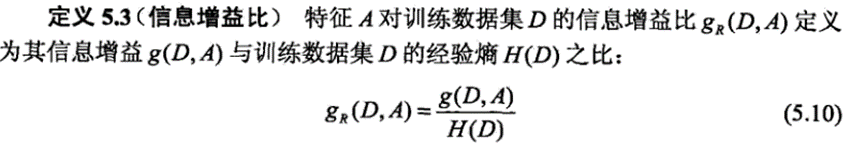
算法是一种决策树生成算法,它使用信息增益比(gain ratio)来选择最优分裂属性,具体步骤如下:
1、计算所有样本的类别熵(H)。
2、对于每一个属性,计算该属性的熵【也为自身熵】(Hi)。
3、对于每一个属性,计算该属性对于分类所能够带来的信息增益(Gi = H - Hi)。
4、计算每个属性的信息增益比(gain ratio = Gi / Hi),即信息增益与类别自身熵的比值。
选择具有最大信息增益比的属性作为分裂属性。
2.3 CART决策树
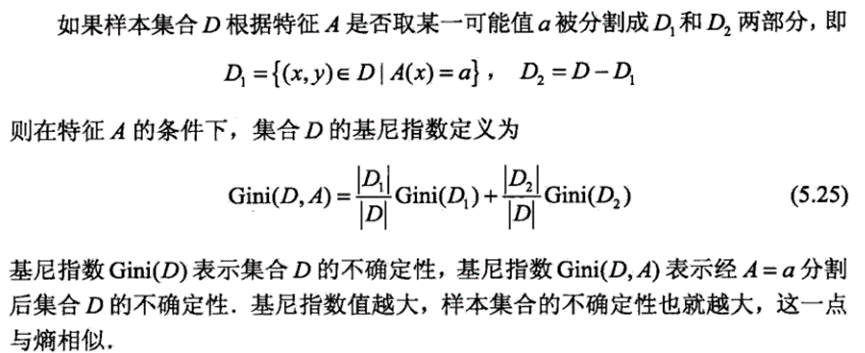
用Gini指数最小化准则来进行特征选择。基于基尼(GINI)指数
决策树的分类只需做了解即可
三、决策树的案例分析---某公司客户流失案例
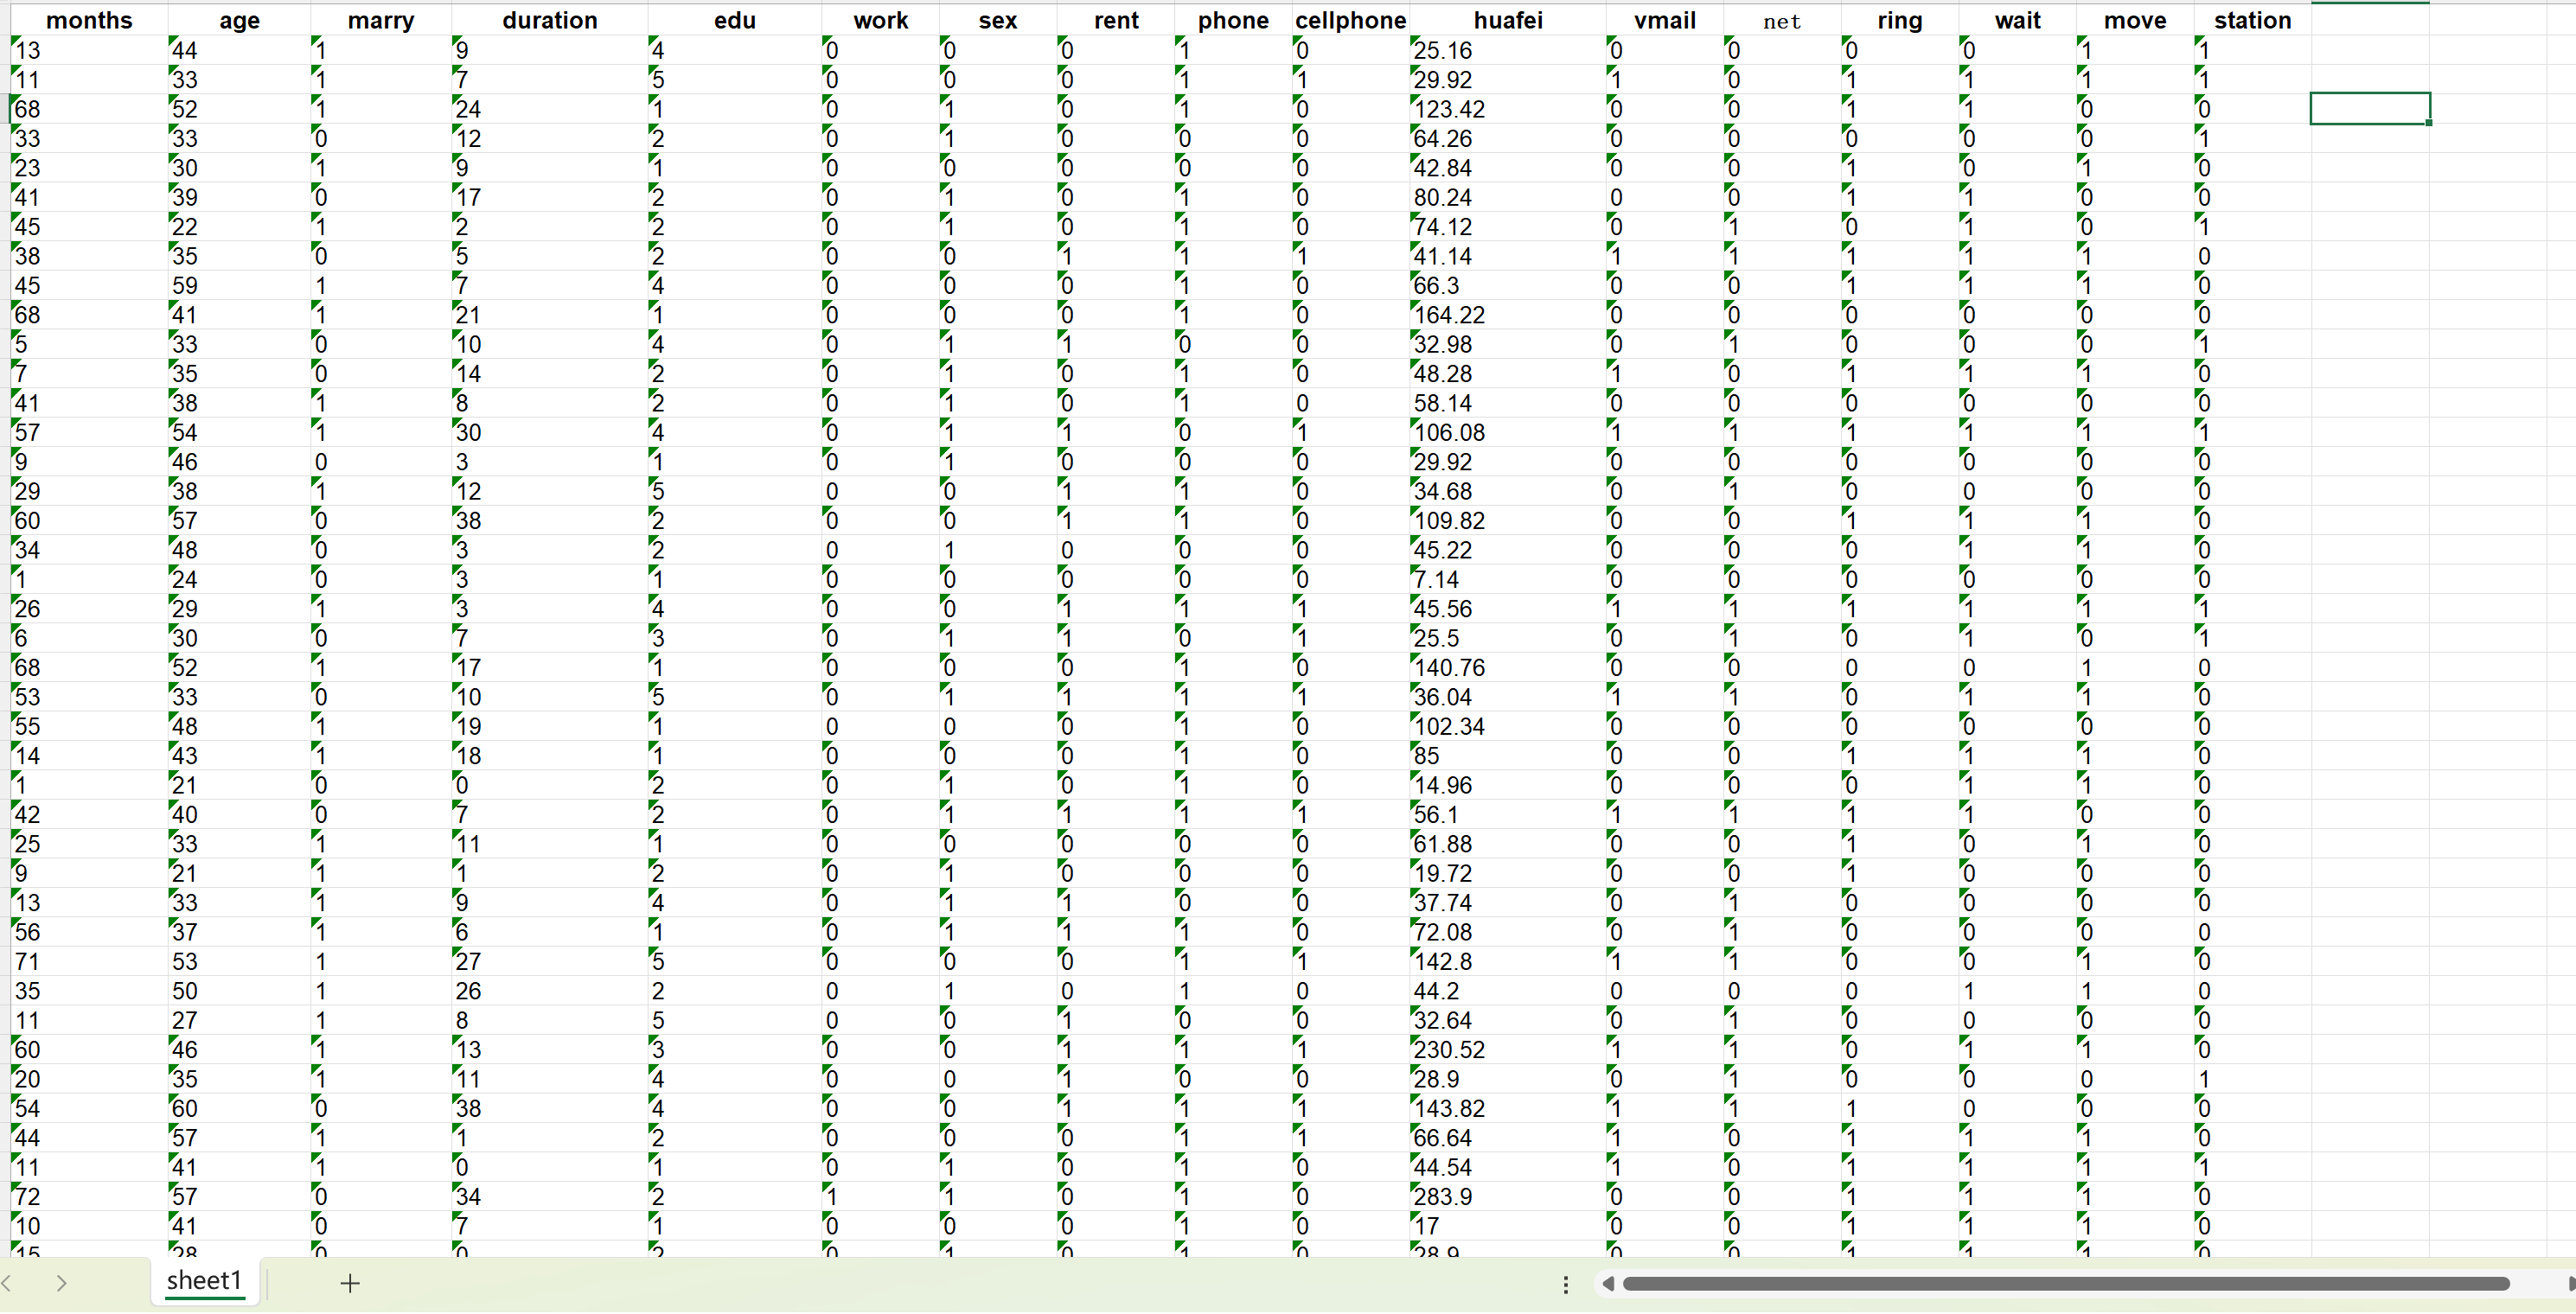
3.1数据样例的部分展示(数据已上传可进行下载)
字段说明:
1.months~move皆是样本的特征
2.station为样本的标签
3.2 完整流程和代码分步讲解
第一步:导入pandas,读取本地数据
import pandas as pd
datas = pd.read_excel('电信客户流失数据2.xlsx')
#将特征与标签分开
data = datas.iloc[ : ,: -1]
target = datas.iloc[ : , -1]
对于是用numpy读取还是用pandas读取取决于数据集是否有标题,有标题的用pandas读取,没有标题的用numpy读取
#无标题用numpy
import numpy as np
data = np.loadtxt()
#有标题用pandas
import pandas as pd
datas = pd.read_excel()
第二步,可定义混淆矩阵,模型预测的结果可视化,让你一眼看出模型在哪些类别上表现好、哪些类别容易分错。混淆矩阵的定义是固定的模板,可自行记忆。
import matplotlib.pyplot as plt

def cm_plot(y,yp):
    from sklearn.metrics import confusion_matrix
    import matplotlib.pyplot as plt

    cm = confusion_matrix(y ,yp)
    plt.matshow(cm , cmap = plt.cm.Blues)
    plt.colorbar()
    for x in range(len(cm)):
        for y in range(len(cm)):
            plt.annotate(cm[x,y],xy=(y,x),horizontalalignment ='center',
                         verticalalignment='center')
            plt.ylabel('True label')
            plt.xlabel('Predicted label')
    return plt
第三步,对数据进行处理
#将特征与标签分开
#第一种
data = datas.iloc[ : ,: -1]
target = datas.iloc[ : , -1]
#第二种
x = data.drop('Class',axis=1)
y = data.Class
#Class为对应的标签所在的列

#划分测试集和训练集
from sklearn.model_selection import train_test_split
data_train,data_test,target_train,target_test = train_test_split(data,target,test_size= 0.2,random_state=0)
第四步,定义决策树,并通过交叉验证来寻找最优参数的值
拿为什么要通过交叉验证验证选参呢,因为通过交叉验证,从一堆候选参数中找出“泛化能力最好”的那个,避免模型过拟合或欠拟合。我们需要一个科学的方法来找到那个“刚刚好”的值,而不是靠猜。交叉验证就是干这个的。
from sklearn import tree
#执行交叉验证,来找寻最优参数
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import cross_val_score

#执行交叉验证操作选择比较优的max_depth
scores = [] #用来存储不同c的验证集下的评分
max_depth_param_range = [2, 3, 4, 5, 6, 7, 8, 10]#max_depth的参数
for i in max_depth_param_range:
    dtr = tree.DecisionTreeClassifier(max_depth=i,random_state=0)
    score = cross_val_score(dtr,data_train,target_train,cv=8,scoring="accuracy")
    score_mean = sum(score)/len(score)
    scores.append(score_mean)
    print(score_mean)

#根据score中最大的值找到对应的max_depth的参数
best_max_depth = max_depth_param_range[np.argmax(scores)]
print(f"............最优的max_depth为:{best_max_depth}...........")

#执行交叉验证操作选择比较优的min_samples_leaf
scores = [] #用来存储不同的min_samples_leaf验证集下的评分
min_samples_leaf_param_range = [2, 3, 4, 5, 6, 7, 8, 10]#min_samples_leaf的参数
for i in min_samples_leaf_param_range:
    dtr = tree.DecisionTreeClassifier(max_depth =best_max_depth ,min_samples_leaf=i,random_state=0)
    score = cross_val_score(dtr,data_train,target_train,cv=8,scoring="accuracy")
    score_mean = sum(score)/len(score)
    scores.append(score_mean)
    print(score_mean)

#根据score中最大的值找到对应的min_samples_leaf的参数
best_min_samples_leaf = min_samples_leaf_param_range[np.argmax(scores)]
print(f"............最优的max_depth为:{best_min_samples_leaf}...........")
该方法代码是基于初学者便于理解,有更简洁优雅的代码可自行优化。
第五步:训练模型和混淆矩阵的训练
#训练模型
dtr = tree.DecisionTreeClassifier(max_depth= best_max_depth,min_samples_leaf=best_min_samples_leaf,random_state=0)
dtr.fit(data_train,target_train)

'''
训练集混淆矩阵
'''
#训练集预测值
train_predicted = dtr.predict(data_train)

from sklearn import metrics
#绘制混淆矩阵
print(metrics.classification_report(target_train,train_predicted))
#可视化混淆矩阵
cm_plot(target_train,train_predicted).show()
'''
测试集混淆矩阵
'''
test_predicted = dtr.predict(data_test)
from sklearn import metrics
#绘制混淆矩阵
print(metrics.classification_report(target_test,test_predicted))
#可视化矩阵
cm_plot(target_test,test_predicted).show()
第六步:对决策树进行评分
#对决策树进行评分
dtr.score(data_test,target_test)
from sklearn.tree import plot_tree
fig ,ax = plt.subplots(figsize=(32,32))
plot_tree(dtr,filled= True,ax = ax)
plt.show()
完整代码为
import pandas as pd
import matplotlib.pyplot as plt
from pylab import mpl
import numpy as np

def cm_plot(y,yp):
    from sklearn.metrics import confusion_matrix
    import matplotlib.pyplot as plt

    cm = confusion_matrix(y ,yp)
    plt.matshow(cm , cmap = plt.cm.Blues)
    plt.colorbar()
    for x in range(len(cm)):
        for y in range(len(cm)):
            plt.annotate(cm[x,y],xy=(y,x),horizontalalignment ='center',
                         verticalalignment='center')
            plt.ylabel('True label')
            plt.xlabel('Predicted label')
    return plt


datas = pd.read_excel('电信客户流失数据2.xlsx')
#将特征与标签分开
data = datas.iloc[ : ,: -1]
target = datas.iloc[ : , -1]

#划分测试集和训练集
from sklearn.model_selection import train_test_split
data_train,data_test,target_train,target_test = train_test_split(data,target,test_size= 0.2,random_state=0)

#定义决策树
from sklearn import tree
#执行交叉验证,来找寻最优参数

from sklearn.model_selection import cross_val_score

#执行交叉验证操作选择比较优的max_depth
scores = [] #用来存储不同c的验证集下的评分
max_depth_param_range = [2, 3, 4, 5, 6, 7, 8, 10]#max_depth的参数
for i in max_depth_param_range:
    dtr = tree.DecisionTreeClassifier(max_depth=i,random_state=0)
    score = cross_val_score(dtr,data_train,target_train,cv=8,scoring="accuracy")
    score_mean = sum(score)/len(score)
    scores.append(score_mean)
    print(score_mean)

#根据score中最大的值找到对应的max_depth的参数
best_max_depth = max_depth_param_range[np.argmax(scores)]
print(f"............最优的max_depth为:{best_max_depth}...........")

#执行交叉验证操作选择比较优的min_samples_leaf
scores = [] #用来存储不同的min_samples_leaf验证集下的评分
min_samples_leaf_param_range = [2, 3, 4, 5, 6, 7, 8, 10]#min_samples的参数
for i in min_samples_leaf_param_range:
    dtr = tree.DecisionTreeClassifier(max_depth =best_max_depth ,min_samples_leaf=i,random_state=0)
    score = cross_val_score(dtr,data_train,target_train,cv=8,scoring="accuracy")
    score_mean = sum(score)/len(score)
    scores.append(score_mean)
    print(score_mean)

#根据score中最大的值找到对应的min_samples_leaf的参数
best_min_samples_leaf = min_samples_leaf_param_range[np.argmax(scores)]
print(f"............最优的max_depth为:{best_min_samples_leaf}...........")

dtr = tree.DecisionTreeClassifier(max_depth= best_max_depth,min_samples_leaf=best_min_samples_leaf,random_state=0)
dtr.fit(data_train,target_train)

'''
训练集混淆矩阵
'''
#训练集预测值
train_predicted = dtr.predict(data_train)

from sklearn import metrics
#绘制混淆矩阵
print(metrics.classification_report(target_train,train_predicted))
#可视化混淆矩阵
cm_plot(target_train,train_predicted).show()
'''
测试集混淆矩阵
'''
test_predicted = dtr.predict(data_test)
from sklearn import metrics
#绘制混淆矩阵
print(metrics.classification_report(target_test,test_predicted))
#可视化矩阵
cm_plot(target_test,test_predicted).show()

#对决策树进行评分
dtr.score(data_test,target_test)
from sklearn.tree import plot_tree
fig ,ax = plt.subplots(figsize=(32,32))
plot_tree(dtr,filled= True,ax = ax)
plt.show()
四、决策树的优缺点与适用场景
决策树作为一种经典的机器学习算法,因其直观、易于理解和实现而广受欢迎。然而,它也存在一些固有的局限性。本节将系统总结决策树的主要优点、缺点以及典型的适用场景。
4.1 优点
- 可解释性强:决策树生成的规则(if-then)非常直观,易于向非技术人员解释,符合人类的决策思维过程。
- 无需数据标准化:决策树不依赖于数据的距离或度量,因此不需要对数据进行标准化或归一化处理,可以直接处理原始数据。
- 能够处理混合类型数据:既可以处理数值型特征,也可以处理类别型特征。
- 对缺失值不敏感:大多数决策树算法(如CART)能够通过代理分裂等技术处理缺失值。
- 可以捕捉特征间的非线性关系:通过树的分裂过程,能够自然地建模特征之间的交互作用和非线性关系。
- 计算复杂度相对较低:训练和预测的速度通常较快,适合处理大规模数据集。
4.2 缺点
- 容易过拟合:如果不进行剪枝或设置深度限制,决策树倾向于生成非常复杂的树,完美拟合训练数据,导致在测试集上泛化能力差。
- 对数据变化敏感:训练数据的微小变化可能导致生成完全不同的树结构(高方差),不够稳定。
- 倾向于选择具有更多取值的特征:信息增益等准则会偏好具有更多类别的特征,可能导致偏差。
- 难以学习复杂的关系:对于需要复杂边界(如XOR问题)或高度线性可分的数据,决策树可能不是最优选择,性能可能不如支持向量机或神经网络。
- 可能产生有偏的树:如果类别分布不平衡,生成的树可能会偏向于多数类。
4.3 适用场景
- 需要模型可解释性的场景:如金融风控、医疗诊断、商业决策等,决策者需要理解模型做出判断的依据。
- 探索性数据分析:决策树可以帮助快速识别数据中最重要的特征和潜在的模式。
- 作为复杂模型的基准:由于其简单和快速,常被用作与其他更复杂模型(如随机森林、梯度提升树)对比的基准模型。
- 集成学习的基础组件:决策树是随机森林、梯度提升决策树(GBDT)、XGBoost、LightGBM等强大集成模型的核心弱学习器。
- 处理混合数据类型:当数据集同时包含数值和类别特征时,决策树是一个方便的选择。
在实际应用中,为了克服单一决策树的缺点,通常会使用集成方法(如随机森林、梯度提升树)来提升模型的稳定性、准确性和泛化能力。
更多推荐



 25
 0
- 0


 已为社区贡献4条内容

所有评论(0)