
大模型网关的限流与排队:从原理到工程实践
当 LLM 请求遇上高并发,传统的限流策略为何失灵?Token 维度限流、有界队列背压、分布式协调、长时排队异步化、Agent 状态管理——本文拆解 LLM Gateway 流量控制的完整技术栈。
目录
- 为什么 LLM 限流和普通 API 不一样
- 限流:从令牌桶到 Token 维度
- 排队:超限请求的缓冲艺术
- 背压:有界队列的自动节流
- 持久化与长时排队:何时转向异步
- Redis + Lua:分布式限流的工程实现
- 工业实践:网关内置 vs 消息队列
- LiteTopic 的真实定位
- Agent 状态管理:两种工程范式
- 总结与选型建议
为什么 LLM 限流和普通 API 不一样
一个普通的 REST API 请求,耗时通常在 50-200 毫秒,资源消耗与请求数大致成正比。一个 LLM 推理请求,耗时可能长达 30 秒,资源消耗取决于输入和输出的 token 数量,而非请求次数本身。这个差异决定了 LLM Gateway 的流量控制不能照搬传统方案。
具体来说,LLM 请求有三个特殊性:
- 长耗时:单次请求从首 token 到末 token 可能持续数十秒,连接长期占用
- Token 计费:成本和资源消耗按 token 计算,而非按请求次数,100 个短 prompt 的请求和 1 个长 prompt 的请求资源消耗天差地别
- 流式响应:SSE 长连接意味着请求一旦开始就难以中途拒绝,限流必须在请求进入前完成
传统的 TPS(每秒请求数)限流只能防止瞬时洪峰,但无法控制一个租户用少量超大 prompt 耗尽 GPU 资源。LLM Gateway 需要在请求维度和 token 维度同时限流,并在请求超限时通过排队而非直接拒绝来改善体验。
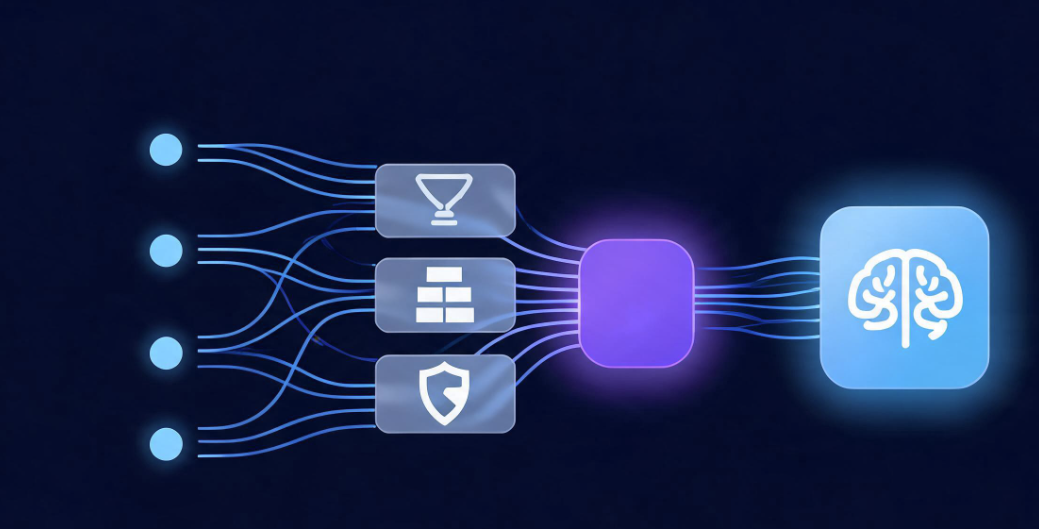
图 1:LLM Gateway 请求流水线——限流、排队、熔断三层守卫
限流:从令牌桶到 Token 维度
三种限流维度
LLM Gateway 的限流不是单一策略,而是三个维度的组合:
| 维度 | 控制对象 | 典型算法 | 解决的问题 |
|---|---|---|---|
| TPS(每秒请求数) | 请求进入速率 | 令牌桶 | 防止瞬时洪峰压垮网关 |
| TPM(每分钟 Token 数) | token 消耗速率 | 滑动窗口 | 防止少数大请求耗尽 GPU |
| 并发连接数 | 同时处理的请求 | 信号量 | 防止连接池和内存耗尽 |
令牌桶与滑动窗口
令牌桶适合 TPS 限流。它的核心思想是以固定速率向桶中添加令牌,每个请求消耗一个令牌,桶满则丢弃新令牌。令牌桶允许突发——桶中积攒的令牌可以被一次性消耗,应对短时间的流量脉冲。Python 中可以用 asyncio 实现一个简单的令牌桶:
import asyncio
import time

class TokenBucket:
    def __init__(self, rate: float, capacity: int):
        self.rate = rate          # 令牌生成速率(个/秒)
        self.capacity = capacity  # 桶容量
        self.tokens = capacity
        self.last_refill = time.monotonic()
        self._lock = asyncio.Lock()

    async def acquire(self, tokens: int = 1) -> bool:
        async with self._lock:
            now = time.monotonic()
            elapsed = now - self.last_refill
            self.tokens = min(self.capacity, self.tokens + elapsed * self.rate)
            self.last_refill = now
            if self.tokens >= tokens:
                self.tokens -= tokens
                return True
            return False
滑动窗口适合 TPM 限流。它记录过去 N 秒内每个请求的时间戳,通过清理过期记录来精确计算当前窗口内的总量。与固定窗口相比,滑动窗口不会在窗口边界处出现两倍流量的漏洞。Redis ZSET 是实现滑动窗口的经典数据结构。
Token 维度限流的难点
普通 API 按请求数限流就够了——每个请求的资源消耗大致相同。但 LLM 按 token 计费,100 个 10-token 的请求和 1 个 10000-token 的请求,请求数差 100 倍,资源消耗却相近。如果只按 TPS 限流,一个用户可以用少量超长 prompt 耗尽 GPU。
TPM 限流的核心难点在于:请求进入时只知道 input token,output token 是未知的。Gateway 需要做两件事:
- 请求前预估:用 tokenizer 计算 prompt 的 input token 数,加上预估的 output token(通常按 max_tokens 或历史平均值),与 TPM 配额比较
- 流式中实时扣减:在 SSE 流式转发过程中,每收到一个 chunk 解析其中的 token 数,实时累加到 Redis 计数器
第二步尤其关键。如果客户端在接收一半时断开连接,网关必须已经记录了已生成的 token 数,否则用户实际消耗了资源但配额未扣减,产生"资损"。
分层限流
生产环境通常采用三层限流,每一层保护不同的资源:
- 全局限流:保护 Gateway 整体,防止总流量超过系统承载能力
- 租户限流:按 API Key 分配配额,保证多租户间的公平性
- 模型限流:不同上游模型有不同的 QPS 和 TPM 限制,需分别控制
阿里云 ACK Gateway with Inference Extension 就是典型的 Redis 后端全局限流方案,通过 Envoy Gateway 的 Rate Limit Filter 与全局限流服务交互,实时获取限流阈值。
排队:超限请求的缓冲艺术
限流决定了请求能否进入,排队决定了超限请求的命运。直接拒绝(返回 429 或 503)是最简单的策略,但用户体验差——用户看到错误后重试,反而加剧拥塞。排队让超限请求在有限时间内等待处理机会,起到削峰填谷的作用。
网关内置排队:最常见的方案
大多数生产环境不需要引入额外的消息队列,网关自身就提供排队能力:
Nginx 的 limit_req 模块通过 burst 参数允许请求排队:
# 定义限流规则:rate=1200r/s
limit_req_zone $binary_remote_addr zone=api_limit:10m rate=1200r/s;

server {
    location /api/chat {
        # burst=200 允许 200 个请求排队,nodelay 表示不延迟处理
        limit_req zone=api_limit burst=200 nodelay;
        limit_req_status 429;
    }
}
burst=200 意味着超出 1200r/s 的请求不会立即被拒绝,而是排入一个长度为 200 的缓冲队列。队列满后新请求才返回 429。
腾讯云云原生网关内置了更精细的排队策略:最大排队时间可配置 0-15 秒,每隔 1 秒网关重试处理排队中的请求,如果达到最大排队时间还未被处理,则请求被限流。
应用层内存队列
对于自建的 LLM Gateway,Python asyncio 的有界队列是最直接的排队实现。关键是用 maxsize 限制队列长度,队列满时 put() 自动阻塞,形成天然背压:
import asyncio

class RequestQueue:
    def __init__(self, max_concurrent: int = 10, max_queue: int = 100):
        self.semaphore = asyncio.Semaphore(max_concurrent)
        self.queue = asyncio.Queue(maxsize=max_queue)
        self._timeout = 15.0  # 排队超时 15 秒

    async def submit(self, request):
        # 1. 尝试入队
        if self.queue.full():
            raise RateLimitError("队列已满,请稍后重试")

        await self.queue.put(request)

        # 2. 等待获取处理信号量(带超时)
        try:
            await asyncio.wait_for(
                self.semaphore.acquire(),
                timeout=self._timeout
            )
        except asyncio.TimeoutError:
            raise RateLimitError("排队超时,请稍后重试")
        finally:
            self.queue.get_nowait()

        # 3. 处理请求
        try:
            return await self._process(request)
        finally:
            self.semaphore.release()
排队的边界条件
排队不是无限的缓冲,它有三个必须设置的边界:
- 队列长度上限:防止内存溢出。通常是并发数的 2-5 倍
- 排队超时:防止客户端长时间挂起。通常 5-15 秒,超时后快速失败
- 优先级:VIP 用户或高 SLA 请求应优先处理。可以用优先级队列替代 FIFO
设计原则:排队的目的是平滑短时脉冲,不是消化持续超量流量。如果排队超时率持续高于 10%,说明限流阈值设置过低或需要扩容,而不是加大队列长度。
背压:有界队列的自动节流
上面的代码里有一个容易被忽略的细节:asyncio.Queue(maxsize=max_queue)。这个 maxsize 参数不是装饰性的——它是**背压(Backpressure)**的核心机制。理解背压,才能真正理解为什么有界队列比无界队列安全。
背压是怎么产生的
背压是流式系统中的概念,本质是下游处理不过来时,上游自动减速。在 asyncio.Queue 中,当队列中已有 maxsize 个元素时,put() 调用会阻塞,直到队列中有元素被取出腾出空间。
这个阻塞行为看起来像 bug,实则是保护机制。假设一个 LLM Gateway 的处理能力是 10 并发,队列容量 100:
- 前 10 个请求被信号量放行,进入处理
- 第 11-110 个请求入队等待,队列逐渐填满
- 第 111 个请求调用
put()时被阻塞——HTTP 协程被挂起,不再从 socket 读取新请求 - TCP 层面的接收窗口逐渐缩小,内核缓冲区填满,最终客户端的 send() 也被阻塞
整条链路从 LLM 推理端反向传导到客户端,形成了自动节流。这就是背压:不需要显式拒绝请求,处理能力的上限自然成为流量的上限。
无界队列的陷阱
如果把 maxsize 设为 0(无界),put() 永远不阻塞,队列可以无限增长。在 LLM 场景下这意味着:
- 每个排队请求的上下文(prompt、HTTP 请求头、用户信息)都驻留在内存中
- 一个 LLM 请求的上下文可能占数十 KB(长 prompt 场景甚至数 MB)
- 1 万个排队请求 × 100KB = 1GB 内存,且持续增长直到 OOM
无界队列把"拒绝请求"变成了"系统崩溃",代价更高。有界队列 + 队列满时快速失败(返回 429),是更可控的策略——至少拒绝时还能返回有用的错误信息,而不是让整个进程 OOM 后无法服务任何用户。
单实例前提:为什么多实例下背压会失效
背压的一个隐含前提是单实例。背压链路之所以能从 LLM 推理端传导到客户端,是因为所有请求都经过同一个进程——队列阻塞 → 协程阻塞 → socket 阻塞 → TCP 窗口收缩,这条传导链是连贯的。
多实例部署时,前面有负载均衡器(如 Nginx、云 SLB)。每个 Gateway 实例各自维护独立的有界队列,各自产生独立的背压。问题在于:
- 实例 A 的队列满了,开始对客户端连接施加背压
- 负载均衡器检测到实例 A 响应变慢,将后续请求转发给实例 B
- 实例 A 的背压被绕过,总并发量没有下降
结果是:每个实例都在做背压,但 LLM Provider 的总并发量并没有被限制住。N 个实例各自独立背压,无法替代全局并发控制。
多实例场景下,本地有界队列仍然有用——它保护每个实例自身的内存不被打爆。但全局 LLM 并发控制必须依赖 Redis 层面的分布式协调(下一节详述)。两层各管各的:本地队列限制实例内存,Redis 限制全局 LLM 并发。
总结:背压是单实例环境下的自动节流机制,通过有界队列的阻塞行为将处理压力反向传导到客户端。多实例部署需要额外的 Redis + Lua 全局协调来补充本地背压的不足。
持久化与长时排队:何时转向异步
一个自然的问题:Gateway 的排队队列做了持久化吗?如果 Gateway 进程重启,排队中的请求会丢失吗?
短时排队:不需要持久化
答案取决于排队时间的量级。前面讨论的网关排队,时间尺度是秒级——Nginx burst 通常几秒,云网关最大排队 15 秒,应用层队列超时一般 5-15 秒。这个时间尺度下,持久化没有必要:
- 请求生命周期短:排队几秒后要么被处理,要么超时返回 429,不需要在磁盘上保留
- 客户端有重试机制:收到 429 后,客户端按照 Retry-After 头延迟重试,等效于"丢失后重新来过"
- 持久化代价高:每个排队请求写一次磁盘或 Redis,在高并发场景下 I/O 开销显著
Gateway 队列是内存中的瞬时缓冲,不是持久化存储。进程重启时队列清空,排队中的请求丢失——这在秒级排队的场景下是可接受的。客户端等待 5 秒收到 429 后重试,体验上与"排队 5 秒后处理"差别不大。
长时排队:从同步到异步的转折点
但如果排队时间达到十几分钟呢?这种场景在 GPU 资源极度紧张时确实会出现——高峰期所有 GPU 都在满负荷运转,新请求的预期等待时间可能超过 10 分钟。
这时同步排队的模型开始崩塌:
- HTTP 连接撑不住:负载均衡器、CDN、客户端都有连接超时(通常 30-120 秒),几分钟的排队会触发各层超时
- 用户体验不可接受:让用户盯着 loading 转圈 15 分钟不现实
- 进程重启代价巨大:排队 10 分钟的请求因为进程重启而丢失,用户无法接受
当排队时间跨过分钟级门槛,架构必须从同步排队切换到异步任务模式:
- 提交阶段:客户端请求到达 Gateway,Gateway 不直接排队等待,而是生成一个 task_id,将任务写入持久化存储(数据库或 MQ),立即返回 task_id
- 轮询/推送阶段:客户端通过 task_id 轮询状态,或通过 WebSocket / SSE 接收推送
- 执行阶段:Worker 从 MQ 消费任务,调用 LLM,结果写回存储
- 断线续传:如果客户端断线重连,通过 task_id 恢复 SSE 流,从断点位置继续推送已生成的 token
这正是 LiteTopic 发挥作用的场景——它不是用来做限流排队的,而是用来解决异步任务模式下长任务的流式输出和断线续传问题。任务可能排队十几分钟才开始执行,执行过程又持续数十秒,期间客户端网络可能中断。LiteTopic 的 offset 机制确保已生成的 token 不丢失、不重复。
分界线:排队时间 < 30 秒 → 同步排队 + 内存队列,丢弃可接受;排队时间 > 5 分钟 → 异步任务 + 持久化存储 + LiteTopic 断线续传。中间地带根据业务 SLA 灵活选择。
Redis + Lua:分布式限流的工程实现
单机限流用内存计数器就够了,但 LLM Gateway 通常多实例部署——每个实例独立限流会导致实际限流效果与预期偏差 30% 以上。分布式限流的核心是 Redis + Lua 脚本,利用 Redis 的单线程模型和 Lua 脚本的原子性保证计数准确。
为什么用 Lua 脚本
如果"检查配额 + 递增计数"分两步执行,在并发场景下会出现竞态条件:两个请求同时检查到配额充足,同时递增,结果超出限额。Redis 保证 Lua 脚本的执行是原子的——脚本执行期间不会有其他命令插入,完美解决竞态。
滑动窗口 TPM 限流脚本
以下是一个基于 Redis ZSET 的滑动窗口限流 Lua 脚本,适用于 TPM(每分钟 Token 数)限流:
-- KEYS[1]: 限流 key(如 rate_limit:tenant:user_123:tpm)
-- ARGV[1]: 当前时间戳(毫秒)
-- ARGV[2]: 窗口大小(毫秒,如 60000)
-- ARGV[3]: 本次请求消耗的 token 数
-- ARGV[4]: 配额上限

local key = KEYS[1]
local now = tonumber(ARGV[1])
local window = tonumber(ARGV[2])
local tokens = tonumber(ARGV[3])
local limit = tonumber(ARGV[4])

-- 1. 清理窗口外的过期记录
redis.call('ZREMRANGEBYSCORE', key, 0, now - window)

-- 2. 统计当前窗口内已消耗的 token 数
local current = 0
local entries = redis.call('ZRANGE', key, 0, -1, 'WITHSCORES')
for i = 2, #entries, 2 do
    current = current + tonumber(entries[i-1])
end

-- 3. 判断是否超限
if current + tokens > limit then
    return 0  -- 限流
end

-- 4. 记录本次消耗,设置过期时间
redis.call('ZADD', key, now, tokens .. ':' .. now)
redis.call('PEXPIRE', key, window)

return 1  -- 放行
Python 端调用这个脚本:
import redis
import time

r = redis.Redis(host='localhost', port=6379)

LUA_SCRIPT = """..."""  # 上面的 Lua 脚本
limiter = r.register_script(LUA_SCRIPT)

async def check_rate_limit(tenant_id: str, tokens: int, limit: int = 100000):
    key = f"rate_limit:tenant:{tenant_id}:tpm"
    now = int(time.time() * 1000)
    window = 60000  # 1 分钟

    allowed = limiter(
        keys=[key],
        args=[now, window, tokens, limit]
    )
    return bool(allowed)
流式 Token 实时扣减
上面的脚本处理的是请求进入时的预扣减。在流式响应过程中,Gateway 还需要每收到一个 chunk 就解析 token 数并实时更新 Redis。一个简化版的流式 token 追踪中间件:
async def stream_with_token_tracking(
    response,           # 上游 LLM 的流式响应
    tenant_id: str,
    on_chunk=None
):
    total_tokens = 0
    async for chunk in response.aiter_bytes():
        # 解析 SSE data 行中的 token 数
        # OpenAI 格式: data: {"usage": {"completion_tokens": N}}
        tokens_in_chunk = parse_chunk_tokens(chunk)
        total_tokens += tokens_in_chunk

        # 实时扣减 Redis 配额
        if tokens_in_chunk > 0:
            await redis.incrby(
                f"rate_limit:tenant:{tenant_id}:tpm:actual",
                tokens_in_chunk
            )

        if on_chunk:
            await on_chunk(chunk)

    return total_tokens
关键点:实时扣减不是为了限流(流式过程中无法中断上游),而是为了准确统计实际消耗。预扣减基于估算值,实际消耗可能不同。Gateway 需要定期对账——用实际值修正估算偏差,避免配额漂移。
Redis 内存安全:只存计数器,不存请求体
多实例场景下用 Redis 做分布式协调,一个常见的担忧是:如果把排队请求都存在 Redis 里,内存会不会被打爆?
答案是:Redis 不应该存排队请求本身。Redis 中只存两类轻量数据:
- 并发计数器:当前正在处理的请求数、当前窗口内已消耗的 token 数——每个计数器仅占几十字节
- 请求 ID 映射:如果需要追踪请求状态,存
request_id → status的映射,每个条目几百字节
完整的请求体(prompt、HTTP 头、用户上下文)始终留在 Gateway 实例的本地内存中。Redis 只负责"告诉每个实例现在全局并发是多少",不负责"存储请求本身"。
这样设计的原因是 Redis 的内存成本远高于应用进程内存。一个 LLM 请求的完整上下文可能占 100KB,1 万个排队请求就是 1GB。如果都塞进 Redis,不仅 Redis 内存吃紧,网络传输开销也不可忽视——每个请求入队时要把 100KB 写入 Redis,出队时再读回来,在高并发场景下这是不可接受的。
正确的分工是:
| 层级 | 存储内容 | 目的 |
|---|---|---|
| Gateway 本地内存 | 请求体、队列、协程上下文 | 排队缓冲 + 背压 |
| Redis | 计数器、请求 ID、配额 | 全局并发控制 + 限流 |
即使 Gateway 实例崩溃,Redis 中的计数器仍然准确——崩溃实例持有的并发额度会在心跳超时后自动释放。而本地队列中的请求丢失了也没关系,因为排队时间本就是秒级,客户端重试即可。
工业实践:网关内置 vs 消息队列
关于限流和排队的实现,工业界有一个常见的误解:认为需要引入 Kafka 或 RocketMQ 这样的消息队列来做流量控制。实际情况是,限流和排队的主流实现不依赖 MQ。
| 方案 | 适用场景 | 时间尺度 | 复杂度 |
|---|---|---|---|
| Redis + Lua | 分布式限流(TPS/TPM) | 毫秒级判断 | 低 |
| 网关 burst | 短时排队缓冲(0-15s) | 秒级 | 低 |
| 应用内存队列 | 单实例排队 + 背压 | 秒级 | 低 |
| Redis Stream | 多实例分布式排队 | 秒级 | 中 |
| Kafka / RocketMQ | 异步任务解耦、削峰填谷 | 分钟~小时 | 高 |
| LiteTopic | 会话级隔离、SSE 断线续传 | 分钟~小时 | 中 |
消息队列解决的是异步解耦问题——生产者和消费者不需要同时在线,消息可以持久化存储。而限流排队解决的是同步请求的流量控制问题——用户在等待响应,排队时间必须控制在秒级。引入 MQ 做同步请求的排队,会带来不必要的延迟和架构复杂度。
典型的工业组合是:Redis+Lua 做限流 + 网关内置 burst 做排队 + LiteTopic 做会话通信。三者各管一层,不是替代关系。
LiteTopic 的真实定位
LiteTopic 是 RocketMQ 5.x 的轻量主题能力,腾讯云 TDMQ 和阿里云 RocketMQ 都已推出。它的核心使命不是限流排队,而是解决 AI 原生应用的三个通信难题:
SSE 断线续传
传统 SSE 连接一旦断开,已生成的半段内容就丢了,用户只能从头再问。LiteTopic 的方案是:LLM 推理节点将每个 token 按序写入 LiteTopic,SSE 网关独占消费并推送给前端。断线重连后,浏览器携带本地 offset,新网关从断点位置精确续推 token,已生成的 token 零浪费。
多租户会话隔离
百万用户并发使用 AI 助手时,A 公司的会话不能被 B 公司的大批量请求拖慢。为每个用户会话动态创建一条独立的 LiteTopic,会话间在 Broker 层硬隔离,慢租户不影响快租户。
多 Agent 异步协作
主 Agent 把子任务派发到每类子 Agent 的专属 LiteTopic,子 Agent 异步消费并把结果回写到统一的事件流主题。事件流天然保序且可回放,Supervisor 进程重启也能从位点继续推进。
关键特性
- 发送即创建
- TTL 自动删除
- 百万级主题
- 排他订阅
- 严格保序
LiteTopic 复用了 RocketMQ 开源 LMQ(Light Message Queue)的轻量存储模型,所有消息追加写入同一物理队列保证全局有序。它在内核存储层面与传统 Topic 无结构性差异,因此实现简洁、维护成本低。
LiteTopic 不在限流排队链路上。它解决的是通信层的会话隔离与断线续传,属于 AI 原生通信架构,而非流量控制系统。
Agent 状态管理:两种工程范式
讨论 LiteTopic 时容易混淆一个概念:LiteTopic 是消息传输层,不是 Agent 状态存储。Agent 的会话状态(对话历史、规划、工具中间变量、记忆)需要独立的存储方案。工业上有两种主流范式,分别适配不同的业务场景。
方案 A:无状态 Agent + Redis Checkpointer
这是 ToC AI 应用最主流的架构,LangGraph 的 Redis Checkpointer 是典型实现。核心思路是Agent 执行单元是无状态函数,状态全部外置到 Redis。
请求处理流程如下:
- 请求到达时携带
thread_id(即 session_id) - 执行前:从 Redis 读取该会话的完整 State(messages、plan、工具中间变量、记忆)
- 在当前请求协程的局部变量中完成 Agent 的 ReAct / 规划 / 工具调用
- 执行结束:把完整新 State 写回 Redis,请求结束、内存全部释放
下一次用户请求可能打到完全不同的机器节点,重新从 Redis 加载状态继续。状态载体是 Redis,Agent 只是处理逻辑,不"持有"用户。
这种架构的优势是弹性扩缩容——任何实例都能处理任何用户的请求,实例数量可以随流量自由波动。代价是每次请求都要读写 Redis,状态序列化/反序列化有开销,且不适合极低延迟的场景。
方案 B:Actor 模型 + 内存驻留
游戏服务器、IoT 长连接场景更适合 Actor 模型。核心思路是每个用户会话是一个独立的 Actor 对象,常驻进程内存。
运行机制:
- 用户首次接入时,系统创建一个专属 Actor 对象驻留在某台机器的进程内存中
- 用户全部状态(对话、plan、工具上下文、连接状态)保存在 Actor 对象的成员变量中
- 用户所有消息作为消息投递到 Actor 的邮箱队列,串行消费
- 所有交互直接操作内存变量,不读写外部存储(可异步备份落盘,主状态在内存)
- 同一个 session 必须路由到创建它的那台机器;Actor 空闲超时才销毁释放内存
状态载体是 Actor 实例内存,Actor 就是用户会话本身。这种架构的优势是极低延迟——所有状态访问都是内存操作,没有序列化开销。代价是扩缩容不灵活(需要 Actor 迁移机制),单机内存容量成为上限。
两种范式对比
| 维度 | 方案 A:无状态 + Redis Checkpointer | 方案 B:Actor 模型 + 内存驻留 |
|---|---|---|
| 状态载体 | Redis(外部存储) | Actor 实例内存 |
| 实例与用户关系 | 无绑定,任意实例处理任意用户 | 绑定,同一 session 路由到同一实例 |
| 扩缩容 | 自由扩缩容,无状态迁移 | 需要 Actor 迁移或重建机制 |
| 延迟 | 每次请求读写 Redis,毫秒级 | 纯内存操作,微秒级 |
| 适用场景 | ToC API、SaaS AI 助手 | 游戏、IoT、实时交互 |
| 故障恢复 | Redis 持久化,实例崩溃不影响状态 | 需异步备份,崩溃可能丢失最新状态 |
LiteTopic 在状态管理中的角色
LiteTopic 不是上述任何一种状态管理方案,它是消息传输层。无论选择方案 A 还是方案 B,LiteTopic 都可以作为 Agent 之间的通信管道:
- 方案 A 中,LiteTopic 负责多 Agent 异步协作的消息投递,状态仍由 Redis Checkpointer 管理
- 方案 B 中,LiteTopic 负责跨进程 Actor 之间的消息传递,Actor 内部状态仍在内存中
不要把 LiteTopic 和状态管理混为一谈。它是管道,不是仓库——消息流过 LiteTopic,但 Agent 的持久状态应该存在 Redis(方案 A)或 Actor 内存(方案 B)中。
分层视角:限流排队(Redis+Lua + 网关 burst)管流量控制,Agent 状态管理(Redis Checkpointer 或 Actor)管会话状态,LiteTopic 管消息传输。三层各司其职,不要让一层承担另一层的职责。
总结与选型建议
回到最初的问题——限流和排队是如何实现的?工业界是否用 MQ 的 LiteTopic?Agent 状态又该存在哪里?
限流的主流实现是 Redis + Lua 脚本,利用原子性保证分布式环境下的计数准确。Redis 只存计数器和请求 ID,不存完整请求体——请求体留在 Gateway 本地内存,避免 Redis 内存被打爆。排队的主流实现是网关内置的短时缓冲或应用层有界队列,通过 maxsize 产生背压自动节流。多实例部署时本地背压会因负载均衡转发而失效,需要 Redis 层面的全局并发控制来补充。
Gateway 队列不做持久化——秒级排队场景下,进程重启丢失队列是可接受的,客户端重试即可。但当排队时间跨过分钟级门槛(如 GPU 短缺高峰期排队十几分钟),同步排队模型崩塌,必须切换到异步任务模式:MQ 持久化 + task_id 轮询 + LiteTopic 断线续传。
LiteTopic 是 RocketMQ 5.x 的轻量主题,定位是消息传输层,不是限流排队,也不是 Agent 状态存储。Agent 状态管理有两种范式:ToC 场景用无状态 Agent + Redis Checkpointer(弹性扩缩容),游戏/IoT 场景用 Actor 模型 + 内存驻留(极低延迟)。LiteTopic 在两种范式下都只负责消息投递,不碰状态存储。
选型上:
- 单实例 LLM 代理:
asyncio.Semaphore+ 有界队列(maxsize),背压自动节流,够用 - 多实例 Gateway:Redis + Lua 分布式限流(只存计数器)+ 网关 burst 排队 + 本地有界队列保护实例内存
- 短时排队(<30s):同步排队 + 内存队列,不做持久化,超时返回 429
- 长时排队(>5min):异步任务 + MQ 持久化 + LiteTopic 断线续传
- ToC AI 应用:无状态 Agent + Redis Checkpointer + LiteTopic 做 SSE 断线续传和会话隔离
- 游戏/IoT 长会话:Actor 模型 + 内存驻留 + LiteTopic 做跨进程消息传递
- 成熟方案:直接采用 LiteLLM Proxy、Kong AI Gateway 等成熟产品
理解了这些边界,才能在架构选型时做出正确判断——不是每个问题都需要最重的方案,但每个层面的问题都需要对应的解法。限流排队管流量,状态管理管会话,消息传输管通信,三层各司其职,不可混淆。
更多推荐


 5
 0
- 0


 已为社区贡献3条内容

所有评论(0)